3.8 现代超标量处理器的高级问题
每周期多发射的挑战
在动态调度处理器中,每周期发射多条指令很复杂,原因很简单:同一指令束中的指令可能相互依赖。我们介绍的指令执行各步骤,特别是发射、派发和提交,都必须考虑并行处理的指令之间的依赖。3.5 节讨论了每周期对多条指令重命名的复杂性;这里进一步说明其对流水线其他部分的影响。
超标量处理器曾采用两种不同方法来处理每周期多条指令。一种是在半个时钟周期内完成相应步骤,从而在一个周期内按顺序处理两条指令。遗憾的是,它不容易扩展到每周期 4 条或更多指令。关键在于,不能简单地通过增加流水级来消除这个问题。例如,如果发射过程占多个周期,仍必须及时更新重命名表,让下一周期发射的依赖指令能够使用更新后的信息。另一种方法是构造必要的逻辑,一次处理两条或更多指令,包括它们之间所有可能的依赖。现代超标量处理器在其深流水线的关键级采用这种方法。
发射步骤是宽发射处理器最基本的瓶颈之一。要正确发射一个含 条指令的指令束,必须:
- 分配并更新 个 ROB 条目;不足 个时,只发射一部分,即束内最老的那些指令。
- 在指令调度器与加载/存储队列中分配并更新 个条目;不足时,同样只发射束内最老的部分指令。
- 分配并更新至多 个物理寄存器;不足时,只发射束内最老的部分指令。
- 正确重命名束内 条指令的全部输入操作数,考虑束内指令之间的数据依赖与名依赖(见 3.5 节)。
依赖组合的数量随指令束大小的平方增长,因此发射很可能成为时钟频率瓶颈,这也是很少有处理器尝试超过每周期 8 条的原因。3.5 节的图 3.18 展示了每周期重命名多条指令的复杂性,也清楚说明了为什么过去 20 年,大批量生产的处理器发射率只从 3~4 条提高到 4~8 条。
每周期派发多条指令较简单,因为到了这一阶段,数据依赖和名依赖已解决,多数情况下可以分别处理各条指令。半导体缩放也让大量功能单元变得容易实现,可在每周期处理就绪指令,因此有些处理器的派发宽度超过发射宽度。这有助于快速处理缓存未命中的加载完成后突然就绪的一批指令。同样,只要提交逻辑保证:第一条报告异常或错误预测的指令之后,所有指令都被撤销,那么每周期从 ROB 提交多条指令也并不特别复杂。
下面用一个例子,从性能角度说明这些概念如何结合。
例题 在支持推测执行的双发射、动态调度处理器上,执行下列循环,对整数数组的每个元素加 1:
假设有独立的整数功能单元,分别用于有效地址计算、ALU 运算、分支条件求值。为该循环前三次迭代建立执行时间表。假设每周期最多可以提交任意类型的两条指令。
解答 图 3.26 给出支持推测执行的双发射动态调度处理器的性能。在这个例子中,循环末尾分支可能成为 ILP 的关键限制,因此推测执行的帮助非常明显。通过预测分支,后续指令可以在较早分支确定之前执行,但不能提交,因而加快执行。例如,第二次加载可以在较早的分支之前完成执行。1 如果不采用推测执行,分支结果的确定会成为关键性能瓶颈。
| 迭代 | 指令 | 发射周期 | 派发周期 | 完成周期 | 提交周期 | 说明 |
|---|---|---|---|---|---|---|
| 1 | ld p2,0(p1) | 1 | 2 | 4 | 5 | 第一条指令 |
| 1 | addi p22,p2,1 | 1 | 4 | 5 | 6 | 等待 ld |
| 1 | sd p22,0(p1) | 2 | 5 | 6 | 等待 addi | |
| 1 | addi p21,p1,8 | 2 | 2 | 3 | 7 | 按顺序提交 |
| 1 | bne p21,p3 Loop | 3 | 3 | 4 | 7 | 等待 addi |
| 2 | ld p32,0(p21) | 4 | 5 | 7 | 8 | 没有执行延迟 |
| 2 | addi p42,p32,1 | 4 | 7 | 8 | 9 | 等待 ld |
| 2 | sd p42,0(p21) | 5 | 8 | 9 | 等待 addi | |
| 2 | addi p31,p21,8 | 5 | 6 | 7 | 10 | 按顺序提交 |
| 2 | bne p31,p3 Loop | 6 | 7 | 8 | 10 | 等待 addi |
| 3 | ld p52,0(p31) | 7 | 8 | 10 | 11 | 最早可能时间 |
| 3 | addi p62,p52,1 | 7 | 10 | 11 | 12 | 等待 ld |
| 3 | sd p62,0(p31) | 8 | 11 | 12 | 等待 addi | |
| 3 | addi p41,p31,8 | 8 | 9 | 10 | 13 | 提前执行 |
| 3 | bne p41,p3 Loop | 9 | 10 | 11 | 13 | 等待 addi |
图 3.26 支持推测执行的双发射流水线中,各指令派发、发射、执行完成和提交的时间。注意,由于预测分支跳转,bne 后的 ld 可以提前开始执行。假设加载需要 1 周期生成地址、1 周期访问缓存,且全部命中;存储可以按需缓冲;一条指令所依赖的较早指令完成执行的同一周期,就可以调度它执行。表中存储的完成周期按原表留空。
推测应做到什么程度
推测执行的一项重要优势,是能提前发现缓存未命中等原本会使流水线停顿的事件。但这项潜在优势也伴随着显著的潜在代价。推测并非免费:它需要时间与能量,从错误推测中恢复还会进一步降低性能。此外,要支持足够高的指令执行速率,从推测中获益,处理器还需要额外资源,占用芯片面积并消耗功率。最后,如果推测引发缓存或地址转换后备缓冲区(TLB)未命中之类的特殊事件,而没有推测本来不会发生该事件,就更可能造成显著性能损失。
为保留大部分收益,同时尽量降低不利影响,许多支持推测执行的流水线,只允许在推测状态下处理代价低的特殊事件,例如缓存未命中。如果发生 TLB 未命中等高代价事件,就等引发事件的指令不再具有推测性后才处理。虽然这可能略微降低某些程序的性能,却能避免其他程序出现重大损失,尤其是特殊事件频繁、分支预测又不够出色的程序。
20 世纪 90 年代,推测执行的潜在弊端还不那么明显。随着处理器越来越激进地采用推测,实际代价逐渐显现,更宽发射与推测执行的局限也变得清楚。稍后将再次讨论这一问题。
跨越多个分支进行推测
本章讨论的宽发射、深流水线处理器,可以重叠执行几十条指令。这意味着任意时刻都可能有多个尚未确定的推测分支。另外三个特征进一步增加了这种可能性:(1)许多程序的分支频率很高;(2)某些代码段中的分支集中出现;(3)功能单元确定分支结果所需的延迟很长。数据库程序及其他结构较不规则的整数计算,经常表现出前两项特征,使跨多个分支的推测尤其重要。同样,功能单元延迟较长时,跨多个分支推测也更重要,因为它有助于避免长流水线引起的停顿。
跨多个分支推测的主要难点,是确定何时更新分支预测状态,包括历史寄存器、预测计数器和目标预测结构。如果只有一条尚未确定的推测分支,可以等它的结果明确后再更新状态。注意,无论预测正确还是错误,都需要更新预测器状态。存在多个推测分支时,就面临取舍:等一条分支确定后再更新预测表,预测随后的几条分支时就无法利用这条分支的历史;一旦预测跳转或不跳转就立即更新,状态又可能包含不准确的信息。若干处理器选择提前更新,如果实际结果与预测方向相反,就修正部分或全部预测结构中的这些更新。例如,有些处理器维护两个 RAS:一个在取入函数调用指令时推测性更新,另一个只在调用指令不再具有推测性时更新。
到目前为止,所有处理器每周期都只预测一条分支。使用单个 PC 从缓存取一个指令束,并索引预测结构,确定下一 PC。如果束内存在跳转分支,预测结构跟踪其中第一条跳转分支的信息。每周期跨越多条实际跳转的分支进行预测,会显著增加复杂度与功耗,性能收益很难抵消这些成本。比较容易取得收益的情况,是循环体很小的循环;可以用循环缓存有效捕捉它们,而这已经是许多现代处理器的常见功能。
推测执行与能效挑战
推测执行如何影响能效?乍看之下,可能认为它总会降低能效,因为推测一旦错误,就会从两方面额外耗能:
- 推测执行了结果不需要的指令,为处理器制造额外工作,浪费能量。
- 撤销推测、恢复处理器状态,以便从正确地址继续执行,又会消耗没有推测时本来不需要的额外能量。
推测执行确实会提高功耗,因为它引入了分支预测器、重命名表、指令窗口、ROB 等新的硬件结构来管理指令执行。这些大型结构持续使用,增加动态和静态功耗。但是,如果执行时间缩短的比例超过平均功耗提高的比例,总能耗仍可能下降。
因此,要理解推测执行对能效的影响,就必须考察它多频繁地造成无用工作。如果执行了大量不需要的指令,推测就不太可能带来幅度相当的运行时间改善。图 3.27 展示使用复杂分支预测器时,部分 SPEC2000 基准中因错误推测而执行的指令比例。科学计算代码的这一比例很小,整数代码却很大,平均约为 30%。因此,推测执行对整数应用很可能并不节能,而 Dennard 缩放规律失效,也使不完美推测的问题更加突出。设计者可以避免推测、减少错误推测,或者探索新方法,例如只对已知高度可预测的分支进行推测。
超标量处理器受到哪些限制
本章讨论的硬件技术,对于开发 ILP 特别有效。如今几乎所有中高性能处理器,都建立在宽发射、深流水线、分支预测、寄存器重命名和动态调度之上。不过,过去十年,超标量处理器的性能改进速度已经放缓。超标量特性持续渐进改进,但若干关键特征,例如发射宽度、流水线深度,甚至时钟频率,已多年基本不变。这表明超标量处理器的有效性存在限制。
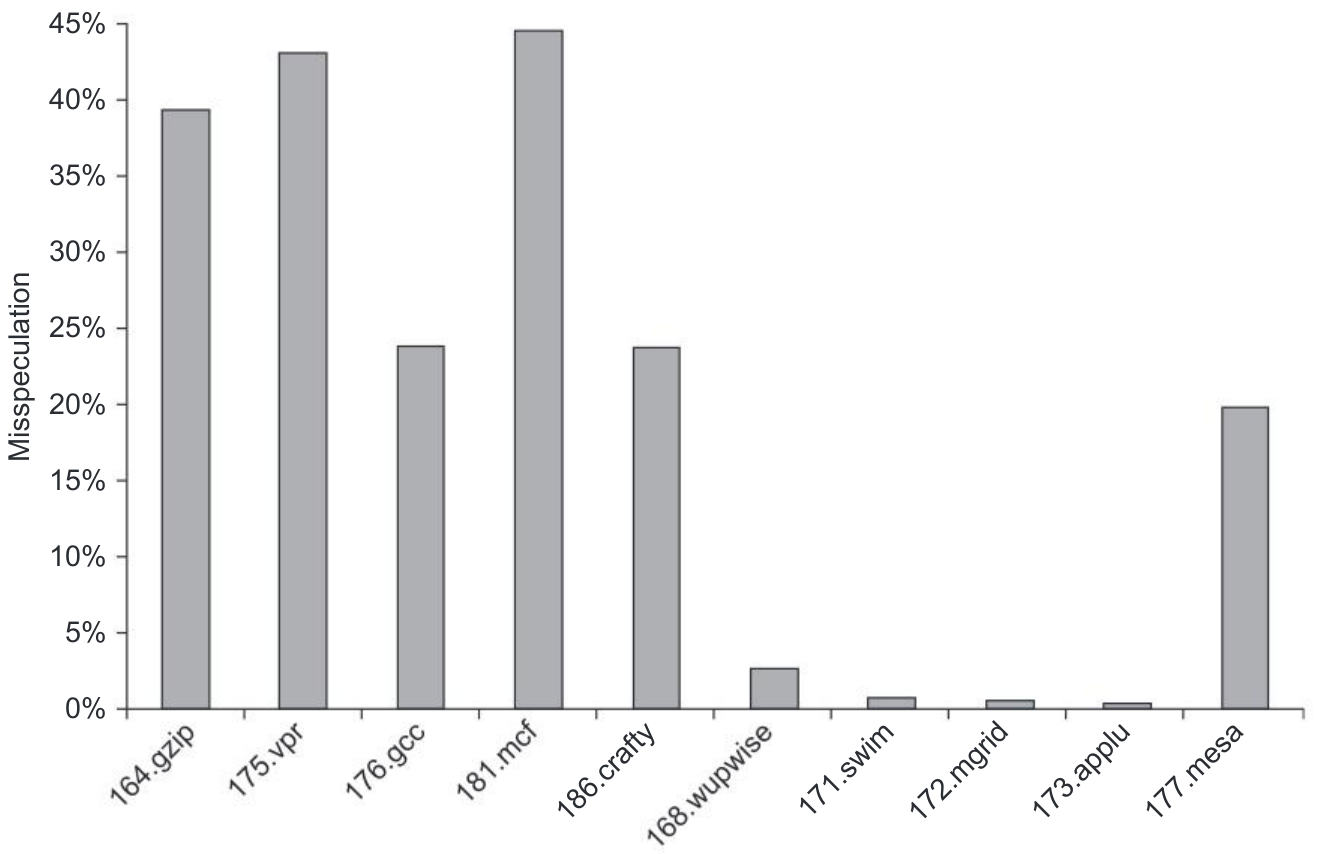
图 3.27 因错误推测而执行的指令比例,整数程序(前五个)通常远高于浮点程序(后五个)。纵轴 Misspeculation 为错误推测比例;横轴依次为 164.gzip、175.vpr、176.gcc、181.mcf、186.crafty、168.wupwise、171.swim、172.mgrid、173.applu、177.mesa。
我们已经讨论了两个关键限制。第一,发射很宽,每周期 4 条或以上,同时流水线很深的处理器,设计复杂而且耗电。有些阶段的复杂度随发射宽度平方增长。为缓解这一问题,处理器厂商正将超标量技术与向量、多核技术结合,分别开发数据级和线程级并行性,以争取更大性能收益。这两类并行性比 ILP 更规则,或者粒度更粗,所需支持硬件也较简单,第 4、5 章将进一步讨论。第二,超标量处理器性能受分支预测准确率限制。即使只有几个百分点的错误预测率,也足以使更宽、更深的流水线失去效果。
第三项限制来自必须由片外缓存和主存服务的缓存未命中。Karkhanis 与 Smith 较早分析了这种可能持续数百周期的长时间未命中的影响(Karkhanis and Smith, 2002)。有趣的是,等待长时间未命中时,停在指令窗口中的依赖指令并非主要问题。现代处理器的大指令窗口能容纳这几十条依赖指令,不妨碍独立指令就绪后发出。
相反,ROB 堵塞是一个重要问题,因为在未命中尚未完成期间,任何更年轻的指令都不能提交。这促使研究者探索利用检查点技术,构造拥有数千 ROB 条目的超标量处理器,但目前还未商用。最后,长时间未命中返回的数据,经常被数据依赖的分支使用,使分支预测不准确。
译注:原题代码末尾为
bne x2,x3,Loop,而图 3.26 的重命名分支使用p21/p31/p41,对应的是更新后的指针x1,不是数组值x2。此外,原解答称第二次加载可先于较早分支完成,但表中第二次加载完成周期为 7,第一次分支完成周期为 4。原代码、文字与时间表均保留,不能据此声称它们已相互一致。 ↩︎