3.11 多线程:利用线程级并行性提高单核吞吐量
本节介绍的多线程,确实是一个贯穿各层的问题:它既与流水线和超标量有关,也与 GPU(第 4 章)及多处理器(第 5 章)有关。软件线程与进程相似,都有自身状态和当前 PC;但线程通常共享同一进程的地址空间,因此,一个线程能够方便地访问同一进程中其他线程的数据。多线程是一项硬件技术,让同一进程内的多个线程,或多个进程,共享处理器流水线,而不必由操作系统在其间执行进程切换。在线程之间快速切换,或让不同线程的指令重叠执行,使多线程能够隐藏流水线延迟和内存延迟。
下一章将看到,多线程如何在 GPU 中带来同样的好处。最后,第 5 章将讨论多线程与多处理的结合。这些主题紧密交织,因为多线程是向硬件提供更多并行性的主要技术之一。严格来说,多线程利用的是线程级或进程级并行性,因而应属于第 5 章的主题;但考虑到它在提高流水线利用率和 GPU 中的重要作用,我们在这里先介绍其概念。
利用 ILP 提高性能的一大优点,是对程序员基本透明;但前面已经看到,在某些应用中,ILP 相当有限,或很难开发。尤其是在合理的指令发射速率下,访问内存或片外缓存的缓存未命中,几乎不可能靠现有的 ILP 隐藏。当然,处理器因等待缓存未命中而停顿时,功能单元的利用率会急剧下降。
用更多 ILP 掩盖长时间内存停顿,效果有限且成本显著,因此,自然会想到:能否利用应用中的其他并行性隐藏内存延迟?例如,在线事务处理系统中,请求带来的多次查询和更新之间,天然存在并行性。许多科学计算应用也有天然并行性,因为它们经常模拟自然界三维、并行的结构;可以利用独立线程开发这种结构中的并行性。甚至在采用现代 Windows 操作系统的桌面应用环境中,通常也有多个应用同时处于活动状态,成为进程级并行性的来源。
多线程允许多个线程以重叠的方式,共享一个处理器的功能单元。相较之下,开发线程级并行性(TLP)更一般的方法是使用多处理器:多个独立线程同时运行,在多条处理器流水线上并行执行。但多线程并不像多处理器那样复制整个处理器;它让一组线程共享处理器核心的大部分资源,仅复制寄存器和 PC 等私有状态。第 5 章将看到,许多较新的处理器,既在单颗芯片上集成多个处理器核心,也在每个核心内支持多线程。
复制处理器核心中每个线程的状态,意味着为每个线程建立独立的寄存器堆和 PC。内存本身可以通过已有的、支持多道程序的虚拟内存机制共享。此外,硬件必须能够较快地切换到另一个线程;尤其是,线程切换应当远比操作系统的进程切换高效。后者通常需要数百至数千个处理器周期;即便用户态协作式线程库中的线程切换,也需要数十至数百个时钟周期。
硬件多线程主要有三种方法:细粒度、粗粒度和同时多线程。细粒度多线程在每个时钟周期切换活动线程,使多个线程的指令交错分布在流水线各级中执行。这种交错通常采用轮转方式,跳过当时因停顿而不活动的线程。细粒度多线程的一项主要优点,是能够隐藏长、短停顿引起的吞吐量损失:一个线程停顿时,即使只停顿几个周期,也可以执行其他线程的指令。其主要缺点是减慢单个线程的执行,因为一个已就绪、原本可以不停顿执行的线程,会被其他线程的指令延后。它以单线程性能的损失——用延迟衡量——换取整体多线程吞吐量的提高。处理器也必须精心设计:由于不同线程的指令可能在流水线中重叠,所有进行转发或停顿控制的逻辑,除寄存器编号外,还必须考虑线程标识符。
细粒度多线程最早商用于 Denelcor HEP 和 Tera MTA 超级计算机。SPARC T1 至 T5 处理器(最初由 Sun 制造,后来由 Oracle 制造,现在由 Fujitsu 制造)采用细粒度多线程。这些处理器面向事务处理、Web 服务等多线程工作负载。T1 每个处理器支持 8 个核心,每核 4 个线程;T5 支持 16 个核心,每核 128 个线程。后续版本(T2–T5)还支持 4~8 个处理器插槽。下一章介绍的 NVIDIA GPU,也使用细粒度多线程。
译注:上述产品归属与线程数均按原书保留。“T5 每核 128 个线程”是原页文字,并非提取时把“每处理器”误读成“每核”;此处数值口径存疑,不能据此作为产品规格依据。
粗粒度多线程是作为细粒度多线程的替代方案提出的。它仅在代价高昂的停顿发生时切换线程,例如需要访问片外内存或缓存的缓存未命中。由于只有当前线程遭遇高代价停顿时,才发射其他线程的指令,因此,粗粒度多线程不再要求线程切换几乎零成本,也远不容易拖慢某个线程的执行。它还简化了处理器设计,因为任一时刻,流水线只执行一个线程的指令。其他活动线程的指令可以预取,但直到出现高代价停顿时才执行。
不过,粗粒度多线程有一个主要缺点:弥补吞吐量损失的能力有限,尤其难以弥补较短停顿造成的损失。这个限制来自粗粒度多线程的流水线启动成本。由于处理器只从单个线程发射指令,发生停顿时,在新线程开始执行之前,流水线中会出现气泡。由于这一启动开销,粗粒度多线程更适合降低代价极高的停顿:相对于停顿时间,重新填充流水线的时间可以忽略。若干研究项目探索过粗粒度多线程,但当前没有主要处理器采用这项技术。
最常见的多线程实现称为同时多线程(simultaneous multithreading,SMT)。SMT 是细粒度多线程的一种变体:在多发射、动态调度处理器上实现细粒度多线程,自然就会得到 SMT。与其他形式的多线程一样,SMT 利用 TLP 隐藏处理器中的长延迟事件,从而提高功能单元利用率。SMT 的关键认识是:寄存器重命名和动态调度,使来自独立线程的多条指令可以执行,而无需另外处理这些指令之间的依赖;依赖的解决可以交给动态调度机制。实际上,SMT 把多个线程的 ILP 交织起来,尽可能充分地利用流水线。
图 3.30 从概念上比较了以下四种处理器配置利用超标量资源的能力:
- 不支持多线程的超标量处理器。
- 支持粗粒度多线程的超标量处理器。
- 支持细粒度多线程的超标量处理器。
- 支持 SMT 的超标量处理器。
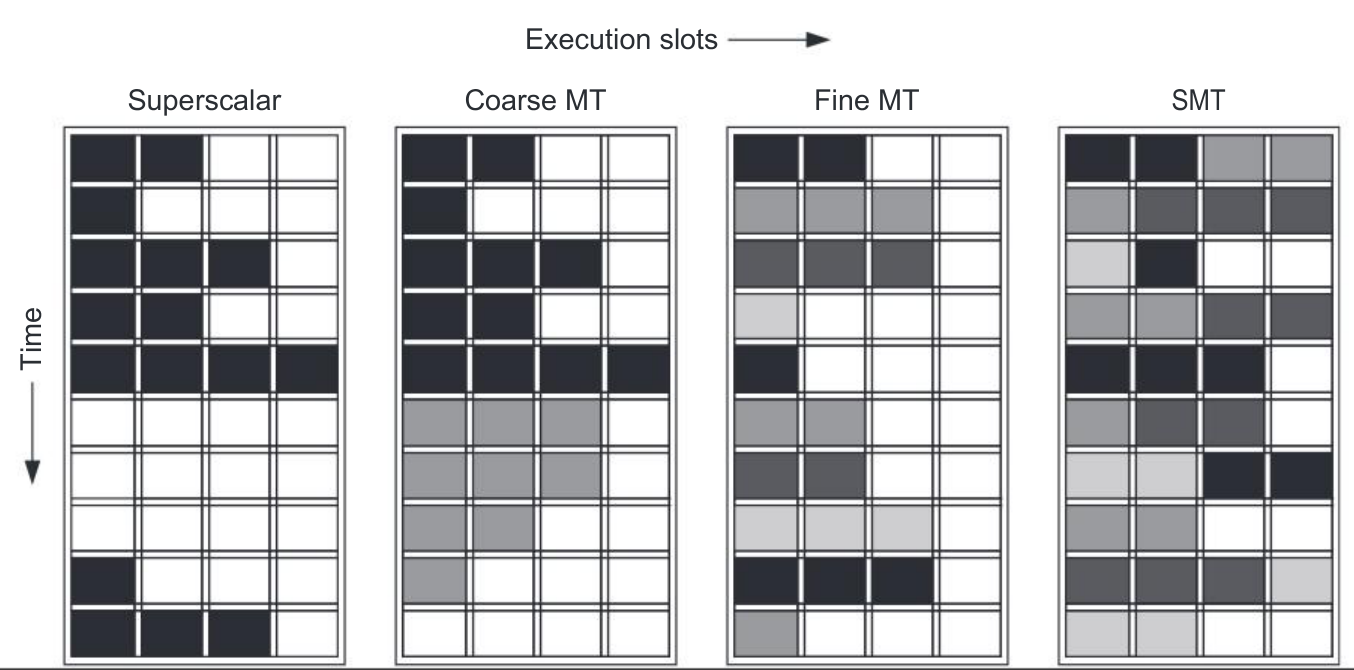
图 3.30 四种方法如何使用超标量处理器功能单元的执行槽位。横向表示每个时钟周期的指令执行能力;纵向表示连续的时钟周期。空白方格表示该周期对应的执行槽位未被使用。不同深浅的灰色与黑色,在多线程处理器中代表四个不同线程;对于不支持多线程的超标量处理器,黑色也表示已占用的发射槽位。Sun T1、T2(又称 Niagara)是细粒度多线程处理器,Intel Core i7 和 IBM Power10 则采用 SMT。T2 与 Power10 有 8 个线程,Intel i7 有 2 个线程。在所有现有 SMT 中,每次只从一个线程发射指令。SMT 的不同之处,是后续决定执行哪条指令的过程与发射解耦,因此,同一周期可以执行来自若干不同指令的操作。
图中文字:Execution slots=执行槽位;Time=时间;Superscalar=超标量;Coarse MT=粗粒度多线程;Fine MT=细粒度多线程;SMT=同时多线程。
在不支持多线程的超标量处理器中,ILP 不足限制了发射槽位的利用,其中包括缺少能够隐藏内存延迟的 ILP。由于 L2、L3 缓存未命中的延迟较长,处理器流水线经常有很大一部分处于空闲状态。
在粗粒度多线程超标量处理器中,切换到另一个线程,让它使用处理器资源,可以部分隐藏长停顿。这种切换减少了完全空闲的时钟周期数。但粗粒度多线程只在停顿时切换线程,而新线程有一段启动时间,因此,仍然很可能留下若干完全空闲的周期。
对于细粒度多线程,线程交错能够消除整行都空着的槽位。又因为每个周期都更换发射指令的线程,所以能够隐藏较长延迟的操作。由于指令发射与执行相连,一个线程只能发射已经就绪的那些指令。发射宽度较窄时,这不是问题——一个周期的槽位要么被占用,要么未被占用。因此,细粒度多线程非常适合单发射处理器,而 SMT 在这种处理器上没有意义。实际上,Sun T2 每周期发射两条指令,但它们来自不同线程。这使它不必实现复杂的动态调度,而是依靠更多线程来隐藏延迟。
如果在支持推测的超标量处理器上实现细粒度多线程,结果就是 SMT。现有大多数 SMT 实现中,所有发射的指令都来自同一个线程;但不同线程的指令可以在同一周期开始执行,由动态调度硬件判断哪些指令已经就绪。每个周期,指令调度器从所有线程中选取就绪指令执行。图 3.30 大幅简化了这些处理器的实际运行方式,但仍说明了多线程总体上的潜在性能优势,以及 SMT 对较宽发射、动态调度处理器的潜在优势。
SMT 利用了这样一个事实:动态调度处理器已经具备支持多线程所需的许多硬件机制,包括大量虚拟寄存器。在超标量处理器上增加每线程独立的重命名表、保存独立 PC,并支持来自多个线程的指令提交,即可构建多线程。
SMT 处理器的一项关键设计决策,是如何在线程间分配 ROB、指令调度器、BTB 表项等流水线资源。一种方法是静态划分各线程的资源,以限制单线程性能和整体硬件利用率为代价,取得性能的一致性与公平性。另一种方法是依据各运行线程的 ILP,按需动态共享表项,取舍方向恰好相反。SMT 处理器会在不同流水线模块中分别采用这两种方法。某些模块,例如 RAS,通常直接复制:它们本来就很小,而共享可能对性能产生较大影响。
每个时钟周期,SMT 处理器的前端都必须决定为哪个线程取指。一种尤其有效的做法,是优先为流水线其余部分中待完成指令最少的线程取指。这兼顾了性能与公平性:如果某线程在一段时间内表现出较高 ILP,指令能够不停顿地快速执行、提交,就会优先为它取指。但同一策略也照顾了较慢的线程:连续几个周期为快速线程取指后,较慢线程的待完成指令数会下降,取指优先级便会上升。
同时多线程在超标量处理器上的效果
一个关键问题是:实现 SMT 能够取得多少性能收益?2000~2001 年研究这个问题时,研究者假定,未来 5 年内动态超标量处理器会显著加宽:每周期支持 6~8 条指令发射,采用推测式动态调度,支持大量并发加载和存储、大型一级缓存,以及 4~8 个上下文,且能同时从多个上下文发射和退役(retirement)指令。
因此,模拟研究中多道程序工作负载取得两倍乃至更高性能收益的结果,并不符合实际。实践中,现有 x86 和 Arm 的 SMT 实现仅提供两个上下文,每次只从其中一个取指、发射,每周期最多发射 4 条指令。因此,SMT 的收益也更有限。只有 IBM Power 处理器实现了 4~8 个 SMT 线程。
Esmaeilzadeh 等(2011)进行了一组广泛而深入的测量,考察在单个 i7 920 核心上运行一组多线程应用时,SMT 带来的性能与能耗收益。Intel i7 920 每核支持两个 SMT 线程,较新的 i7 6700 也是如此。i7 920 与 6700 之间的变化相对较小,不太可能显著改变本节展示的结果。
使用的基准测试包括一组并行科学计算应用,以及来自 DaCapo 和 SPEC Java 套件的一组多线程 Java 程序,概况见图 3.31。图 3.32 给出了这些基准测试在 i7 920 的一个核心上,开启与关闭 SMT 时的性能比和能效比。(图中绘制的是能耗比的倒数,即能效比,使其与加速比一样,数值越大越好。)
尽管有两个基准测试的收益很小,Java 基准测试加速比的调和平均值仍为 1.28。这两个基准测试——pjbb2005 和 tradebeans——虽然是多线程的,但并行性有限。将它们纳入,是因为它们代表了可能在 SMT 处理器上运行的一类典型多线程基准测试:人们希望从中取得一些性能收益,而实际也确实取得了有限收益。PARSEC 基准测试的加速比略优于完整的 Java 基准测试集,调和平均值为 1.31。如果排除 tradebeans 和pjbb2005,Java 工作负载的加速比实际上会达到 1.39,明显优于 PARSEC 基准测试。(采用调和平均值汇总结果的含义,见图 3.32 图注。)
| 基准测试 | 说明 |
|---|---|
| blackscholes | 用 Black–Scholes 偏微分方程为期权组合定价 |
| bodytrack | 跟踪未使用标记点的人体 |
| canneal | 用考虑缓存的模拟退火算法,最小化芯片布线成本 |
| facesim | 模拟人脸运动,用于可视化 |
| ferret | 搜索与查询图像相似的一组图像的搜索引擎 |
| fluidanimate | 用 SPH 算法模拟流体运动的物理过程,用于动画 |
| raytrace | 用物理模拟进行可视化 |
| streamcluster | 近似求解数据点的最优聚类 |
| swaptions | 用 Heath–Jarrow–Morton 框架为互换期权组合定价 |
| vips | 对图像应用一系列变换 |
| x264 | MPG-4 AVC/H.264 视频编码器 |
| eclipse | 集成开发环境 |
| lusearch | 文本搜索工具 |
| sunflow | 照片级真实感渲染系统 |
| tomcat | Tomcat servlet 容器 |
| tradebeans | Tradebeans Daytrader 基准测试 |
| xalan | 用于转换 XML 文档的 XSLT 处理器 |
| pjbb2005 | SPEC JBB2005 的一个版本,固定问题规模,而非固定运行时间 |
图 3.31 本节用于研究多线程、第 5 章用于研究 i7 多处理的并行基准测试。表的上半部分是 Bienia 等(2008)收集的 PARSEC 基准测试,旨在代表适合多核处理器的计算密集型并行应用。下半部分由 DaCapo 中的多线程 Java 基准测试(见 Blackburn 等,2006)和 SPEC 的 pjbb2005 组成。这些基准测试都具有一定并行性;DaCapo 和 SPEC Java 工作负载中的其他 Java 基准测试,虽然使用多个线程,却几乎没有或完全没有真正的并行性,因此未用于这里。有关这些基准测试的特性及其与本节、第 5 章测量之间关系的更多信息,见 Esmaeilzadeh 等(2011)。
译注:表中 x264 的“MPG-4”沿用原书拼写。
能耗由加速比和功耗增长共同决定。对于 Java 基准测试,平均而言,SMT 的能效与不使用 SMT 相同,平均值为 1.0;但这是被两个表现不佳的基准测试拉低的。如果排除 pjbb2005 和 tradebeans,Java 基准测试的平均能效为 1.06,几乎与 PARSEC 基准测试一样好。在 PARSEC 基准测试中,SMT 降低的能耗为 。这种在提高性能的同时降低能耗的改进,非常难得。当然,两种情况下都承担了 SMT 所对应的静态功耗,因此,结果可能略微高估了能耗收益。
这些结果清楚地表明,在采用激进推测的处理器中,SMT 能够以较高能效提升性能。2011 年,在“更多、较简单的核心”与“较少、更复杂的核心”之间,取舍已经转向更多核心:每核通常是每周期发射 3~4 条指令的超标量处理器,以 SMT 支持 2~4 个线程。实际上,Esmaeilzadeh 等(2011)表明,在 Intel i5(与 i7 类似,但缓存更小、时钟频率更低)和 Intel Atom(最初面向上网本和 PMD 市场设计的 80×86 处理器,现在主要面向低端 PC)上,SMT 带来的能耗改善更大。
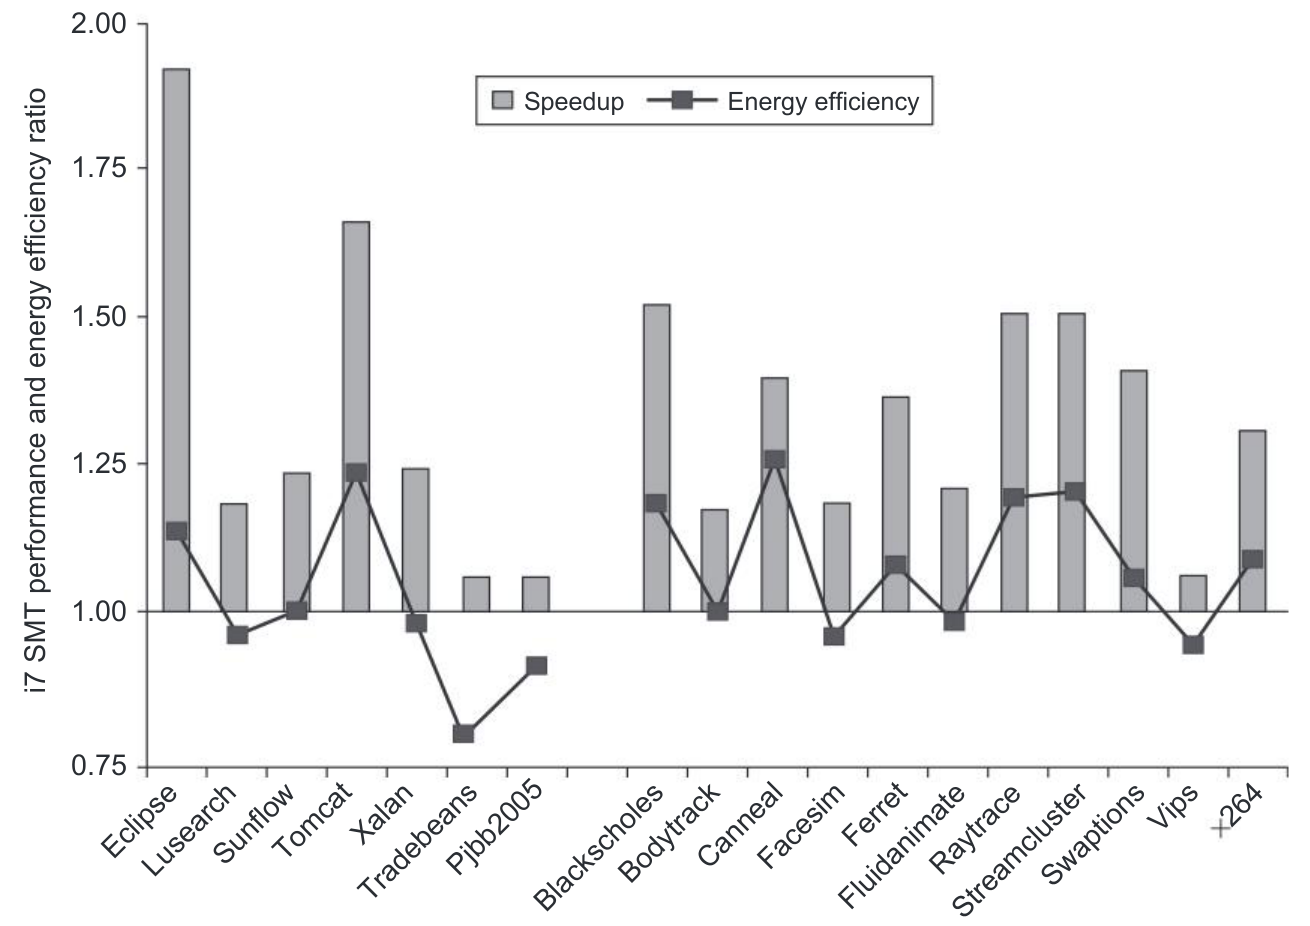
图 3.32 在 i7 处理器的一个核心上使用多线程,Java 基准测试的平均加速比为 1.28,PARSEC 基准测试为 1.31。这里采用不加权的调和平均值,隐含的工作负载是:在单线程基准配置下,每个基准测试的总执行时间相同。两类基准测试的平均能效分别为 0.99 和 1.07,也采用调和平均值。能效大于 1.0,表示该功能带来的执行时间降幅超过了平均功耗增幅。两个 Java 基准测试几乎没有加速,因此能效显著恶化。所有测试均关闭 Turbo Boost。数据由 Esmaeilzadeh 等(2011)使用 Oracle(Sun)HotSpot build 16.3-b01 Java 1.6.0 虚拟机和 gcc v4.4.1 原生编译器收集、分析。
图中文字:纵轴 i7 SMT performance and energy efficiency ratio=i7 SMT 性能比与能效比;Speedup=加速比;Energy efficiency=能效。横轴保留各基准测试名称。
译注:正文能效平均值写作 1.0,并以 1.08 计算 PARSEC 节能幅度;图注则分别写作 0.99 和 1.07。两处均忠实保留;,正文 7% 为取整值。