3.13 融会贯通:Arm Cortex-A53 与 Intel Golden Cove 处理器
本节考察两种多发射处理器的设计。首先讨论 Arm Cortex-A53 核心。手机和平板电脑的芯片常常集成若干高性能核心(big)与高能效核心(little),A53 经常充当其中的高能效核心。接着讨论 Intel Golden Cove 核心,它是 Alder Lake 客户端 CPU 系列和 Sapphire Rapids 服务器 CPU 系列中的高性能核心(p-core)。
Arm Cortex-A53
A53 是双发射、静态调度、动态发射的超标量处理器,每周期可以发射两条指令。图 3.33 展示了基本流水线结构。对于非分支的整数指令,流水线有 8 级:F1、F2、D1、D2、D3/ISS、EX1、EX2 和 WB,含义见图注。这是一条顺序流水线,因此,只有当一条指令的结果可用、且前面的指令也已经开始执行时,才能发射该指令执行。如果接下来的两条指令存在依赖,它们都可以进入相应的执行流水线,但到达流水线起点时,会串行执行。基于记分牌的发射逻辑确认第一条指令的结果可用后,第二条指令才能发射。
译注:原文在发射条件处写的是 “its results are available”(该指令的结果可用),与后文根据前一条指令结果判断就绪的说明并不严密一致。
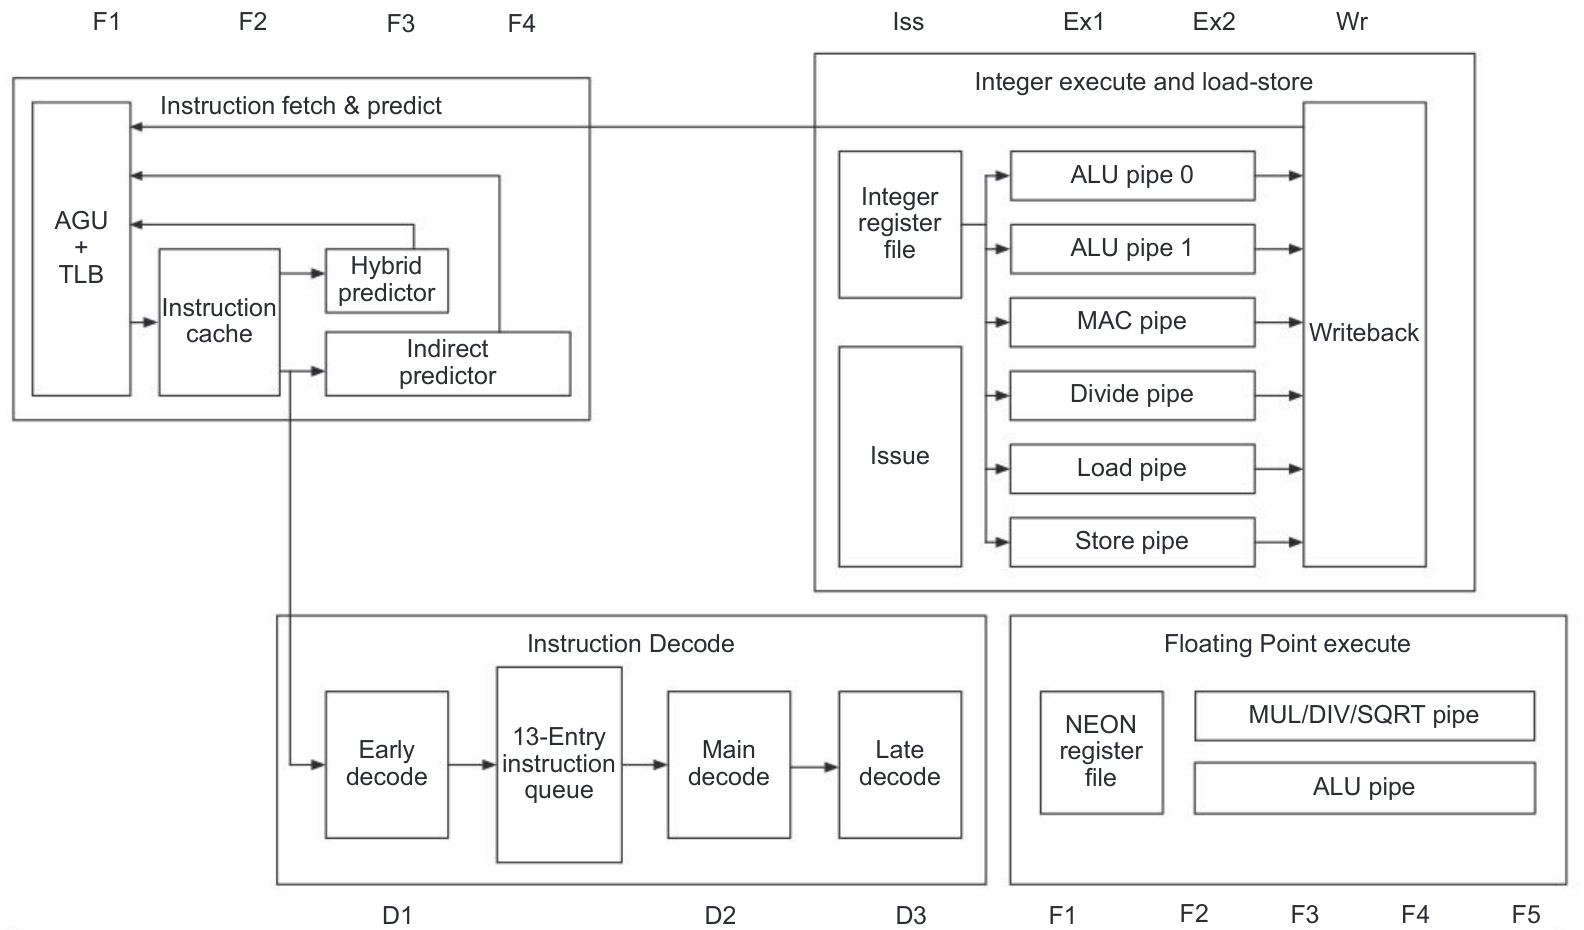
图 3.33 A53 整数流水线的基本结构为 8 级:F1、F2 取指;D1、D2 完成基本译码;D3 进一步译码某些较复杂的指令,并与执行流水线的第一级 ISS 重叠。ISS 之后,Ex1、EX2 和 WB 完成整数流水线。根据分支类型,使用四种不同的预测器。浮点执行流水线深度为 5 个周期,加上取指和译码所需的 5 个周期,共 10 级。
图中文字对照:
| 原文 | 中文 |
|---|---|
| Instruction fetch & predict | 取指与预测 |
| AGU + TLB | 地址生成单元与 TLB |
| Instruction cache | 指令缓存 |
| Hybrid predictor / Indirect predictor | 混合预测器 / 间接分支预测器 |
| Instruction Decode | 指令译码 |
| Early decode / Main decode / Late decode | 早期译码 / 主译码 / 后期译码 |
| 13-Entry instruction queue | 13 项指令队列 |
| Integer execute and load-store | 整数执行与加载、存储 |
| Integer register file / Issue / Writeback | 整数寄存器堆 / 发射 / 写回 |
| ALU pipe 0 / ALU pipe 1 | ALU 流水线 0 / ALU 流水线 1 |
| MAC pipe / Divide pipe | 乘加流水线 / 除法流水线 |
| Load pipe / Store pipe | 加载流水线 / 存储流水线 |
| Floating Point execute | 浮点执行 |
| NEON register file | NEON 寄存器堆 |
| MUL/DIV/SQRT pipe / ALU pipe | 乘法、除法、平方根流水线 / ALU 流水线 |
取指的四个周期包含一个地址生成单元,它通过递增上一个 PC,或使用以下四种预测器之一,产生下一个 PC:
- 单项分支目标缓存,包含两次指令缓存取指的内容,即假定预测正确时,分支之后的两条指令。第一个取指周期检查这个目标缓存;若命中,便由它提供接下来的两条指令。命中且预测正确时,分支执行没有延迟周期。
- 3072 项混合预测器,用于所有未在分支目标缓存中命中的指令,在 F3 工作。由该预测器处理的分支有 2 个周期延迟。
- 256 项间接分支预测器,在 F4 工作;预测正确时,由它预测的分支有 3 个周期延迟。
- 深度为 8 的返回栈,在 F4 工作,产生 3 个周期延迟。
译注:图注按 F1、F2 两级取指说明“8 级”整数流水线,原图与后文则明确列出 F1~F4 四个取指周期;原书两种描述均予保留。
分支在 ALU 流水线 0 中判定,因此错误预测的代价为 8 个周期。图 3.34 给出了 SPECint2006 的错误预测率。被浪费的工作量,既取决于错误预测率,也取决于沿错误分支路径执行期间维持的发射速率。如图 3.35 所示,浪费的工作量总体上随错误预测率变化,但可能更大,偶尔也可能更小。
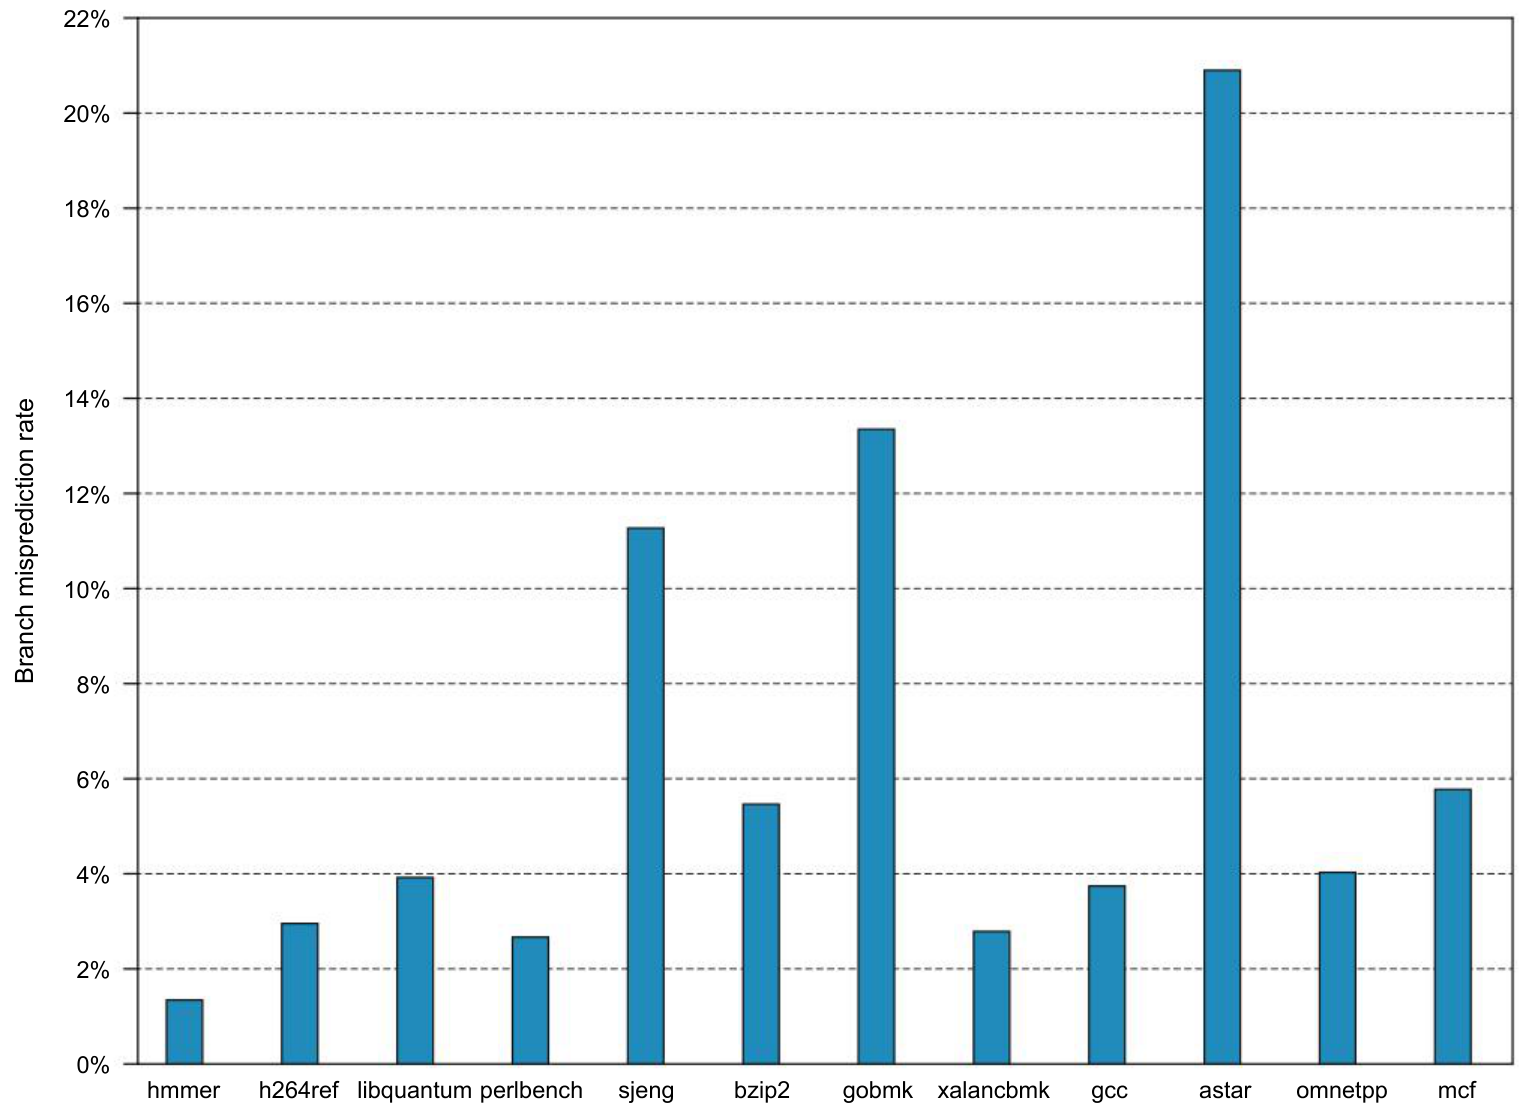
图 3.34 A53 分支预测器在 SPECint2006 上的错误预测率。纵轴 Branch misprediction rate=分支错误预测率,范围 0%~22%;横轴为各基准测试名称。
A53 流水线的性能
由于采用双发射结构,A53 的理想 CPI 为 0.5。流水线停顿有三个来源:
- 功能冒险:选中同时发射的两条相邻指令,需要使用同一条功能流水线。由于 A53 是静态调度处理器,编译器应尽量避免这种冲突。如果这样的指令连续出现,它们会在执行流水线起点串行化,只有第一条指令开始执行。
- 数据冒险:在流水线较早阶段检测到,可能使两条指令都停顿,也可能仅使一对指令中的第二条停顿。如果第一条不能发射,第二条必然停顿。同样,编译器应尽可能避免这类停顿。
- 控制冒险:只在分支预测错误时出现。
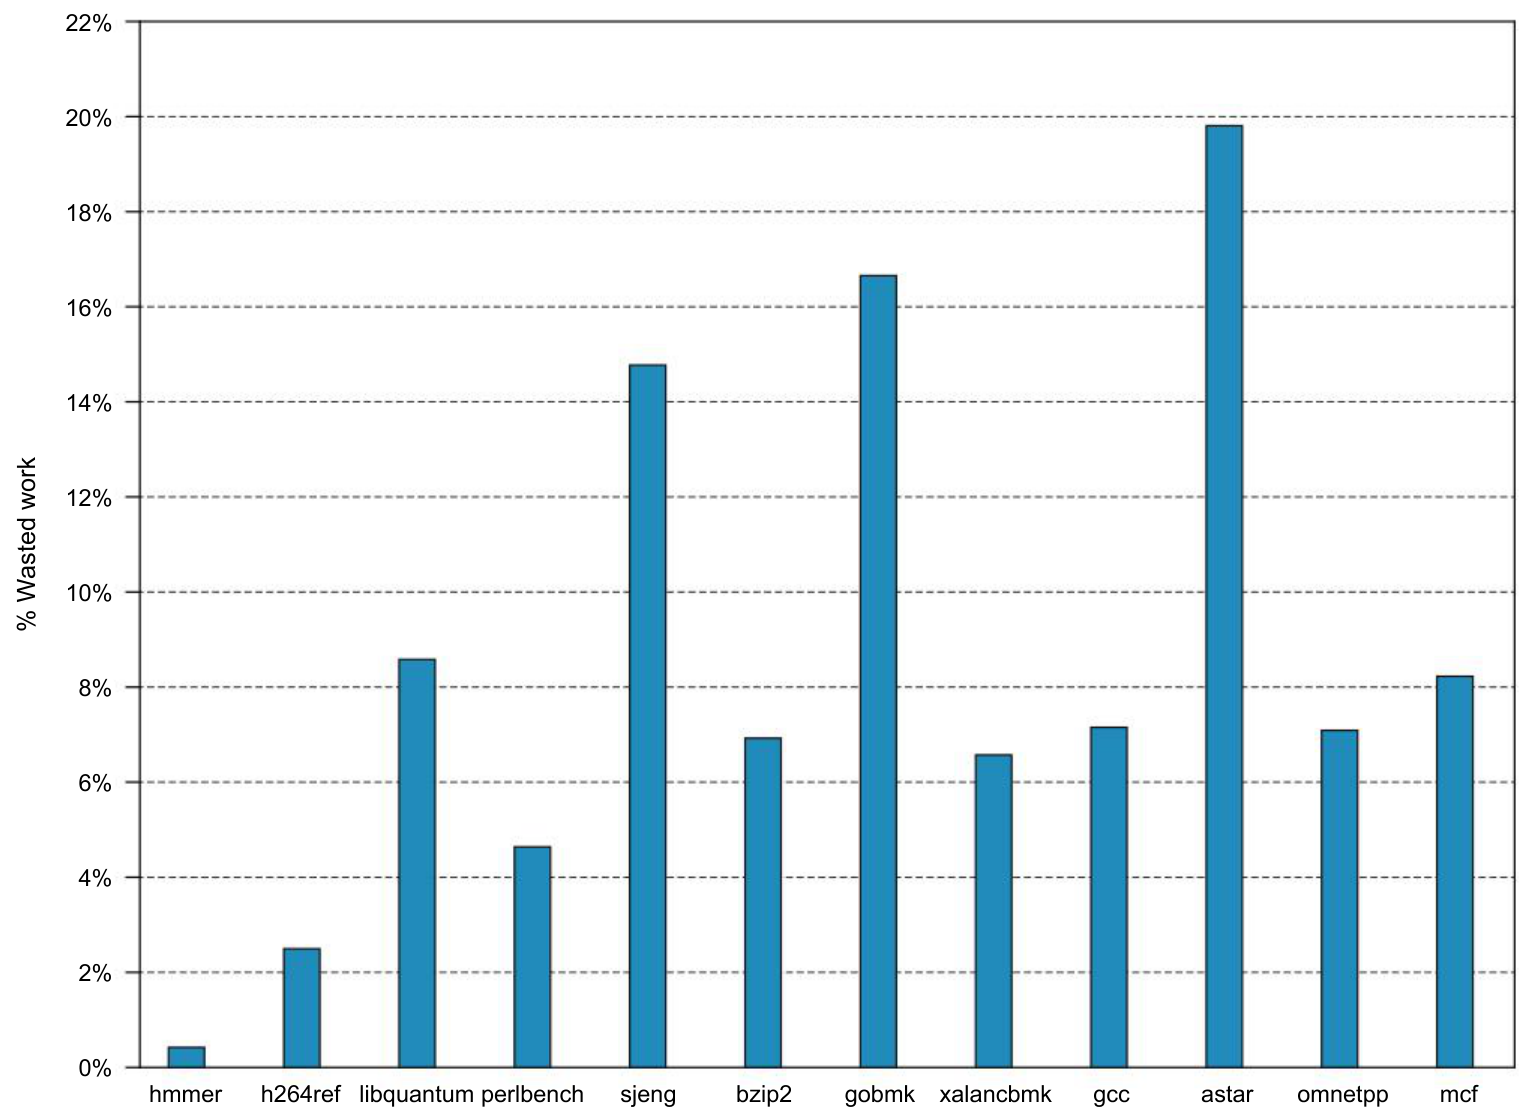
图 3.35 A53 因分支预测错误而浪费的工作。A53 是顺序执行处理器,因此,浪费的工作量取决于多种因素,包括数据依赖和缓存未命中;两者都会引起停顿。纵轴 % Wasted work=浪费的工作占比,范围 0%~22%;横轴为各基准测试名称。
TLB 未命中和缓存未命中也会造成停顿。在指令一侧,TLB 或缓存未命中会推迟指令队列的填充,很可能导致流水线下游停顿。当然,这取决于未命中类型:如果是 L1 未命中,且当时指令队列已满,延迟可能大部分被隐藏;如果是 L2 未命中,耗时就长得多。在数据一侧,缓存或 TLB 未命中会使流水线停顿,因为引起未命中的加载或存储无法继续向流水线后方推进,所有后续指令也就停顿。图 3.36 展示了 CPI 及各类因素贡献的估计值。
A53 采用较浅的流水线和相当积极的分支预测器,使流水线损失保持较小,并能以适中的功耗达到较高时钟频率。与 i7 相比,四核 A53 处理器的功耗约为其 1/200!总体上,A53 是非常成功的低功耗超标量处理器,经常与更高性能的 Arm 核心组成 big.LITTLE 配置。
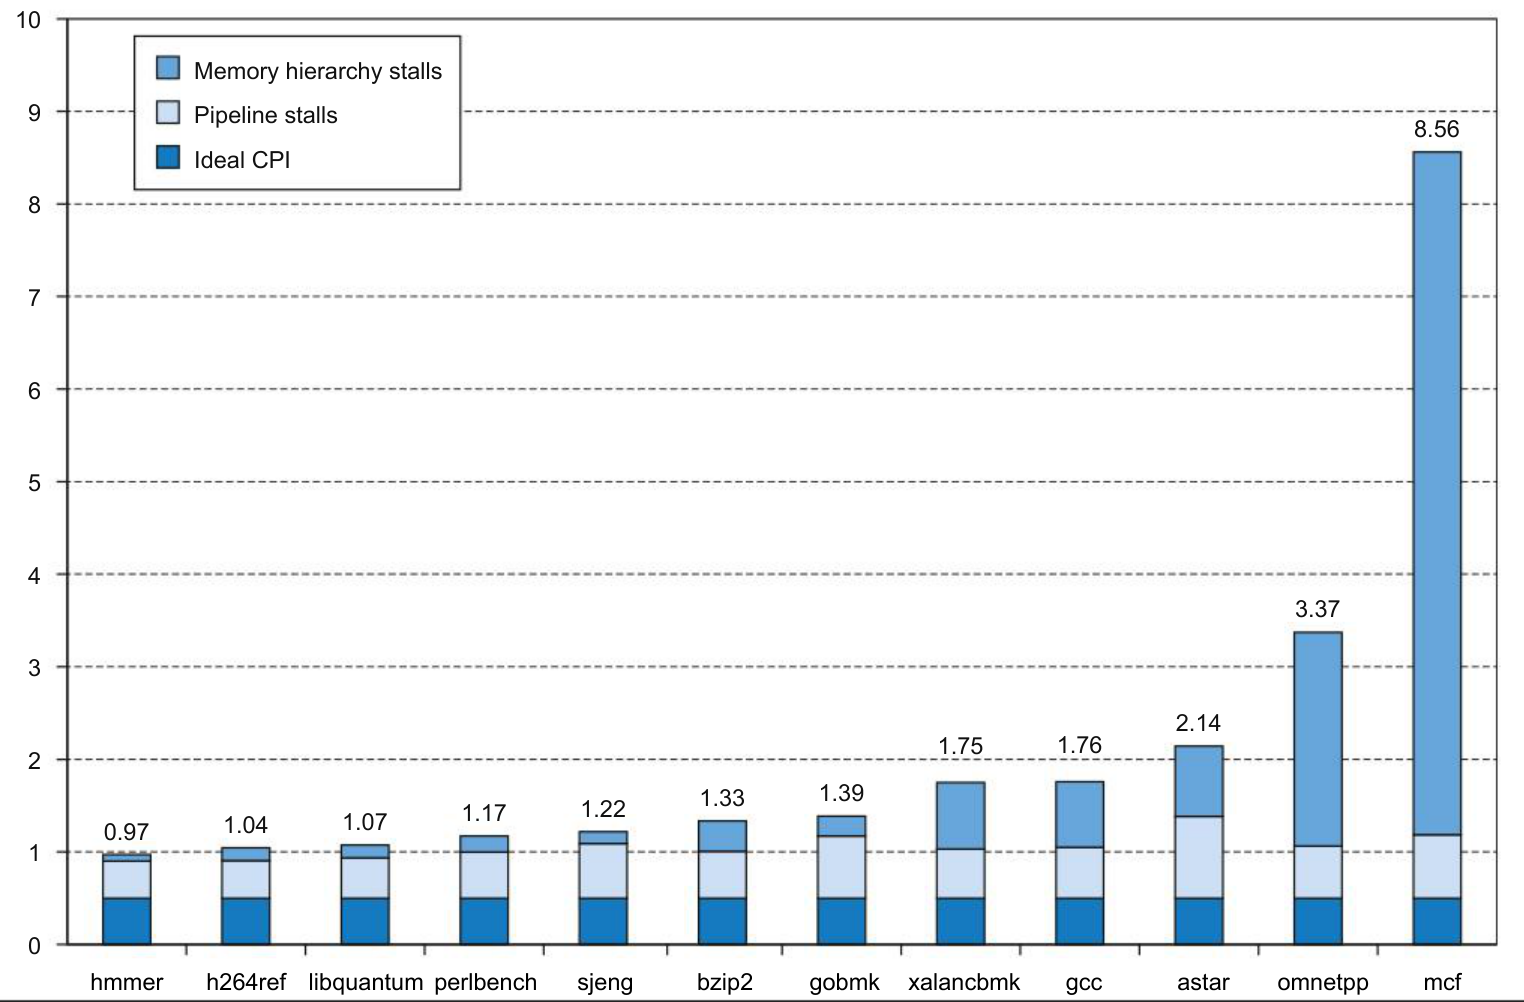
图 3.36 Arm A53 的 CPI 组成估计表明,流水线停顿相当显著,但在性能最差的程序中,缓存未命中的影响更大。估计方法是:用 L1、L2 未命中率及其代价,计算它们造成的每条指令停顿周期数,再从详细模拟器测得的 CPI 中减去这些部分,得到流水线停顿。流水线停顿包含上述三种冒险。
图中文字:Memory hierarchy stalls=存储层次结构停顿;Pipeline stalls=流水线停顿;Ideal CPI=理想 CPI。各程序总 CPI 依次为:hmmer 0.97、h264ref 1.04、libquantum 1.07、perlbench 1.17、sjeng 1.22、bzip2 1.33、gobmk 1.39、xalancbmk 1.75、gcc 1.76、astar 2.14、omnetpp 3.37、mcf 8.56。
Intel Golden Cove
Golden Cove 是一种采用激进乱序执行(OOO)与推测的微体系结构,旨在提高核心从单线程中开发指令级并行性的能力(Rotem 等,2022)。Golden Cove 核心还支持两个线程的 SMT 执行,Intel 自 2008 年以来的所有高端微体系结构均如此。Golden Cove 于 2021 年发布,是 Sunny Cove 微体系结构的后继。图 3.37 展示了其流水线的整体结构,以及许多关键结构的容量。
取指。 x86 指令长度从 1~15 字节不等,因此其指令供给尤其复杂。Golden Cove 前端每周期从指令缓存取 32 字节,用 6 个译码器把 x86 指令转换为类似 RISC 的微操作,再放入 144 项微操作队列。这种将 x86 指令集转换为更易流水化的简单操作的方法,于 1997 年在 Pentium Pro 中引入,之后一直沿用。对于语义更复杂的 x86 指令,微码引擎负责产生微操作序列:每周期最多生成 4 个微操作,持续工作直到所需序列全部生成。
前端包含微操作缓存,可保存 4K 个已译码微操作,每周期最多向微操作队列提供 8 个微操作。借助它,可以不使用指令缓存和译码器而供应指令。此外,循环流检测器(loop stream detector,LSD)跟踪能够容纳在微操作队列中的循环。LSD 允许微操作队列不断向后端供应指令,直到最终出现分支预测错误、终止循环流。单线程模式下,LSD 允许前端其他部分休眠,节省功耗。SMT 模式下,如果一个线程使用 LSD,就可以将更多前端资源用于加快另一个线程的指令供给。
为了更好地支持代码规模较大的工作负载,Golden Cove 的指令 TLB 是 Sunny Cove 的两倍:针对 4 KB 页面有 256 项,针对 2 MB/4 MB 页面有 32 项。代码预取也有所改进。虽然分支预测器的组织方式保密,但已知若干结构扩大了容量。二级分支目标缓冲区有 12K 项,而 Ice Lake 为 5K 项。
乱序执行引擎。 Golden Cove 用一个大型的 512 项 ROB 支持乱序执行。每周期最多重命名 6 个微操作,并将其发射到协调各功能单元执行的调度器。硬件能识别某些可优化的 x86 指令惯用模式。例如,将寄存器清零、或在寄存器之间移动值的指令,不必调度到功能单元上执行。
算术微操作调度器有 97 项,同时服务整数与浮点操作。利用其 5 个端口,每周期最多向整数功能单元发射 5 个已就绪微操作,并可向浮点及向量功能单元发射最多 3 个微操作。Golden Cove 实现了若干面向数据中心和 HPC 工作负载的 x86 ISA 扩展,包括 512 SIMD 指令(AVX-512),支持机器学习工作负载使用的 Brain Floating-point(BF16)格式、8 位整数(INT8)等数据类型。第 7 章将讨论较窄数据类型对机器学习的意义。Golden Cove 是首个实现面向机器学习工作负载的高级矩阵扩展(advanced matrix extensions,AMX)的 Intel 微体系结构。
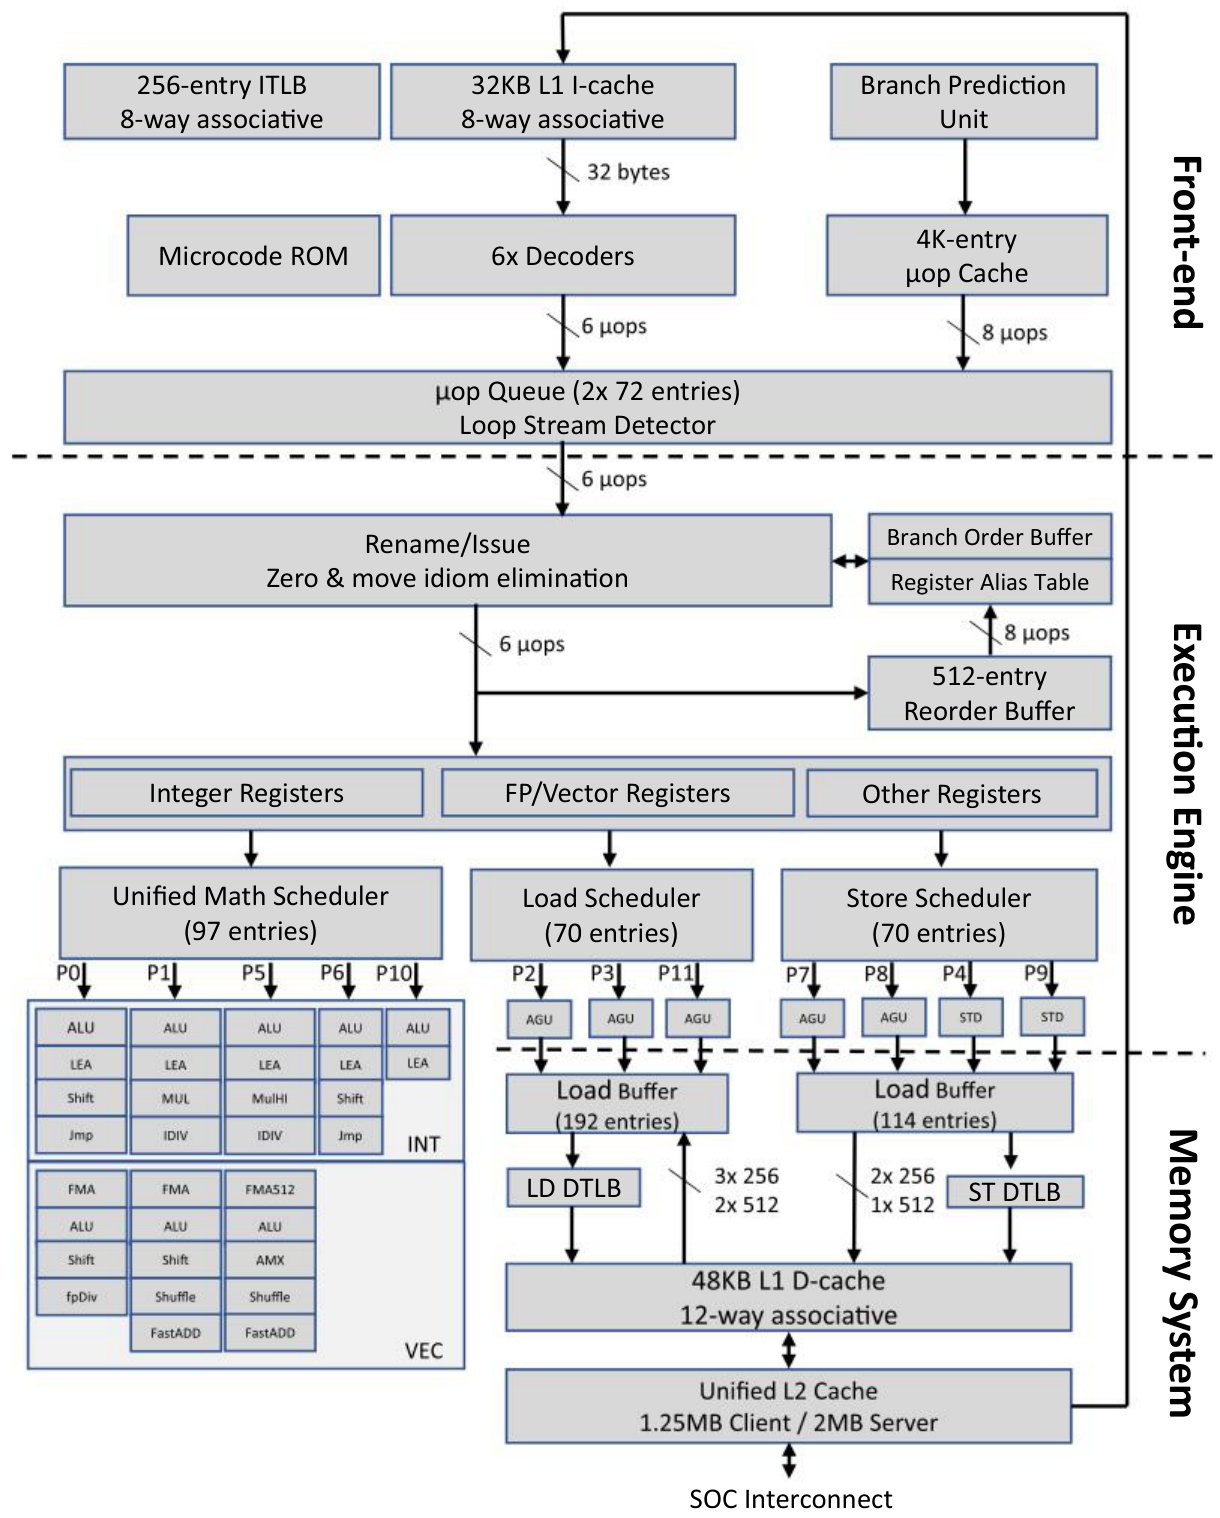
图 3.37 Intel Gold Cove 微体系结构框图。乱序核心每周期最多发射 6 个微操作,派发 12 个微操作,退役 8 个微操作。
图中文字对照:
| 原文 | 中文 |
|---|---|
| Front-end / Execution Engine / Memory System | 前端 / 执行引擎 / 存储系统 |
| 256-entry ITLB, 8-way associative | 256 项指令 TLB,8 路组相联 |
| 32KB L1 I-cache, 8-way associative | 32 KB L1 指令缓存,8 路组相联 |
| Branch Prediction Unit | 分支预测单元 |
| Microcode ROM / 6x Decoders | 微码 ROM / 6 个译码器 |
| 4K-entry μop Cache | 4K 项微操作缓存 |
| μop Queue (2x 72 entries) / Loop Stream Detector | 微操作队列(2×72 项)/ 循环流检测器 |
| Rename/Issue / Zero & move idiom elimination | 重命名、发射 / 消除清零与移动惯用操作 |
| Branch Order Buffer / Register Alias Table | 分支顺序缓冲区 / 寄存器别名表 |
| 512-entry Reorder Buffer | 512 项重排序缓冲区 |
| Integer Registers / FP/Vector Registers / Other Registers | 整数寄存器 / 浮点、向量寄存器 / 其他寄存器 |
| Unified Math Scheduler (97 entries) | 统一算术调度器(97 项) |
| Load Scheduler (70 entries) / Store Scheduler (70 entries) | 加载调度器(70 项)/ 存储调度器(70 项) |
| Load Buffer (192 entries) / Load Buffer (114 entries) | 加载缓冲区(192 项)/ 加载缓冲区(114 项,原图如此) |
| LD DTLB / ST DTLB | 加载数据 TLB / 存储数据 TLB |
| 48KB L1 D-cache, 12-way associative | 48 KB L1 数据缓存,12 路组相联 |
| Unified L2 Cache, 1.25MB Client / 2MB Server | 统一 L2 缓存,客户端 1.25 MB / 服务器 2 MB |
| SOC Interconnect | SoC 互连 |
| P0~P11 | 端口编号 |
| AGU / STD | 地址生成单元 / 存储数据单元 |
| INT / VEC | 整数 / 向量 |
| ALU / LEA | 算术逻辑单元 / 有效地址计算 |
| Shift / Jmp | 移位 / 跳转 |
| MUL / MulHI / IDIV | 乘法 / 取高位乘法 / 整数除法 |
| FMA / FMA512 / AMX | 融合乘加 / 512 位融合乘加 / 高级矩阵扩展 |
| fpDiv / Shuffle / FastADD | 浮点除法 / 重排 / 快速加法 |
| bytes / μops / entries | 字节 / 微操作 / 项 |
图中数据通路旁的 3×256、2×512、2×256、1×512,以及各端口与功能单元的对应关系,均保留原图。
译注:原图注写作 “Gold Cove”,正文为 “Golden Cove”;图中的存储调度器为 70 项,下一页正文为 38 项;存储一侧 114 项缓冲区也误标为 Load Buffer,正文则称 store buffer。以上均保留原页内容并分别说明。正文 “512 SIMD instructions” 未写位数单位,译文亦未擅补。
AMX 定义了一个新的二维寄存器堆,共 8 个寄存器;每个寄存器是由 16 行、每行 64 字节组成的数组。它还定义了一组矩阵乘法指令,可按不同二维形状操作这些寄存器,最高每周期执行 2K 次 Int8 运算。70 项加载调度器每周期可向 3 个地址生成单元供给操作。38 项存储调度器每周期可向 2 个地址生成单元和 2 个存储数据单元供给操作。
Golden Cove 通过 128 项分支顺序缓冲区,从分支预测错误中恢复(Boggs 等,2004)。遇到可能预测错误的条件分支与间接分支指令时,该缓冲区为寄存器重命名状态保存快照。一旦检测到错误预测,就丢弃所有更年轻的指令,恢复该分支之前的最后一份快照,然后从正确目标恢复取指。在错误预测恢复期间,更早的指令继续执行,无需等待错误预测指令到达 ROB 队首,也无需清空整条流水线。
存储子系统。 Golden Cove 每周期最多处理 3 次 32 字节加载,或 2 次 64 字节加载;同时最多处理 2 次 64 字节存储。流水线包含 192 项加载缓冲区和 114 项存储缓冲区,通过推测式内存消歧,发掘加载与存储之间的并行性。Golden Cove 支持存储转发,包括加载开头的一部分字节由存储转发、其余字节从数据缓存读取的情况。
48 KB L1 数据缓存采用 12 路组相联,命中时,从加载到使用结果的延迟为 5 个周期。填充缓冲区最多跟踪 16 次未完成的 L1 缓存未命中。L2 缓存容量为 1.25 MB(客户端芯片)或 2 MB(服务器芯片),延迟为 15 个周期,每周期可提供 64 字节数据。Golden Cove 改进了 L1 与 L2 的预取器。L2 缓存包括基于模式的多路径预取器,采用基于反馈的自适应预取限流。L2 缓存可同时保留 48 个未完成的未命中或预取请求。
加载操作的地址转换使用一个 TLB:针对 4 KB 页面有 96 项、6 路组相联;针对 2 MB/4 MB 页面有 32 项、4 路组相联;针对 1 GB 页面有 8 项。存储操作使用一个支持所有页面大小的 16 项 TLB。所有一级指令与数据 TLB 的后方,都有一个 2K 项二级 TLB(STLB)。STLB 未命中送往页面未命中处理器(page miss handler,PMH),它最多可以并行执行 4 次页表遍历。
与前代 Intel 微体系结构的比较。 图 3.38 将 Golden Cove 的关键特性,与 Skylake(2015)及 Sunny Cove(2019)比较。Golden Cove 的 ILP 能力显著提高:译码、发射、派发、退役各阶段,每周期都能处理更多指令;与前代相比,所有关键缓冲结构也都更大。同时,Golden Cove 核心还能达到较高频率,已公布的客户端与服务器产品最高频率分别为 5.5 GHz 和 4.2 GHz。
| 特性 | Skylake(2015) | Sunny Cove(2019) | Golden Cove(201,原文年份) |
|---|---|---|---|
| 微操作队列(每 SMT 线程) | 64 | 70 | 72 |
| 微操作缓存容量 | 1,500 | 2,304 | 4,096 |
| 保留站(整数+浮点) | 97 | 97 | 80 |
| 整数寄存器 | 180 | 280 | 280 |
| 浮点寄存器 | 168 | 224 | 332 |
| 未完成加载缓冲区 | 72 | 128 | 192 |
| 未完成存储缓冲区 | 56 | 72 | 114 |
| 重排序缓冲区 | 256 | 352 | 512 |
| 每周期取指字节数 | 16 | 16 | 32 |
| 指令译码器数量 | 1 个复杂+5 个简单 | 4 | 6 |
| 每周期发射指令数 | 4 | 5 | 6 |
| 通往功能单元的调度器端口数 | 8 | 10 | 12 |
| 每周期退役指令数 | 4 | 4 | 8 |
图 3.38 Intel 三代乱序微体系结构的特性。为了开发更多 ILP,关键流水线阶段(译码、发射、派发、退役)的宽度,以及关键缓冲区、队列、寄存器堆的容量,多年来持续增大。各种缓冲区的容量选择有时看似随意,实际上很可能以大量模拟为依据。
译注:原表 Golden Cove 年份为“201”,本节正文为 2021;原表整数与浮点保留站为 80 项,而前文及图 3.37 的统一算术调度器为 97 项。表中数据忠实保留,不将两种口径擅自统一。
Golden Cove 核心的性能
图 3.39 展示了 Golden Cove 核心以单线程模式运行 10 个 SPECPUint2017 基准测试的性能特征。CPI 在 0.32~0.89 之间,也就是说,核心平均每周期执行 1.11~3.14 条指令。CPI 与错误预测率、缓存未命中率、TLB 未命中率有较强相关性。例如,mcf 实现了网络单纯形法,用来解决公共交通车辆调度等最小费用流问题。该方法用寻找环、修改生成树等可快速完成的网络操作,替代一般单纯形算法中的线性代数。因此,这个基准测试包含依赖数据的分支,以及不可预测的指针访问,导致较高的分支错误预测率,以及存储层次结构各级较高的缓存未命中率。仅仅分支错误预测率高,就足以使核心缺少有用指令可执行;leela 就是如此,它是一个采用 Monte Carlo 局面估计的围棋引擎。对于用于垃圾邮件过滤的 Perl 脚本 perlbench、H.264/MPEG-4 AVC 视频编码程序 x264,以及生成数独题目的递归程序 exchange2 等基准测试,Golden Cove 的预测器与缓存表现良好,使后端能够开发大量 ILP。
图 3.40 展示了以双线程模式运行这 10 个 SPECCPUint2017 基准测试的性能收益。与单线程相比,Golden Cove 核心运行两个 SMT 线程时,吞吐量提高 5%~46%。对于单线程性能较低的基准测试,SMT 收益通常较大,例如 mcf 为 46%,leela 为 45%。这些基准测试未充分利用核心资源,使第二个 SMT线程仍能以相当可观的吞吐量执行。当双插槽系统中的全部 112 个核心都以双线程模式运行时,SMT 收益为 5%~37%。例如,访存密集的 mcf,仅一个核心活动时 SMT 收益为 46%,所有核心活动时则降至 27%,因为每个插槽中的 112 个线程会争用共享 L3 缓存与主存系统资源。总体而言,对 SPECPUint2017 rate 的几何平均值,SMT 的收益在单核时为 27%,双插槽系统时为 16%。虽然更宽的乱序流水线对各种单线程工作负载的收益并不相同,但 SMT 带来的显著吞吐量提升,证明了这种设计的价值。
| 指标 | perlbench_r | gcc_r | mcf_r | omnetpp_r | xalancbmk_r | x264_r | deepsjeng_r | leela_r | exchange2_r | xz_r |
|---|---|---|---|---|---|---|---|---|---|---|
| SpecRate | 6.68 | 7.84 | 7.12 | 6.31 | 7.9 | 16.43 | 5.5 | 4.97 | 17.53 | 3.92 |
| CPI | 0.328 | 0.577 | 0.899 | 0.717 | 0.505 | 0.321 | 0.512 | 0.666 | 0.318 | 0.730 |
| L1 数据缓存未命中率 | 1.33% | 7.81% | 14.85% | 8.90% | 14.20% | 2.05% | 1.29% | 1.21% | 0.03% | 5.02% |
| L2 未命中率 | 14.29% | 39.58% | 32.13% | 46.19% | 24.50% | 11.44% | 15.45% | 20.65% | 40.63% | 23.51% |
| L3 未命中率 | 8.89% | 23.67% | 59.06% | 23.01% | 2.05% | 31.62% | 66.67% | 1.43% | 0.00% | 24.03% |
| L1D MPKI | 3.88 | 22.08 | 38.25 | 29.33 | 38.2 | 4.33 | 3.04 | 3.19 | 0.1 | 12.51 |
| L2 MPKI | 1.35 | 11.83 | 12.36 | 13.95 | 9.77 | 1.36 | 1.38 | 0.7 | 0.13 | 3.08 |
| L3 MPKI | 0.12 | 2.8 | 7.3 | 3.21 | 0.2 | 0.43 | 0.92 | 0.01 | 0 | 0.74 |
| 数据 TLB MPKI | 0.1 | 0.45 | 1.56 | 3.36 | 0.11 | 0.04 | 0.23 | 0.01 | 0 | 1.43 |
| 分支错误预测率 | 0.49% | 1.30% | 8.77% | 2.06% | 0.28% | 1.46% | 4.04% | 9.44% | 1.81% | 3.95% |
图 3.39 Golden Cove 核心单线程运行 SPECCPUint2017 基准测试的关键性能特征。测量平台是双插槽 Sapphire Rapids 系统,每插槽 56 个核心、8 条 DDR5-4800 通道。基准测试二进制程序由 Intel ICC 18 编译,采用 AVX2 指令。MPKI 表示每 1000 条指令的未命中次数。
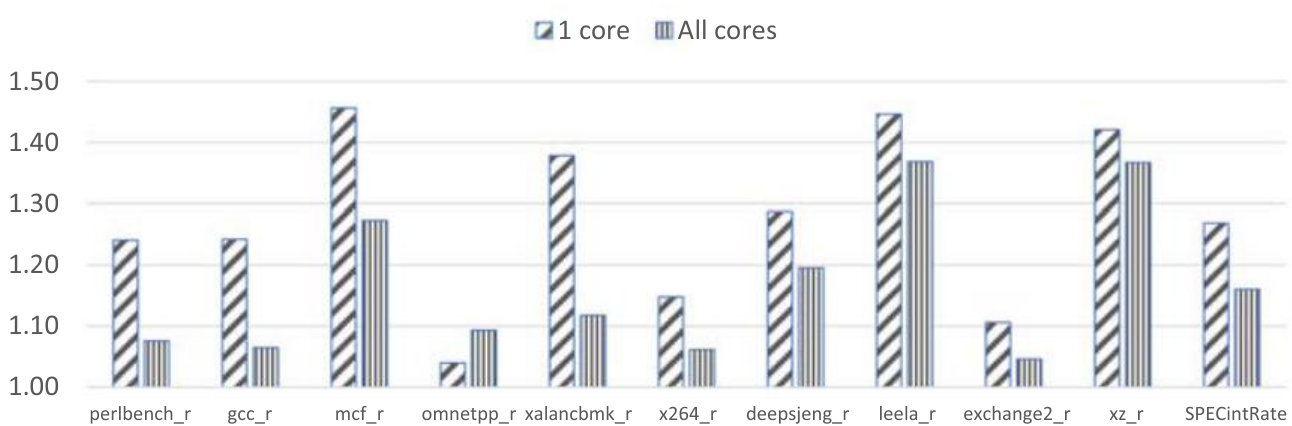
图 3.40 Sapphire Rapids 系统运行 SPECCPUint2017 基准测试时,每核使用两个 SMT 线程的性能收益。测试配置与图 3.39 相同。图中分别给出仅使用一个核心(最多两个 SMT 线程),以及使用双插槽系统全部 112 个核心(最多 224 个 SMT 线程)时的收益。图例 1 core=一个核心;All cores=所有核心;纵轴为相对性能,横轴保留基准测试及 SPECintRate 名称。
图 3.41 给出了双插槽系统全部 112 个核心都运行 SMT 时,每核的性能特征。图 3.38 与图 3.40 之间,分支错误预测率、L1 和 L2 未命中率的差异,来自核心资源竞争。
L3 未命中率的差异,则来自两个插槽上所有线程之间的资源竞争。例如,gcc 的每 1000 条指令 L3 缓存未命中次数(MPKI),从一个线程时的 2.8(图 3.38),增加到 224 个线程时的 20.2(图 3.40)。这一增长凸显了缓存与存储系统设计的重要性,尤其是对同时执行数百个线程的多核芯片。还要注意,开启 SMT 后,每线程 CPI 会增加。例如,从图 3.38 到图 3.40,perlbench 的 CPI 从 0.328 增加至 0.590。但此时有两个线程以这个速率执行指令,因此,核心整体的有效吞吐量增益为:
即提高 11.1%。
| 指标 | perlbench_r | gcc_r | mcf_r | omnetpp_r | xalancbmk_r | x264_r | deepsjeng_r | leela_r | exchange2_r | xz_r |
|---|---|---|---|---|---|---|---|---|---|---|
| CPI(每线程) | 0.590 | 1.260 | 1.420 | 1.950 | 0.958 | 0.556 | 0.794 | 0.934 | 0.552 | 1.150 |
| L1 数据缓存未命中率 | 1.85% | 9.10% | 18.98% | 10.43% | 17.03% | 2.96% | 2.68% | 1.92% | 0.00% | 7.37% |
| L2 未命中率 | 11.32% | 42.70% | 25.63% | 43.99% | 19.01% | 6.63% | 12.17% | 10.36% | 0.00% | 23.12% |
| L3 未命中率 | 82.96% | 65.62% | 78.92% | 80.76% | 63.95% | 77.78% | 81.21% | 35.19% | 0.00% | 71.43% |
| L1D MPKI | 5.53 | 26.74 | 48.47 | 35.1 | 47.14 | 6.32 | 6.39 | 5.16 | 0.01 | 17.82 |
| L2 MPKI | 1.35 | 15.27 | 12.43 | 15.85 | 9.32 | 0.9 | 1.49 | 0.54 | 0 | 4.13 |
| L3 MPKI | 1.12 | 10.02 | 9.81 | 12.8 | 5.96 | 0.7 | 1.21 | 0.19 | 0 | 2.95 |
| 数据 TLB MPKI | 0.15 | 0.6 | 1.32 | 4.53 | 0.11 | 0.01 | 0.24 | 0 | 0 | 1.78 |
| 分支错误预测率 | 0.63% | 1.11% | 9.04% | 1.97% | 0.29% | 1.38% | 4.22% | 9.86% | 1.91% | 4.03% |
图 3.41 共 112 核的双插槽系统以双线程模式运行 SPECCPUint2017 基准测试时,单个 Golden Cove 核心的关键性能特征。测试配置与图 3.39 相同。这里给出每个 SMT 线程的 CPI;MPKI 表示每 1000 条指令的未命中次数。
译注:最后两段把单线程与双线程性能表引用为图 3.38、3.40,实际对应图 3.39、3.41。正文
gcc的双线程 L3 MPKI 为 20.2,而图 3.41 为 10.02。按给出的 CPI 复算,,正文 1.111 与 11.1% 沿用原文;这只是算术核查,不消除表格与图表测量口径上的差异。