3.14 谬误与陷阱
本节几个谬误主要围绕这样的问题:很难预测性能和能效,也很难从时钟频率或 CPI 等单一指标外推性能。我们还将说明,不同体系结构方案面对不同基准测试,可能表现出截然不同的行为。
谬误:只要工艺不变,就很容易预测同一指令集体系结构两个不同版本的性能与能效
2008 年,Intel 为低端上网本和个人移动设备(PMD)市场推出了 Atom 230 处理器,同时实现 x86 体系结构的 64 位和 32 位版本。Atom 是静态调度、双发射超标量处理器,其微体系结构与 Arm A8 非常相似;A8 是 A53 的单核前代。2008 年,Intel 还推出了基于乱序 Nehalem 微体系结构的 Core i7 920。有意思的是,Atom 230 和 Core i7 920 都采用 Intel 的同一 45 nm 工艺制造。图 3.42 概述了 Intel Core i7 920、Arm Cortex-A8 和 Intel Atom 230。这些共同点提供了一个难得的机会:在底层制造工艺不变的情况下,直接比较同一指令集的两种截然不同的微体系结构。在比较之前,还需要进一步介绍 Atom 230。
| 类别 | 具体特性 | Intel i7 920:四核,每核有浮点单元 | ARM A8:单核,无浮点单元 | Intel Atom 230:单核,有浮点单元 |
|---|---|---|---|---|
| 芯片物理特性 | 时钟频率 | 2.66 GHz | 1 GHz | 1.66 GHz |
| 芯片物理特性 | 热设计功耗 | 130 W | 2 W | 4 W |
| 芯片物理特性 | 封装 | 1366 引脚 BGA | 522 引脚 BGA | 437 引脚 BGA |
| 存储系统 | TLB | 两级;均为 4 路组相联;128 项指令 / 64 项数据;L2 512 项 | 一级,全相联;32 项指令 / 32 项数据 | 两级;均为 4 路组相联;16 项指令 / 16 项数据;L2 64 项 |
| 存储系统 | 缓存 | 三级;L1 32 KiB / 32 KiB;L2 256 KiB;L3 2~8 MiB | 两级;L1 16/16 或 32/32 KiB;L2 128 KiB~1 MiB | 两级;L1 32/24 KiB;L2 512 KiB |
| 存储系统 | 峰值内存带宽 | 17 GB/s | 12 GB/s | 8 GB/s |
| 流水线结构 | 峰值发射速率 | 每周期 4 次操作,支持融合 | 每周期 2 次操作 | 每周期 2 次操作 |
| 流水线结构 | 流水线调度 | 推测、乱序 | 顺序、动态发射 | 顺序、动态发射 |
| 流水线结构 | 分支预测 | 两级 | 两级;512 项 BTB;4K 全局历史;8 项返回栈 | 两级 |
图 3.42 四核 Intel i7 920、一个典型 Arm A8 处理器芯片实例(256 MiB L2、32 KiB L1,无浮点单元),以及 Intel Atom 230 的概况,清楚展示了两类设计理念的区别:一类面向 PMD(Arm)或上网本(Atom),另一类面向服务器和高端桌面机。注意,i7 有四个核心,每个核心的性能都高于单核 A8 或 Atom。所有这些处理器均采用可比较的 45 nm 工艺实现。
译注:原图注写作“256 MiB L2”,而表中 A8 的 L2 范围为 128 KiB~1 MiB;原页单位如此,未默改为 KiB。
Atom 使用标准方法实现 x86 体系结构:把 x86 指令转换为类似 RISC 的微操作,正如自 20 世纪 90 年代中期以来每一种 x86 实现所做的那样。Atom 的微操作稍强一些,允许将算术操作与加载或存储配对;后来的乱序微体系结构通过宏融合(macrofusion)加入了这种能力。这项优化意味着,对于典型指令组合,平均只有 4% 的指令需要不止一个微操作。随后,微操作在深度为 16 的流水线中执行;与 Arm A8 一样,它能够每周期顺序发射两条指令。Atom 有两个整数 ALU,为浮点加法和其他浮点操作设置独立流水线,还有两条内存操作流水线,因此支持比 Arm A8 更一般的双操作执行,但仍受顺序发射能力限制。
Atom 230 有 32 KiB 指令缓存和 24 KiB 数据缓存,它们共同使用同一裸片上的 512 KiB L2。(Atom 230 也支持两个线程的多线程执行,但这里仅比较单线程。)
我们可能预期,采用相同工艺和相同指令集的 Core i7 与 Atom 230,在相对性能和能耗方面表现得可预测,也就是说,功耗与性能近似线性变化。我们用三组基准测试检验这个假设。第一组是来自 DaCapo 与 SPEC JVM98 的 Java 单线程基准测试,相关基准与测量的讨论见 Esmaeilzadeh 等(2011)。第二、第三组来自 SPEC CPU2006,分别是整数和浮点基准测试。
图 3.43 表明,i7 的性能明显高于 Atom。在所有基准测试中,i7 的性能都至少是 Atom 的 4 倍;其中两个 SPECFP 基准测试超过 10 倍,一个 SPECINT 基准测试超过 8 倍!两者时钟频率之比为 1.6,因此,大部分优势来自 i7 920 低得多的 CPI:Java、SPECINT、SPECFP 基准测试的 CPI 比值分别为 2.8、3.1、4.3。
但 i7 920 的平均功耗略低于 43 W,Atom 的平均功耗为 4.2 W,仅约十分之一!结合性能与功耗来看,Atom 的能效通常超过 i7 的 1.5 倍,而且经常达到 2 倍!对采用相同底层工艺的这两个处理器的比较,清楚表明:采用动态调度和推测的激进超标量处理器,其性能优势伴随着显著的能效劣势。
谬误:CPI 更低的处理器总是更快
谬误:时钟频率更高的处理器总是更快
关键在于,决定性能的是 CPI 与时钟频率的乘积。通过加深处理器流水线取得较高频率时,还必须维持较低 CPI,才能充分发挥更快时钟的好处。同样,一个时钟频率较高、CPI 较低的简单处理器,也可能更慢。
译注:上述两句忠实保留原书措辞,但原文“CPI 与时钟频率的乘积”有误。正确关系为 ,或等价地乘以时钟周期时间。相同指令数下,性能取决于时钟频率与 CPI 的比值;最后一句也不能仅凭同时“频率高、CPI 低”得出更慢的结论。
前一个谬误已经说明,即使 ISA 相同,面向不同环境设计的处理器,性能与能效也可能相差很大。实际上,即便同一家公司的一组处理器都面向高端应用,性能也可能存在很大差异。图 3.44 给出了 Intel 两种不同 x86 实现,以及同样由 Intel 设计的一个 Itanium 实现的整数、浮点性能。
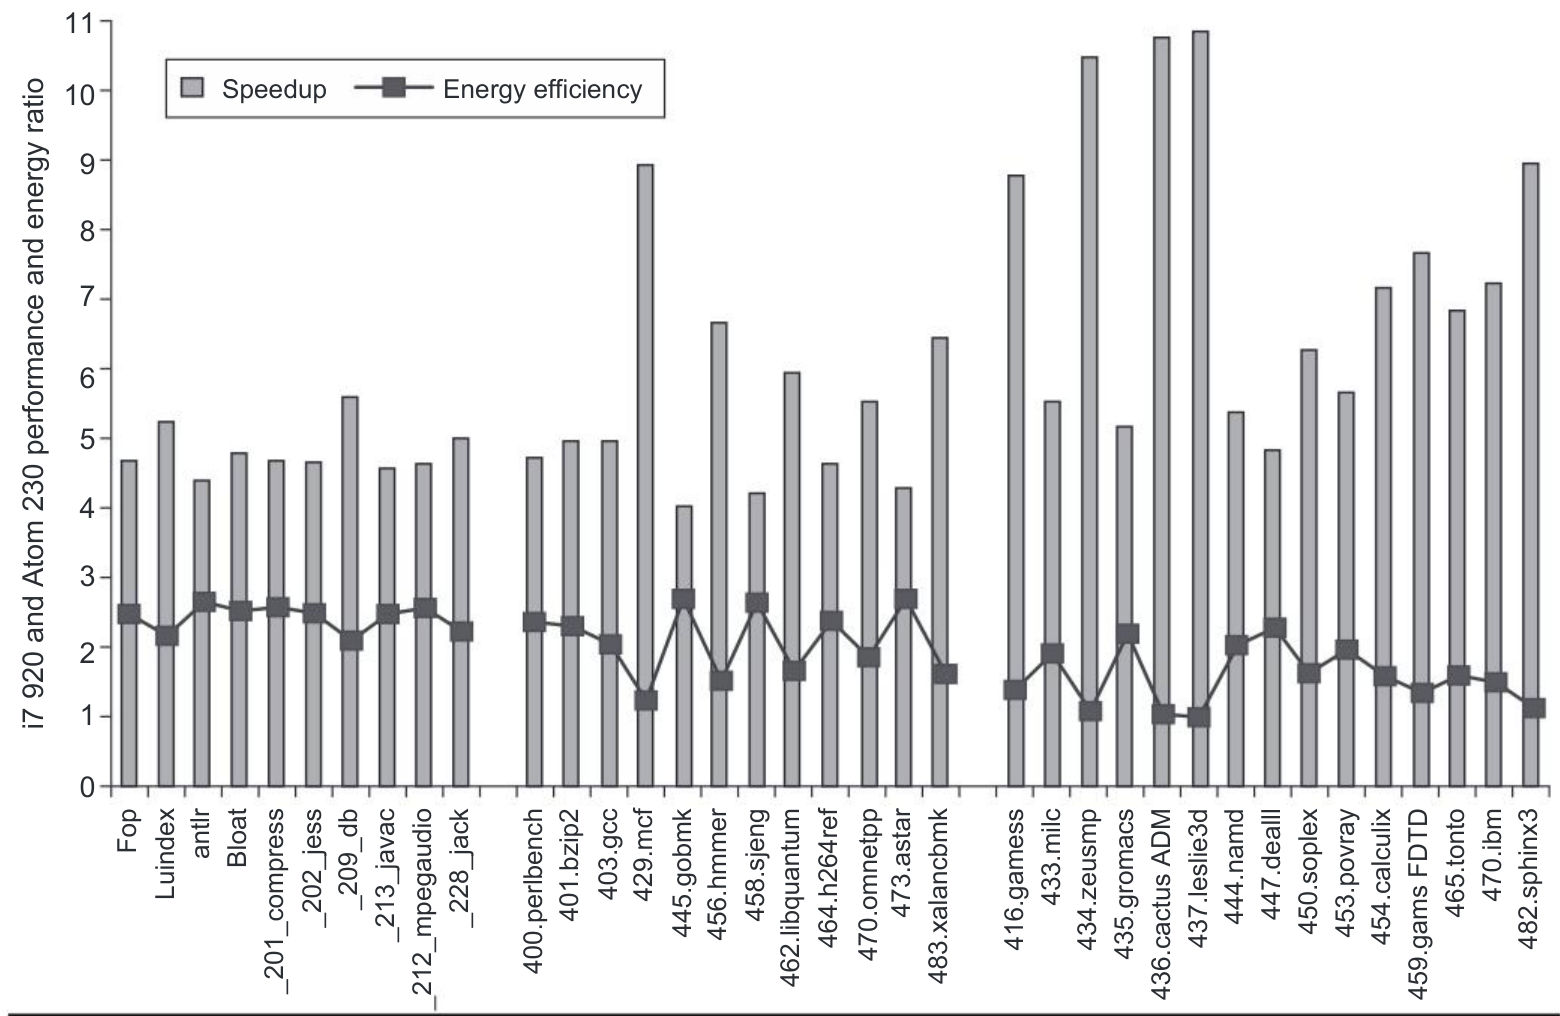
图 3.43 一组单线程基准测试上的相对性能与能效表明,i7 920 的性能为 Atom 230 的 4 倍至 10 倍以上,但平均功耗效率却只有约一半!柱状条表示 i7 相对 Atom 的性能,即执行时间(i7)/执行时间(Atom)。折线表示能耗(Atom)/能耗(i7)。i7 的能效从未优于 Atom,不过在四个基准测试上基本相当,其中三个是浮点基准测试。数据由 Esmaeilzadeh 等(2011)收集。SPEC 基准测试由标准 Intel 编译器优化编译,Java 基准测试使用 Sun(Oracle)Hotspot Java VM。i7 仅有一个核心处于活动状态,其余核心处于深度节能模式。i7 使用 Turbo Boost,扩大了性能优势,但相对能效略有下降。
图中文字:Speedup=加速比;Energy efficiency=能效;纵轴 i7 920 and Atom 230 performance and energy ratio=i7 920 与 Atom 230 的性能比和能耗比。横轴保留原基准测试名称。
译注:原图注的性能比公式分子、分母,与“i7 快 4~10 倍以上”及柱状图大于 1 的方向相反;加速比应为 Atom 执行时间 / i7 执行时间。折线多数大于 1,而正文说 Atom 更节能,因此图注的 Energy (Atom)/Energy (i7) 方向也与图形及文字结论不符。图注同时混用了 power efficiency 与 energy efficiency;译文区分其原措辞,未将原图数值或公式静默反转。
| 处理器 | 实现工艺 | 时钟频率 | 功率 | SPECCInt2006 base | SPECCFP2006 baseline |
|---|---|---|---|---|---|
| Intel Pentium 4 670 | 90 nm | 3.8 GHz | 115 W | 11.5 | 12.2 |
| Intel Itanium 2 | 90 nm | 1.66 GHz | 104 W;仅一个核心活动时约 70 W | 14.5 | 17.3 |
| Intel i7 920 | 45 nm | 3.3 GHz | 总计 130 W;仅一个核心活动时约 80 W | 35.5 | 38.4 |
图 3.44 三种 Intel 处理器之间存在很大差异。虽然 Itanium 有两个核心、i7 有四个核心,但基准测试只使用一个核心。功率列给出热设计功耗,并估计了多核处理器仅一个核心活动时的功耗。
Pentium 4 是 Intel 迄今流水化最激进的处理器,流水线超过 20 级,有 7 个功能单元,缓存微操作而非 x86 指令。相对于如此激进的实现,其性能却不理想,清楚表明开发更多 ILP 的尝试失败了——在途指令很容易就达到 50 条。Pentium 的功耗与 i7 相近,但晶体管数量更少,因为其一级缓存只有 i7 的一半,二级缓存仅 2 MiB,也没有三级缓存。
Intel Itanium 属于 VLIW 风格的体系结构。虽然相对于动态调度超标量处理器,它有望降低复杂度,却从未达到能够与主流 x86 处理器竞争的时钟频率,尽管其整体 CPI 看起来与 i7 接近。考察这些结果时,需要注意它们采用不同的实现工艺:对相同流水化程度的处理器而言,i7 在晶体管速度、因而在时钟频率方面占有优势。即便如此,Pentium 与 i7 超过 3 倍的性能差异,仍然令人惊讶。下一项陷阱解释了其中相当一部分优势来自何处。
陷阱:有时更大、更笨的办法反而更好
21 世纪初,很多注意力都放在构建激进处理器以开发 ILP 上,包括采用当时微处理器中最深流水线的 Pentium 4,以及具有当时最高每周期峰值发射速率的 Intel Itanium。人们很快发现,开发 ILP 的主要限制,往往是存储系统。对于一级缓存未命中造成的 10~15 个周期代价,推测式乱序流水线能够较好地隐藏其中相当一部分;但对于末级缓存未命中、需要访问主存的情况,代价可能达到 50~100 个周期,流水线几乎无能为力。
结果是,尽管晶体管数量庞大、技术极其复杂精巧,这些设计的指令吞吐量始终远未接近峰值。另一项变化进一步说明了这一陷阱:设计者不再试图用 ILP 隐藏更多内存延迟,而是直接把晶体管用于构建大得多的缓存。Itanium 2 和 i7 都采用三级缓存,而 Pentium 4 只有两级;前两者的三级缓存分别为 9 MiB、8 MiB,Pentium 4 的二级缓存则为 2 MiB。不言而喻,构建更大的缓存,远比设计 Pentium 4 超过 20 级的流水线容易;根据图 3.44 的数据,效果似乎也更好。
陷阱:有时更聪明的办法又胜过更大、更笨的办法
过去十年中,分支预测领域出现了一个颇令人意外的结果:带标签的混合预测器表明,使用相同位数时,更复杂的预测器可以胜过简单的 gshare 预测器,见图 3.10。
之所以令人惊讶,一个原因是,带标签的预测器实际保存的预测更少,因为它还要消耗位数存储标签;gshare 则只需一个大型预测数组。即便如此,避免将某个分支的预测误用于另一个分支,带来的优势似乎足以证明:与其把所有位数都分给预测值,不如划出一部分给标签。
陷阱:相信只要技术合适,就有大量 ILP 可供开发
大规模开发 ILP 的尝试因多种原因失败,其中最重要的一条,是一些设计者起初并不接受的事实:即使采用推测,也很难在常规结构的程序中找到大量 ILP。David Wall 在 1993 年进行了一项著名研究(见 Wall,1993),分析了多种理想化条件下可用的 ILP。本节概述其中一种处理器配置的结果,其能力约为 2023 年最先进处理器的 4~8 倍。Wall 的研究广泛记录了多种不同方法;对开发 ILP 的挑战感兴趣的读者,应阅读完整研究。
这里考虑的激进处理器具有以下特征:
- 每周期最多发射、派发 64 条指令,没有发射限制。这是 2023 年最宽处理器 IBM Power10 总发射宽度的 8 倍,每周期允许的加载与存储数量最多可达其 32 倍!如前所述,大发射速率带来严重的复杂度与功耗问题。
- 1K 项竞争预测器,以及 16 项函数返回预测器。这个预测器与 2016 年最好的预测器相当,并非主要瓶颈。错误预测在一个周期内处理,但会限制推测能力。
- 动态完成完美的内存引用消歧。这一目标很有雄心,但对于较小的窗口,也许可以实现。
- 寄存器重命名,额外提供 64 个整数寄存器和 64 个浮点寄存器,略少于 2011 年最激进的处理器。由于研究假定所有指令延迟都只有一个周期,而 Golden Cove 一类处理器的普通指令需要 1~4 个周期、复杂指令最高 15 个周期,因此,其有效重命名寄存器数量约为这些处理器的 5 倍。
图 3.45 展示了该配置在不同窗口大小下的结果。该配置比现有实现更复杂、成本更高,尤其体现在指令发射数量上。不过,它为未来实现可能取得的效果提供了有用的上限。这些图中的数据还因另一个原因显得十分乐观:64 条指令之间没有任何发射限制,例如,它们可以全是内存引用。即使在不久的将来,也不会有人考虑在处理器中提供这种能力。
此外,解释这些结果时还应记住:研究没有考虑缓存未命中,也没有考虑不等于一个周期的操作延迟,而这两者都具有显著影响。
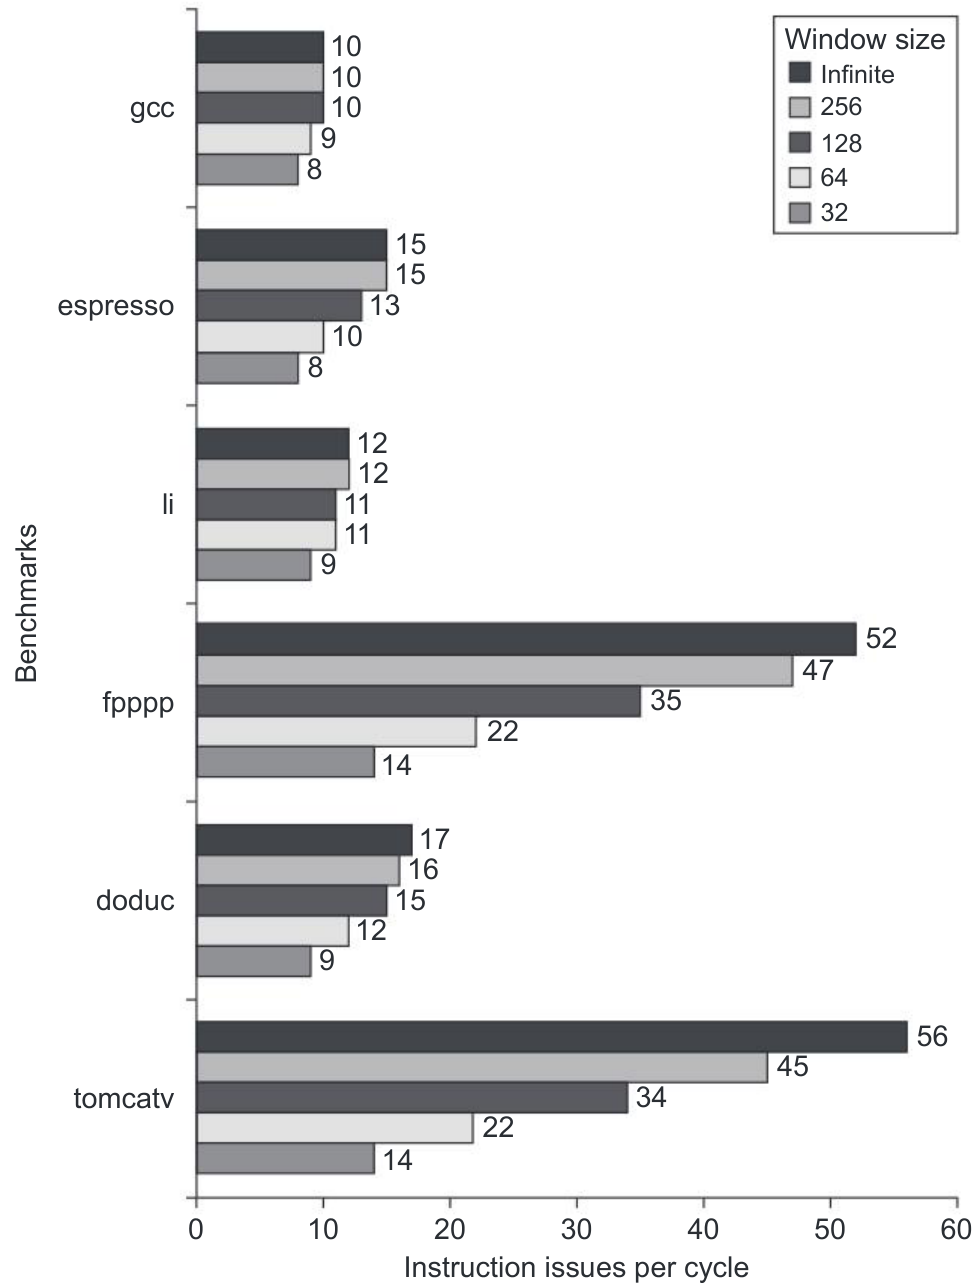
图 3.45 对若干整数与浮点程序,每周期最多发射 64 条任意指令时,可用并行性与窗口大小的关系。虽然重命名寄存器数量少于窗口大小,但所有操作的延迟都为一个周期,且重命名寄存器数量等于发射宽度,因此处理器能够开发整个窗口内的并行性。
图中文字:Window size=窗口大小;Infinite=无限;Benchmarks=基准测试;Instruction issues per cycle=每周期发射指令数。原图标出的全部数值如下,按窗口大小排列:
| 程序 | 无限 | 256 | 128 | 64 | 32 |
|---|---|---|---|---|---|
| gcc | 10 | 10 | 10 | 9 | 8 |
| espresso | 15 | 15 | 13 | 10 | 8 |
| li | 12 | 12 | 11 | 11 | 9 |
| fpppp | 52 | 47 | 35 | 22 | 14 |
| doduc | 17 | 16 | 15 | 12 | 9 |
| tomcatv | 56 | 45 | 34 | 22 | 14 |
图 3.45 中最引人注目的观察,是在上述现实处理器约束下,窗口大小对整数程序的影响不如对浮点程序那么大。这体现了两类程序的关键区别:两个浮点程序具有循环级并行性,因此能够开发更多 ILP;对于整数程序,分支预测、寄存器重命名,以及本来就较少的并行性等其他因素,都是重要限制。这一观察十分关键,因为过去十年中大多数市场增长领域——事务处理、Web 服务器等——依赖的是整数性能,而非浮点性能。
有些人当初不相信 Wall 的研究。但十年之后,现实已经清楚:大量硬件资源只换来有限的性能提高,而错误推测又带来严重能耗问题,两者共同迫使设计方向改变。结语将回到这个话题。
译注:第 1 项把 Power10 的“总发射宽度”按 8 条计算,而图 3.46 将其总宽度列为 16,图注又区分了单线程最多 8 条与总体 16 条。上述研究年份、预测器比较年份及“一周期延迟”等模型假设,也均按原书保留,不作为当代产品测量结果。