4.3 面向多媒体的 SIMD 指令集扩展
SIMD 多媒体扩展源自一个简单的观察:许多媒体应用处理的数据类型,比 32 位处理器所针对的类型更窄。图形系统通常用 8 位分别表示三原色中的每一种,再用 8 位表示透明度;音频采样则视应用而定,通常用 8 位或 16 位表示。以一个 256 位加法器为例,只要将其进位链分段,处理器就能同时对由 32 个 8 位操作数、16 个 16 位操作数、8 个 32 位操作数或 4 个 64 位操作数组成的短向量执行运算。这种分段加法器增加的成本很小。图 4.8 概括了典型的多媒体 SIMD 指令。与向量指令一样,SIMD 指令对一组向量数据执行相同的操作。但向量计算机通常具有大型寄存器堆,例如 RISC-V RV64V 的 32 个向量寄存器,每个可以保存 32 个 64 位元素;SIMD 指令通常指定较少的操作数,因此使用的寄存器堆也小得多。
向量体系结构提供了简洁的指令集,适合作为向量化编译器的目标。相比之下,SIMD 扩展有三项主要缺失:没有向量长度寄存器,没有步长访问或聚集/散布数据传送指令,也没有掩码寄存器。
| 指令类别 | 操作数 |
|---|---|
| 无符号加/减 | 32 个 8 位、16 个 16 位、8 个 32 位或 4 个 64 位 |
| 最大值/最小值 | 32 个 8 位、16 个 16 位、8 个 32 位或 4 个 64 位 |
| 平均值 | 32 个 8 位、16 个 16 位、8 个 32 位或 4 个 64 位 |
| 右移/左移 | 32 个 8 位、16 个 16 位、8 个 32 位或 4 个 64 位 |
| 浮点运算 | 16 个 16 位、8 个 32 位、4 个 64 位或 2 个 128 位 |
- 多媒体 SIMD 扩展把数据操作数的个数固定在操作码中,结果是 x86 体系结构的 MMX、SSE、AVX 和 AMX 扩展增加了数百条指令。向量体系结构则用向量长度寄存器指定当前操作的操作数个数。这种可变长度的向量寄存器,很容易适应那些向量长度自然小于体系结构所支持最大长度的程序。此外,向量体系结构具有隐含的最大向量长度,配合向量长度寄存器,可以避免使用大量操作码。
- 直到最近,多媒体 SIMD 才开始提供向量体系结构中较复杂的寻址方式,即步长访问和聚集/散布访问。这些功能能够扩大向量化编译器可成功处理的程序范围(见 4.7 节)。
- 多媒体 SIMD 通常也不像向量体系结构那样提供掩码寄存器,以支持各元素的条件执行,不过这种情况正在改变。
这些缺失让编译器生成 SIMD 代码更困难,也增加了使用 SIMD 汇编语言编程的难度。
在 x86 体系结构中,1996 年加入的 MMX 指令复用了 64 位浮点寄存器,因此基本指令能够同时执行 8 个 8 位操作或 4 个 16 位操作。随后又加入了并行的 MAX、MIN 操作,各种掩码与条件指令,数字信号处理器中常见的操作,以及一些被认为有助于重要媒体库的专用指令。注意,MMX 访问内存时复用了浮点数据传送指令。
其后继者是 1999 年的流式 SIMD 扩展 SSE。它增加了 16 个独立的 128 位寄存器(XMM 寄存器),使一条指令能够同时执行 16 个 8 位操作、8 个 16 位操作或 4 个 32 位操作。
它还支持并行的单精度浮点运算。因为 SSE 使用独立寄存器,也需要独立的数据传送指令。Intel 很快又通过 2001 年的 SSE2、2004 年的 SSE3 和 2007 年的 SSE4 加入双精度 SIMD 浮点数据类型。只要程序员把操作数相邻放置,能够同时执行 4 次单精度或 2 次双精度浮点运算的指令,就能提高 x86 计算机的峰值浮点性能。每一代还会增加一些专用指令,用于加速当时被认为重要的特定多媒体功能。
2010 年加入的高级向量扩展 AVX,将寄存器宽度再次翻倍到 256 位(YMM 寄存器),从而将所有较窄数据类型的并行操作数目翻倍。图 4.9 列出了适用于双精度浮点计算的 AVX 指令。2013 年的 AVX2 增加了 30 条新指令,例如聚集指令 VGATHER 和向量移位指令 VPSLL、VPSRL、VPSRA。2017 年的 AVX-512 再次将宽度翻倍至 512 位(ZMM 寄存器),将寄存器数量也翻倍至 32 个,并加入约 250 条新指令,其中包括散布指令 VPSCATTER 和掩码寄存器 OPMASK。AVX 还为未来版本将寄存器扩展到 1024 位做了准备。
最新的扩展是高级矩阵扩展 AMX,它出现在 2022 年推出的微处理器中,目标是支持机器学习所依赖的矩阵乘法(见第 7 章)。AMX 增加了 8 个称为 tile 的二维向量寄存器。每个 tile 为 :16 行,每行 256 位宽。因此,AMX 增加的总状态为 字节。Tile Matrix Multiply(TMUL)单元可以执行矩阵乘法。
| AVX 指令 | 说明 |
|---|---|
VADDPD | 对 4 个打包的双精度操作数执行加法 |
VSUBPD | 对 4 个打包的双精度操作数执行减法 |
VMULPD | 对 4 个打包的双精度操作数执行乘法 |
VDIVPD | 对 4 个打包的双精度操作数执行除法 |
VFMADDPD | 对 4 个打包的双精度操作数执行乘加 |
VFMSUBPD | 对 4 个打包的双精度操作数执行乘减 |
VCMPxx | 对 4 个打包的双精度操作数执行 EQ、NEQ、LT、LE、GT、GE 等比较 |
VMOVAPD | 传送对齐的 4 个打包双精度操作数 |
VBROADCASTSD | 将一个双精度操作数广播到一个 256 位寄存器中的 4 个位置 |
矩阵元素可以是 8 位整数,也可以是采用 BF16 格式的 16 位浮点数(见第 7 章)。因此,一个 256 位的行可以保存 32 个 int8 数据或 16 个 BF16 数据。
总体来说,这些扩展的目标一直是加速精心编写的库,而不是让编译器自动生成它们(见附录 H)。不过,较新的 x86 编译器正在尝试生成这种代码,尤其是针对浮点密集型应用。由于操作码决定 SIMD 寄存器的宽度,每当宽度翻倍,SIMD 指令的数量也必须随之翻倍。
既然存在这些不足,为什么多媒体 SIMD 扩展仍如此流行?首先,在标准算术单元上增加最初的 SIMD 支持成本很低,实现也容易。其次,与向量体系结构相比,它增加的处理器状态很少,而状态大小始终关系到上下文切换时间。第三,向量体系结构需要很高的内存带宽,而许多计算机不具备这一条件。第四,SIMD 无须处理这样一种虚拟内存问题:一条指令产生 32 次访存,其中任何一次都可能发生缺页异常。最初的 SIMD 扩展为每组在内存中对齐的 SIMD 操作数分别传送数据,所以这些传送不会跨越页边界。SIMD 的短而定长的“向量”还有一个优点:很容易加入支持新媒体标准的指令,例如置换指令,或消费的操作数个数少于、或多于向量所产生个数的指令。最后,人们还曾担心向量体系结构能否与缓存良好配合。较新的向量体系结构已经解决了这些问题。不过,支配全局的因素是向后二进制兼容性的极端重要性:一旦体系结构走上 SIMD 这条路,就很难再离开。
例题
为了了解多媒体指令的形式,假设为 RISC-V 增加一个 256 位 SIMD 多媒体扩展,暂称为 RVP,P 代表 packed(打包)。本例只考虑浮点运算,用后缀 4D 表示同时处理 4 个双精度操作数。与向量体系结构一样,可以把 SIMD 处理器看作具有多个通道,这里有 4 个。RV64P 将 F 寄存器扩展到完整宽度,即 256 位。下面给出 DAXPY 循环的 RISC-V SIMD 代码;原书以下划线标出为支持 SIMD 而修改的部分。假设 X 和 Y 的起始地址分别在 x5 和 x6 中。
解答
RISC-V SIMD 代码如下:
译注: 原代码的
addi x28,x5,将#256排到了注释区域;两次加载与存储之间只有结果注释,没有印出计算乘积与和的指令。原书声称使用下划线标示改动,但相应指令文本并不完整。
改动包括:
- 将每条 RISC-V 双精度指令替换成相应的 4D 指令;
- 将索引增量从 8 改为 32;
- 增加
splat指令,在f0的 256 位中产生 a 的 4 个副本。
RISC-V SIMD 虽然没有像 RV64V 那样把动态指令带宽需求降为原来的 1/32,但也实现了接近 4 倍的减少:执行 67 条指令,而 RV64G 需要 258 条。这段代码预先知道元素个数;实际中,个数通常在运行时才确定,因此还需要额外的 strip mining 循环,处理元素个数不是 4 的整数倍的情况。
多媒体 SIMD 体系结构的编程
由于多媒体 SIMD 扩展具有较强的专用性,使用这些指令最容易的方法一直是调用库或直接编写汇编语言。
较新的扩展变得更规则,为编译器提供了更合理的目标。借用向量化编译器的技术,编译器已经开始自动生成 SIMD 指令。例如,当今先进的编译器可以生成 SIMD 浮点指令,大幅提高科学计算代码的性能。不过,程序员必须确保内存中的所有数据都按代码运行时 SIMD 单元的宽度对齐,否则编译器可能对本来能够向量化的代码生成标量指令。
Roofline 可视化性能模型
比较不同 SIMD 体系结构潜在浮点性能的一种直观方法,是 Roofline 模型(Williams et al., 2009)。图中的水平线与斜线构成类似屋顶的形状,既是这个简单模型名称的由来,也说明了它的用途(见图 4.11)。它在二维图中将浮点性能、内存性能和算术强度联系起来。算术强度是每访问一字节内存所执行的浮点运算次数,计算方法是用程序的浮点运算总次数,除以执行过程中与主存之间传送的数据总字节数。图 4.10 展示了几个示例计算内核的相对算术强度。
峰值浮点性能可以根据硬件规格得到。本案例中的许多内核无法完全放入片上缓存,因此峰值内存性能由缓存之后的存储系统决定。这里需要的是处理器实际能够获得的峰值内存带宽。
它并非仅仅是 DRAM 引脚处的带宽,例如图 4.30 中的带宽。测量实际交付的峰值内存性能的一种方法,是运行 Stream 基准测试。
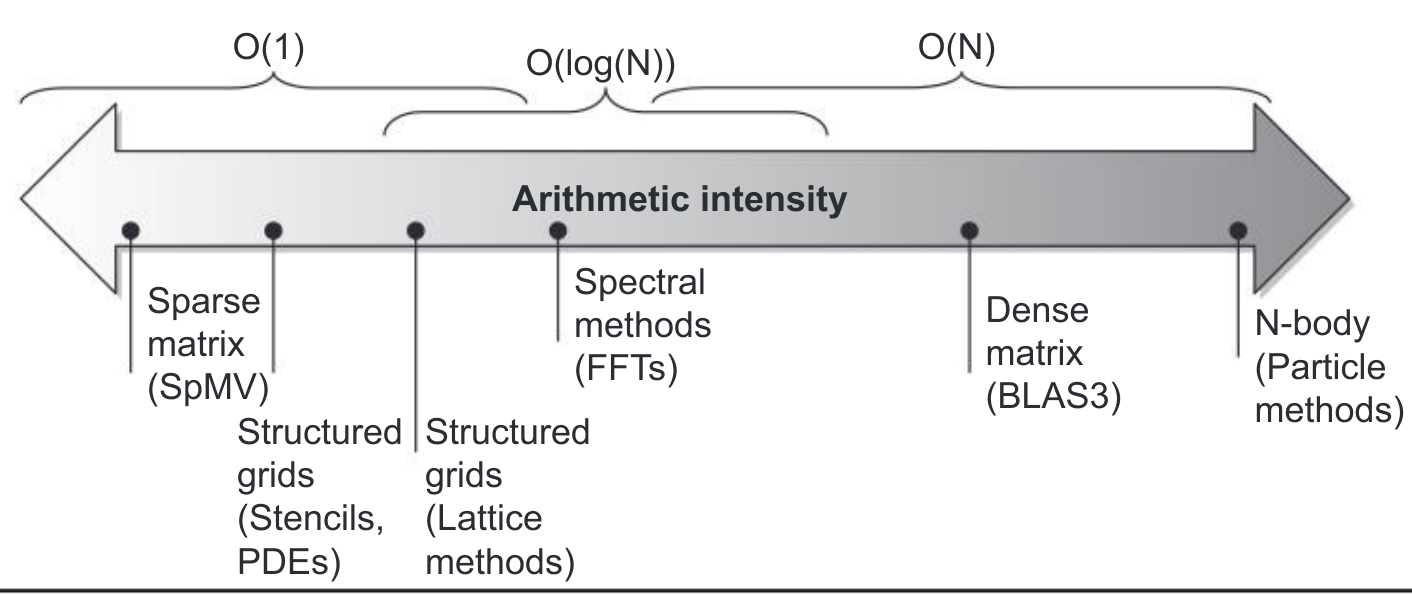
图内术语:Arithmetic intensity=算术强度;Sparse matrix (SpMV)=稀疏矩阵(稀疏矩阵向量乘);Structured grids (Stencils, PDEs)=结构化网格(Stencil 计算、偏微分方程);Structured grids (Lattice methods)=结构化网格(格点方法);Spectral methods (FFTs)=谱方法(快速 Fourier 变换);Dense matrix (BLAS3)=稠密矩阵(三级 BLAS);N-body (Particle methods)=N 体问题(粒子方法)。
图 4.11 左侧给出 NEC SX-9 向量处理器的 Roofline 模型,右侧给出 Intel Core i7 920 多核处理器的模型。纵轴是可达到的浮点性能,范围从 2 到 256 GFLOP/s;两图横轴都是算术强度,范围从每访问一个 DRAM 字节执行 1/8 次浮点运算,到执行 16 次浮点运算。注意,两轴均采用对数刻度,而且对一台计算机只需建立一次 Roofline 图。
对于某个计算内核,可以根据其算术强度确定横轴上的一个点。经过这个点画一条竖线,内核在该计算机上的性能必定位于这条线上。再画一条水平线表示计算机的峰值浮点性能。实际浮点性能显然不可能高于这条线,因为这是硬件的限制。
怎样表示峰值内存性能呢?横轴单位是 FLOP/byte,纵轴单位是 FLOP/second,所以 bytes/second 在这张图中对应一条 45 度斜线。
因此,在 Roofline 模型中可以画出第三条线,表示在给定算术强度下,计算机的存储系统能够支持的最大浮点性能。图 4.11 中的这些限制可以写成:
如果这个推导太快,不妨换一种方式。假设要画一条曲线 ,表示充分利用内存带宽时的性能上限。
曲线上的每个点 都对应一个计算速率(纵轴)和一个内存带宽。这个带宽是隐含的,因为横轴 FLOP/byte 表达了计算量与完成这些计算所需内存数据量之间的关系。具体来说,图上给定点 的内存带宽为 :纵轴是 FLOP/second,横轴是 FLOP/byte,两者相除得到 bytes/second,恰好是内存带宽单位。将式子重写为 ,再令 m 为系统固定的峰值内存带宽,就得到了一条斜率为 m 的直线。
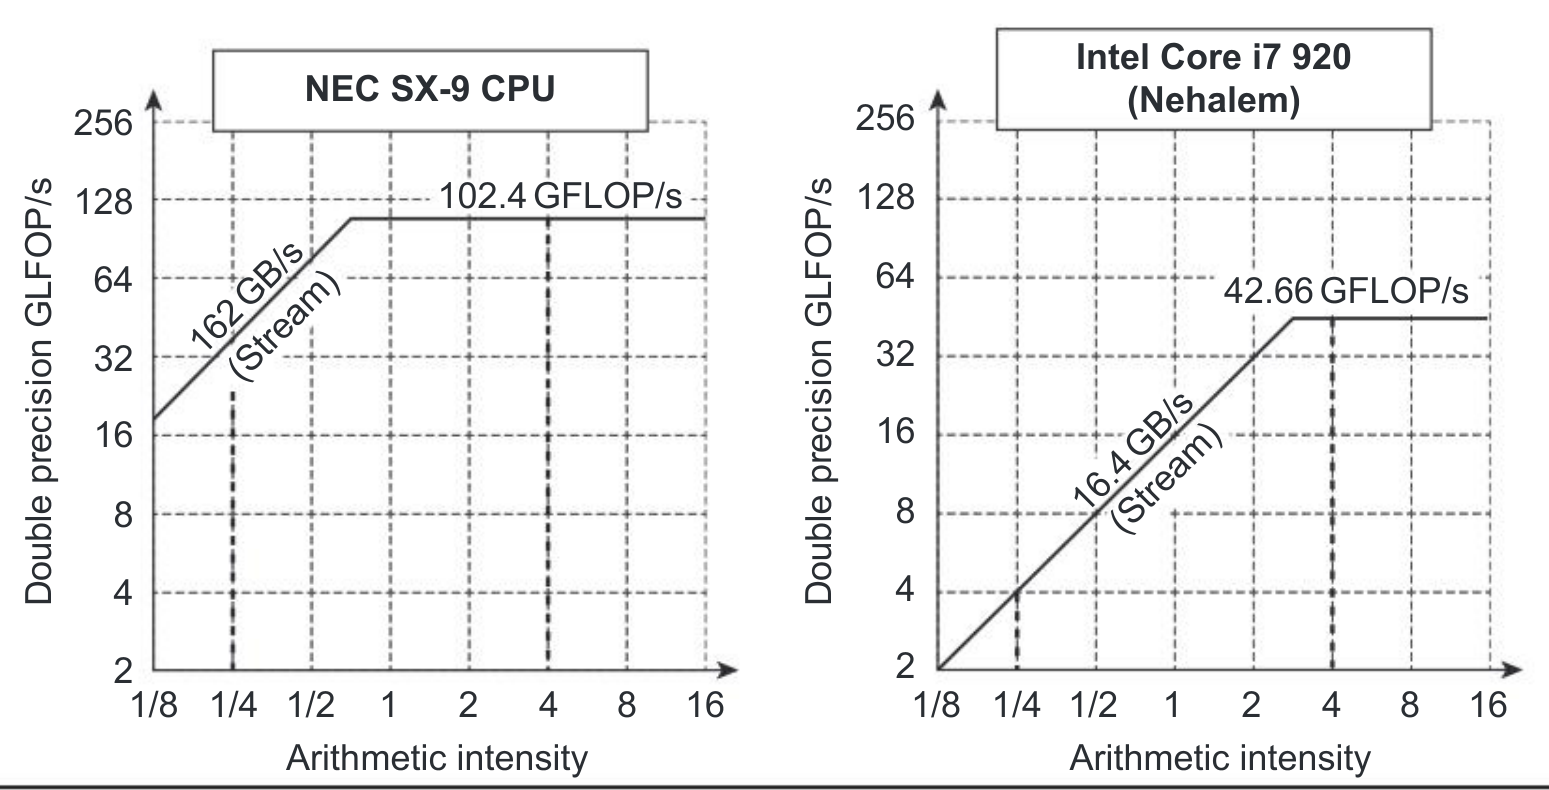
图内术语:Arithmetic intensity=算术强度;Double precision GFLOP/s=双精度浮点性能,单位 GFLOP/s;Stream 为测量内存带宽的基准测试。
译注: 图注在比较 2.4 倍加速比时,将 SX-9 的单位印为“102.4 FLOP/s”,漏了 G;同一图注前文、曲线标记和数值比较均表明应为 102.4 GFLOP/s。图注保留原文,并在此指出。
“屋顶线”根据内核的算术强度给出性能上限。如果把算术强度看成一根向上顶到屋顶的杆子,它或者碰到平坦部分,表示性能受计算能力限制;或者碰到倾斜部分,表示性能最终受内存带宽限制。图 4.11 中算术强度为 4 的右侧竖直虚线是前一种情况。
算术强度为 1/4 的左侧竖直虚线则是后一种情况。一台计算机的 Roofline 模型一旦建立,就可以重复使用,因为它不会随计算内核改变。
斜线与水平线交汇的“屋脊点”还能揭示计算机的一个重要特征。如果它远在右侧,只有算术强度很高的内核才能达到最大性能;如果它靠近左侧,几乎任何内核都有可能达到最大性能。我们将看到,与其他 SIMD 处理器相比,这款向量处理器的内存带宽高得多,屋脊点也明显更靠左。
图 4.11 表明,SX-9 的峰值计算性能是 Core i7 的 2.4 倍,但内存性能是其 10 倍。对于算术强度为 0.25 的程序,SX-9 快约 10 倍,即 40.5 对 4.1 GFLOP/s。较高的内存带宽将屋脊点从 Core i7 的 2.6 降到 SX-9 的 0.6,意味着更多程序可以在向量处理器上达到峰值计算性能。
向量体系结构与多媒体 SIMD 计算机的异同
前面提到,SIMD 的一个优点是最初的数据并行支持非常简单,成本也低。体系结构设计者把已有寄存器和 ALU 分成多个 8 位、16 位或 32 位部分,再并行计算。操作码指定数据宽度与运算,数据传送就是对单个寄存器进行加载和存储。
为了通过更多的数据并行性进一步加速 SIMD,设计者随后将寄存器宽度翻倍,以同时处理更多分段。由于指令集通常坚持向后二进制兼容,而且数据宽度由操作码指定,扩展 SIMD 寄存器也就扩展了 SIMD 指令集。此后每一次寄存器宽度和指令数量翻倍,都会推动 ISA 不断膨胀,成本则由处理器设计者、编译器作者和汇编语言程序员承担。自 1978 年以来,x86 指令集从 80 条增长到约 1400 条,主要推动力就是 SIMD。
向量计算机从主存中聚集对象,放入长而顺序组织的向量寄存器;流水线执行单元在这些寄存器上高效计算,再将结果散布回主存。加载或存储的操作数可以连续排列,也可以按非单位步长排列,甚至随机分布(聚集/散布);但在向量寄存器内部,它们是连续的。简单的向量处理器可能每次只执行一个元素的操作,但各元素操作在定义上相互独立,因此理论上可以同时计算所有元素。
当今向量处理器通常每个时钟周期处理 2、4 或 8 个字元素。当向量长度不是每周期处理元素数的整数倍时,硬件会处理边界情况。与 SIMD 一样,向量也支持不同的数据宽度:每个寄存器能够保存 N 个 64 位元素的处理器,也能处理 2N 个 32 位、4N 个 16 位或 8N 个 8 位元素。
图 4.12 汇总了 x86 AVX2 与 RV32V 上 DAXPY 程序的指令数量(Patterson and Waterman, 2017)。与辅助代码(bookkeeping code)相比,SIMD 计算代码显得很少:x86 AVX2 代码中约三分之二到四分之三属于 SIMD 开销。辅助代码包括复制标量 a 以供 SIMD 执行使用,处理 n 不是 SIMD 寄存器宽度整数倍时的 strip mining 代码,以及 n 为 0 时跳过主循环的代码。RV32V 不需要这些辅助管理操作,因此显著减少了静态指令数。与 SIMD 不同,它有向量长度寄存器 vl,使向量指令能够适应任意 n;还有 vsetvl 指令,自动处理 n 不是向量通道数整数倍以及 n 为 0 的情况。
不过,SIMD 与向量处理的最大差别并非静态代码大小。SIMD 程序执行的指令数是 RV32V 的 10~20 倍,因为每次 SIMD 循环只处理 2 或 4 个元素,而向量循环处理 64 个元素。额外的取指与译码意味着完成同一任务需要更多能量。
与标量版 DAXPY 相比,尽管主循环大小不变,SIMD 版本按指令条数和字节数衡量的代码大小都大约翻倍。根据 SIMD 寄存器宽度,动态执行指令数降为原来的 1/2 或 1/4。RV32V 向量版本的静态代码大小却只增加到原来的 1.2 倍,动态指令数则降为原来的 1/43。
| ISA | IA-32 AVX2 | RV32V |
|---|---|---|
| 静态指令数 | 29 | 13 |
| 主循环中的指令数 | 6 | 10 |
| 辅助指令数 | 23 | 3 |
| 每次主循环产生的结果数 | 4 | 64 |
| 动态指令数(n = 1000) | 1517 | 163 |
动态指令数虽然相差很大,却未必是 SIMD 与向量之间最重要的差别。更重要的可能是 ISA 和辅助代码的急剧膨胀。像 x86 这样坚持向后二进制兼容和渐进式指令集设计的 ISA,每次改变 SIMD 宽度,都必须复制此前针对较窄 SIMD 寄存器定义的全部指令。
多代 SIMD ISA 已经产生了数百条 x86 指令,未来还会增加数百条。汇编程序员需要承担很大的认知负担:vfmadd213pd 到底是什么意思,应该什么时候使用?这也意味着第三方应用必须重新编码,才能使用新指令;在很多情况下,这并不是轻而易举的工作。
相比之下,RV64V 代码不受向量寄存器存储空间大小的影响。即使向量存储空间扩大,RV64V 代码也无须改变,甚至不必重新编译。因为最大向量长度 VLMAX 由处理器提供,所以处理器设计者将向量存储空间翻倍或减半,都不影响代码。
SIMD ISA 规定了硬件的组织方式,因此增加数据级并行性就需要修改指令集和编译器。向量 ISA 则允许处理器设计者根据应用选择数据并行资源,而不影响程序员或编译器。在将体系结构与实现分离这一设计原则上,向量体系结构做得好得多。