4.4 图形处理单元
只需几百美元,人们就能购买一块含有数千个并行浮点单元的 GPU 芯片,将它插入桌面 PC。这样的价格和便利性使高性能计算走向更多用户。当这种潜力与让 GPU 更易编程的语言结合后,人们对 GPU 计算的兴趣迅速增长。
今天,人们谈论使用 GPU 计算时,可能指的是:
- 用 GPU 生成图形;
- 用 GPU 进行科学计算或多媒体计算;
- 用 GPU 进行机器学习计算。
在图形生成领域,GPU 毫无疑问占据优势。许多科学计算和多媒体应用的程序员,则在考虑究竟使用 GPU 还是 CPU。例如,截至 2022 年,全球前 500 台超级计算机中有 30% 依赖 GPU 完成大部分计算。对第 7 章所讨论的机器学习感兴趣的程序员,更倾向于使用 GPU。
沿着计算机体系结构的发展谱系追溯,GPU 和 CPU 并没有共同祖先,也不存在一个可以同时解释两者的“缺失环节”。4.10 节将说明,GPU 的主要祖先是图形加速器,因为擅长图形处理正是 GPU 存在的理由。尽管 GPU 正在进入主流计算领域,它们仍不能放弃继续在图形处理方面保持优势的责任。因此,从以下角度理解 GPU 设计可能更合适:既然已经为高效图形处理投入了这些硬件,还能增加什么,使更广泛的应用从中获得性能收益?
本节着重讨论如何用 GPU 进行计算。如果想了解 GPU 计算与传统图形加速任务如何结合,可参见 John Nickolls 和 David Kirk 撰写的“Graphics and Computing GPUs”,即本书同一作者所著 Computer Organization and Design 第 6 版的附录 C。
GPU 的术语和某些硬件特性与向量及 SIMD 体系结构很不相同,因此,我们先介绍一个简化的 GPU 编程模型,再说明其体系结构。
GPU 编程
CUDA 为表达算法中的并行性提供了一个优雅的解决方案——并非适用于所有算法,但它所适用的范围已经足够重要。它似乎契合了我们的思考和编码方式,使任务级以外的并行性也能得到更容易、更自然的表达。
——Vincent Natol,“Kudos for CUDA”,HPC Wire,2010 年
GPU 程序员面临的挑战不仅是让 GPU 获得良好性能,还要协调系统处理器与 GPU 上的计算调度,以及系统内存与 GPU 内存之间的数据传送。此外,正如本节后面将看到的,GPU 几乎拥有编程环境能够利用的所有并行形式:多线程、MIMD、SIMD,甚至指令级并行性。
NVIDIA 决定开发一种类似 C 的语言和编程环境,同时应对异构计算与多种并行形式带来的挑战,提高 GPU 程序员的生产率。这个系统称为 CUDA,即 Compute Unified Device Architecture。CUDA 为系统处理器(host,主机)生成 C/C++ 代码,为 GPU(device,设备,也是 CUDA 中 D 的含义)提供一种 C 和 C++ 方言。NVIDIA 用 CUDA 线程作为统一各种并行形式的概念。以这种最底层的并行性作为编程原语,编译器和硬件就能把数千个 CUDA 线程组合起来,利用 GPU 内部的多线程、MIMD、SIMD 和指令级并行性。因此,NVIDIA 将 CUDA 编程模型归类为单指令多线程(SIMT)。后面将解释为何要把这些线程组织成组,称为线程块(Thread Block)。执行整个线程块的硬件,在本节称为多线程 SIMD 处理器。
介绍 CUDA 程序示例之前,只需了解以下几个细节:
- 为区分 GPU(设备)函数与系统处理器(主机)函数,CUDA 对前者使用
__device__或__global__,对后者使用__host__。 - 使用
__device__声明的 CUDA 变量分配在 GPU 内存中(见后文),所有多线程 SIMD 处理器都能访问。 - 在 GPU 上运行的函数采用扩展调用语法
name<<<dimGrid, dimBlock>>>(参数列表)。其中,dimGrid指定代码的维度,以线程块为单位;dimBlock指定一个块的维度,以线程为单位。 - 除了块标识符
blockIdx和块内线程标识符threadIdx,CUDA 还提供表示每块线程数的blockDim,其值来自调用中的dimBlock参数。
先看 4.2 节 DAXPY 循环的普通 C 代码:
CUDA 版本如下。我们启动 n 个线程,每个向量元素对应一个;在多线程 SIMD 处理器上,每个线程块有 256 个 CUDA 线程。GPU 函数先根据块 ID、每块线程数和线程 ID,计算相应元素索引 i;只要索引仍在数组范围内,即 i < n,就执行乘法和加法。
比较 C 和 CUDA 代码,可以看到数据并行 CUDA 程序的一种常见并行化模式。C 版本的各次循环迭代彼此独立,因此可以直接把循环转换成并行代码,让每次迭代成为一个独立线程。前面提到过,4.5 节还将详细说明:向量化编译器同样依赖于循环迭代之间不存在依赖,这类依赖称为循环携带依赖(loop-carried dependence)。CUDA 程序员通过指定网格维度和每个 SIMD 处理器的线程数,显式确定并行性。因为每个元素只分配给一个线程,所以将结果写回内存时不需要在线程之间同步。
并行执行和线程管理由 GPU 硬件处理,而不是由应用程序或操作系统完成。为了简化硬件调度,CUDA 要求线程块能够独立执行,而且可以按任意顺序执行。不同线程块不能直接通信,不过可以通过全局内存中的原子操作进行协调。
我们很快会看到,许多 GPU 硬件概念在 CUDA 中并不明显。追求性能的程序员编写 CUDA 时必须考虑 GPU 硬件。尽管 CUDA 编程模型看起来像 MIMD,高效 GPU 代码仍要求程序员按 SIMD 操作来思考。这可能影响编程生产率,但多数程序员本来就是为了性能而选择 GPU。出于后面将说明的原因,他们知道,要让多线程 SIMD 处理器发挥最佳性能,就应使每组 32 个线程在控制流上保持一致;还需要为每个处理器创建更多线程,以隐藏 DRAM 延迟。为了获得预期的内存性能,数据地址也需要集中在一个或少数几个内存块中。
与许多并行系统一样,CUDA 通过提供内建函数(intrinsics),让程序员显式控制硬件,在生产率与性能之间折中。一方面希望提高生产率,另一方面又希望程序员能够表达硬件所能完成的一切,这种矛盾经常出现在并行计算中。CUDA 将如何在这场经典的生产率与性能之争中演进,以及它是否会流行到其他 GPU、甚至其他体系结构中,都是值得关注的问题。
NVIDIA GPU 的计算结构
前面提到的特殊发展背景,解释了 GPU 为什么形成了独立于 CPU 的体系结构风格和术语。理解 GPU 的一个障碍就是术语,其中有些名称甚至会造成误导。克服这一障碍比想象中困难得多,本章多次重写的经历就说明了这一点。
为了兼顾理解 GPU 体系结构和学习这些采用非传统定义的术语,我们在软件部分使用 CUDA 术语,在硬件部分则先采用描述性更强的名称,有时借用 OpenCL 的术语。解释完体系结构后,再将这些名称对应到 NVIDIA GPU 的正式术语。
图 4.13 从左到右列出本节的描述性名称、主流计算中最接近的术语、供感兴趣的读者参考的 NVIDIA GPU 正式术语,以及简短说明。本节其余部分采用其中的描述性名称来解释 GPU 微体系结构。
我们选择 NVIDIA 系统作为例子,因为它们具有 GPU 体系结构的代表性。具体来说,我们沿用前面 CUDA 并行编程语言的术语,并以 NVIDIA Pascal GPU 为例(见 4.7 节)。后续 NVIDIA GPU 的基本微体系结构相同,通常增加了 Pascal 某些部件的副本。
与向量体系结构一样,NVIDIA GPU 只有在数据级并行问题上才能表现良好。两者都有聚集/散布数据传送和掩码寄存器,而 NVIDIA GPU 的寄存器甚至更多。有时,向量处理器由软件实现的功能,NVIDIA GPU 会用硬件实现。这是因为向量处理器有一个可以执行软件功能的标量处理器。与大多数向量体系结构不同,NVIDIA GPU 还依赖单个多线程 SIMD 处理器内部的多线程来隐藏内存延迟(见第 2、3 章)。不过,无论向量体系结构还是 GPU,高效代码都要求程序员以成组的 SIMD 操作为单位思考。
网格(Grid)是在 NVIDIA GPU 上运行、由一组线程块构成的代码。图 4.13 将网格类比为一个向量化循环,将线程块类比为经过 strip mining 后、能够完成一段完整计算的循环体。举个具体例子,假设要计算两个各含 8192 个元素的向量的逐元素乘积:A = B * C。本节会反复使用这个例子。图 4.14 展示了它与前两个 GPU 概念的关系。处理全部 8192 个元素乘法的 GPU 代码称为网格,类似一个向量化循环。为分解成更易管理的规模,网格由多个线程块组成,每块最多处理 512 个元素,类似向量化循环的循环体。注意,GPU SIMD 指令每次处理 32 个元素。对于长度为 8192 的向量,本例共有 个线程块。网格和线程块是由 GPU 硬件实现的编程抽象,帮助程序员组织 CUDA 代码。线程块可类比为向量长度为 32 的、经过 strip mining 的向量循环。
线程块由线程块调度器分配给执行其代码的处理器,也就是本节所称的多线程 SIMD 处理器。
| 类别 | 本节的描述性名称 | GPU 之外最接近的传统术语 | CUDA/NVIDIA 正式术语 | 简要说明 |
|---|---|---|---|---|
| 程序抽象 | 可向量化循环 | 可向量化循环 | Grid | 在 GPU 上执行,由一个或多个可并行执行的线程块(向量化循环体)组成 |
| 程序抽象 | 向量化循环体 | 经过 strip mining 的向量化循环体 | Thread Block | 在一个多线程 SIMD 处理器上执行的向量化循环,由一个或多个 SIMD 指令线程组成;它们可通过局部存储器通信 |
| 程序抽象 | SIMD 通道操作序列 | 标量循环的一次迭代 | CUDA Thread | SIMD 指令线程的一个纵向切片,对应由一个 SIMD 通道执行的一个元素;是否保存结果取决于掩码和谓词寄存器 |
| 机器对象 | SIMD 指令线程 | 向量指令线程 | Warp | 只包含 SIMD 指令的传统线程,在一个多线程 SIMD 处理器上执行;是否保存结果由逐元素掩码决定 |
| 机器对象 | SIMD 指令 | 向量指令 | PTX Instruction | 跨多个 SIMD 通道执行的一条 SIMD 指令 |
| 处理硬件 | 多线程 SIMD 处理器 | (多线程)向量处理器 | Streaming Multiprocessor | 执行 SIMD 指令线程,独立于其他 SIMD 处理器 |
| 处理硬件 | 线程块调度器 | 标量处理器 | Giga Thread Engine | 将多个线程块(向量化循环体)分配给多线程 SIMD 处理器 |
| 处理硬件 | SIMD 线程调度器 | 多线程 CPU 的线程调度器 | Warp Scheduler | 调度和发射已就绪的 SIMD 指令线程的硬件单元;包含记分牌以跟踪 SIMD 线程的执行 |
| 处理硬件 | SIMD 通道 | 向量通道 | Thread Processor | 对单个元素执行 SIMD 指令线程中的操作;是否保存结果取决于掩码 |
| 存储硬件 | GPU 内存 | 主存 | Global Memory | GPU 中所有多线程 SIMD 处理器都可访问的 DRAM |
| 存储硬件 | 私有内存 | 栈或操作系统的线程局部存储 | Local Memory | 每个 SIMD 通道私有的一部分 DRAM |
| 存储硬件 | 局部存储器 | 局部存储器 | Shared Memory | 一个多线程 SIMD 处理器内部的快速本地 SRAM,其他 SIMD 处理器无法访问 |
| 存储硬件 | SIMD 通道寄存器 | 向量通道寄存器 | Thread Processor Registers | 单个 SIMD 通道中的寄存器,在整个线程块(向量化循环体)中分配 |
译注: 本表实际有 13 个术语,原图注的“11 个”不符。图注的图号与页码也沿用了其他版本:本版向量术语对照见图 4.24,厂商和 OpenCL 术语对照见图 4.27、图 4.28。为避免混淆,下文“局部存储器”专指本节的 Local Memory,即 NVIDIA 所称 Shared Memory;NVIDIA 的 Local Memory 则对应本节“私有内存”。
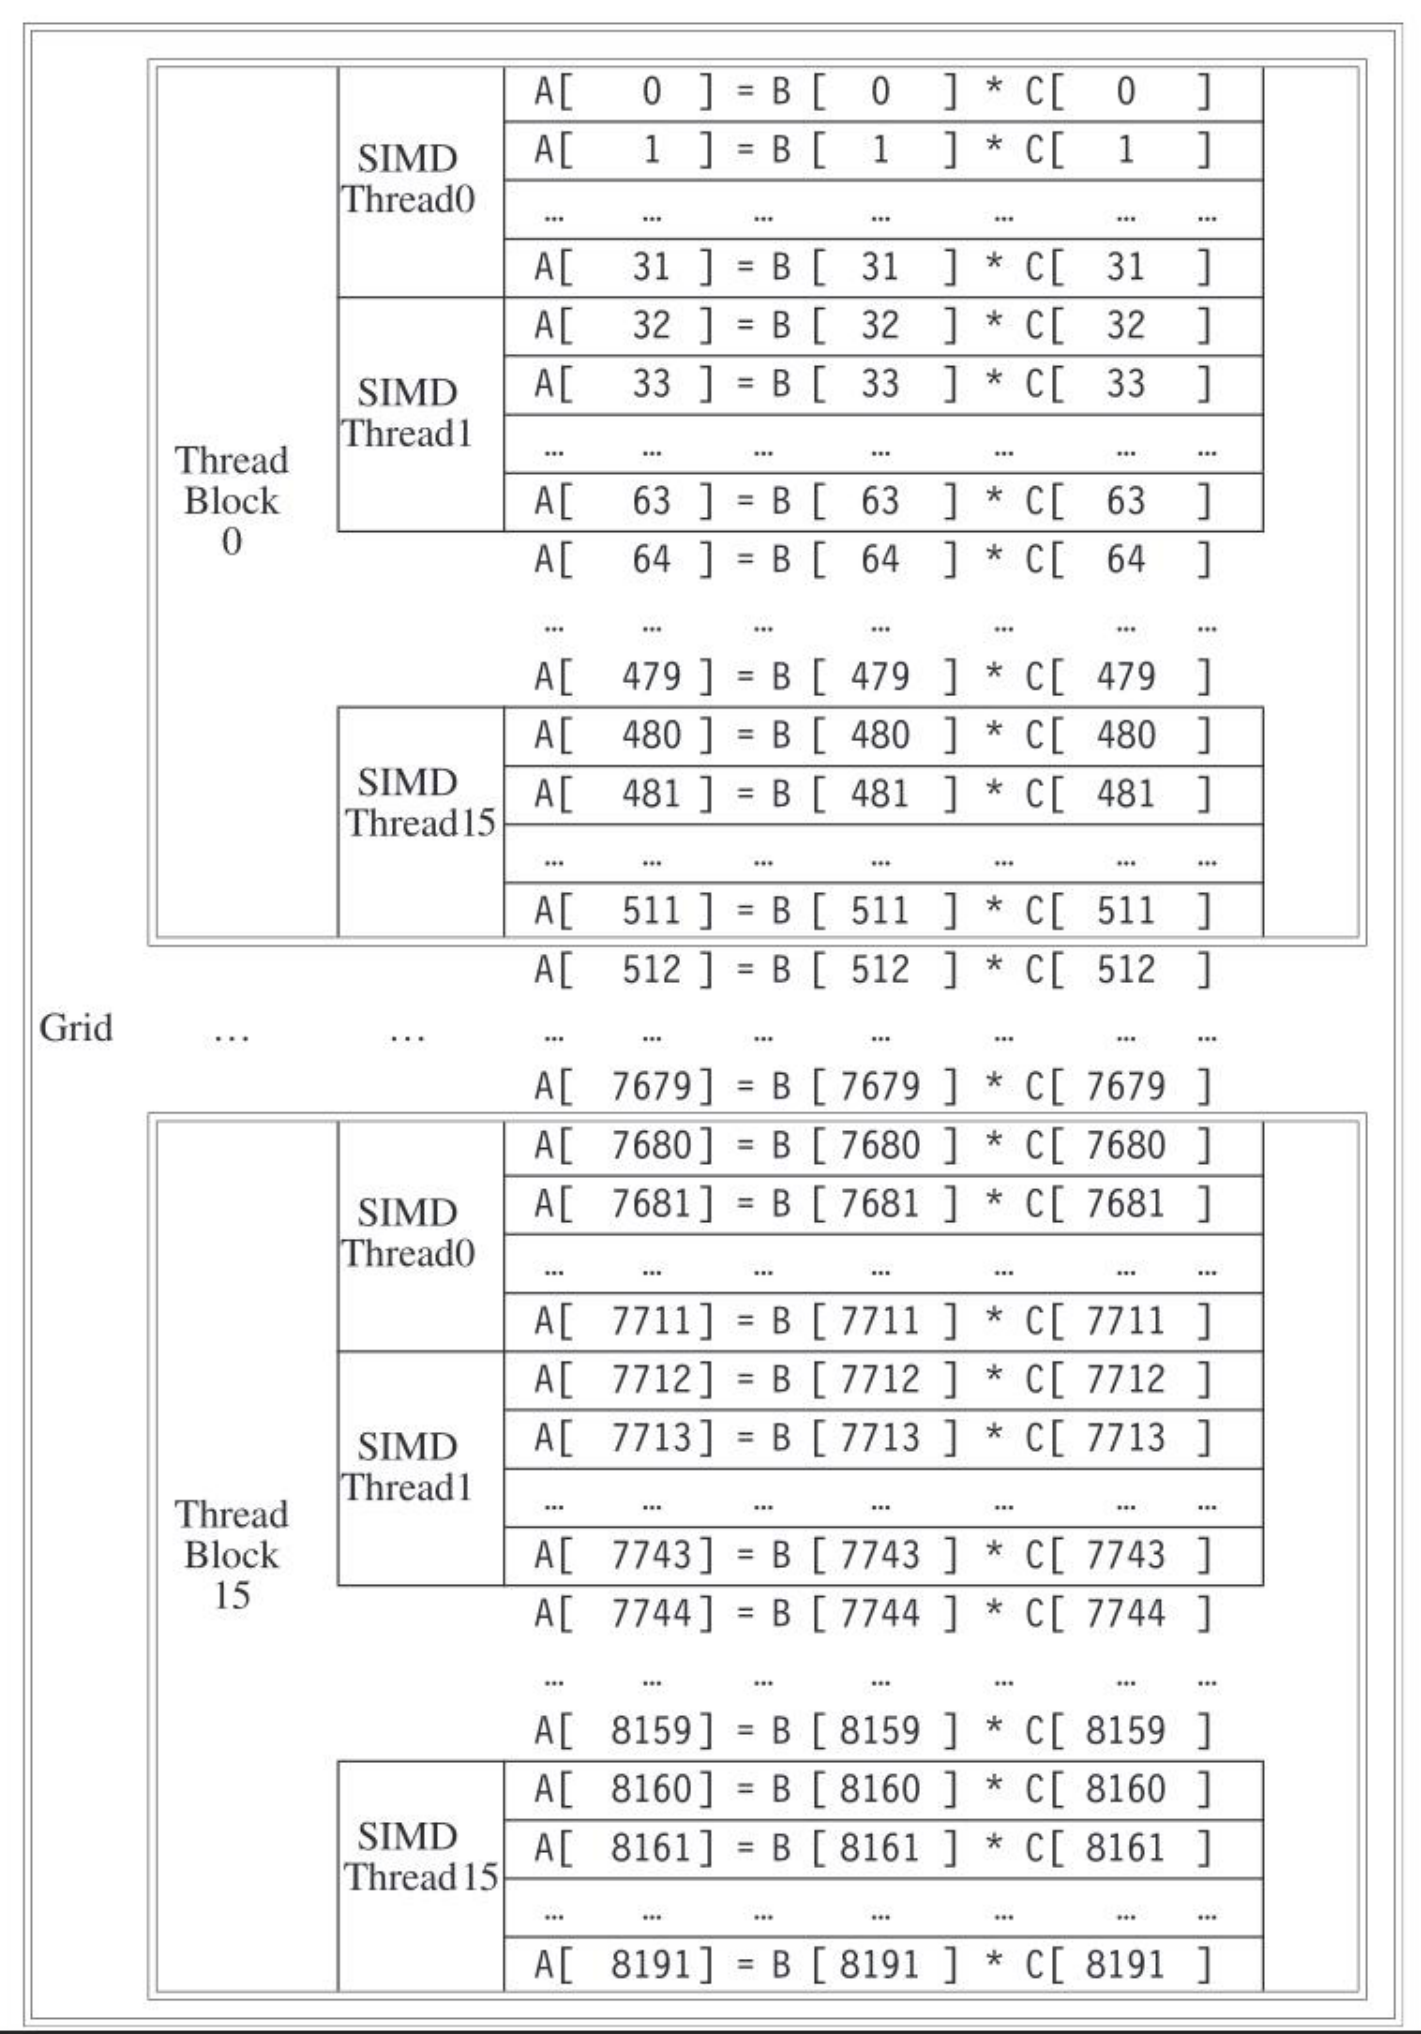
图内术语:Grid=网格;Thread Block=线程块;SIMD Thread=SIMD 指令线程。A、B、C 的数组下标展示各层负责的元素范围。
程序员告诉由硬件实现的线程块调度器,需要运行多少个线程块。在本例中,调度器将 16 个线程块分派给多线程 SIMD 处理器,以计算循环中的全部 8192 个元素。
图 4.15 给出了多线程 SIMD 处理器的简化框图。它类似向量处理器,但采用许多并行功能单元,而不像向量处理器那样采用少数深流水线单元。在图 4.14 的编程示例中,每个多线程 SIMD 处理器分配到 512 个向量元素。SIMD 处理器是完整的处理器,拥有独立的程序计数器 PC,并使用线程编程(见第 3 章)。
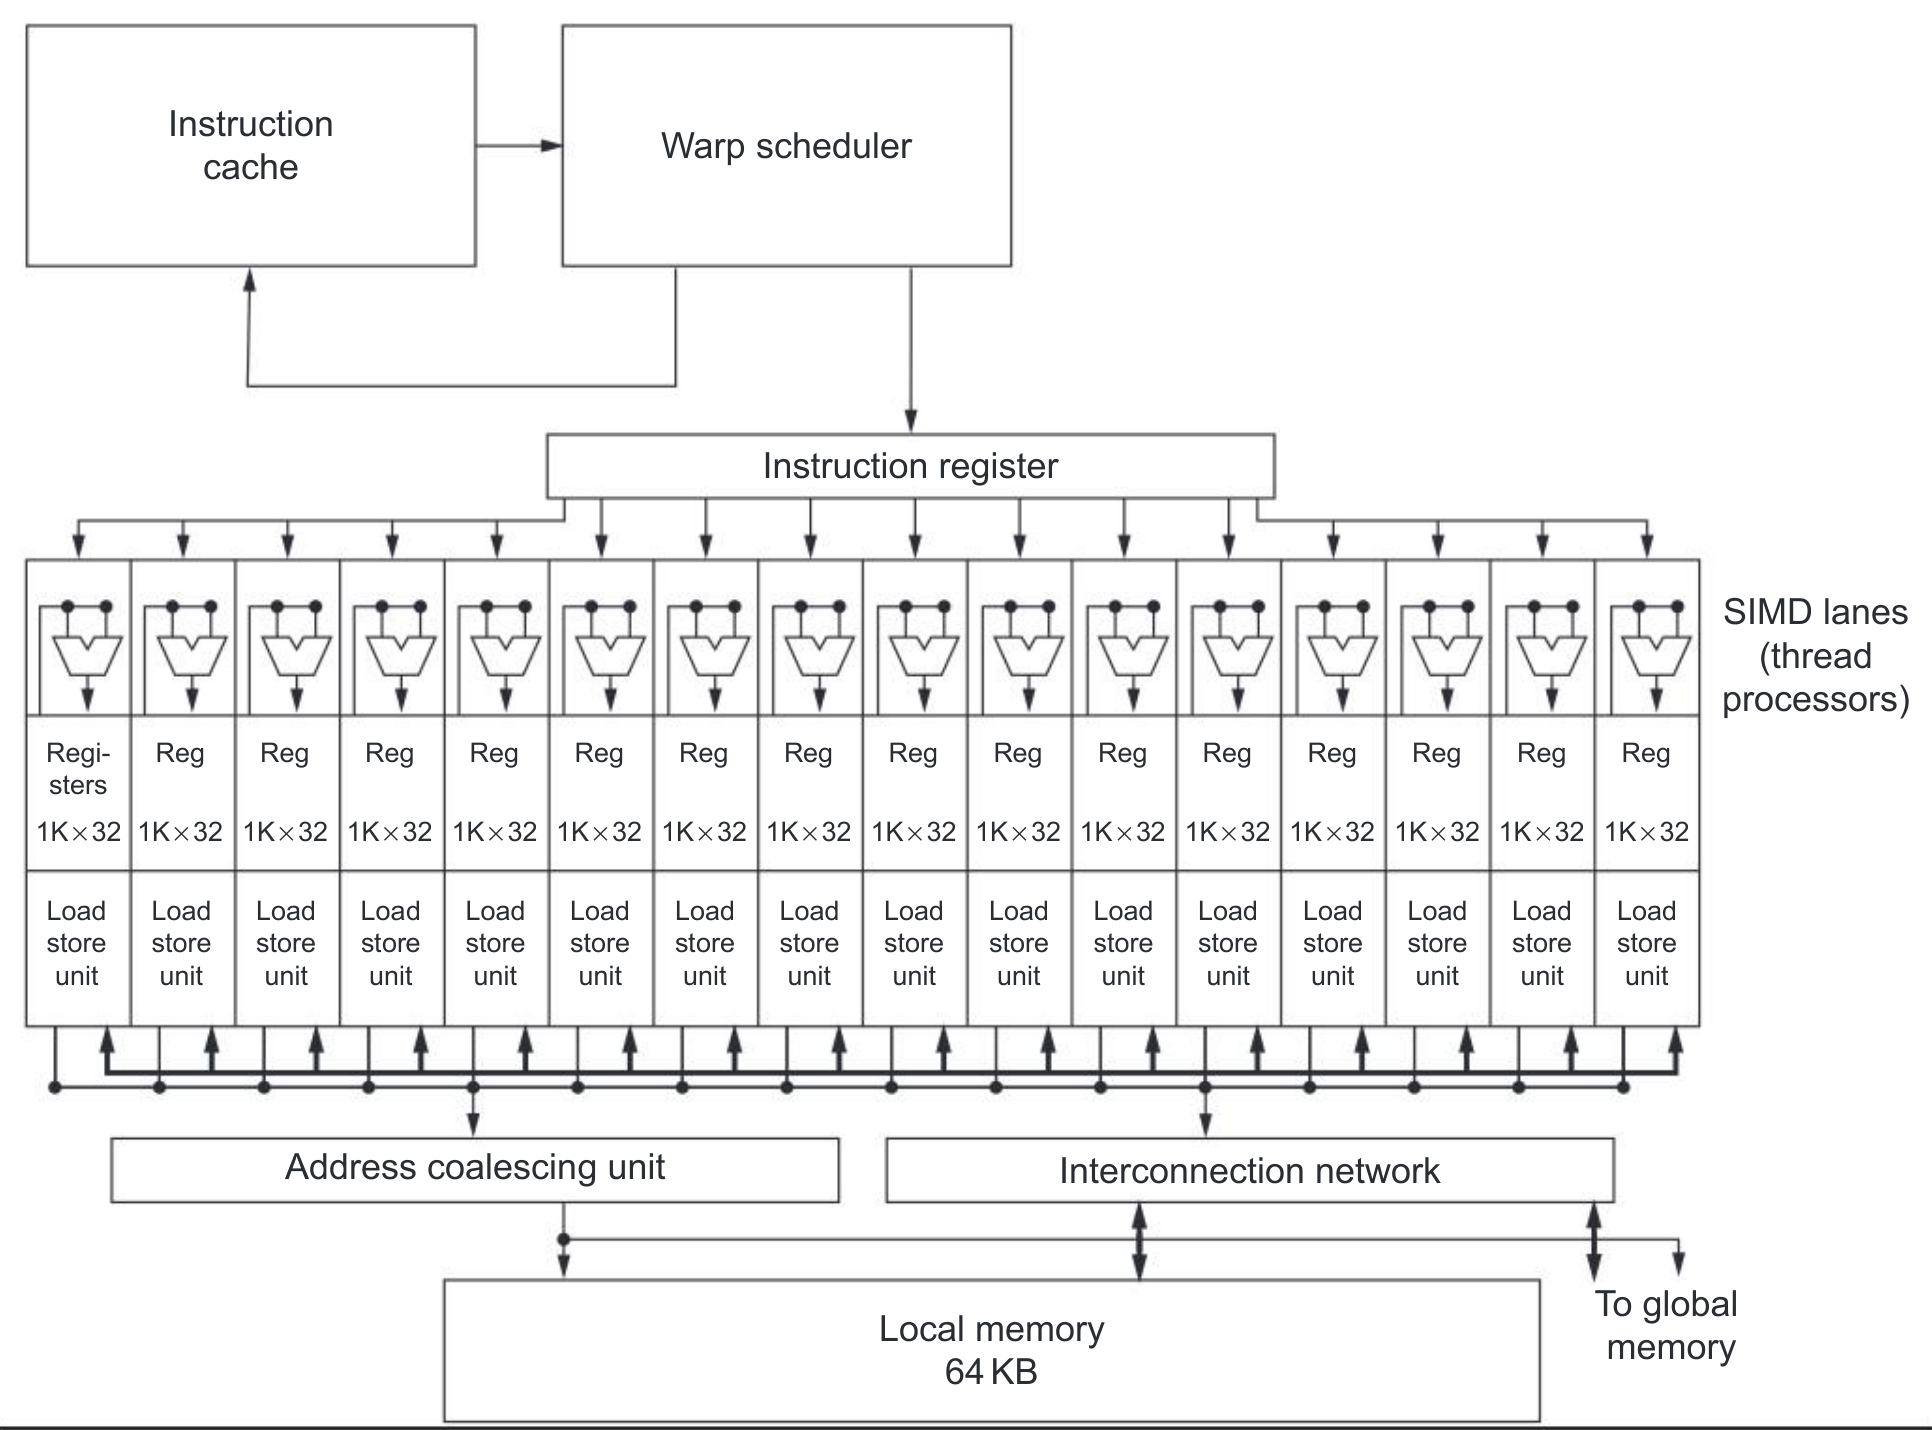
图内术语:Instruction cache=指令缓存;Warp scheduler=Warp 调度器,即本节的 SIMD 线程调度器;Instruction register=指令寄存器;Registers/Reg=寄存器;Load store unit=加载/存储单元;Address coalescing unit=地址合并单元;Interconnection network=互连网络;Local memory=局部存储器;To global memory=通向全局内存;SIMD lanes (thread processors)=SIMD 通道(线程处理器)。
GPU 硬件包含一组多线程 SIMD 处理器,它们执行由线程块(相当于向量化循环体)组成的网格。也就是说,GPU 是由多线程 SIMD 处理器构成的多处理器。一块 GPU 可以有一个到几十个多线程 SIMD 处理器。例如,Pascal P100 有 56 个,Hopper H100 有 132 个,而较小的芯片可能只有一两个。线程块调度器将线程块分配给多线程 SIMD 处理器,使具有不同处理器数量的 GPU 型号能够透明扩展。图 4.16 展示了 Pascal 体系结构 P100 实现的芯片布局。
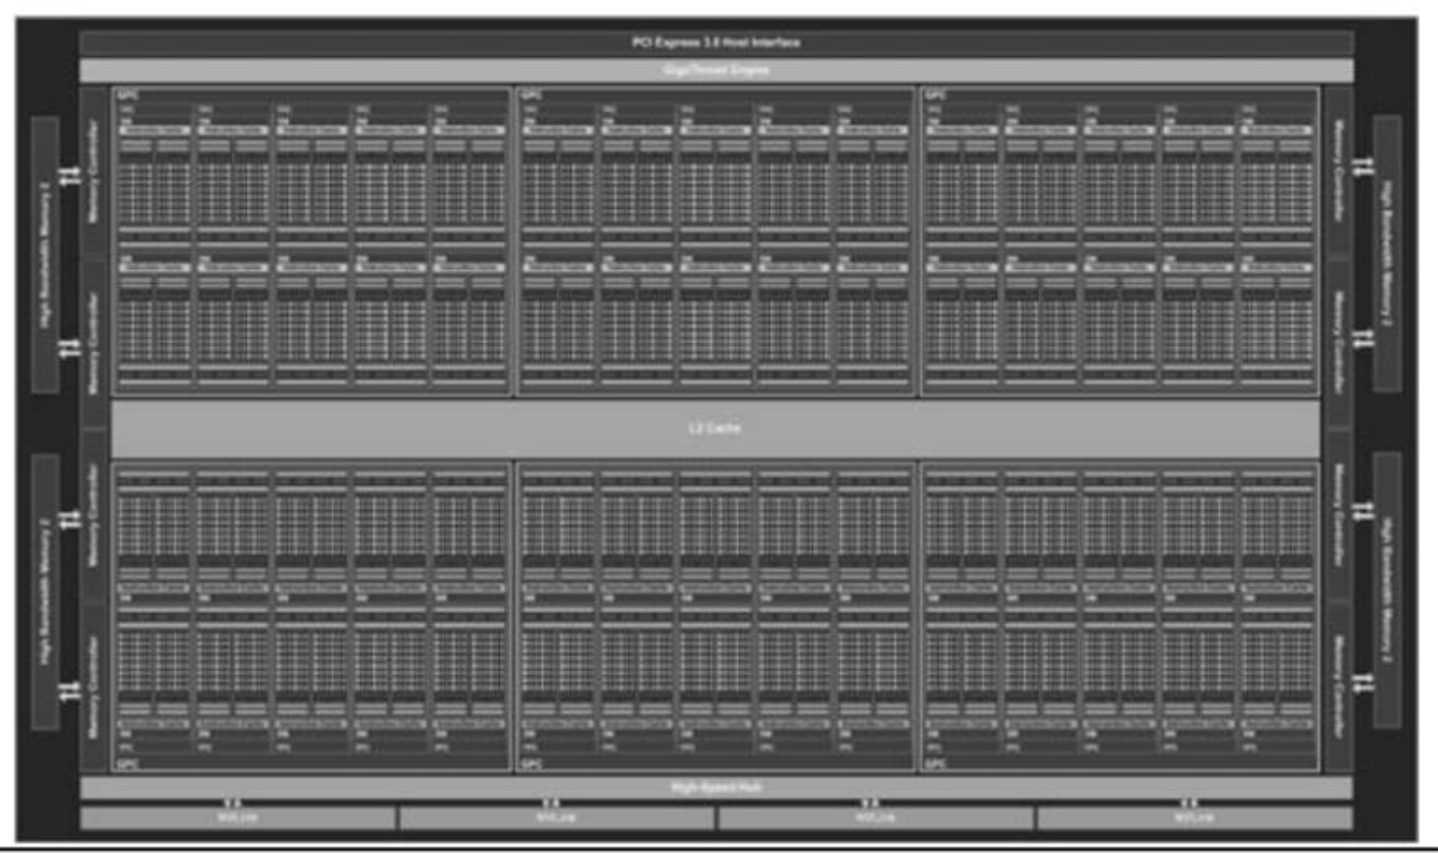
图内主要标记:PCI Express 3.0 Host Interface=PCI Express 3.0 主机接口;GigaThread Engine=线程块调度引擎;L2 Cache=L2 缓存;High-Speed Hub=高速枢纽;NVLink=NVLink 互连。
再深入一层,硬件所创建、管理、调度和执行的机器对象是SIMD 指令线程:它是只包含 SIMD 指令的传统线程。这些线程各有自己的 PC,在多线程 SIMD 处理器上运行。SIMD 线程调度器知道哪些线程已就绪,并将它们送到分派单元,在处理器上执行。因此,GPU 有两级硬件调度器:
- 线程块调度器:将线程块(向量化循环体)分配给多线程 SIMD 处理器。
- SIMD 处理器内部的 SIMD 线程调度器:决定各 SIMD 指令线程何时在该处理器内运行。
这些线程中的 SIMD 指令宽度为 32,因此本例每个 SIMD 指令线程计算 32 个元素。每个线程块包含 个 SIMD 线程,见图 4.14。
因为线程由 SIMD 指令组成,SIMD 处理器必须有并行功能单元来执行这些操作。我们将它们称为 SIMD 通道,它们与 4.2 节的向量通道十分相似。
对于 Pascal GPU,每个 32 元素宽的 SIMD 指令线程映射到 16 个物理 SIMD 通道,因此线程内每条 SIMD 指令需要 2 个时钟周期完成。一个 SIMD 指令线程中的各元素锁步执行,仅在开始时进行调度。继续采用向量处理器的类比,可以说它有 16 个通道、向量长度为 32,一个 chime 为 2 个时钟周期。正是这种“宽而浅”的特点,使我们采用 SIMD 处理器这一更准确的类比,而不是向量处理器。
GPU 的 SIMD 处理器所具有的通道数,可以是从较小数值到线程块线程数之间的任意值,正如向量处理器的通道数可以在 1 与最大向量长度之间变化。例如,不同 GPU 世代中,每个 SIMD 处理器的通道数曾在 8 到 32 之间变化。
根据定义,SIMD 指令线程相互独立,所以 SIMD 线程调度器可以选取任何已就绪的线程,而不必始终沿着某个线程的指令序列执行下一条指令。调度器包含一个记分牌(见第 3 章),跟踪最多 64 个执行时间各异的 SIMD 指令线程,判断哪条 SIMD 指令已准备好执行。缓存和 TLB 的命中、未命中会改变内存指令的延迟,因此需要记分牌判断这些指令何时完成。图 4.17 展示了调度器随时间以不同顺序选择 SIMD 指令线程的过程。GPU 设计者的假设是:GPU 应用拥有足够多的 SIMD 指令线程,使多线程既能隐藏 DRAM 延迟,又能提高多线程 SIMD 处理器的利用率。
继续看向量乘法:每个多线程 SIMD 处理器必须将两个向量的各 32 个元素从内存加载到寄存器,通过读写寄存器执行乘法,再将乘积从寄存器写回内存。为了保存这些元素,Pascal GPU 的一个 SIMD 处理器依据型号具有多达 32,768~65,536 个 32 位寄存器,图 4.15 中每个通道有 1024 个。与向量处理器一样,这些寄存器在逻辑上分布到各向量通道中,这里则称 SIMD 通道。
每个 SIMD 线程最多使用 256 个寄存器,因此可以把一个 SIMD 线程看作最多拥有 256 个向量寄存器,每个包含 32 个 32 位元素。
双精度浮点操作数使用两个相邻的 32 位寄存器,因此也可以将其看作:每个 SIMD 线程有 128 个向量寄存器,每个包含 32 个 64 位元素。
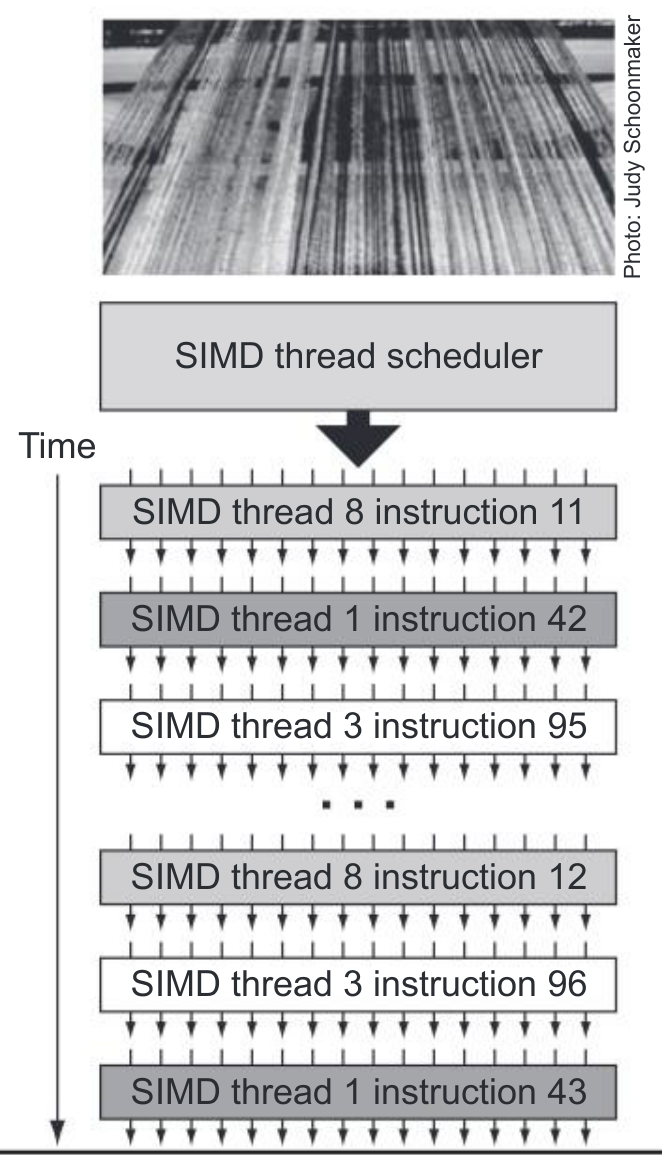
图内术语:SIMD thread scheduler=SIMD 线程调度器;Time=时间;SIMD thread 8 instruction 11=SIMD 线程 8 的第 11 条指令,其余标记依此类推。
寄存器使用量与最大线程数之间存在权衡:每个线程使用的寄存器越少,能够容纳的线程就越多;使用的寄存器越多,线程数就越少。也就是说,并非所有 SIMD 线程都需要最大数量的寄存器。Pascal 设计者认为,若为所有线程都配备最大数量的寄存器,就会有大量宝贵的硅面积闲置。
为了支持许多 SIMD 指令线程,每个线程在创建时,都会动态获得所在 SIMD 处理器的一组物理寄存器;线程退出时再释放。例如,一个线程块可以包含 16 个 SIMD 线程、每个线程使用 36 个寄存器,同时另一个线程块包含 32 个 SIMD 线程、每个线程使用 20 个寄存器。后续线程块可能按任意顺序到来,因此寄存器必须按需分配。这种变化可能产生碎片,使一些寄存器无法利用;但实际上,对于给定的可向量化循环(网格),大多数线程块使用相同数量的寄存器。硬件必须知道每个线程块的寄存器在大型寄存器堆中的位置,并按线程块记录这些信息。因为某个线程块的指定寄存器可能位于寄存器堆中的任何位置,这种灵活性需要硬件中的路由、仲裁和分存储体机制。
注意,一个 CUDA 线程只是 SIMD 指令线程的一个纵向切片,对应一个 SIMD 通道执行的一个元素。CUDA 线程与 POSIX 线程很不相同,不能从 CUDA 线程任意发起系统调用。
现在可以看看 GPU 指令的形式了。
NVIDIA GPU 指令集体系结构
与大多数系统处理器不同,NVIDIA 编译器的目标指令集是硬件指令集的一种抽象。PTX(Parallel Thread Execution)向编译器提供稳定的指令集,并支持不同 GPU 世代之间的兼容;真正的硬件指令集则对程序员隐藏。PTX 指令描述单个 CUDA 线程上的操作,通常与硬件指令一一对应,但一条 PTX 指令也可能展开为多条机器指令,反之亦然。PTX 使用数量不限、只写一次的寄存器,编译器必须执行寄存器分配,把 PTX 寄存器映射到实际设备中数量有限、可反复读写的硬件寄存器。随后运行的优化器可以进一步减少寄存器使用量,同时消除死代码、合并指令,并计算分支可能发生分歧及分歧路径可能重新汇合的位置。
PTX 与 x86 微体系结构有一些相似之处:两者都转换为内部形式,x86 的内部形式是微指令。但区别在于,x86 在程序执行期间由硬件完成转换,GPU 则在加载时由软件完成。
PTX 指令格式为:
其中 d 是目的操作数,a、b、c 是源操作数,分号右侧为注释。操作类型 opcode.type 可以使用下列类型说明符:
| 类型 | .type 说明符 |
|---|---|
| 无类型的 8、16、32、64 位位串 | .b8、.b16、.b32、.b64 |
| 8、16、32、64 位无符号整数 | .u8、.u16、.u32、.u64 |
| 8、16、32、64 位有符号整数 | .s8、.s16、.s32、.s64 |
| 16、32、64 位浮点数 | .f16、.f32、.f64 |
源操作数可以是 32 位或 64 位寄存器,也可以是常量。除存储指令以外,目的操作数均为寄存器。
图 4.18 列出了基本 PTX 指令集。所有指令都可以由 1 位谓词寄存器控制,谓词寄存器可以用设置谓词指令 setp 赋值。控制流指令包括函数调用 call 与返回 return、线程退出 exit、分支 branch,以及线程块内部线程的屏障同步 bar.sync。在分支指令前加上谓词,就得到条件分支。编译器或 PTX 程序员将虚拟寄存器声明为 32 位或 64 位、有类型或无类型的值。例如,R0、R1 等用于 32 位值,RD0、RD1 等用于 64 位值。PTX 的虚拟寄存器到物理寄存器的映射发生在加载时。
下面的 PTX 指令序列对应前面 DAXPY 循环的一次迭代(原文引用第 292 页):
如前所示,CUDA 程序员为每次循环迭代分配一个 CUDA 线程;CUDA 为每个线程块提供唯一的 blockIdx,为块内每个 CUDA 线程提供唯一的 threadIdx。这样便创建了 8192 个 CUDA 线程,并用唯一编号寻址数组中的每个元素,不需要递增或分支代码。前 3 条 PTX 指令在 R8 中计算该元素唯一的字节偏移,再与数组基地址相加。后续指令加载两个双精度浮点操作数,执行乘法、加法并存储结果。对应 CUDA 语句 if (i < n) 的 PTX 代码稍后介绍。
这个例子表明,通用 GPU(GPGPU)程序员首先尝试创建尽可能多的线程,然后针对已知的低效来源进一步优化,例如未合并的内存访问。NVIDIA 提供的一些 CUDA 示例,也从简单但不一定高效的内核出发,逐步改进成更高效的代码,归约运算就是一例。
与向量体系结构不同,GPU 没有分别用于连续、步长和聚集/散布传送的不同指令。所有数据传送都是聚集/散布!为了恢复连续(单位步长)传送的效率,GPU 使用专门的地址合并硬件,识别一个 SIMD 指令线程中的各通道是否共同发出了连续地址。运行时硬件随后通知内存接口单元,请求一次传送 32 个连续字的块传送。
| 类别 | 指令 | 示例 | 含义 | 说明 |
|---|---|---|---|---|
| 算术 | add.type | add.f32 d,a,b | d = a + b | |
| 算术 | sub.type | sub.f32 d,a,b | d = a - b | |
| 算术 | mul.type | mul.f32 d,a,b | d = a * b | |
| 算术 | mad.type | mad.f32 d,a,b,c | d = a * b + c | 乘加 |
| 算术 | div.type | div.f32 d,a,b | d = a / b | 多条微指令 |
| 算术 | rem.type | rem.u32 d,a,b | d = a % b | 整数余数 |
| 算术 | abs.type | abs.f32 d,a | d 为 a 的绝对值 | |
| 算术 | neg.type | neg.f32 d,a | d = 0 - a | |
| 算术 | min.type | min.f32 d,a,b | d = (a < b) ? a : b | 浮点形式选择非 NaN 值 |
| 算术 | max.type | max.f32 d,a,b | d = (a > b) ? a : b | 浮点形式选择非 NaN 值 |
| 算术 | setp.cmp.type | setp.lt.f32 p,a,b | p = (a < b) | 比较并设置谓词 |
| 算术 | mov.type | mov.b32 d,a | d = a | 传送 |
| 算术 | selp.type | selp.f32 d,a,b,p | d = p ? a : b | 按谓词选择 |
| 算术 | cvt.dtype.atype | cvt.f32.s32 d,a | d = convert(a) | 将 atype 转为 dtype |
| 特殊函数 | rcp.type | rcp.f32 d,a | d = 1/a | 倒数 |
| 特殊函数 | sqrt.type | sqrt.f32 d,a | d = sqrt(a) | 平方根 |
| 特殊函数 | rsqrt.type | rsqrt.f32 d,a | d = 1/sqrt(a) | 平方根的倒数 |
| 特殊函数 | sin.type | sin.f32 d,a | d = sin(a) | 正弦 |
| 特殊函数 | cos.type | cos.f32 d,a | d = cos(a) | 余弦 |
| 特殊函数 | lg2.type | lg2.f32 d,a | d = log(a)/log(2) | 以 2 为底的对数 |
| 特殊函数 | ex2.type | ex2.f32 d,a | d = 2 ** a | 以 2 为底的指数 |
| 逻辑 | and.type | and.b32 d,a,b | d = a & b | |
| 逻辑 | or.type | or.b32 d,a,b | d = a | b | |
| 逻辑 | xor.type | xor.b32 d,a,b | d = a ^ b | |
| 逻辑 | not.type | not.b32 d,a,b | d = ~a | 按位取反 |
| 逻辑 | cnot.type | cnot.b32 d,a,b | d = (a == 0) ? 1 : 0 | C 的逻辑非 |
| 逻辑 | shl.type | shl.b32 d,a,b | d = a << b | 左移 |
| 逻辑 | shr.type | shr.s32 d,a,b | d = a >> b | 右移 |
| 内存访问 | ld.space.type | ld.global.b32 d,[a+off] | d = *(a+off) | 从指定内存空间加载 |
| 内存访问 | st.space.type | st.shared.b32 [d+off],a | *(d+off) = a | 存入指定内存空间 |
| 内存访问 | tex.nd.dtyp.btype | tex.2d.v4.f32.f32 d,a,b | d = tex2d(a,b) | 纹理查找 |
| 内存访问 | atom.spc.op.type | atom.global.add.u32 d,[a],b;atom.global.cas.b32 d,[a],b,c | 原子执行 d = *a; *a = op(*a,b); | 原子读—修改—写 |
| 控制流 | branch | @p bra target | if (p) goto target | 条件分支 |
| 控制流 | call | call (ret),func,(params) | ret = func(params) | 调用函数 |
| 控制流 | ret | ret | return | 从函数调用返回 |
| 控制流 | bar.sync | bar.sync d | 等待线程 | 屏障同步 |
| 控制流 | exit | exit | exit | 终止线程执行 |
图 4.18 的修饰符:
- 算术
.type:.s32、.u32、.f32、.s64、.u64、.f64。 - 数值比较
.cmp:eq、ne、lt、le、gt、ge;无序比较:equ、neu、ltu、leu、gtu、geu、num、nan。 - 特殊函数
.type:.f32,部分支持.f64。 - 逻辑
.type:.pred、.b32、.b64。 - 内存空间
.space:.global、.shared、.local、.const;内存类型.type:.b8、.u8、.s8、.b16、.b32、.b64。 - 原子
.op:and、or、xor、add、min、max、exch、cas;.spc:.global;.type:.b32。
为了获得地址合并带来的重要性能收益,GPU 程序员必须确保相邻 CUDA 线程同时访问邻近地址,使这些访问能够合并到一个或少数几个内存块或缓存块中;我们的例子就满足这一条件。
GPU 中的条件分支
与单位步长传送一样,向量体系结构和 GPU 处理 IF 语句的方式也很相似:前者主要用软件配合有限硬件支持来实现,后者则使用更多硬件。除显式谓词寄存器外,GPU 分支硬件还利用内部掩码、分支同步栈和指令标记,管理分支何时分成多条执行路径,以及这些路径何时重新汇合。
在 PTX 汇编层面,一个 CUDA 线程的控制流由分支、调用、返回、退出指令,以及每条指令逐线程通道的谓词控制来描述;程序员通过每个线程通道的 1 位谓词寄存器指定谓词。PTX 汇编器分析分支图,将其优化为最快的 GPU 硬件指令序列。每个线程都可以自行决定分支走向,无须保持锁步。
在 GPU 硬件指令层面,控制流包括分支、跳转、索引跳转、调用、索引调用、返回、退出,以及管理分支同步栈的特殊指令。一些早期 GPU 为每个 SIMD 线程提供一个栈;栈项包含标识 token、目标指令地址和目标线程活动掩码。GPU 有特殊指令向某个 SIMD 线程的栈压入栈项,也有特殊指令与指令标记,弹出栈项或将栈展开到指定位置,再使用目标活动掩码跳转到目标地址。GPU 硬件指令也具有逐通道的谓词控制(启用/禁用),由每通道的 1 位谓词寄存器指定。Volta GPU 及其后继产品取消了这个栈,并允许 Warp 分拆。
对于使用 PTX 分支指令编写的简单最外层 IF-THEN-ELSE,PTX 汇编器通常会将其优化为完全由谓词控制的 GPU 指令,不产生 GPU 分支指令。较复杂的控制流则经常混用谓词执行、GPU 分支以及特殊指令和标记。当部分通道跳转到目标地址、其他通道顺序执行时,分支同步栈会压入一个栈项;NVIDIA 称之为分支分歧(diverge)。当 SIMD 通道执行同步标记、路径汇合(converge)时,也会使用这种组合:弹出栈项,采用其中的活动掩码,跳转到栈项指定的地址。
PTX 汇编器会识别循环分支,生成跳回循环顶部的 GPU 分支指令,同时生成特殊栈指令,以处理某些通道提前退出循环的情况;
当所有通道都完成循环时,再使 SIMD 通道汇合。GPU 的索引跳转和索引调用指令也会压栈,使所有通道完成 switch 语句或函数调用后,SIMD 线程能够汇合。
GPU 的设置谓词指令——图 4.18 中的 setp——计算 IF 语句的条件,PTX 分支指令依赖该谓词。若 PTX 汇编器生成不含 GPU 分支的谓词指令,就使用逐通道谓词寄存器,针对每条指令启用或禁用各 SIMD 通道。IF 的 THEN 部分中的 SIMD 指令,会向所有 SIMD 通道广播操作;谓词为 1 的通道执行操作并保存结果,其余通道不执行,也不保存结果。ELSE 部分使用相对于 THEN 部分取反的谓词,于是原先空闲的通道执行并保存结果,原先活动的通道则空闲。ELSE 结束后,指令不再受该谓词控制,原来的计算继续。因此,对于长度相同的两条路径,IF-THEN-ELSE 的效率只有 50% 或更低。
IF 语句可以嵌套,这正是使用栈的原因。对于复杂控制流,PTX 汇编器通常生成谓词指令、GPU 分支和特殊同步指令的混合序列。深层嵌套可能使执行嵌套条件语句时的大多数通道闲置:等长路径的两层 IF 嵌套效率为 25%,三层为 12.5%,以此类推。向量处理器中类似的情况是只有少数掩码位为 1;处理嵌套 IF 时,由于需要组合各层条件来设置向量掩码寄存器,正会出现这种情况。
进一步看,PTX 汇编器会在合适的条件分支指令上设置“分支同步”标记,把当前活动掩码压入各 SIMD 线程内部的栈。如果条件分支发生分歧,一些通道跳转、另一些顺序执行,就压入栈项,并根据条件设置当前内部活动掩码。在 ELSE 部分之前,一个分支同步标记弹出分歧分支栈项,并翻转掩码位。若存在嵌套 IF-ELSE,掩码调整会比简单取反稍复杂。IF 语句结束时,PTX 汇编器再加入一个分支同步标记,弹出之前的活动掩码,恢复为当前活动掩码。
如果所有掩码位都是 1,THEN 末尾的分支就会跳过 ELSE 部分。所有掩码位都是 0 时,也有类似优化:条件分支会跳过 THEN 指令。并行 IF 语句和 PTX 分支经常使用所有通道一致认可的分支条件,即所有通道都沿同一路径前进;此时 SIMD 线程不会分歧为不同的逐通道控制流。PTX 汇编器会优化这类分支,跳过没有任何通道需要执行的指令块。
例如,条件式错误检查必须执行测试,却很少进入错误处理路径,这时上述优化就很有用。
下面的条件语句类似 4.2 节中的例子:
假设 R8 已保存按元素大小缩放后的线程 ID,这个 IF 语句可以编译成下列 PTX 指令。*Push、*Comp 和 *Pop 表示 PTX 汇编器插入的分支同步标记,分别压入旧掩码、对当前掩码取反,以及弹栈恢复旧掩码。
译注: 原页的比较指令确为
setp.neq.s32 P1, RD0, #0,但前一条指令加载的是.f64数据,目的也是 64 位RD0。类型与前后浮点数据流不一致,neq也不同于图 4.18 所列的ne。
再次强调,SIMD 处理器通常会执行 IF-THEN-ELSE 中的所有指令,只是在 THEN 部分启用某些通道,在 ELSE 部分启用其他通道。前面提到,各通道对谓词分支达成一致的情况出乎意料地常见,例如按所有通道都相同的参数值分支,使活动掩码全为 0 或全为 1。此时,分支会跳过 THEN 或 ELSE 指令。
这种灵活性让每个元素看起来都有自己的程序计数器。然而,在最慢的情况下,每 2 个时钟周期只有一个 SIMD 通道能够保存结果,其余通道全部闲置。向量体系结构中对应的最慢情况,就是只有一个掩码位置 1。这种灵活性可能使不熟悉 GPU 的程序员写出性能很差的代码,但在程序开发初期也有帮助。必须记住:一个时钟周期内,SIMD 通道只能执行 PTX 指令指定的操作,或保持闲置;两个 SIMD 通道不能同时执行不同指令。后面将把这种做法与向量方法比较。
这种灵活性也解释了为什么把 SIMD 指令线程中的每个元素称为 CUDA 线程:它给人以独立执行的错觉。初学者可能认为,这种线程抽象意味着 GPU 能更从容地处理条件分支——一些线程走一条路,其余走另一条路;只要不急着得到结果,看起来确实如此。
每个 CUDA 线程要么与线程块中的其他线程执行相同指令,要么闲置。这种同步使带条件分支的循环更容易处理,因为掩码可以关闭 SIMD 通道,并自动检测循环结束。
译注: 上句原文使用“Thread Block”。但本节前文明确说明,一个线程块可包含多个独立调度的 SIMD 指令线程;此处锁步执行与掩码的范围应是同一 SIMD 指令线程(Warp),不是整个线程块。
实际性能有时会暴露这种简单抽象的局限。让 SIMD 通道以高度独立的 MIMD 方式工作,就像在物理内存很小的计算机上编写大量使用虚拟地址空间的程序:两者都正确,却很可能慢到令程序员难以接受。
条件执行体现了两类体系结构的分工差异:GPU 在运行时用硬件完成向量体系结构在编译时完成的工作。向量编译器执行两次 IF 转换,生成四种不同的掩码。基本执行过程与 GPU 相同,只是向量方式还要执行一些额外指令。向量体系结构与标量处理器集成,因此当掩码为 0 的情况占主导时,可以避免浪费这些执行时间。何时改用标量更有利取决于标量处理器与向量处理器的相对速度,分界可能在掩码中少于 20% 的位为 1 时。GPU 可以在运行时进行一项向量体系结构无法在编译时完成的优化:掩码全为 0 或全为 1 时,跳过 THEN 或 ELSE 部分。
因此,GPU 执行条件语句的效率最终取决于分支分歧的频率。例如,一个特征值计算程序有很深的条件嵌套,但实测发现,约 82% 的发射周期中,32 个掩码位有 29~32 个为 1,所以 GPU 的执行效率比直觉预期更高。
同一机制还处理向量循环的 strip mining,即元素个数与硬件宽度不完全匹配的情况。本节开头的示例使用 IF 语句,检查当前 SIMD 通道对应的元素编号(前例中保存在 R8)是否小于界限,即 i < n,并据此设置掩码。关键区别是:向量编译器设置掩码寄存器并生成不同循环,n 层嵌套最多需要 种;GPU 则由硬件跟踪掩码与嵌套。两种方法的运行时间相近。
NVIDIA GPU 的存储结构
图 4.19 展示了 NVIDIA GPU 的存储结构。多线程 SIMD 处理器的每个 SIMD 通道,都获得一块私有的片外 DRAM 区域,本节称为私有内存。它用于栈帧、寄存器溢出,以及放不进寄存器的私有变量。不同 SIMD 通道不共享私有内存。GPU 用 L1 和 L2 缓存缓存这些数据,以辅助寄存器溢出并加快函数调用。
每个多线程 SIMD 处理器内部的片上存储器,本节称为局部存储器。它是一块小型 scratchpad 存储器,延迟低,约几十个时钟周期;带宽高,可达每周期 128 字节。程序员可以把需要重用的数据放在这里,供同一线程或同一线程块中的其他线程使用。局部存储器容量有限,通常为 48 KiB;它不会在同一处理器先后执行的线程块之间保留状态。它由单个多线程 SIMD 处理器内的各通道共享,但不在不同 SIMD 处理器之间共享,因此本节称之为“局部”。创建线程块时,处理器动态分配一部分局部存储器;线程块内所有线程退出后,再释放这部分空间。这部分存储器为该线程块私有。
最后,整个 GPU 和所有线程块共享的片外 DRAM 区域,本节称为 GPU 内存。前面的向量乘法示例只使用 GPU 内存。
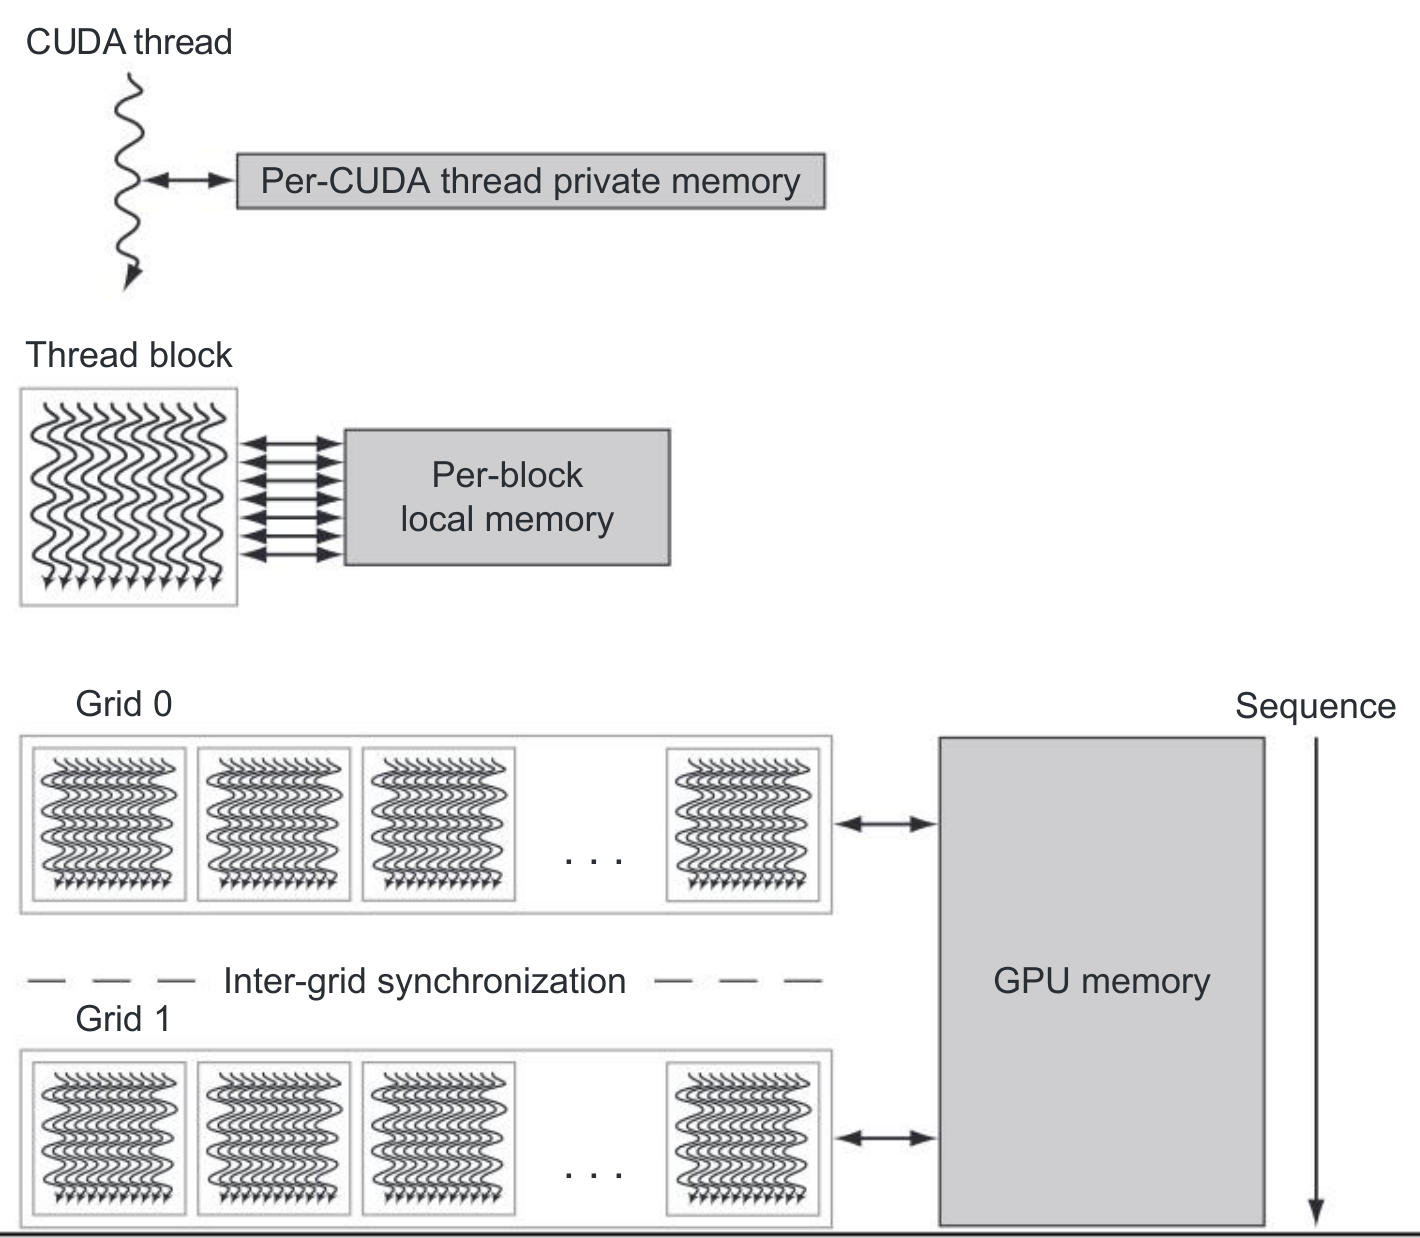
图内术语:CUDA thread=CUDA 线程;Per-CUDA thread private memory=每个 CUDA 线程的私有内存;Thread block=线程块;Per-block local memory=每个线程块的局部存储器;Grid=网格;Inter-grid synchronization=网格间同步;GPU memory=GPU 内存;Sequence=执行顺序。
称为主机的系统处理器可以读写 GPU 内存。局部存储器只属于各多线程 SIMD 处理器,主机无法访问;主机也无法访问私有内存。
GPU 传统上不依赖大型缓存容纳应用的整个工作集,而是使用较小的流式缓存。由于工作集可能达到数百兆字节,它依靠大量 SIMD 指令线程的多线程执行来隐藏 DRAM 长延迟。既然用多线程隐藏延迟,系统处理器中用于大型 L2、L3 缓存的芯片面积,就可以在 GPU 中用于计算资源和保存大量线程状态的寄存器。相比之下,向量加载和存储只支付一次延迟,然后将其余访问流水线化,把延迟分摊到许多元素上。
虽然用大量线程隐藏内存延迟是 GPU 最初的设计理念,但较新的 GPU 和向量处理器都使用缓存降低延迟。这可以用排队论中的 Little 定律解释:延迟越长,一次访存期间需要运行的线程越多,所需寄存器也越多。因此,GPU 增加缓存,是为了降低平均延迟,减轻潜在的寄存器数量不足。GPU 缓存设计时假定的命中率远低于 CPU 缓存,因为 GPU 经常处理从高带宽内存连续流入的数据。
前面说过,为提高内存带宽、降低开销,当同一个 SIMD 线程中并行线程的地址位于同一块内时,PTX 数据传送指令与内存控制器配合,把各请求合并成一个内存块请求。这给 GPU 程序施加了一些约束,类似系统处理器程序为了触发硬件预取而遵循的规则(见第 2 章)。GPU 内存控制器还会暂存请求,将指向同一个已打开 DRAM 页的请求一起发送,以提高带宽,见 4.6 节。第 2 章对 DRAM 的介绍足以帮助理解按相关地址分组的潜在收益。
较新 GPU 体系结构中的创新
真实 GPU 的多线程 SIMD 处理器比图 4.15 的简化版本复杂一些。为提高硬件利用率,每个 SIMD 处理器有两个 SIMD 线程调度器,每个带多个指令分派单元;有些 GPU 的调度器更多。双调度器选出两个 SIMD 指令线程,从各线程发射一条指令,送往两组各 16 个 SIMD 通道、16 个加载/存储单元,或 8 个特殊函数单元。多个执行单元使每个时钟周期都能调度两个 SIMD 指令线程,最多有 64 个通道活动。因为线程相互独立,不需要检查指令流之间的数据依赖。这类似一个通道数加倍、可以从两个独立线程发射向量指令的多线程向量处理器。
图 4.20 展示双调度器的指令发射,图 4.21 给出 Pascal GP100 GPU 的多线程 SIMD 处理器框图。
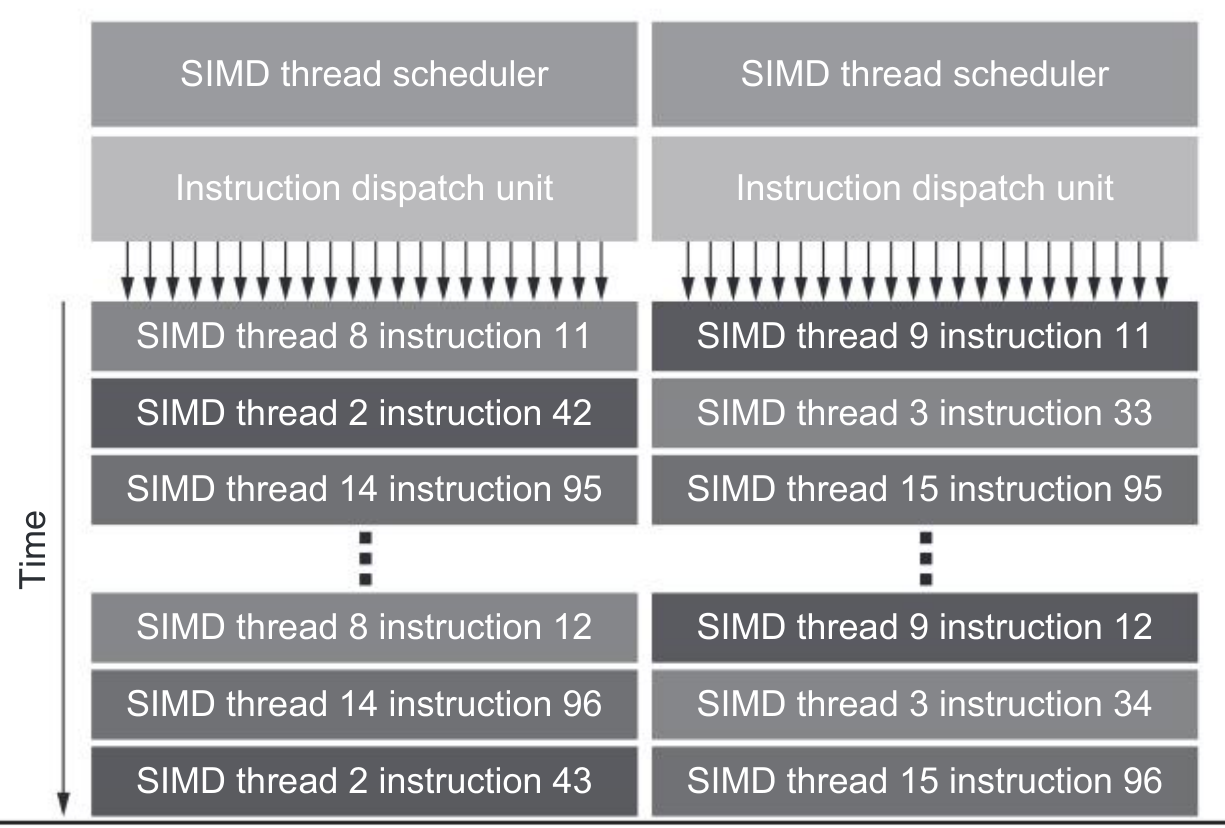
图内术语:SIMD thread scheduler=SIMD 线程调度器;Instruction dispatch unit=指令分派单元;Time=时间;SIMD thread N instruction M=SIMD 线程 N 的第 M 条指令。
译注: 本版单调度器的指令调度示意实际为图 4.17,图 4.16 是 P100 全芯片框图。原图注的图号未默改。
图 4.22 表明,每代新 GPU 通常都会增加一些提高性能或方便编程的特性。以 Pascal GPU 为例,主要有四项创新:
- 快速的单精度、双精度和半精度浮点运算。 Pascal GP100 对 IEEE 浮点标准的三种精度都提供很高性能:单精度峰值为 10 TFLOP/s;双精度约为其一半,即 5 TFLOP/s;半精度以二元素向量表示时,约为其两倍,即 20 TFLOP/s。原子内存操作包含这三种精度的浮点加法。Pascal GP100 是首款具有如此高半精度性能的 GPU。
- 高带宽内存。 Pascal GP100 采用堆叠式高带宽内存 HBM2。它有 4096 条数据线,运行在 0.7 GHz,提供 732 GB/s 的峰值带宽,比前代 GPU 快一倍以上。后续 GPU 使用更新、更快的 HBM。
- 高速芯片间互连。 GPU 是协处理器,当一个 CPU 配合多个 GPU 使用时,PCI 总线可能成为通信瓶颈。Pascal GP100 引入 NVLink 通信通道,每个方向最多支持 20 GB/s 数据传送。
每个 GP100 有 4 条 NVLink 通道,每芯片的双向总峰值带宽为 160 GB/s。面向多 GPU 应用的系统可配置 2、4 或 8 个 GPU;每个 GPU 都能对通过 NVLink 连接的其他 GPU 执行加载、存储和原子操作。某些情况下,NVLink 还能与 CPU 通信,例如 IBM Power9 及后续 CPU 支持 CPU—GPU 通信。在这类芯片中,NVLink 为相连的全部 GPU 和 CPU 提供一致的内存视图,并且可以在缓存之间直接通信,而不必经由内存到内存的传送。
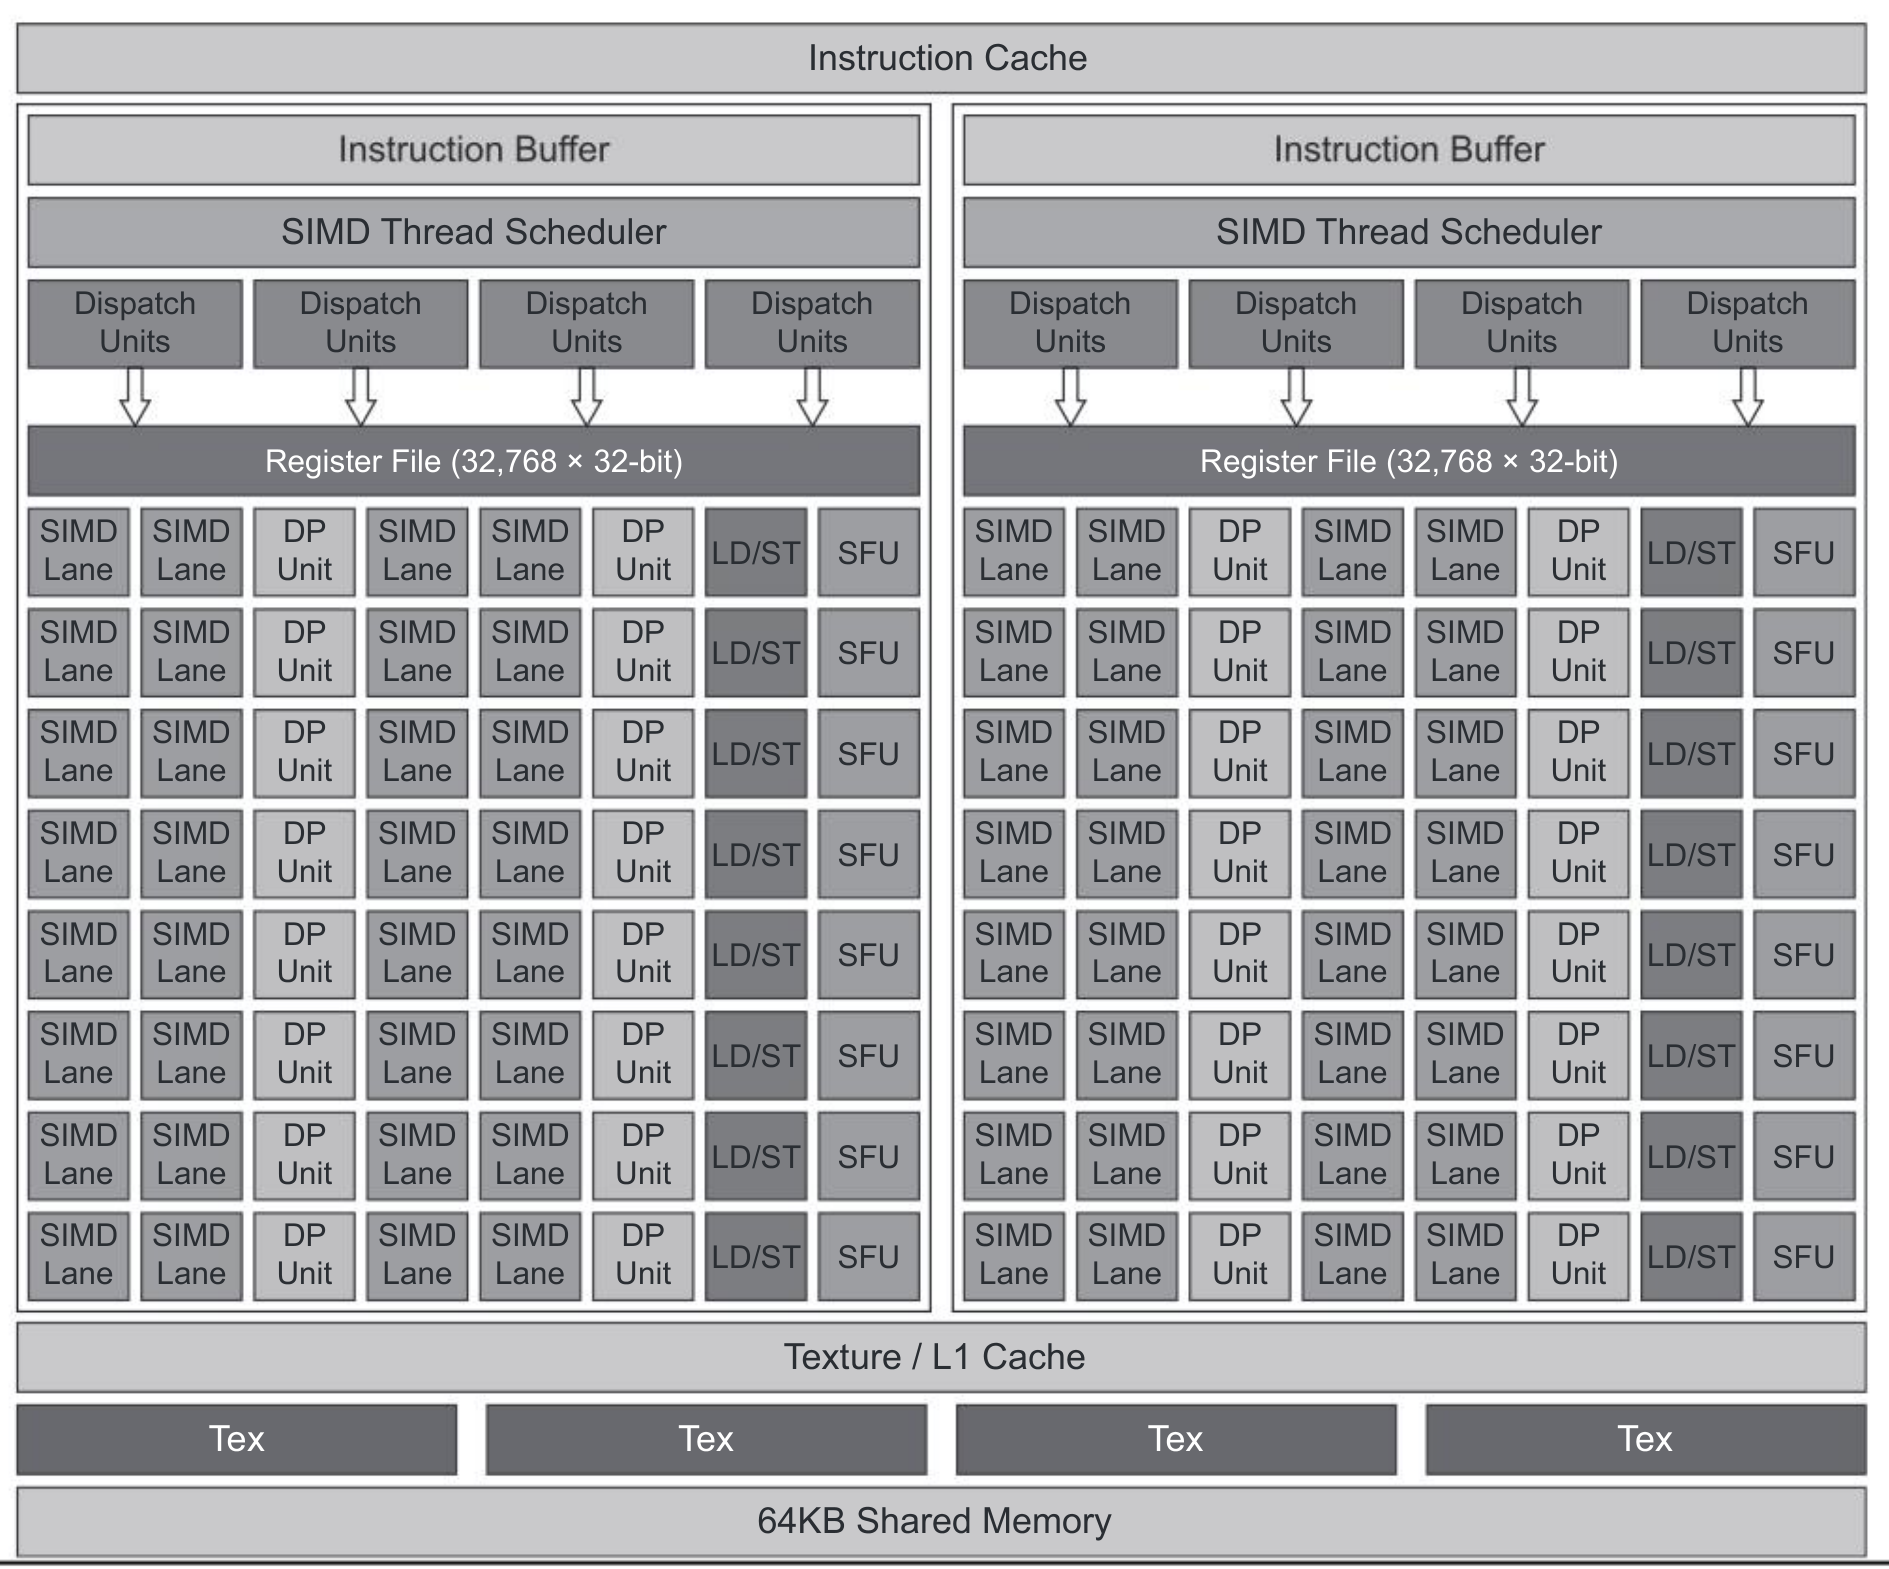
图内术语:Instruction Cache=指令缓存;Instruction Buffer=指令缓冲区;SIMD Thread Scheduler=SIMD 线程调度器;Dispatch Units=分派单元;Register File=寄存器堆;SIMD Lane=SIMD 通道;DP Unit=双精度单元;Texture / L1 Cache=纹理/L1 缓存;Tex=纹理单元;Shared Memory=共享存储器,即本节所称局部存储器。
- 统一虚拟内存和分页支持。 Pascal GP100 在统一虚拟地址空间内增加了缺页处理能力,使同一系统中所有 GPU 和 CPU 能以同一个虚拟地址表示同一数据结构。线程访问远端地址时,一个内存页会传到本地 GPU,供后续使用。统一内存以按需分页替代 CPU 与 GPU 或不同 GPU 之间的显式内存复制,简化编程模型;它也允许分配远超 GPU 实际容量的内存,以处理内存需求很大的问题。与任何虚拟内存系统一样,仍须避免过度页面迁移。
| GPU 型号 | P100 | V100 | A100 | H100 |
|---|---|---|---|---|
| 发布年份 | 2016 | 2017 | 2020 | 2022 |
| SM 数量 | 56 | 80 | 108 | 132 |
| 基准时钟频率(GHz) | 1.19 | 1.12 | 1.10 | 1.13 |
| Turbo 模式时钟频率(GHz) | 1.48 | 1.53 | 1.41 | 1.98 |
| 裸片面积(mm²) | 610 | 815 | 826 | 814 |
| 工艺(TSMC) | 16 nm | 12 nm FinFET+ | 7 nm N7 | 4N |
| 功率(W) | 300 | 300 | 400 | 700 |
| 晶体管数量(十亿) | 15.3 | 21.1 | 54.2 | 80 |
| 内存带宽(GB/s) | 732 | 900 | 2000 | 3350 |
| L2 缓存大小(MB) | 4 | 6 | 40 | 50 |
| 单精度 SIMD 宽度 | 8 | 32 | 32 | 32 |
| 双精度 SIMD 宽度 | 4 | 32 | 32 | 32 |
| 峰值单精度性能(GFLOP/s) | 10,608 | 15,700 | 19,500 | 66,900 |
| 峰值双精度性能(GFLOP/s) | 5,304 | 7,800 | 9,700 | 33,500 |
| 面向机器学习的峰值 16 位性能(GFLOP/s) | N.A. | 125,000 | 312,000 | 989,000 |
| 面向机器学习的峰值 8 位性能(GFLOP/s) | N.A. | N.A. | N.A. | 1,979,000 |
图 4.22 列出四代 GPU 的关键参数,图 4.23 则以 Pascal P100 为基准展示其变化。变化最大的是 L2 缓存容量,其次是单、双精度峰值浮点性能和晶体管数量。A100 的浮点性能增幅相对于晶体管数量增幅较小,因为它主要着眼于提高机器学习性能,见图 4.22 最后两行及第 7 章。H100 浮点性能的大幅提升,部分来自接近翻倍的功率和 4 nm 工艺。
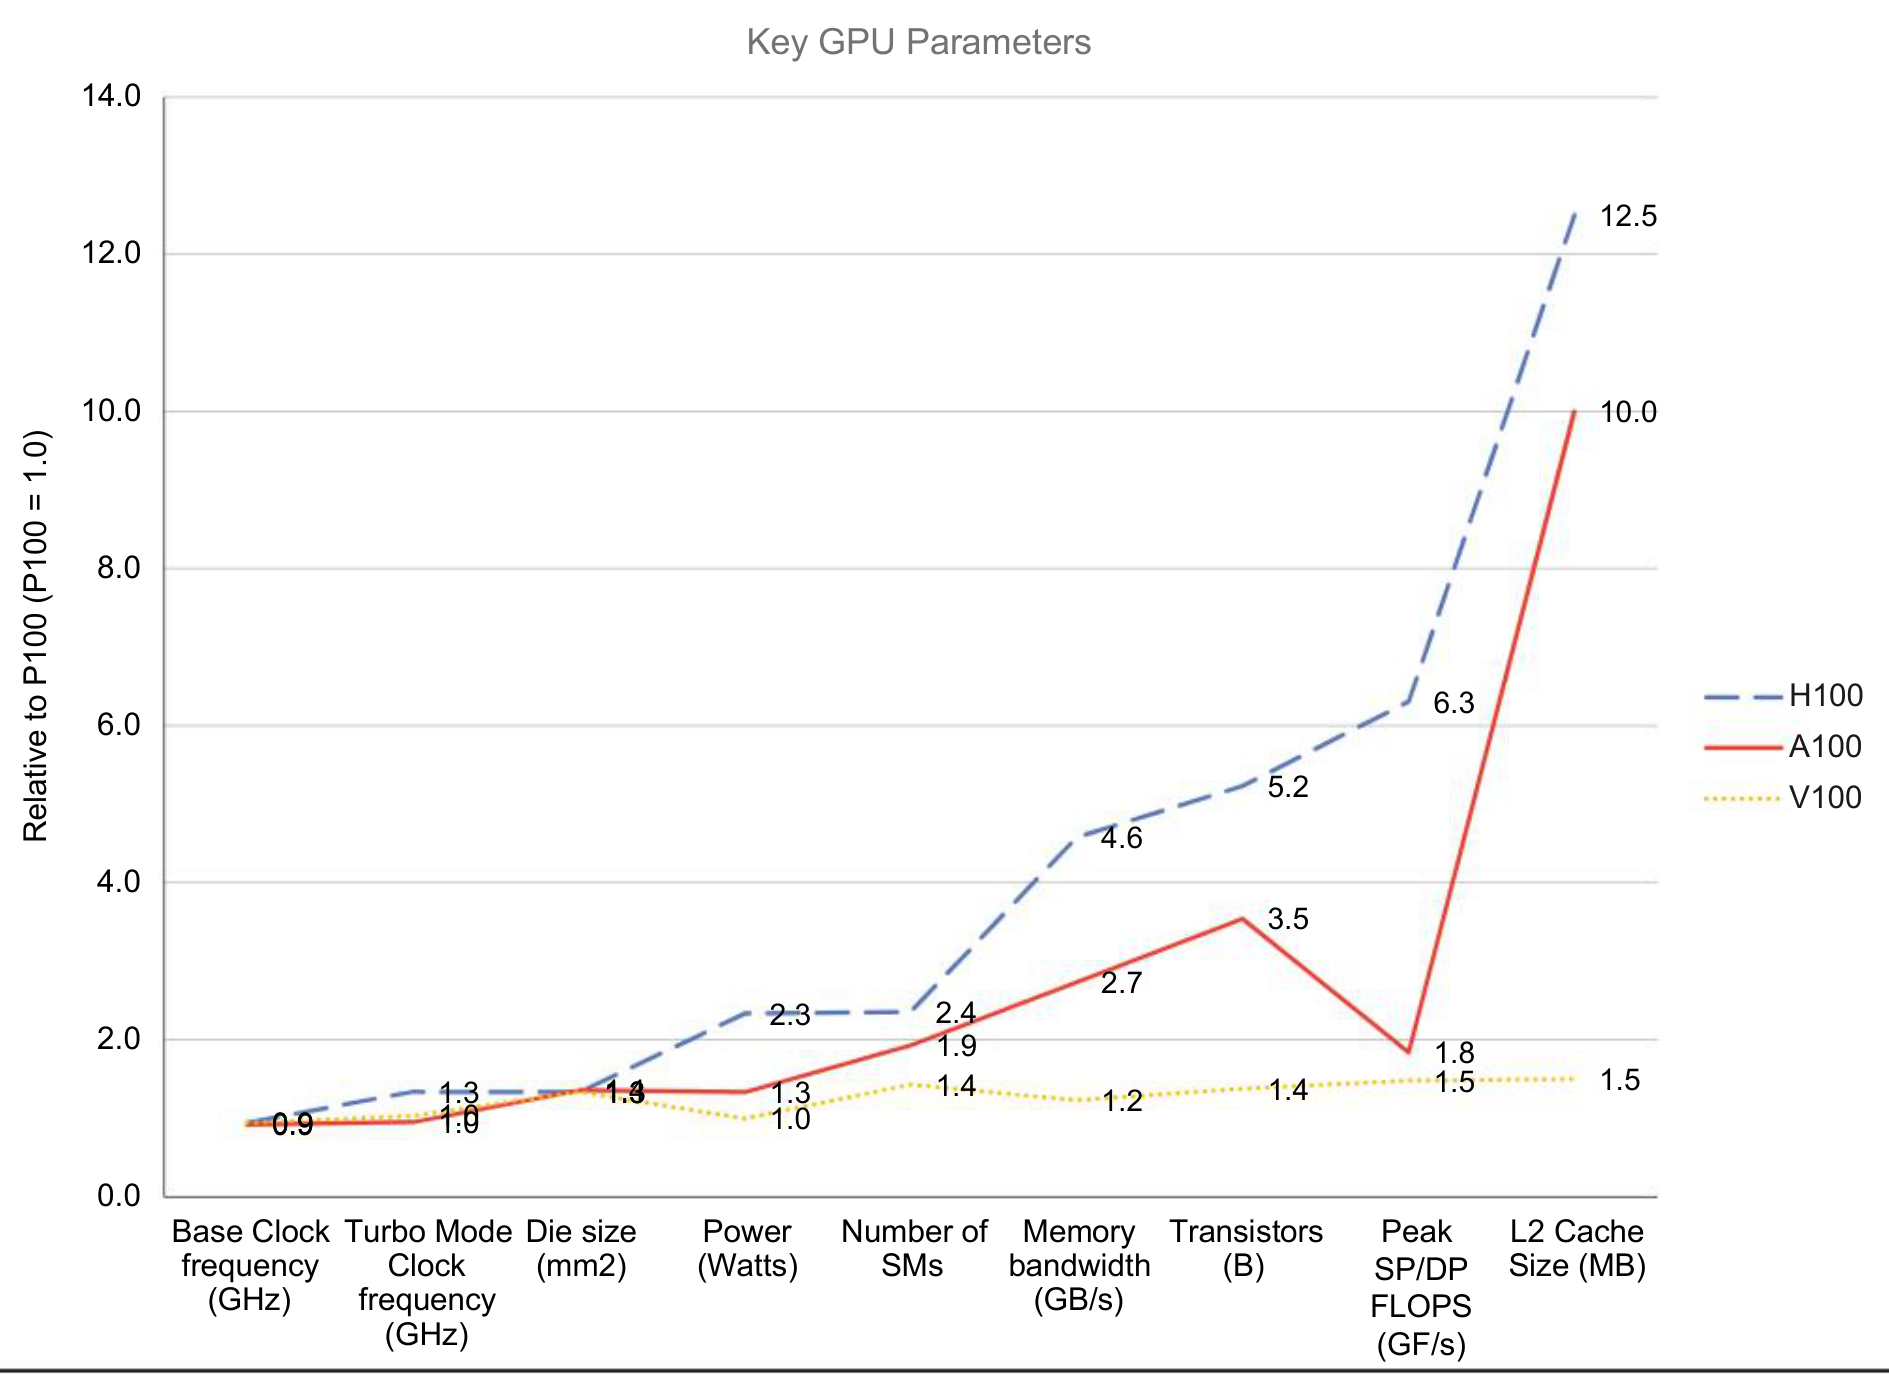
图中纵轴以 P100 = 1.0 归一化;横轴依次为基准时钟频率、Turbo 模式时钟频率、裸片面积、功率、SM 数量、内存带宽、晶体管数量、单/双精度峰值浮点性能、L2 缓存容量;三条线分别表示 H100、A100 和 V100。单位与数值见图 4.22。
向量体系结构与 GPU 的异同
正如我们看到的,向量体系结构与 GPU 确实有很多相似之处。这些相似性加上 GPU 特殊的术语,使部分体系结构研究者对 GPU 究竟有多新颖产生困惑。了解两者的内部组织后,就能够理解它们的共同点和差别。两者都为数据级并行程序而设计,却走了不同道路,因此值得深入比较,以更好地理解 DLP 硬件需要什么。图 4.24 先列出向量术语,再给出 GPU 中最接近的对应概念。
SIMD 处理器类似向量处理器。GPU 中的多个 SIMD 处理器像独立的 MIMD 核一样工作,就像许多向量计算机包含多个向量处理器。从这个角度看,NVIDIA H100 是一台具有硬件多线程支持的 132 核机器,每个核有 64 个通道。
| 类别 | 向量术语 | 最接近的 CUDA/NVIDIA GPU 术语 | 说明 |
|---|---|---|---|
| 程序抽象 | 向量化循环 | Grid | 概念相似,但 GPU 的名称描述性较弱 |
| 程序抽象 | chime | — | Pascal 一条向量指令(PTX 指令)只需 2 周期,因此 GPU 的 chime 很短。Pascal 有两个支持常用浮点指令的执行单元,可交替使用,实际发射速率为每周期一条指令 |
| 机器对象 | 向量指令 | PTX Instruction | SIMD 线程的一条 PTX 指令广播到全部 SIMD 通道,类似向量指令 |
| 机器对象 | 聚集/散布 | 全局加载/存储(ld.global/st.global) | 所有 GPU 加载和存储都是聚集/散布,每个通道提供独立地址;若地址允许,由合并单元实现单位步长性能 |
| 机器对象 | 掩码寄存器 | 谓词寄存器与内部掩码寄存器 | 向量掩码是显式体系结构状态,GPU 掩码则位于硬件内部;GPU 条件执行硬件在谓词之外增加了动态管理掩码的机制 |
| 处理与存储硬件 | 向量处理器 | 多线程 SIMD 处理器 | 两者相似,但 SIMD 处理器通常通道较多,每通道只需少数周期即可完成向量;向量体系结构通道较少,完成向量需要较多周期。前者还支持多线程,后者通常不支持 |
| 处理与存储硬件 | 控制处理器 | 线程块调度器 | 最接近的是把线程块分配给多线程 SIMD 处理器的调度器。但 GPU 没有标量—向量操作,也没有单位步长或带步长的数据传送指令,而向量控制处理器经常提供这些功能 |
| 处理与存储硬件 | 标量处理器 | 系统处理器 | 缺少共享内存且通过 PCI 总线通信需要数千周期,使 GPU 配套的系统处理器很少承担向量体系结构中标量处理器所承担的任务 |
| 处理与存储硬件 | 向量通道 | SIMD 通道 | 很相似,本质上都是带寄存器的功能单元 |
| 处理与存储硬件 | 向量寄存器 | SIMD 通道寄存器 | 多线程 SIMD 处理器执行一个 SIMD 指令线程时,全部 16 个通道中同名的寄存器相当于一个向量寄存器。每线程寄存器数量可变,Pascal 最多为 256,因此最多相当于 256 个向量寄存器 |
| 处理与存储硬件 | 主存 | GPU 内存 | 前者是向量系统内存,后者是 GPU 内存 |
最大的差异在于多线程:它是 GPU 的基础,而大多数向量处理器没有这一机制。
再看寄存器。本节实现中的 RV64V 寄存器堆保存完整向量,即连续的一组元素;GPU 中的一个向量则分散在所有 SIMD 通道的寄存器中。RV64V 处理器有 32 个向量寄存器,每个可能保存 32 个元素,总共 1024 个。GPU 的一个 SIMD 指令线程最多有 256 个寄存器,每个含 32 个元素,共 8192 个。这些额外寄存器用于支持多线程。
图 4.25 左侧是向量处理器执行单元,右侧是 GPU 的多线程 SIMD 处理器。为了讲解,我们假定二者都只有 4 个通道。图中,四个 SIMD 通道协同工作,很像四通道向量单元;整个 SIMD 处理器也很像一个向量处理器。
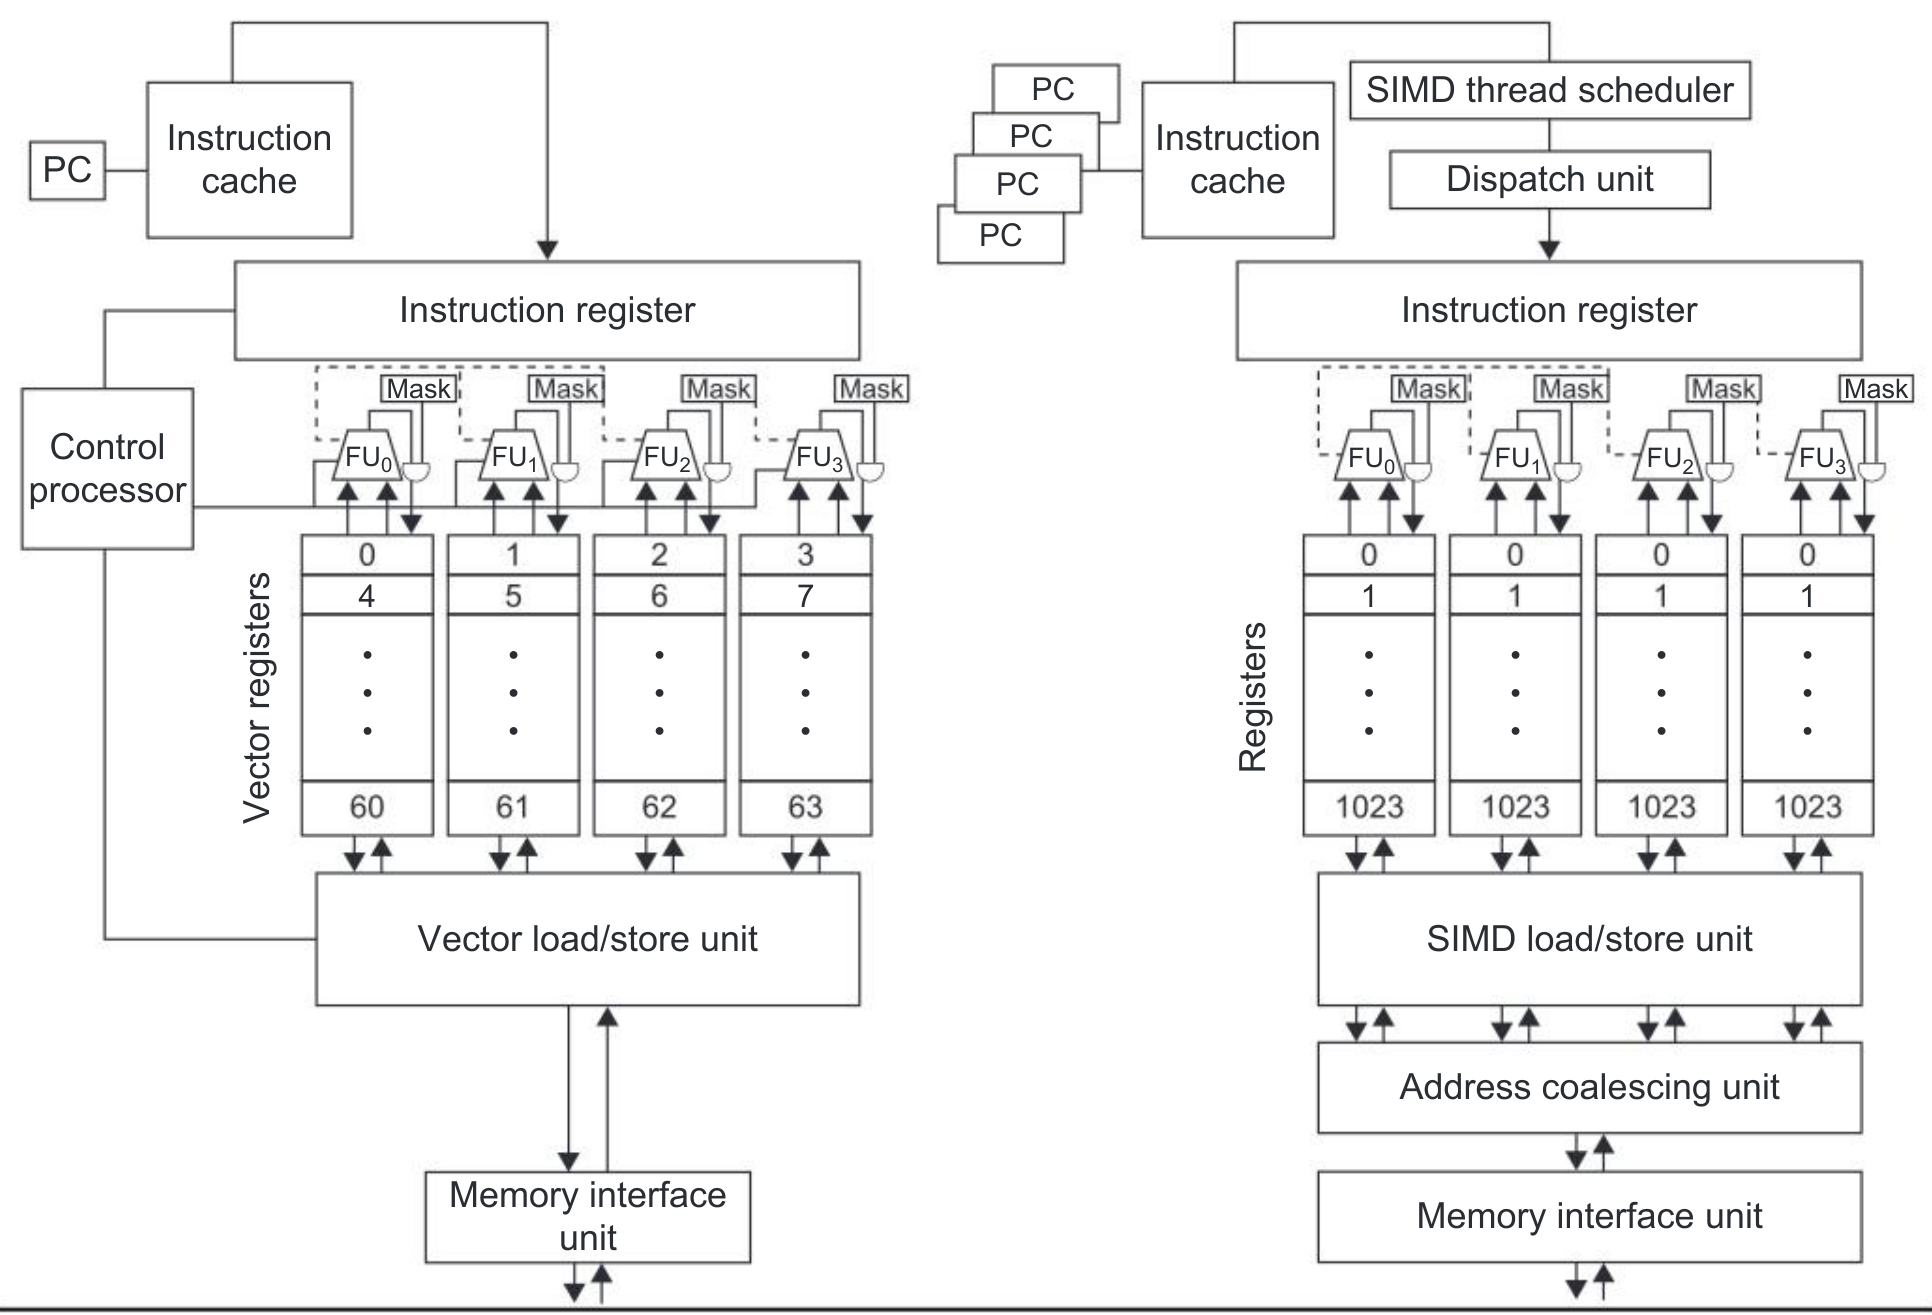
图内术语:PC=程序计数器;Mask=掩码;FU=功能单元;Instruction cache/register=指令缓存/寄存器;Control processor=控制处理器;Vector registers=向量寄存器;Vector/SIMD load/store unit=向量/SIMD 加载存储单元;Memory interface unit=内存接口单元;SIMD thread scheduler=SIMD 线程调度器;Dispatch unit=分派单元;Address coalescing unit=地址合并单元。
实际上 GPU 的通道更多,因此它的“chime”更短。向量处理器可能有 2~8 个通道、向量长度为 32,对应 4~16 个时钟周期的 chime;多线程 SIMD 处理器可能有 8 或 16 个通道,SIMD 线程宽度为 32 个元素,因此 chime 只有 4 或 2 个周期。这正是我们使用“SIMD 处理器”这一描述性名称的原因:它比传统向量处理器更接近 SIMD 设计。
GPU 中与向量化循环最接近的是网格;与向量指令最接近的是 PTX 指令,因为 SIMD 线程会将一条 PTX 指令广播到所有通道。
对于内存访问,GPU 的所有加载都是聚集,所有存储都是散布。如果 CUDA 线程同时访问的邻近地址落在同一缓存块或内存块内,GPU 的地址合并单元就能提供高带宽。向量体系结构显式提供单位步长加载/存储,而 GPU 编程中的单位步长是隐含的;这解释了为什么 CUDA 虽然看起来像 MIMD,高效 GPU 代码仍要求程序员按 SIMD 操作来思考。CUDA 线程可以生成自己的地址,包括步长和聚集/散布地址,因此两种体系结构都有地址向量。
两者隐藏内存延迟的方法很不相同。向量体系结构用深流水线访问,把延迟分摊到全部向量元素上,每次向量加载只支付一次延迟。因此,向量加载和存储类似内存与向量寄存器之间的块传送。GPU 则用多线程隐藏延迟。有些研究者正尝试为向量体系结构加入多线程,以兼得两者的优点。
对于条件分支,两者都使用掩码寄存器。两条条件路径即使不保存结果,也会占用时间或空间。区别是向量编译器在软件中显式管理掩码,而 GPU 硬件与汇编器通过分支同步标记和内部栈,隐式保存、取反、恢复掩码。
向量计算机的控制处理器在向量指令执行中作用重要。它向全部向量通道广播操作,并为向量—标量操作广播标量寄存器值;还会隐式进行 GPU 中需要显式执行的计算,例如为单位步长和非单位步长访存自动递增地址。GPU 没有这样的控制处理器,最接近的是把线程块分配给多线程 SIMD 处理器的线程块调度器。许多 DLP 应用的地址天然相邻,但 GPU 仍需要运行时硬件先生成地址,再检查它们是否相邻,这很可能不如使用控制处理器节能,尤其是常见的单位步长访问。
向量计算机的标量处理器执行向量程序中的标量指令,即那些放在向量单元上执行会太慢的操作。与 GPU 配套的系统处理器最接近这一角色,但分离的地址空间和 PCIe 传送,使二者配合需要数千个周期的开销。向量计算机中的标量处理器做浮点计算可能慢于向量处理器,却不会慢到系统处理器与 GPU 多线程 SIMD 处理器之间那样的程度,尤其把通信开销算进去后。
因此,GPU 中每个“向量单元”都必须执行一些在向量计算机中本应交给标量处理器的工作。与其在系统处理器上计算再传回结果,不如用谓词寄存器和内部掩码关闭除一个以外的所有通道,让单个通道完成标量任务,反而可能更快。向量计算机中相对简单的标量处理器,很可能比这种 GPU 方案更快、更节能。如果未来系统处理器与 GPU 结合得更紧密,例如 NVIDIA Grace 处理器,那么系统处理器能否像向量和多媒体 SIMD 体系结构中的标量处理器那样工作,将是一个值得关注的问题。
多媒体 SIMD 计算机与 GPU 的异同
从高层看,带有多媒体 SIMD 扩展的多核计算机与 GPU 确实具有相似之处。图 4.26 汇总了它们的异同。
| 特性 | 带 SIMD 的多核计算机 | GPU |
|---|---|---|
| SIMD 处理器数量 | 4~8 | 8~32 |
| 每处理器的 SIMD 通道数 | 2~4 | 最多 64 |
| 硬件多线程支持的 SIMD 线程数 | 2~4 | 最多 64 |
| 典型单精度/双精度性能比 | 2:1 | 2:1 |
| 最大缓存容量 | 40 MB | 4 MB |
| 内存地址宽度 | 64 位 | 64 位 |
| 主存容量 | 最多 1024 GB | 最多 24 GB |
| 页级内存保护 | 支持 | 支持 |
| 按需分页 | 支持 | 支持 |
| 标量处理器与 SIMD 处理器集成 | 是 | 否 |
| 缓存一致性 | 支持 | 部分系统支持 |
译注: 本表的规模与容量数据不应视为前面图 4.22 中各代 GPU 的统一上限;例如本章已列出 H100 的 132 个 SM 和 50 MB L2 缓存。
两者都是多处理器,各处理器都使用多个 SIMD 通道,只是 GPU 的处理器和通道多得多。两者都用硬件多线程提高利用率,只是 GPU 支持的线程多得多。两者的单精度与双精度峰值浮点性能比大致都是 2:1。两者都使用缓存,但 GPU 使用较小的流式缓存,多核计算机则使用大型多级缓存,试图完整容纳工作集。两者都使用 64 位地址空间,但 GPU 的物理主存小得多。两者都支持页级内存保护和按需分页,因此能够寻址远超板载容量的内存。
除了处理器数、通道数、硬件线程数和缓存容量的巨大数量差异,还存在许多体系结构差异。传统计算机中的标量处理器与多媒体 SIMD 指令紧密集成;GPU 则隔着 I/O 总线,甚至拥有独立主存。GPU 内的多个 SIMD 处理器使用同一地址空间;在 CPU 厂商支持下,例如 IBM Power9,一些系统还可以提供全部内存的一致视图。与 GPU 不同,多媒体 SIMD 历来缺少聚集/散布访存支持,4.7 节将说明这是一项重要缺失。
向量体系结构编程的一项关键方法,是阅读编译器关于哪些循环已向量化的报告,并据此修改代码。GPU 编译器几乎不说明代码将以多高效率执行;程序员必须借助性能分析工具,例如 NVIDIA Parallel Nsight,获得动态执行行为的反馈,再判断怎样改进代码。
CUDA/SIMT 比一些人预想的更成功,是因为它以合适的方式在程序员与系统之间分配了开发并行性的工作:把容易但繁琐的优化留给系统,让程序员专注于寻找足够外层循环并行性这个困难问题。这种分工甚至可能促使程序员寻找全新的算法。
CUDA/SIMT 刚出现时,许多体系结构设计者持怀疑态度,因为他们假定程序或算法相对固定,任务是针对这个固定输入优化其余系统。从这个角度看,大量开发者似乎不太可能投入时间重写大批代码,因此 GPU 计算会一直停留在小众领域。过于关注为既有平台编写的标准基准测试,也让体系结构设计者难以想象:新的、具有重大经济价值的应用,会从头开始主要面向不同于 CPU 的新体系结构编写。
GPU 的幸运之处在于,机器学习应用并不建立在数千名程序员编写数百万行代码之上,因此更容易从头编写新应用。它的智能来自一个相对较小的程序从数据中学习,而不是把智能编码成庞大程序。在标准 Python 框架 JAX、PyTorch、TensorFlow 中编写的小型内核,可以通过数千块 GPU 分析海量数据、训练数周,产生有价值的深度神经网络。
小结
揭开术语的面纱后,可以看到 GPU 本质上是多线程 SIMD 处理器的集合,只是比传统多核计算机拥有更多处理器、每处理器更多通道,以及更多多线程硬件。例如,Hopper H100 GPU 有 132 个 SIMD 处理器,每个有 64 个通道,并支持 64 个 SIMD 线程。Pascal 通过从两个 SIMD 线程向两组通道发射指令来利用指令级并行性。GPU 的缓存也较少,Hopper 的 L2 为 50 MiB;通过远端标量处理器或远端 GPU 的配合,还能维持缓存一致性。
CUDA 编程模型用一个抽象——CUDA 线程——包装了所有这些并行形式。程序员可以认为自己在为数千个线程编程,实际上,每组 32 个线程在许多 SIMD 处理器的通道上执行。追求良好性能的程序员需要记住:这些线程按块组织,每次执行 32 个;要获得良好的存储系统性能,访问地址应彼此相邻。
本节虽然采用 CUDA 和 NVIDIA GPU,但 OpenCL 以及其他厂商的 GPU 中也能找到相同思想。
现在理解了 GPU 的工作方式,就可以揭示正式术语了。图 4.27 和图 4.28 将本节的描述性名称与定义,对应到 CUDA/NVIDIA 和 AMD 的正式术语,并列出 OpenCL 名称。我们认为,GPU 学习曲线陡峭,部分原因就在于把 SIMD 处理器称为 streaming multiprocessor,把 SIMD 通道称为 thread processor,把局部存储器称为 shared memory,尤其是这块局部存储器根本不在不同 SIMD 处理器之间共享!希望这种虽稍绕路、但分两步解释的方法,能帮助读者更快理解。
| 类别 | 本书的描述性名称 | CUDA/NVIDIA 正式术语 | 简要说明及 AMD/OpenCL 名称 | CUDA/NVIDIA 正式定义 |
|---|---|---|---|---|
| 程序抽象 | 可向量化循环 | Grid | 在 GPU 上执行的可向量化循环,由一个或多个可并行执行的线程块(向量化循环体)组成。OpenCL 称 index range,AMD 称 NDRange | 线程块组成的数组,可以并发、顺序或混合执行 |
| 程序抽象 | 向量化循环体 | Thread Block | 在多线程 SIMD 处理器上执行的向量化循环,由一个或多个 SIMD 指令线程组成,线程间通过局部存储器通信。AMD 和 OpenCL 称 work group | 并发执行的 CUDA 线程数组,可通过共享内存和屏障同步合作、通信;线程块在网格内有一个线程块 ID |
| 程序抽象 | SIMD 通道操作序列 | CUDA Thread | SIMD 指令线程的纵向切片,对应一个通道执行的一个元素,是否保存结果取决于掩码。AMD 和 OpenCL 称 work item | 执行顺序程序的轻量级线程,可与同一线程块中的其他 CUDA 线程合作;在块内具有线程 ID |
| 机器对象 | SIMD 指令线程 | Warp | 仅含 SIMD 指令的传统线程,在多线程 SIMD 处理器上运行,是否保存结果由逐元素掩码决定。AMD 称 wavefront | 一组并行 CUDA 线程(例如 32 个),在多线程 SIMT/SIMD 处理器中共同执行同一条指令 |
| 机器对象 | SIMD 指令 | PTX instruction | 跨多个 SIMD 通道执行的一条 SIMD 指令。AMD 称 AMDIL 或 FSAIL 指令 | 指定由一个 CUDA 线程执行的指令 |
| 类别 | 本书的描述性名称 | CUDA/NVIDIA 正式术语 | 简要说明及 AMD/OpenCL 名称 | CUDA/NVIDIA 正式定义 |
|---|---|---|---|---|
| 处理硬件 | 多线程 SIMD 处理器 | Streaming multiprocessor | 执行 SIMD 指令线程,独立于其他 SIMD 处理器。AMD 和 OpenCL 称 compute unit;但 CUDA 程序员为一个通道编程,而不是为多个通道组成的“向量”编程 | SM 是执行 CUDA 线程 Warp 的多线程 SIMT/SIMD 处理器;SIMT 程序指定单个 CUDA 线程的执行,而不是多个 SIMD 通道构成的向量 |
| 处理硬件 | 线程块调度器 | Giga Thread Engine | 将多个向量化循环体分配给多线程 SIMD 处理器。AMD 称 Ultra-Threaded Dispatch Engine | 当资源可用时,将网格中的线程块分派并调度到 SM |
| 处理硬件 | SIMD 线程调度器 | Warp scheduler | 调度和发射已就绪的 SIMD 指令线程,含记分牌以跟踪执行。AMD 称 Work Group Scheduler | SM 中的 Warp 调度器在 Warp 的下一条指令就绪时调度其执行 |
| 处理硬件 | SIMD 通道 | Thread processor | 对单个元素执行 SIMD 指令线程中的操作,是否保存结果由掩码决定。OpenCL 称 processing element;AMD 也称 SIMD Lane | SM 中的数据通路和寄存器堆部分,执行一个 Warp 的一个或多个通道的操作 |
| 存储硬件 | GPU 内存 | Global memory | GPU 中所有多线程 SIMD 处理器可访问的 DRAM。OpenCL 称 global memory | 任意网格、任意线程块的所有 CUDA 线程均可访问;实现为一块 DRAM 区域,可以被缓存 |
| 存储硬件 | 私有内存 | Local memory | 每个 SIMD 通道私有的一部分 DRAM。AMD 和 OpenCL 都称 private memory | CUDA 线程私有的线程局部内存,实现为可缓存的 DRAM 区域 |
| 存储硬件 | 局部存储器 | Shared memory | 一个多线程 SIMD 处理器内部的快速 SRAM,其他处理器不可访问。OpenCL 称 local memory,AMD 称 group memory | 组成同一线程块的 CUDA 线程共享、而对该块私有的快速 SRAM,用于在线程块的屏障同步点进行线程间通信 |
| 存储硬件 | SIMD 通道寄存器 | Registers | 单个 SIMD 通道内的寄存器,在向量化循环体中分配。AMD 也称 registers | CUDA 线程的私有寄存器;每个线程处理器中的多线程寄存器堆,为若干 Warp 的特定通道提供寄存器 |