4.7 融会贯通:嵌入式与服务器 GPU、Tesla 与 Core i7
图形应用十分普及,因此,移动客户端、笔记本电脑、高性能台式机和传统服务器中如今都能看到 GPU。图 4.29 列出了面向平板电脑和笔记本客户端的 Intel Xe GPU 片上系统,以及面向服务器的 NVIDIA Hopper GPU 的主要特征。
Iris Xe ICX 是 Intel GPU 微体系结构家族中的低功耗成员。它的基本构件是执行单元(Execution Unit,EU),即一个支持七路多线程的 SIMD 处理器。每个线程有 128 个寄存器,每个寄存器宽 32 字节。主要计算单元是一个八路 SIMD 单元,用于浮点和整数计算;辅助单元是一个两路 SIMD 单元,用于扩展数学运算。
每个 EU 每个时钟周期能够执行 16 次 16 位浮点运算,或 8 次 32 位浮点运算。图 4.29 所列实例有 96 个 EU、12 MB L3 缓存,每个时钟周期可以向 DRAM 传输 128 字节数据。
NVIDIA Hopper H100 的睿频时钟频率为 2.0 GHz,包含 132 个 SIMD 处理器。通往 HBM3 存储器的数据通路宽 5120 位,在 2.62 GHz 时钟的上升沿和下降沿都传输数据,因此,峰值存储器带宽为 3330 GB/s。
H100 裸片的各项物理指标都相当惊人:它包含 800 亿个晶体管,采用 TSMC 4 nm 工艺,裸片面积为 814 mm²,典型功率为 700 W。
| 特征 | Intel Xe GPU(Core i7-1195G7 中) | NVIDIA Hopper H100 |
|---|---|---|
| 推出年份 | 2021 | 2022 |
| 核心数 | 96 | 132 |
| 基础时钟频率(GHz) | 0.30 | 1.13 |
| 睿频时钟频率(GHz) | 1.40 | 1.98 |
| 裸片面积(mm²) | N.A. | 814 |
| 制造工艺 | Intel 10 nm SF | TSMC 4N |
| 功率(W) | 最高 28(包括 CPU、缓存等) | 700 |
| 晶体管数(十亿) | N.A. | 80 |
| 存储器技术 | LPDDR4x-4267 | HBM3 |
| 存储器容量(GB) | 32 | 80 |
| 存储器带宽(GB/s) | 68 | 3350 |
| 片上存储容量(MB) | 12 | 50 |
| 单精度 SIMD 宽度 | 8 | 32 |
| 双精度 SIMD 宽度 | N.A. | 32 |
| 单精度峰值(GFLOP/s) | N.A. | 66,900 |
| 双精度峰值(GFLOP/s) | N.A. | 33,500 |
| 机器学习 16 位峰值(GFLOP/s) | 4300 | 989,000 |
译注: 正文把 H100 的峰值带宽写为 3330 GB/s,图 4.29 写为 3350 GB/s。按正文给出的位宽和频率计算, GB/s。
GPU 与带有多媒体 SIMD 的 MIMD 的比较
一组 Intel 研究人员发表了一篇论文(Lee 等,2010),比较了带有多媒体 SIMD 扩展的四核 Intel i7 与 Tesla GTX 280。虽然这项研究没有采用 CPU 和 GPU 的最新版本,但它解释了性能差异背后的原因,因此是对这两种风格最深入的比较。此外,这两类体系结构的当前版本,与研究中的版本仍有许多相似之处。
图 4.30 列出了两个系统的特征。这两款产品都是在 2009 年秋季购买的。Core i7 采用 Intel 的 45 nm 半导体工艺,GPU 采用 TSMC 的 65 nm 工艺。如果由中立方,或由两个利益相关方共同进行比较,也许会更加公平;不过,本节的目的并非判定一种产品比另一种快多少,而是理解这两种截然不同的体系结构风格中,各项特征的相对价值。
| 特征 | Intel Core i7-960 | NVIDIA GTX 280 | GTX 280 / Core i7 |
|---|---|---|---|
| 处理单元数(核或 SM) | 4 | 30 | 7.5 |
| 时钟频率(GHz) | 3.2 | 1.3 | 0.41 |
| 裸片面积 | 263 | 576 | 2.2 |
| 制造工艺 | Intel 45 nm | TSMC 65 nm | 1.6 |
| 芯片功率(不是模块功率) | 130 | 130 | 1.0 |
| 晶体管数 | 7 亿 | 14 亿 | 2.0 |
| 存储器带宽(GB/s) | 32 | 141 | 4.4 |
| 单精度 SIMD 宽度 | 4 | 8 | 2.0 |
| 双精度 SIMD 宽度 | 2 | 1 | 0.5 |
| 单精度标量峰值(GFLOP/s) | 26 | 117 | 4.6 |
| 单精度 SIMD 峰值(GFLOP/s) | 102 | 311–933 | 3.0–9.1 |
| 单精度:一次加法或乘法 | N.A. | (311) | (3.0) |
| 单精度:一次融合乘加 | N.A. | 622 | 6.1 |
| 单精度:双发射融合乘加与乘法(罕见情况) | N.A. | 933 | 9.1 |
| 双精度 SIMD 峰值(GFLOP/s) | 51 | 78 | 1.5 |
译注: 原表制造工艺的比值写为 1.6,按表内数字 。图注所指“图 4.28”是术语比较表,不含带宽数据,显然是交叉引用错误;本节随后图 4.31 才列出实测 Roofline 带宽。以上均保留原值并注明。
图 4.31 中 Core i7 920 与 GTX 280 的 Roofline 曲线显示了这两台计算机的差异。920 的时钟频率低于 960(2.66 GHz 对 3.2 GHz),系统的其余部分相同。
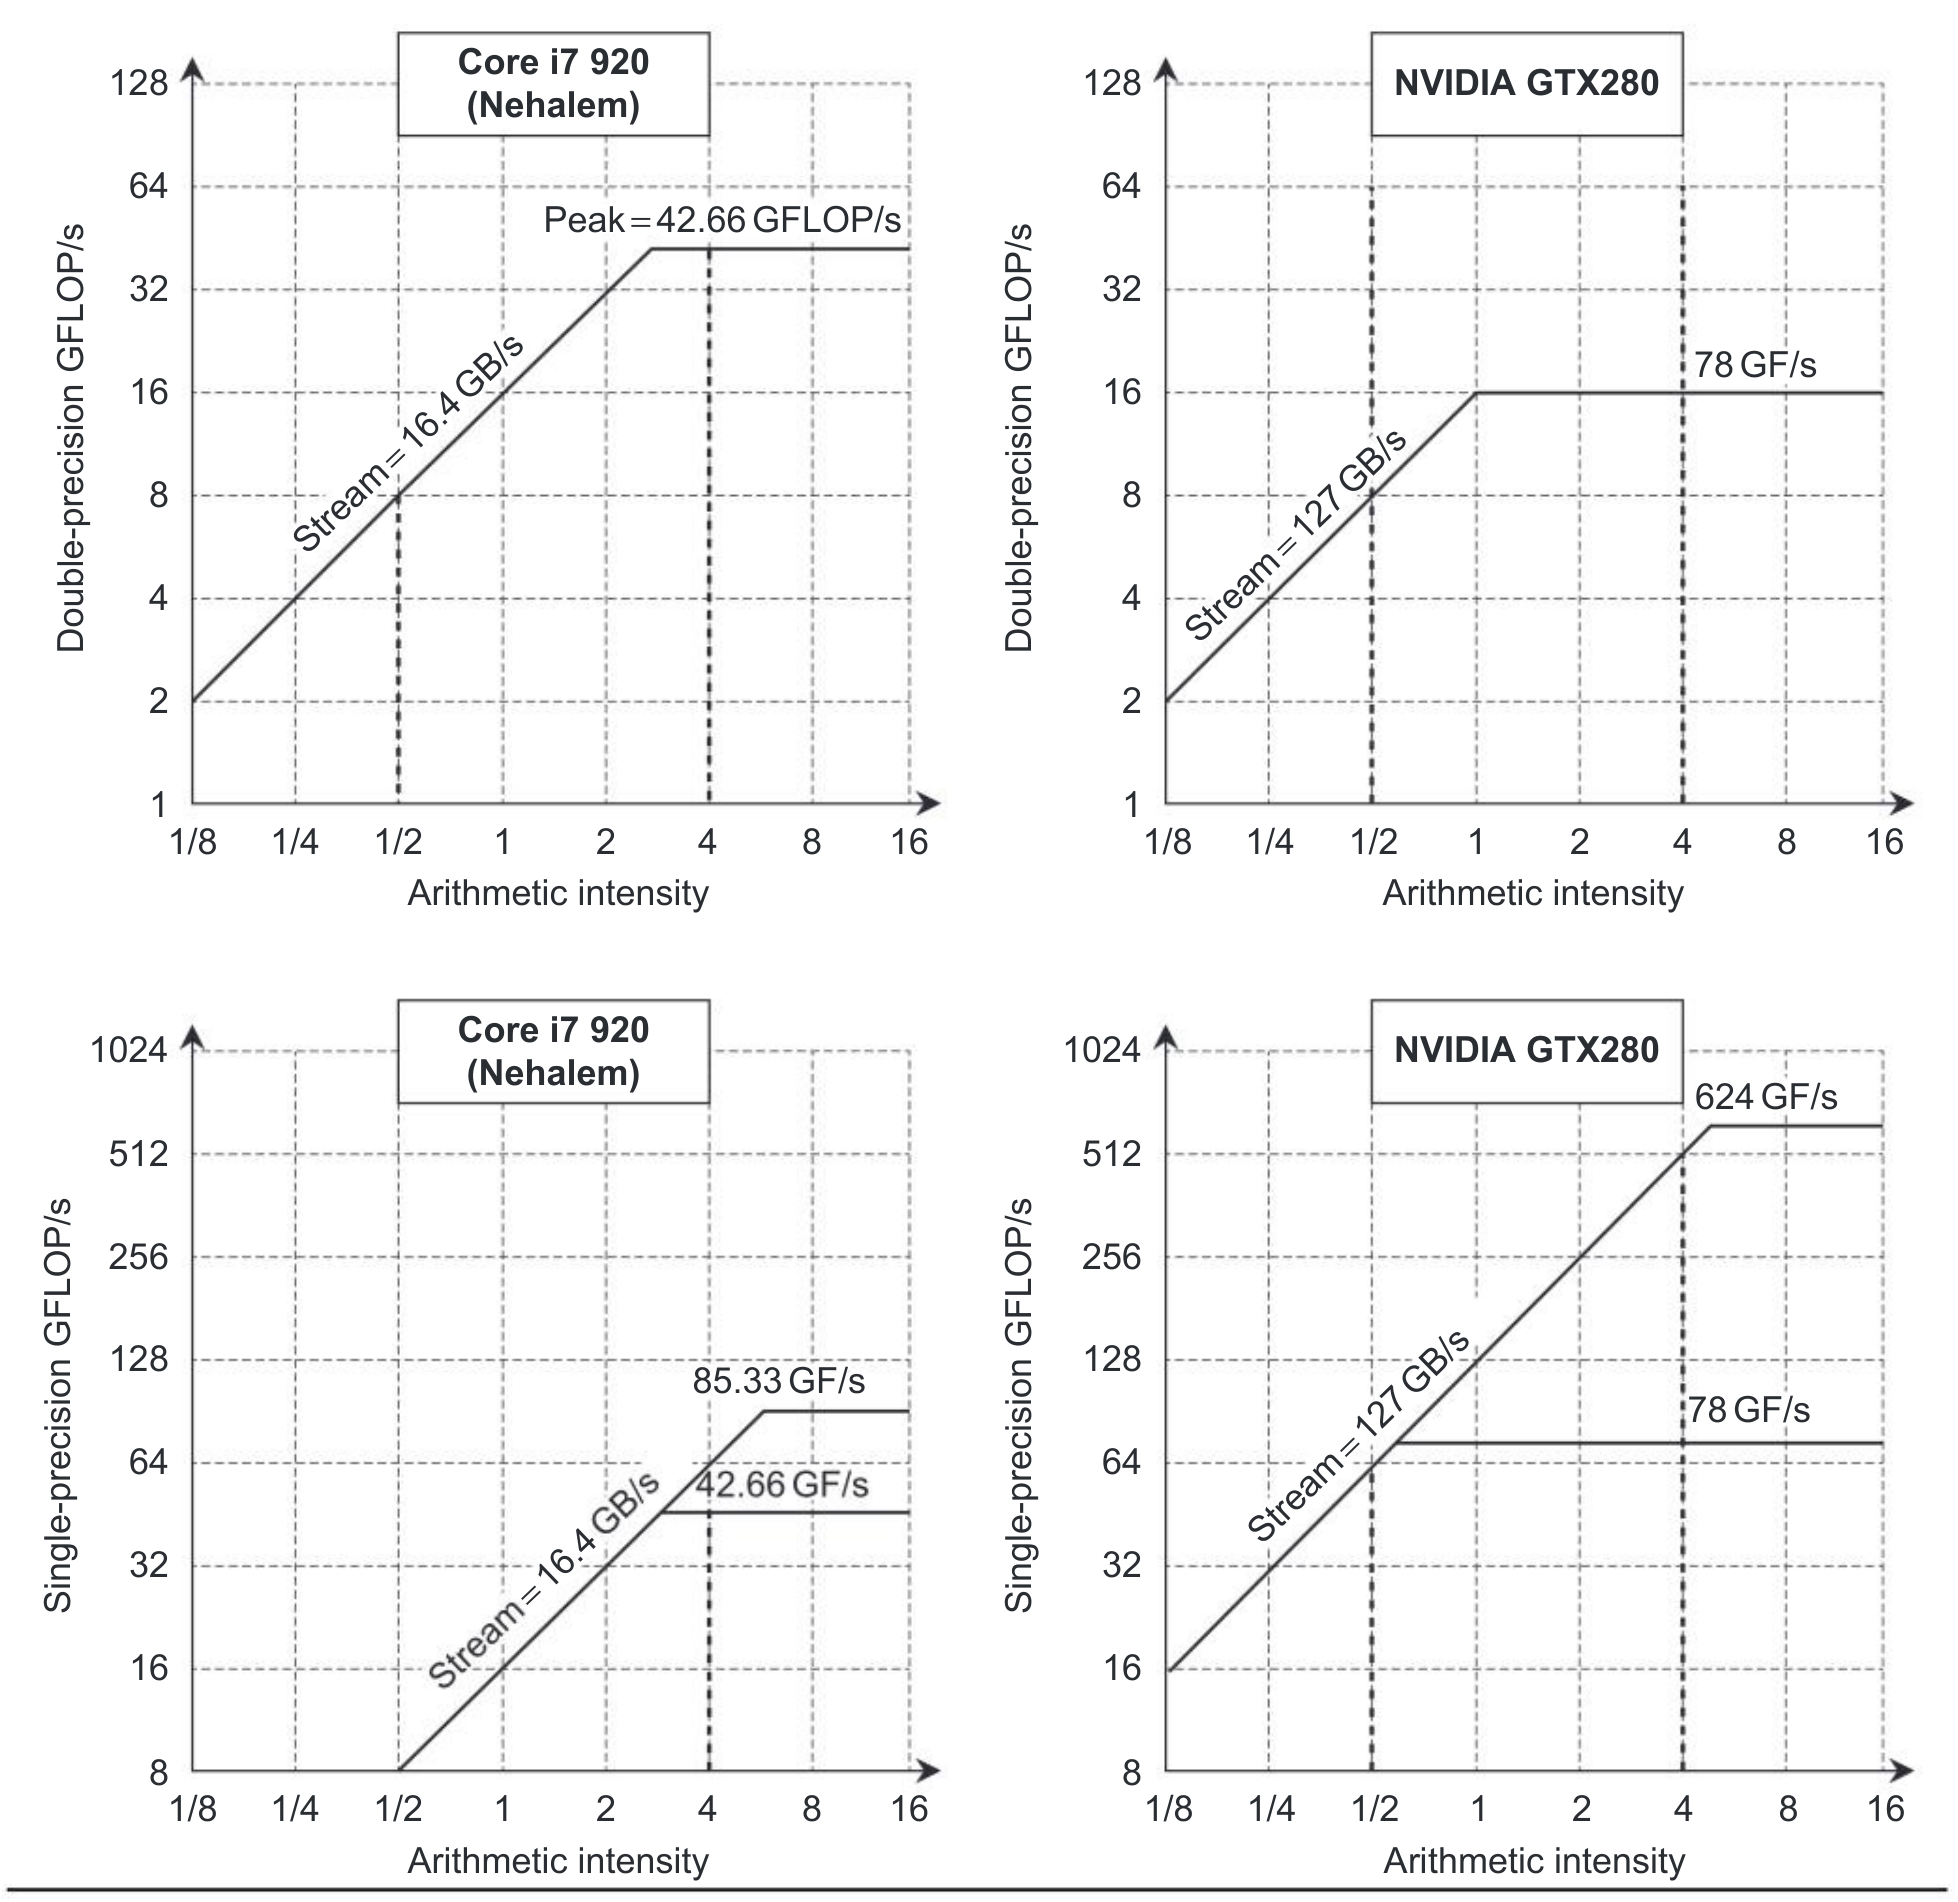
图内标记:Arithmetic intensity=算术强度;Double-precision/Single-precision GFLOP/s=双精度/单精度 GFLOP/s;Peak=峰值;Stream=STREAM 所测存储器带宽。
译注: 原图及图注有三处不一致。右上图的水平线标为 78 GFLOP/s,却画在纵轴约 16 的位置。图注末尾的“双精度 512 GFLOP/s”应与单精度曲线对应,因为同一图已给出双精度峰值 78 GFLOP/s。算术强度为 4 时,单精度性能仍受带宽限制:按图中数据,Core i7 为 GFLOP/s,GTX 280 为 GFLOP/s;因此,“仅受计算能力限制”不能同时适用于图注所列的全部情况。
GTX 280 不仅具有高得多的存储器带宽和双精度浮点性能,其双精度曲线的转折点也明显更靠左。前面提到,Roofline 曲线的转折点越靠左,就越容易达到计算性能峰值。GTX 280 的双精度转折点为 0.6,Core i7 为 2.6。单精度情况下,转折点向右移动了很多;由于单精度性能上限高得多,要达到这一上限也困难得多。注意,内核的算术强度根据访问主存的字节数计算,而不是访问缓存的字节数。因此,如果大部分访问确实命中缓存,缓存就可能改变一个内核在某台计算机上的算术强度。Roofline 曲线有助于解释本案例中的相对性能。还要注意,两种体系结构给出的带宽都针对单位步长访问;后面会看到,对于不能合并的实际聚集/散布地址,GTX 280 和 Core i7 都会更慢。
研究人员表示,他们先分析了当时新提出的四套基准测试的计算与存储访问特征,再“制定出能够体现这些特征的一组吞吐计算内核”。图 4.32 描述了这 14 个内核,图 4.33 给出了性能结果,数值越大表示速度越快。
GTX 280 的原始规格与 Core i7 相比,从慢 2.5 倍(时钟频率)到快 7.5 倍(每芯片核心数)不等;实际性能则从慢 2.0 倍(Solv)到快 15.2 倍(GJK)不等。Intel 研究人员分析了这些差异的原因:
- 存储器带宽。 GPU 的存储器带宽是 Core i7 的 4.4 倍,这有助于解释 LBM 和 SAXPY 分别快 5.0 倍与 5.3 倍的原因:两者的工作集都达数百 MB,无法装入 Core i7 的缓存。(为了密集地访问存储器,SAXPY 没有采用缓存分块。)因此,Roofline 曲线的斜率解释了它们的性能。SpMV 的工作集也很大,但只快 1.9 倍,因为 GTX 280 的双精度浮点性能仅为 Core i7 的 1.5 倍。
- 计算吞吐能力。 其余内核中有五个受计算能力限制:SGEMM、Conv、FFT、MC 和 Bilat。GTX 分别快 3.9、2.8、3.0、1.8 和 5.7 倍。前三个使用单精度浮点运算,而 GTX 280 的单精度性能快 3–6 倍。(图 4.30 所示比 Core i7 快 9 倍的情况,仅发生在 GTX 280 每个周期都能发射一次融合乘加和一次乘法这一极特殊的条件下。)MC 使用双精度运算,所以只快 1.8 倍,因为双精度性能仅快 1.5 倍。Bilat 使用超越函数,GTX 280 直接提供硬件支持(见图 4.18)。Core i7 有三分之二的时间花在计算超越函数上,因此 GTX 280 快 5.7 倍。
最后这一观察说明了对工作负载中常见运算提供硬件支持的价值:包括双精度浮点运算,甚至可能包括超越函数。
- 缓存的收益。 光线投射(RC)在 GTX 上只快 1.6 倍,因为 Core i7 的缓存与缓存分块使它避免像 GPU 上那样受存储器带宽限制。缓存分块也有助于 Search。如果索引树足够小,能装入缓存,Core i7 的速度就是其两倍。较大的索引树则会使程序受存储器带宽限制。
| 内核(简称) | 应用领域 | SIMD 并行性的特点 | 线程级并行性的划分 | 性能特点 |
|---|---|---|---|---|
| SGEMM(SGEMM) | 线性代数 | 规则 | 跨二维分块 | 分块后受计算能力限制 |
| Monte Carlo(MC) | 计算金融 | 规则 | 跨路径 | 受计算能力限制 |
| 卷积(Convolution,Conv) | 图像分析 | 规则 | 跨像素 | 受计算能力限制;小滤波器时受带宽限制 |
| FFT(FFT) | 信号处理 | 规则 | 跨较小的 FFT | 依规模而定,受计算能力或带宽限制 |
| SAXPY(SAXPY) | 点积 | 规则 | 跨向量 | 大向量时受带宽限制 |
| LBM(LBM) | Time migration | 规则 | 跨单元 | 受带宽限制 |
| 约束求解器(Constraint solver,Solv) | 刚体物理 | 聚集/散布 | 跨约束 | 受同步限制 |
| SpMV(SpMV) | 稀疏求解器 | 聚集 | 跨非零元素 | 典型的大矩阵受带宽限制 |
| GJK(GJK) | 碰撞检测 | 聚集/散布 | 跨对象 | 受计算能力限制 |
| 排序(Sort) | 数据库 | 聚集/散布 | 跨元素 | 受计算能力限制 |
| 光线投射(Ray casting,RC) | 体绘制 | 聚集 | 跨射线 | 第一级工作集为 4–8 MB;最后一级超过 500 MB |
| 搜索(Search) | 数据库 | 聚集/散布 | 跨查询 | 小树时受计算能力限制;大树底部受带宽限制 |
| 直方图(Histogram,Hist) | 图像分析 | 需要冲突检测 | 跨像素 | 受归约/同步限制 |
| Bilateral(Bilat) | 图像分析 | 规则 | 跨像素 | 受计算能力限制 |
译注: 原表把 SAXPY 的应用写为“Dot product(点积)”,这里按原表保留。SAXPY 本身计算的是标量乘向量再加另一向量,并非点积。LBM 的应用栏“Time migration”也按原表保留,不根据缩写另行推定其应用。
总的来说,GTX 280 上的 Search 快 1.8 倍。缓存分块也有助于 Sort。虽然大多数程序员不会在 SIMD 处理器上运行 Sort,但可以用名为 split 的 1 位排序原语来实现它。不过,split 算法执行的指令远多于标量排序。因此,GTX 280 的速度仅为 Core i7 的 0.8 倍。缓存也有助于 Core i7 上的其他内核,因为缓存分块能让 SGEMM、FFT 和 SpMV 转为受计算能力限制。这再次说明了第 2 章所述缓存分块优化的重要性。
- 聚集/散布。 如果数据分散在主存各处,多媒体 SIMD 扩展几乎帮不上忙;只有数据按 16 字节边界对齐时,才能获得最佳性能。因此,GJK 在 Core i7 上从 SIMD 获得的收益很小。如前所述,GPU 提供了向量体系结构具有、但 SIMD 扩展缺失的聚集/散布寻址。地址合并单元也发挥了作用:它把对同一 DRAM 行的访问合并起来,减少聚集和散布的次数。存储器控制器还会把访问同一 DRAM 页的请求放到一批中。这些机制相结合,使 GTX 280 上的 GJK 比 Core i7 快了惊人的 15.2 倍,超过图 4.30 中任何单一物理参数的比值。这进一步说明了聚集/散布对向量和 GPU 体系结构的重要性,而 SIMD 扩展恰恰缺少它。
| 内核 | 单位 | Core i7-960 | GTX 280 | GTX 280 / Core i7 |
|---|---|---|---|---|
| SGEMM | GFLOP/s | 94 | 364 | 3.9 |
| MC | 十亿路径/s | 0.8 | 1.4 | 1.8 |
| Conv | 百万像素/s | 1250 | 3500 | 2.8 |
| FFT | GFLOP/s | 71.4 | 213 | 3.0 |
| SAXPY | GB/s | 16.8 | 88.8 | 5.3 |
| LBM | 百万次查找/s | 85 | 426 | 5.0 |
| Solv | 帧/s | 103 | 52 | 0.5 |
| SpMV | GFLOP/s | 4.9 | 9.1 | 1.9 |
| GJK | 帧/s | 67 | 1020 | 15.2 |
| Sort | 百万元素/s | 250 | 198 | 0.8 |
| RC | 帧/s | 5 | 8.1 | 1.6 |
| Search | 百万次查询/s | 50 | 90 | 1.8 |
| Hist | 百万像素/s | 1517 | 2583 | 1.7 |
| Bilat | 百万像素/s | 83 | 475 | 5.7 |
- 同步。 Hist 的同步性能受原子更新限制。即使 Core i7 提供硬件取值并递增指令,原子更新仍占其总运行时间的 28%。因此,原文称“Hist 只比 GTX 280 快 1.7 倍”。Solv 对一批互相独立的约束进行少量计算,然后执行屏障同步。Core i7 受益于原子指令,以及一个即使此前对存储层次结构的访问尚未全部完成、也能保证结果正确的存储一致性模型。GTX 280 缺少这样的存储一致性模型,其版本需要由系统处理器启动某些批次,结果 GTX 280 的速度只有 Core i7 的一半。这说明,对某些数据并行问题,同步性能可能十分重要。
译注: “Hist 只比 GTX 280 快 1.7 倍”是原文的比较方向。根据上一页图 4.33,Hist 在 GTX 280 上为 2583 百万像素/s,在 Core i7 上为 1517 百万像素/s,实际是 GTX 280 约快 1.7 倍。
值得玩味的是,向量体系结构比 SIMD 指令早了几十年,其聚集/散布支持却对这些 SIMD 扩展的实际效果如此重要;在这项比较之前就有人作出了这一判断(Gebis 与 Patterson,2007)。Intel 研究人员指出,如果 Core i7 能提供更高效的聚集/散布支持,14 个内核中有 6 个就能更好地利用 SIMD。
这项比较还缺少一项重要信息:在两个系统上获得这些结果,各自需要付出多少努力。理想情况下,今后的比较应公开两边使用的代码,让其他人能在不同硬件平台上复现实验,并可能进一步改进结果。
比较的更新
此后的几年中,Core i7 与 Tesla GTX 280 的后继产品针对其弱点作出了改进。Intel 的 ACV2 增加了聚集指令,AVX/512 增加了散布指令,两者都出现在 Intel Skylake 系列中。NVIDIA Pascal 的双精度浮点性能达到单精度的一半,而非八分之一,还提供了快速原子操作和缓存。
译注: 原文写作“ACV2”和“AVX/512”。结合本章 4.3 节的扩展名称,分别应为 AVX2 和 AVX-512。
图 4.34 列出了这两款后继产品的特征。图 4.35 使用原论文 14 个基准中的 3 个比较性能——我们只找到了这 3 个的源代码。图 4.36 给出了两个新的 Roofline 模型。新 GPU 芯片比其前代快 15–50 倍,新 CPU 芯片比其前代快 50 倍,而新 GPU 比新 CPU 快 2–5 倍。
从历史来看,GPU 上 SGEMM 相对 CPU 的 3.9 倍加速,以及 CUDA 的可用性,对 Intel 和 NVIDIA 后来的发展都至关重要。SGEMM 是 Single precision GEneral Matrix Multiply(单精度通用矩阵乘法)的缩写,而矩阵乘法正是深度神经网络的核心计算。Alex Krizhevsky 是多伦多大学的博士生,曾选修一门使用 GPU 进行计算的研究生课程。2012 年,他在 GPU 上训练了名为 AlexNet 的神经网络,并将其提交给计算机视觉领域的 ImageNet 竞赛。AlexNet 不仅获得第一名,还大幅降低了视觉识别错误率。2012 年,AlexNet 是唯一参赛的 DNN;仅仅两年之后,全部参赛方案都依赖 DNN。这个结果推动 GPU 成为 DNN 的首选计算引擎,DNN 的重要性此后也迅速上升。
2012 年,Intel 的市值是 NVIDIA 的 10 多倍。在我们于 2024 年修订本章时,DNN 的日益普及使双方地位反转:NVIDIA 的市值已超过 Intel 的 30 倍。注意,2012 年 NVIDIA 并没有一个以 DNN 为目标的宏大计划。它通过 CUDA 尽可能向更多程序员开放 GPU 的潜力,让任何人都能围绕任何课题探索,使一个杀手级应用自行出现,由此获得了成功。
| 特征 | Intel Xeon Platinum 8180 | NVIDIA P100 | P100 / Xeon |
|---|---|---|---|
| 处理单元数(核或 SM) | 28 | 56 | 2.0 |
| 时钟频率(GHz) | 2.5 | 1.3 | 0.52 |
| 裸片面积 | N.A. | 610 mm² | — |
| 制造工艺 | Intel 14 nm | TSMC 16 nm | 1.1 |
| 芯片功率(不是模块功率) | 80 W | 300 W | 3.8 |
| 晶体管数 | N.A. | 153 亿 | — |
| 存储器带宽(GB/s) | 199 | 732 | 3.7 |
| 单精度 SIMD 宽度 | 16 | 8 | 0.5 |
| 双精度 SIMD 宽度 | 8 | 4 | 0.5 |
| 单精度 SIMD 峰值(GFLOP/s) | 4480 | 10,608 | 2.4 |
| 双精度 SIMD 峰值(GFLOP/s) | 2240 | 5304 | 2.4 |
译注: 图 4.34 再次把带宽比较指向不含带宽数据的图 4.28,属于与图 4.30 同样的交叉引用疑误。
| 内核 | 单位 | Xeon 8180 | P100 | P100 / Xeon | 原平台 GTX 280 / Core i7-960 |
|---|---|---|---|---|---|
| SGEMM | GFLOP/s | 3494 | 6827 | 2.0 | 3.9 |
| DGEMM | GFLOP/s | 1693 | 3490 | 2.1 | — |
| FFT-S | GFLOP/s | 410 | 1820 | 4.4 | 3.0 |
| FFT-D | GFLOP/s | 190 | 811 | 4.2 | — |
| SAXPY | GB/s | 207 | 544 | 2.6 | 5.3 |
| DAXPY | GB/s | 212 | 556 | 2.6 | — |
译注: 图 4.35 图注所指的“图 4.30”是硬件参数表;此前以 SAXPY 测量带宽的基准结果实际位于图 4.33。
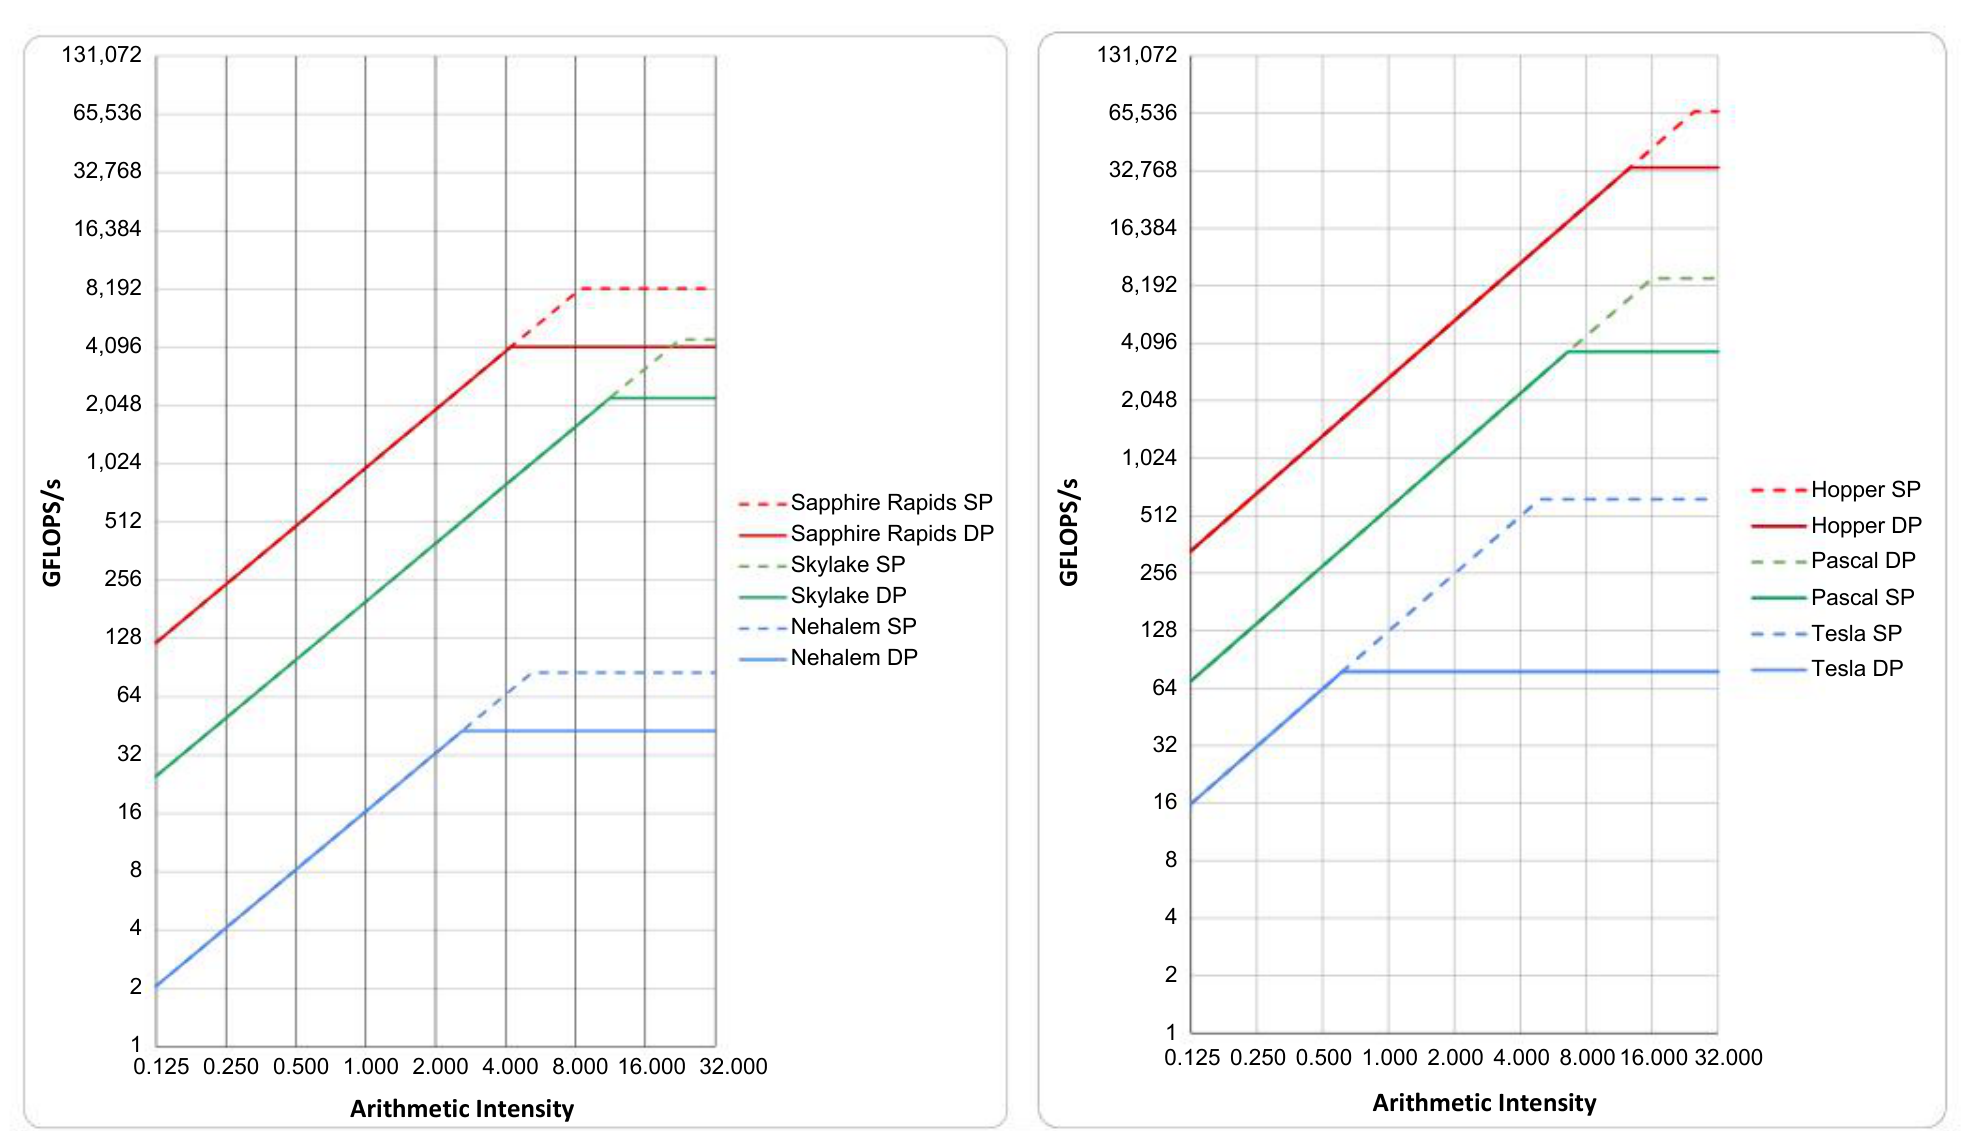
图内标记:Arithmetic Intensity=算术强度;SP=单精度;DP=双精度;纵轴 GFLOPS/s 按原图保留;Sapphire Rapids、Skylake、Nehalem、Hopper、Pascal、Tesla 均为产品或微体系结构名称。
译注: 原图右侧图例把 Pascal 较高的曲线标为 DP、较低的曲线标为 SP,与本图图注和前文 P100 的单、双精度峰值关系相反。
本节图 4.30、4.32、4.33 的完整出处:Lee, W.V., et al., 2010. Debunking the 100× GPU vs. CPU myth: an evaluation of throughput computing on CPU and GPU. In: Proc. 37th Annual Int’l. Symposium on Computer Architecture (ISCA), June 19–23, 2010, Saint-Malo, France.