5.1 引言
正如本章开篇的引语所示,多年来,一些研究者始终认为单处理器体系结构的发展已接近尽头。显然,其中某些判断为时过早。事实上,在 1986–2003 年间,受微处理器推动,单处理器性能的增长速度达到了自 20 世纪 50 年代末、60 年代初第一批晶体管计算机问世以来的最高水平。
尽管如此,多处理器在整个 20 世纪 90 年代仍日益重要。设计者希望构建性能超越单个微处理器的服务器和超级计算机,同时利用通用商品微处理器在性价比上的巨大优势。如第 1 章和第 3 章所述,开发指令级并行性(ILP)的收益递减,使单处理器性能增长放缓;与此同时,功耗问题日益受到关注。这两方面共同开启了计算机体系结构的新时代:从低端到高端,多处理器都发挥着重要作用。第二段引语正好捕捉到了这一明确的转折点。
多处理日益重要,反映了以下几个主要因素:
- 2000–2005 年间,设计者试图发现并开发更多 ILP,却遇到了硅面积和能量利用效率显著下降的问题。这种做法效率不高,因为功耗与硅面积成本的增长超过了性能增长。除了 ILP,我们所知的、能够让性能提升超过基本技术在开关速度方面所允许提升幅度的可扩展通用方法,只有多处理,包括 SIMD 和 MIMD 两类方法。
- 随着云计算和软件即服务日益重要,人们对高端服务器的兴趣不断增加。
- 互联网上海量数据的可获得性,推动了数据密集型应用的增长。
- 人们认识到,提高桌面性能已不那么重要;图形和 AI 加速器除外,它们使用其他形式的并行性。这或许是因为现有性能已能满足需求,也可能是因为计算和数据高度密集的应用正在云端执行。
- 人们更加了解如何有效使用多处理器,尤其是在具有大量固有并行性的服务器环境中。这些并行性可能来自大型数据集,通常表现为数据并行;来自科学与工程代码中的“自然世界”并行;或者来自大量独立请求之间的并行,即请求级并行性。
- 通过复制现有设计而不是进行全新设计,可以更充分地利用设计投入;所有多处理器设计都能获得这种好处。
- 设计包含不同类型核心的多核处理器,即 big/little,使系统可以使用高性能且功耗较高的核心,也可以使用效率更高的低功耗核心,并能纳入领域专用加速器。
- 将互连和共享内存的缓存一致性支持集成到各个芯片中,从而支持构建由多个多核处理器组成的系统。
第三段引语提醒我们,多核在扩展性能方面能提供的空间可能有限。Amdahl 定律的影响与 Dennard 缩放规律失效相结合,意味着多核的前景可能受到限制,至少在提高单个应用性能这一用途上如此。异构处理器和领域专用处理器或许提供了其他出路。本章后面将再次讨论这一主题。
本章重点研究**线程级并行性(thread-level parallelism,TLP)**的开发。TLP 意味着存在多个程序计数器,因此主要通过 MIMD(Multiple Instruction, Multiple Data,多指令流多数据流)处理器来利用。虽然 MIMD 已存在数十年,但 TLP 在从嵌入式应用到高端服务器的整个计算领域占据核心地位,主要还是过去 30 年的产物。同样,将 TLP 广泛用于各类通用应用,而不仅是事务处理或科学应用,也是较近才发生的事情。
本章关注多处理器(multiprocessor)。我们将其定义为由紧密耦合的处理器组成的计算机:处理器的协调和使用通常由一个操作系统控制,操作系统也可能有副本;处理器通过共享地址空间共享内存。这类系统通过两种不同的软件模型开发 TLP。第一种是执行一组紧密耦合、协作完成同一任务的线程,通常称为并行处理(parallel processing)。第二种是执行多个相对独立的进程,这些进程可能来自一个或多个用户;这属于请求级并行性,但规模远小于下一章讨论的情形。请求级并行性可以由一个运行于多个处理器上的应用来开发,例如响应查询的数据库,也可以由多个彼此独立运行的应用来开发,后者通常称为多道程序设计(multiprogramming)。
本章考察的多处理器,通常从单插槽 8 核处理器到包含数十个、有时数百个核心的系统不等,核心之间主要通过共享内存通信与协调。虽然通过内存共享意味着拥有共享地址空间,但不一定意味着只有一个物理存储器。这类多处理器既包括在单个芯片中包含多个核心的系统,即多核处理器(multicore),也包括由多个芯片构成的计算机,其中每个芯片通常又是一个多核处理器。
除了真正的多处理器,我们还将回到多线程这一主题。多线程是一种让多个线程在单个多发射处理器上交错执行的技术。许多多核处理器也提供多线程支持。
下一章将讨论数据中心。数据中心通常由数量极大的处理器构成,少则数千,多则数十万,通过网络技术连接;所用网络技术不一定与连接互联网的技术相同。这些大型系统服务于云计算,主要并行执行海量独立任务。本章讨论的多核与多处理器,是这些更大规模系统的构件。此外,搜索和某些机器学习算法等容易并行化的计算密集型任务,也会使用集群。当集群增长到数万台服务器乃至更大规模时,又称为仓库级计算机。Alibaba、Amazon、Google、Microsoft 和 Facebook 都构建并使用仓库级计算机。这类系统有时也称为多计算机(multicomputer),尤其是在科学计算领域。
许多其他著作,例如 Culler et al.(1999),对这些系统有详细介绍。多处理领域范围广阔且持续变化——刚提到的 Culler 等人的书超过 1000 页,而且只讨论多处理!因此,我们选择将注意力集中在计算领域中我们认为最重要、最具通用性的部分。附录 I 讨论构建更大规模计算机时出现的一些问题,以及它们在计算密集型科学应用中的使用。
我们将重点考察约含 8–1024 个处理器核心的多处理器。这些核心可能分布在 1–64 个独立芯片上,也可能封装在一个插槽中的模块里,每个模块包含多个 CPU 以及内存。无论按出货量还是销售金额衡量,这类设计都占据绝对主导地位。在大规模多处理器中,互连网络是设计的关键组成部分;附录 F 专门讨论这一主题。
多处理器体系结构:问题与方法
为了利用一个包含 个处理器的 MIMD 多处理器,通常必须至少有 个可执行线程或进程。如今大多数高端多核芯片都有多线程能力,此时所需数量还要高 2–8 倍。单个进程中的独立线程通常由程序员识别,或者由操作系统根据多个独立请求创建。另一种极端情况是,线程可能只包含循环的几十次迭代,由并行编译器利用循环中的数据并行性生成。分配给一个线程的计算量称为粒度(grain size),它对如何高效开发 TLP 十分重要。不过,TLP 与 ILP 的关键定性区别在于:TLP 由软件系统或程序员在较高层次识别,线程则由数千至数十亿条可并行执行的指令构成。
线程也能用于开发数据级并行性,但其开销通常高于 SIMD 处理器,例如向量单元或 GPU,见第 4 章。这些开销意味着,粒度必须足够大,才能高效利用并行性。例如,向量处理器或 GPU 也许能高效地并行执行短向量上的运算,但如果把这份并行工作分散给许多线程,粒度可能太小,以致 MIMD 中的开销高得无法接受。
传统上,共享内存多处理器分为两类,区别在于处理器数量,而数量又决定了存储器组成和互连策略。我们按照存储器组成来称呼这些多处理器,因为多少处理器算少、多少算多,会随时间不断变化。
早期多处理器通常使用单一共享存储器,并通过总线连接处理器与存储器。这类系统称为 UMA(Uniform Memory Access,均匀内存访问)多处理器,因为所有处理器访问内存所需时间相同。一些早期多核处理器也采用 UMA。公共总线简化了设计,但随着核心数与各核心性能同时增长,总线也成为瓶颈。因此,大多数多核处理器转向图 5.1 所示的结构,使用共享的末级缓存(Last Level Cache,LLC),通常将其分散布置。互连网络让核心能够访问内存接口,也允许 LLC 之间通信;后文将看到,为维持一致的内存视图,必须进行这种通信。一些设计让一小组处理器共享一个 LLC 分片。
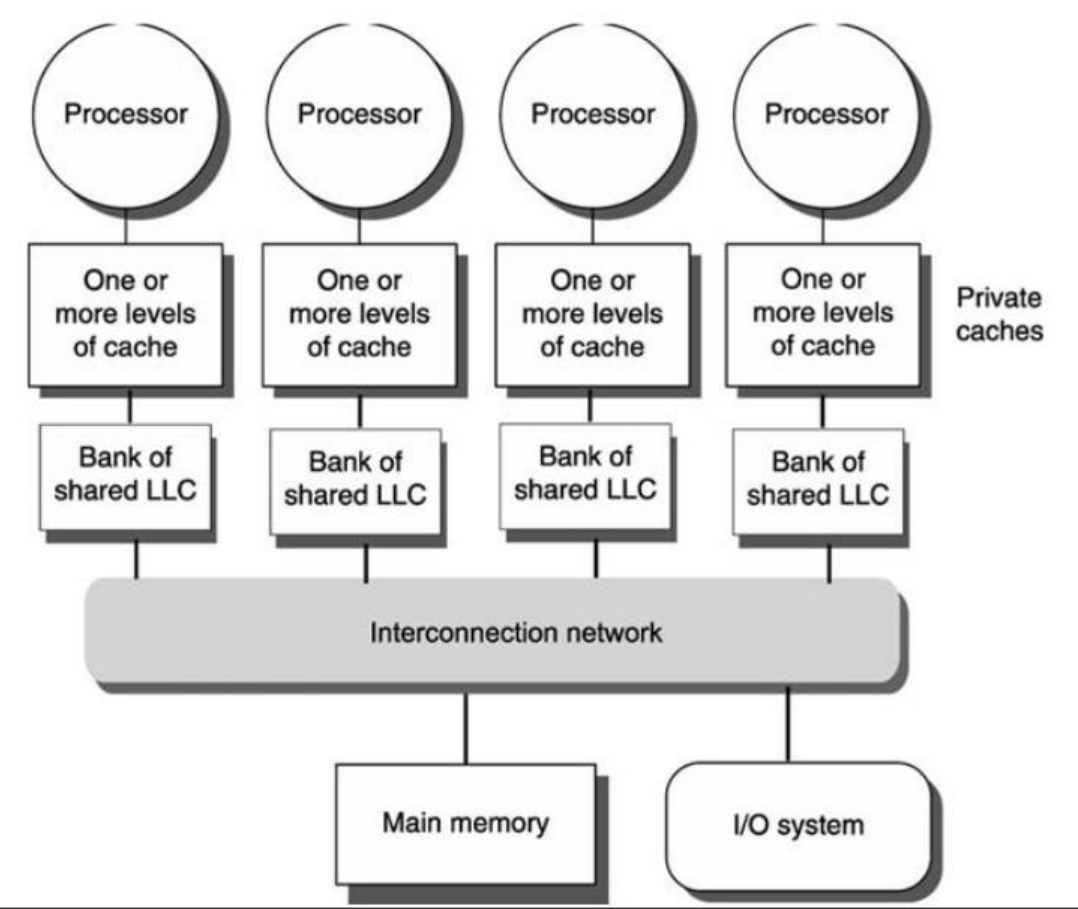
图 5.1(续)。 在多数现代多核处理器中,L3 分成多个存储体,每个存储体与一个或两个多核处理器相关联,原文用词为 multicores。早期多处理器中的总线被互连网络取代。对于较大的多核系统,这通常是多级间接网络,到达某些多核处理器需要经过多跳。内存通常也通过同一互连网络访问,I/O 设备同样如此。注意,即使设计采用 UMA,也可能采用 NUCA(NonUniform Cache Access,非均匀缓存访问),因为到达 LLC 不同共享存储体的时间并不相同。
图内术语:Processor=处理器;One or more levels of cache=一级或多级缓存;Private caches=私有缓存;Bank of shared LLC=共享 LLC 的存储体;Interconnection network=互连网络;Main memory=主存;I/O system=I/O 系统。
由多个多核处理器组成的系统,可以同时使用多个存储器,并通过互连网络连接各多核处理器,如图 5.2 所示。这种体系结构称为分布式共享内存(distributed shared memory,DSM),表现出**非均匀内存访问(Nonuniform Memory Access,NUMA)**特征:访问延迟取决于发起访问的核心与保存数据的物理存储器之间的关系。虽然内存在物理上是分布式的,但处理器共享一个地址空间,可以访问全部内存,这正是“分布式共享内存”这一名称的含义。需要通信的进程和线程,请求操作系统将各自虚拟地址空间的一部分映射到物理地址空间中的某个共享区域。随后由存储系统确保各处理器能够正确访问和共享内存;本章将深入研究这一主题。
相比之下,下一章介绍的集群与仓库级计算机,更像是由网络连接起来的独立计算机;每台计算机可能又由基于多核的多处理器组成。如果没有运行在两台计算机上的软件协议协助,一台计算机无法访问另一台计算机的内存。这类设计通过消息传递协议在计算机之间通信数据。
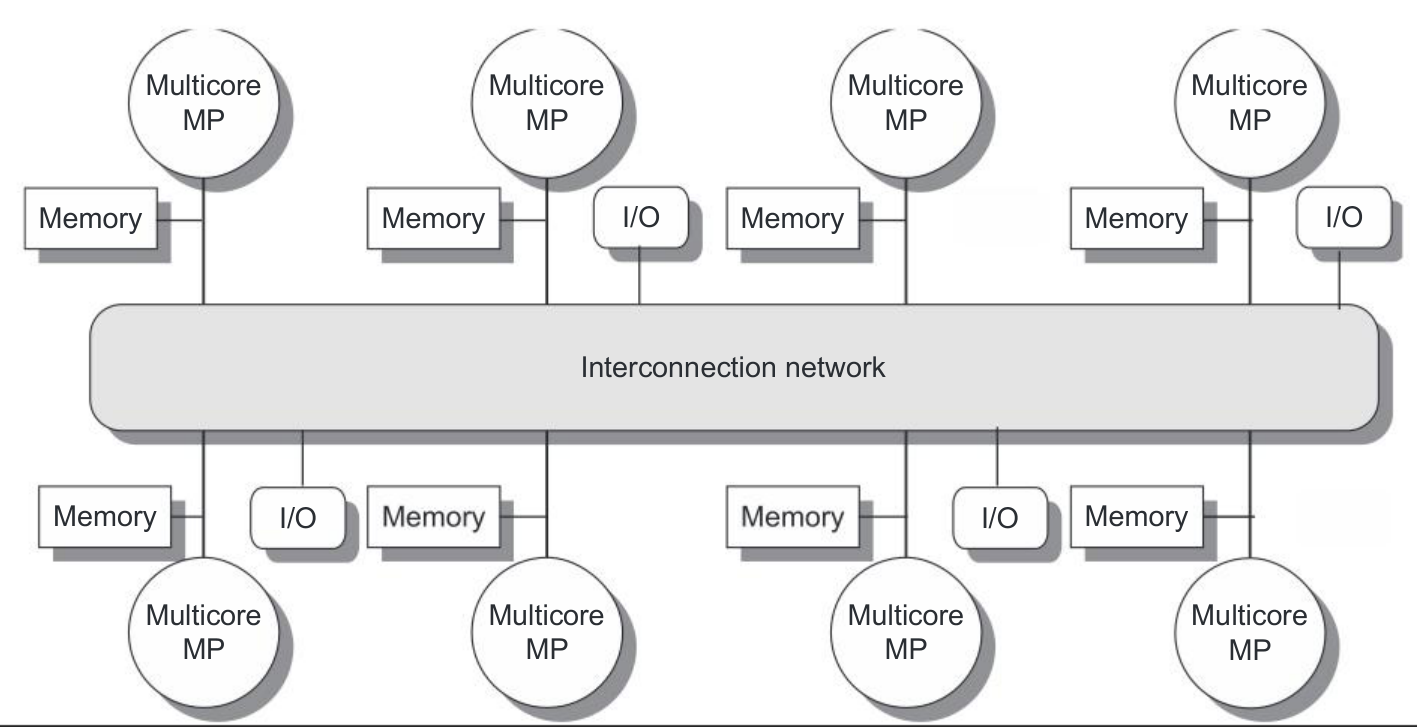
图 5.2(续)。 每个处理器核心共享全部内存,但访问连接在本核心所在芯片上的本地内存,要比访问远程内存快得多。这些设计中有许多也采用 NUCA。
图内术语:Multicore MP=多核多处理器;Memory=内存;Interconnection network=互连网络;I/O=输入/输出。
并行处理的挑战
多处理器的应用范围很广,既可以运行几乎不通信的独立任务,也可以运行必须由线程相互通信才能完成任务的并行程序。对于彼此依赖、相互作用的线程,并行处理有两大障碍,都可以用 Amdahl 定律解释。要克服这些障碍,通常需要综合考虑算法的选择和实现、底层编程语言与系统、操作系统及其支持功能,以及体系结构与硬件实现。很多情况下,其中某一项是关键瓶颈;但当处理器数量扩展到较大规模,例如 32 个或更多时,往往需要关注软硬件的所有方面。
第一道障碍是程序中可用并行性有限;第二道障碍来自相对较高的通信成本。可用并行性的限制,使任何并行处理器都难以获得良好的加速比,下面第一个例题说明了这一点。
例题:串行部分允许占多大比例
假设希望用 100 个处理器获得 80 的加速比。原计算中允许有多大比例是串行的?
解答。 回顾第 1 章,Amdahl 定律为:
为简化本例,假定程序只有两种运行模式:一种是充分使用全部处理器的并行模式,即增强模式;另一种是只使用一个处理器的串行模式。这样,增强模式的加速比就是处理器数量,而增强部分的比例就是在并行模式下执行的时间比例。代入上式:
化简得:
因此,要用 100 个处理器取得 80 的加速比,原计算中只有 0.25% 可以是串行的!当然,要取得线性加速,即用 个处理器获得 的加速比,通常要求整个程序都可以并行执行,没有串行部分。实践中,程序并非只在完全并行或串行这两种模式下运行;即使处于并行模式,也往往没有使用全部处理器。Amdahl 定律也可用于分析加速程度不同的应用,如下例所示。
例题:使用不同数量处理器的执行阶段
假设一个应用运行在包含 100 个处理器的多处理器上,可以使用 1、50 或 100 个处理器。假定 95% 的时间可以使用全部 100 个处理器,那么,为了得到 80 的加速比,剩余 5% 的执行时间中,有多少必须使用 50 个处理器?
解答。 使用包含更多项的 Amdahl 定律:
代入,原书写为:
化简:
如果应用中 95% 的部分能完美使用 100 个处理器,要得到 80 的加速比,原书表述为:“剩余时间中的 4.8% 必须使用 50 个处理器,而只有 0.2% 可以串行执行!”1
并行处理的第二项主要挑战,是远程访问的高延迟。在现有共享内存多处理器中,不同核心之间的数据通信可能花费 50–100 个以上时钟周期;不同芯片上核心之间的通信,则可能从 500 个时钟周期到 1000 个甚至更多,大规模多处理器尤为如此。具体时间取决于通信机制、互连网络类型和多处理器规模。长通信延迟的影响显然十分显著。下面看一个简单例子。
例题:远程通信对 CPI 的影响
假设一个应用运行在 32 处理器的多处理器上,处理一次远程内存访问需要 200 ns。对该应用,假定除通信访问以外,所有访问都命中本地存储层次;这显然是乐观假设。处理器会在远程请求上停顿,时钟频率为 4 GHz。如果基本 CPI 为 0.5,即假定所有访问都命中缓存,那么,与 0.2% 的指令涉及远程通信访问相比,完全没有通信的多处理器会快多少?
解答。 先计算每条指令的时钟周期数更简单。当 0.2% 的访问为远程访问时,有效 CPI 为:
远程请求开销为:
因此,原书计算 CPI 为:
原书据此得出:全部访问都在本地完成的多处理器快 倍!2 实际上,性能分析复杂得多,因为一部分不涉及通信的访问也会在本地层次中未命中,而且远程访问时间并不是单一常数。例如,大量访问争用全局互连,会使延迟增加,远程访问的开销因而更高;另一方面,如果内存采用分布式组织,而访问恰好指向本地内存,时间也可能更短。
这个问题也可以用 Amdahl 定律分析,留给读者作为练习。
并行性不足和远程通信延迟过长,是使用多处理器时最大的两项性能挑战。应用并行性不足,主要必须依靠软件解决:开发并行性能更好的新算法,并由软件系统尽量增加充分利用全部处理器的执行时间。远程高延迟的影响,则可以由体系结构和程序员共同缓解。例如,可以通过缓存共享数据等硬件机制,或者重新组织数据、让更多访问在本地完成等软件机制,降低远程访问频率。也可以用第 3 章讨论的多线程,或第 2 章详细讨论的预取,来容忍延迟。
本章的大部分内容关注如何减轻远程通信高延迟的影响。例如,5.2–5.4 节讨论如何利用缓存降低远程访问频率,同时维持一致的内存视图。5.5 节讨论同步:同步本质上涉及处理器间通信,并可能限制并行性,因此是一个重要的潜在瓶颈。5.6 节介绍延迟隐藏技术与共享内存的存储一致性模型。附录 I 则主要研究规模更大的多处理器,以及它们在科学计算中的应用。