5.4 通过目录维护缓存一致性
如 5.3 节所示,监听协议在每次缓存未命中时,都必须与所有缓存通信,包括对可能共享的数据进行写入。没有集中式数据结构来跟踪缓存状态,是监听方案成本低的根本优势,却也是它在可扩展性方面的致命弱点。
可以通过分布内存来增加内存带宽和互连带宽,如图 5.2 所示。 这样便立即将本地内存流量与远程内存流量分开,降低存储系统与互连网络的带宽需求。但是,如果仍要求一致性协议在每次缓存未命中时广播,那么分布内存的收益也很有限。
如前所述,监听一致性协议的另一种选择是目录协议(directory protocol)。目录保存每个可能被缓存的块的状态,包括哪些缓存或缓存集合可能持有副本,以及该块是否已修改。
对于具有包含性共享 LLC 的单个多核处理器,很容易在 LLC 实现目录:只需为每个 LLC 块保存一个长度等于核心数的位向量。由于所有 L2 块必然都在 LLC 中,该向量便可指明哪些私有 L2 可能持有该块,只向这些缓存发送失效请求即可。对于 LLC 具有包含性的单个多核处理器,这一方案工作得很好,Intel i7 就采用了它。假如 LLC 不具有包含性,仍可以在 LLC 保存目录信息:或者维护独立目录结构,如 Intel Xeon;或者复制 L2 标签,如 AMD EPYC。单一目录也简化了事件排序,而这是实现各种存储一致性模型所必需的,见 5.6 节。 有了单一目录,只需暂缓后续请求,直到确认当前请求完成,例如失效请求,或获取远程缓存数据的请求。随着核心数增加,这种阻塞办法效率低下;有多个目录时则无法工作。
因此,目录也必须像内存一样分布,而不能只有一个。但是,分布方式必须让一致性协议知道,任意已缓存内存块的目录信息位于哪里。显而易见的办法是让目录随内存一起分布:不同一致性请求可以到达不同目录,正如不同内存请求可以到达不同存储器。
分布式目录保留了这样一个特征:某块的共享状态始终位于一个确定、已知的位置。结合目录中保存的“其他哪些节点可能缓存该块”的信息,一致性协议便可以避免广播。图 5.14 显示在每个节点加入目录之后的分布式内存多处理器。
最简单的目录实现,为每个内存块关联一个目录项。所需信息量与“内存块数量 × 节点数量”成正比;内存块大小与 L2 或 LLC 块相同,而节点可以是单个多核处理器,也可以是内部通过监听实现一致性的一小组处理器。对于处理器数量少于几百的多处理器,每个处理器本身也可能是多核,这一开销不是问题,因为采用合理块大小时,目录开销可以接受。更大规模的多处理器则需要让目录结构有效扩展的方法,不过只有超级计算机规模的系统才需要担心这一点。
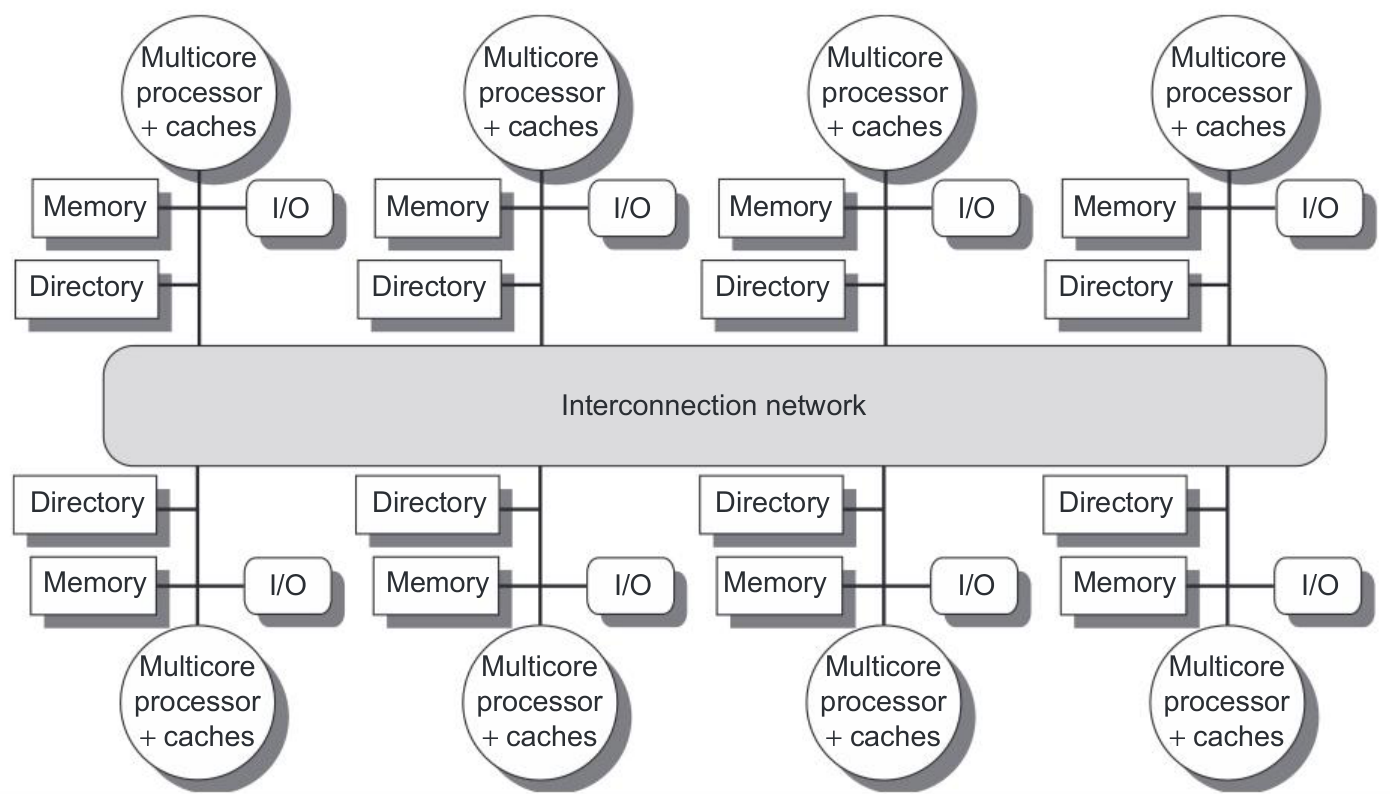
图 5.14(续)。 图中一个节点是一颗多核芯片,其所关联内存的目录信息可以位于片上,也可以位于片外。每个目录负责跟踪哪些缓存共享了本节点所辖内存地址。一致性机制既维护目录信息,也处理多核节点内部所需的一致性动作。
图内术语:Multicore processor + caches=多核处理器及缓存;Memory=内存;Directory=目录;Interconnection network=互连网络;I/O=输入/输出。
目录式缓存一致性协议的基础
与监听协议一样,目录协议必须实现两项主要操作:处理读未命中,以及处理对共享、干净缓存块的写入。对当前已共享块的写未命中,只是这两者的简单组合。为实现这些操作,目录必须跟踪各缓存块的状态。在一个简单协议中,可以有如下状态:
- 共享(Shared):一个或多个节点缓存了该块,内存中的值为最新,持有副本的全部缓存中的值也为最新。
- 未缓存(Uncached):没有节点持有该缓存块的副本。
- 已修改(Modified):恰有一个节点持有该块副本,而且已经写入,因此内存副本过期。这个处理器称为块的拥有者。
除了跟踪每个可能共享的内存块的状态,还必须跟踪哪些节点持有副本,因为写入时必须使它们失效。最简单的办法,是为每个可能被缓存的内存块保存位向量。块为共享状态时,各位指示对应核心或核心组是否持有副本;块为独占状态时,该位向量也能用来跟踪拥有者。为提高效率,各缓存自身还会跟踪其缓存块状态。
各缓存的状态机,其状态及转换与监听缓存相同,只是转换时的动作略有区别。使副本失效,以及找到数据项独占副本的过程不同,因为两者都需要请求节点与目录通信,再由目录与一个或多个远程节点通信。在监听协议中,这两步通过向所有节点广播合并完成。目录式系统则使用请求核心、目录控制器和响应核心之间的点对点消息,不向所有节点广播。
在查看状态图之前,先列出核心与目录之间为处理未命中、维护一致性可能传送的消息,有助于理解协议。图 5.15 给出了节点间的消息类型。**本地节点(local node)**是请求发起的节点。**归属节点(home node)**是某地址的内存位置和目录项所在的节点。物理地址空间静态分布,因此,给定物理地址,其内存与目录位于哪个节点是已知的。例如,地址高位可表示节点号,低位表示该节点内存中的偏移。本地节点也可能就是归属节点。即使二者相同,也必须访问目录,因为第三个节点,即远程节点,仍可能持有副本。
**远程节点(remote node)**是持有该缓存块副本的节点;它可能独占该块,此时是唯一副本,也可能共享该块。远程节点可能与本地节点或归属节点相同。这时基本协议不变,只是处理器间消息可以改为处理器内部消息。
本节采用简单的存储一致性模型。为尽量减少消息类型和协议复杂性,假定消息按发送顺序接收并处理。5.8 节考察的多处理器和多核系统满足这一假设,但极大规模的多处理器可能不满足。不严格遵守此顺序时,会增加复杂性,5.6 节讨论存储一致性模型时会涉及其中一部分。本节利用这一假设,确保节点发出的失效请求在传送新消息之前得到处理,正如讨论监听协议实现时的假设一样。
与监听协议一样,这里省略了一些实现一致性所必需的细节。其中大多数问题,同样可以通过增加瞬态来处理非原子动作。
| 消息类型 | 来源 | 目的地 | 消息内容 | 功能 |
|---|---|---|---|---|
| 读未命中 | 本地缓存 | 归属目录 | P,A | 节点 P 在地址 A 读未命中:请求数据,并让 P 成为读共享者。 |
| 写未命中 | 本地缓存 | 归属目录 | P,A | 节点 P 在地址 A 写未命中:请求数据,并让 P 成为独占拥有者。 |
| 失效 | 本地缓存 | 归属目录 | A | 请求向所有缓存了地址 A 所在块的远程缓存发送失效消息。 |
| 失效 | 归属目录 | 远程缓存 | A | 使地址 A 的共享数据副本失效。 |
| 获取(Fetch) | 归属目录 | 远程缓存 | A | 取得地址 A 所在块并发往归属目录;将远程缓存中 A 的状态改为共享。 |
| 获取并失效(Fetch/invalidate) | 归属目录 | 远程缓存 | A | 取得地址 A 所在块并发往归属目录;使缓存中的该块失效。 |
| 数据值应答 | 归属目录 | 本地缓存 | D | 从归属内存返回数据值。 |
| 数据写回 | 远程缓存 | 归属目录 | A,D | 写回地址 A 的数据值。 |
| 确认 | 归属目录 | 本地缓存 | A | 表示针对地址 A 请求的全部失效操作均已完成。目录逐一跟踪收到的确认,待所有共享副本失效后发送该消息。 |
| 确认 | 远程缓存 | 归属目录 | P,A | 表示处理器 P 已完成地址 A 的失效操作。目录逐一跟踪这些确认,然后向发起请求的本地缓存发送确认。 |
图 5.15(续)。 前三种是本地节点发往归属节点的请求。第四至第六种是归属节点为了满足读写未命中请求而发往远程节点的消息。数据值应答把值从归属节点传回请求节点。数据写回有两个原因:缓存中的块被替换,必须写回归属内存;或者响应归属节点发来的获取或获取并失效消息。每当块转为共享状态就写回数据,可以减少协议所需的状态,因为所有脏块都必须独占,而所有共享块在归属内存中始终都有可用副本。最后两行是确认,用于跟踪远程缓存何时完成失效,以及本地缓存完成写入所需的全部失效何时完成。失效操作本来不要求响应,但存储一致性模型要求我们知道何时可以继续写入,所以必须加入确认消息。
一个关键增补就是图 5.15 中的确认消息。因为我们不能直接知道所有必要的失效何时完成,所以,对于不返回任何数据的失效请求,必须让接收方发回确认,才能知道该操作已经完成。而且,只有确认全部失效都完成后,才能允许写入继续。5.6 节讨论存储一致性时,将说明这一限制的必要性;附录 I 也将进一步讨论。
一个目录协议示例
目录协议中,缓存块的基本状态与监听协议完全一样,目录状态也与前面类似。因此,可以先看单个缓存块的简单状态转换图,再考察内存中各块所对应目录项的状态图。和监听一样,这些状态图不表示协议的全部细节。实际控制器高度依赖多处理器的许多细节,例如消息交付特性、缓冲结构等。本节介绍基本状态图,实现中的棘手问题留到附录 I。
图 5.16 显示单个缓存响应的协议动作。记号沿用上一节:节点外部的请求为灰色,动作以粗体表示。单个缓存的状态变化由读未命中、写未命中、失效和数据获取请求触发。缓存自身也会产生发往归属目录的读未命中、写未命中和失效消息。读写未命中需要数据值应答,必须等应答到达后才能改变状态;因此,与监听一样,这些事务需要瞬态。目录还必须跟踪失效操作,以确定何时全部完成。
图 5.16 中缓存块状态图的工作方式与监听基本相同:状态一致,触发事件也几乎一样。在监听方案中通过总线或其他网络广播的写未命中,改由目录控制器选择性发送数据获取和失效操作。与监听协议一样,任何缓存块在被写入时必须处于独占状态,任何共享块在内存中都必须为最新。在许多多核处理器中,最外层缓存由核心共享,例如 Intel i7 和 i9、AMD Opteron 和 EPYC,以及 IBM Power 系列的 L3;这一层的硬件通过内部目录或监听,维持同一芯片各核心私有缓存的一致性。这种设计允许目录信息保存在 LLC。扩展到多个插槽后,LLC 不再共享,需要进一步扩展,稍后讨论。
目录协议的另一半由目录实现。一条发往目录的消息会引起两类动作:更新目录状态,以及发送额外消息来满足请求。目录表示一个块的三个标准状态;但与监听不同,它表示某内存块的全部缓存副本的状态,而不是单个缓存块的状态。
内存块可能没有被任何节点缓存,可能由多个节点缓存且可读,即共享,也可能恰好由一个节点独占缓存且可写。除了状态,目录还必须跟踪持有副本的节点集合,这里用 Sharers 集合表示。节点少于 64 个时,通常用位向量保存它;每个节点可能包含 4–8 个处理器,因此处理器数可以是节点数的 4–8 倍。目录请求需要更新 Sharers,并读取它以执行失效操作。
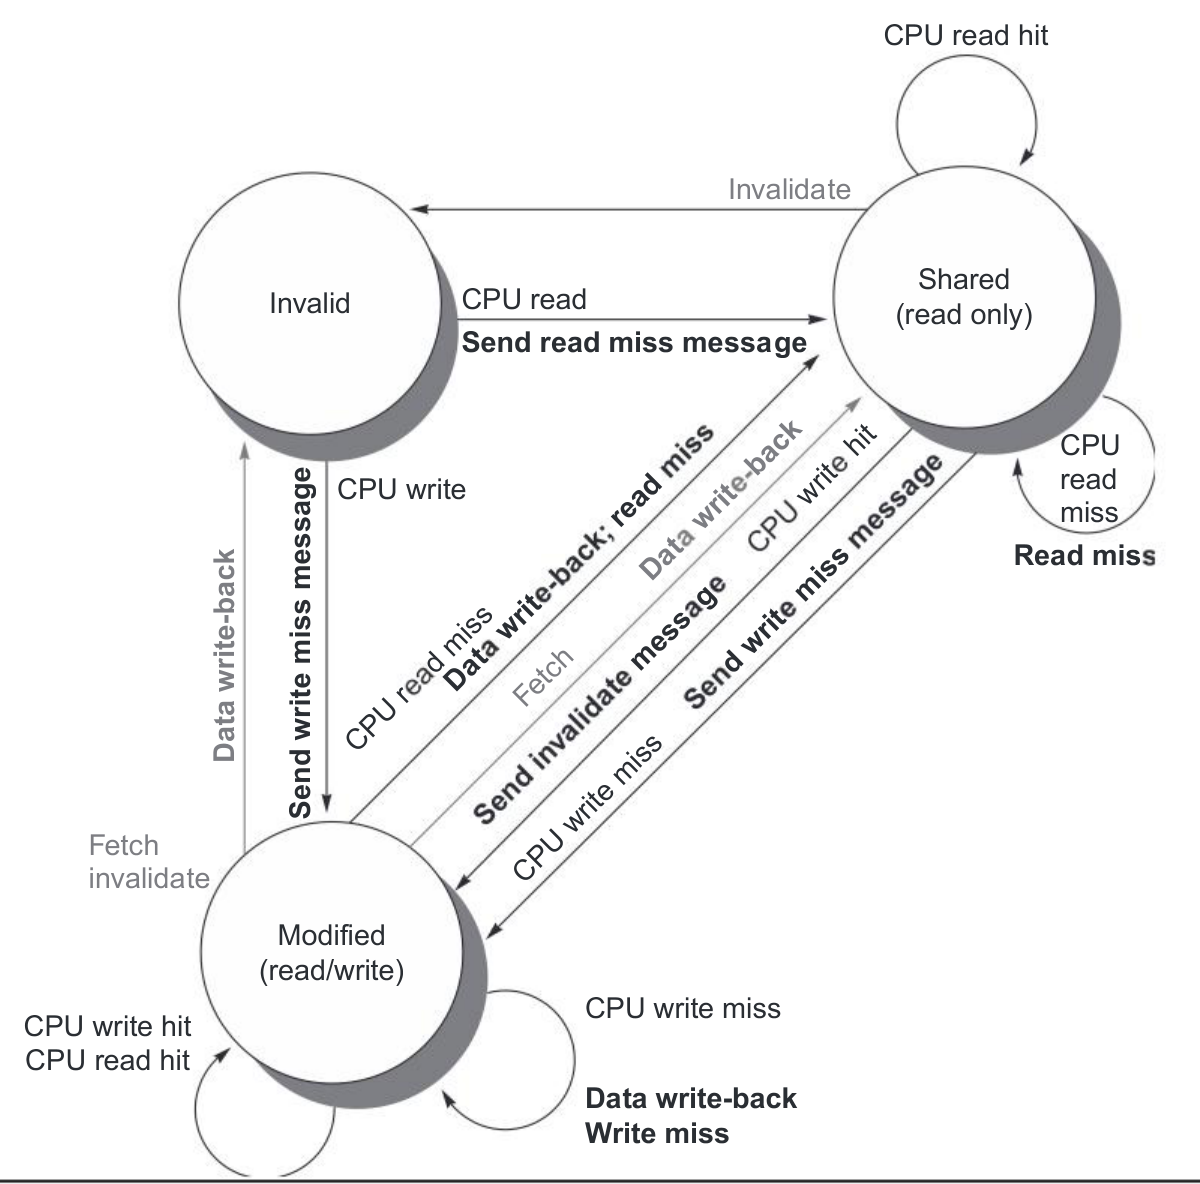
图 5.16(续)。 状态与监听情况一致,事务也很相似,只是用显式失效和写回请求代替了原先在总线上广播的写未命中。与监听控制器一样,假定尝试写共享缓存块被视为未命中。实际实现可以把它视为所有权请求或升级请求,无须重新获取缓存块就交付所有权。
图内术语:Invalid=无效;Shared (read only)=共享(只读);Modified (read/write)=已修改(可读写);CPU read/write hit/miss=CPU 读/写命中或未命中;Send read/write miss message=发送读/写未命中消息;Send invalidate message=发送失效消息;Fetch=获取;Fetch invalidate=获取并失效;Data write-back=数据写回。
图 5.17 显示目录对收到消息所采取的动作。目录接收三种请求:读未命中、写未命中和数据写回。响应消息以粗体表示,对 Sharers 的更新以粗斜体表示。因为所有触发消息都来自外部,所有动作都画成灰色。这个简化协议假定某些动作是原子的,例如请求一个值并发送给另一个节点。真实实现不能依靠这一假设,需要像监听方案一样增加瞬态。
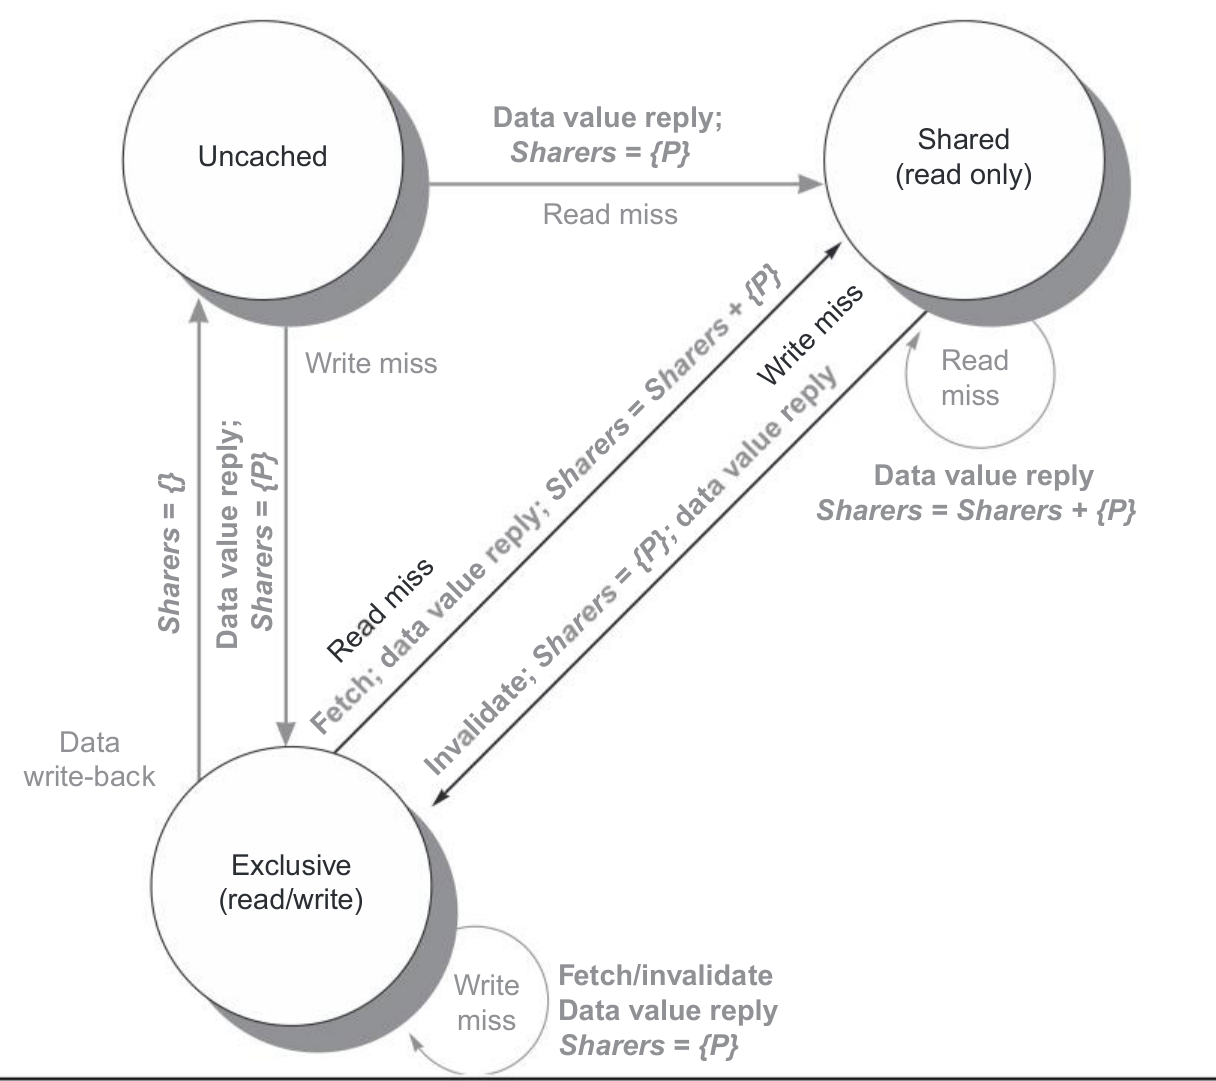
图 5.17(续)。 与监听一致性一样,目录只有确认全部失效请求都已被接收,才能响应写未命中。目录方案通过收到失效请求的缓存向目录发送确认来跟踪这一进程。
图内术语:Uncached=未缓存;Shared (read only)=共享(只读);Exclusive (read/write)=独占(可读写);Read/Write miss=读/写未命中;Data value reply=数据值应答;Data write-back=数据写回;Fetch/invalidate=获取并失效;Invalidate=失效。Sharers 为共享者集合,{P} 表示仅含节点 P,{} 表示空集,Sharers + {P} 表示把 P 加入集合。
为理解目录操作,下面按状态分别考察请求和动作。块为未缓存时,内存副本就是当前值,因此只可能收到以下请求:
- 读未命中。 从内存向请求节点发送数据,将其设为唯一共享节点,块转为共享状态。
- 写未命中。 将值发送给请求节点,让它成为共享集合中的节点。块转为独占,表示唯一有效副本已被缓存;Sharers 指明拥有者。
块为共享时,内存中的值是最新的,也可能发生这两类请求:
- 读未命中。 从内存发送所需数据,并将请求节点加入共享集合。
- 写未命中。 向请求节点发送值。向 Sharers 中所有节点发送失效消息,并将 Sharers 设为只包含请求节点。目录知道所有失效已完成后,块转为独占。
块为独占时,当前值位于 Sharers 指定节点,即拥有者,的缓存中。此时可能收到三种目录请求:
- 读未命中。 向拥有者发送数据获取消息,使其缓存中的块转为共享,并把数据发给目录。目录将数据写入内存,再发回请求处理器。把请求节点加入 Sharers;原拥有者仍保留可读副本,因此仍在集合中。
- 数据写回。 拥有者正在替换块,所以必须写回。写回使内存副本成为最新,归属目录实际上成为拥有者。该块转为未缓存,Sharers 为空。
- 写未命中。 该块将有新的拥有者。向旧拥有者发送消息,让它使缓存块失效,并将值发给目录;目录再转发给请求节点,后者成为新拥有者。Sharers 改为新拥有者,块仍处于独占状态。
实际多处理器的目录协议还有额外优化。例如,在本协议中,对独占块发生读写未命中时,块先发往归属目录,在那里写入归属内存,再转发给最初的请求节点。许多商用多处理器协议直接将数据从拥有者发往请求节点,同时仍写回归属节点。这些优化增加了需处理的消息类型,也增加了复杂性。此外,监听协议中的同类扩展也可用于目录协议,原书举例为“加入 O 和 I 状态”。1
实现目录方案,需要解决大多数与监听协议相同的挑战。但是,如果不限制 CPU 数量,还会出现额外问题,见附录 I。
在多核处理器中实现目录一致性
所有多芯片多处理器都选择将监听与某种目录结合,以便在较多处理器下维持一致性。事实上,随着单芯片核心数增长,许多设计即使在单芯片内部也采用混合方案,将目录信息与共享 LLC 的分片关联。如果 LLC 具有包含性,可以把目录信息与各 LLC 块的标签关联。目录可以指出哪些 L2 持有共享数据;如果多个 L2 通过某个共享结构连接,例如 Power 处理器的环形总线,则只需指出需要监听哪一组处理器。也可以只让 LLC 包含所有共享缓存行,而不要求包含其他行;或者建立目录,指出需要监听哪些 L2 或 L2 集群。AMD EPYC 通过复制 L2 标签建立目录。
一旦超出共享 LLC 的范围,就需要为某块的目录信息安排一个唯一关联点。这类系统中的内存也是分布式的,因此最容易将目录放在内存接口处。假定一致性在 LLC 层实现,目录只需跟踪哪些核心的 LLC 可能持有某共享块。这样,每个内存块的目录信息很少,只需 1–16 bit。也可以按缓存方式保存这些数据,而不为每个内存块都保留。采用目录缓存就意味着必须处理目录未命中;最简单的处理办法是假定该块可能存在于各处,向每个集群发送失效请求。
多数设计要么只采用目录,要么在目录之下对部分核心监听,但两者角色也可以反过来。芯片数较少时,可以监听 LLC 层保存的目录。LLC 目录命中后,再向持有副本的 L2 发出显式失效请求。EPYC 采用这一方式,因为它最多有两个插槽、两个 LLC。
NUMA 多处理器运行 WWW 搜索应用的性能
截至 2022 年,所有较新的多核处理器都是 NUMA,其中许多还因 LLC 分布式布置而采用 NUCA;当然,核心越多,非均匀性就越明显。更大规模的这类系统主要用于服务器,通常提供交互式服务,因此既要求高吞吐量,也要求快速响应,而且通常还有服务质量要求。
为考察性能与系统权衡,我们选择一个基于交互式搜索中最耗时部分的负载。负载与本节数据的详细介绍见 Ayers et al.(2018)。这部分计算主要发生在搜索树的根部,检查网页索引中的独立分片,称为 shard;这些索引通过离线批处理构建。搜索过程的其他几个部分与之类似,但耗时较少。
与 SPECint 等其他负载相比,搜索负载的 L2 指令未命中率更高;其整体 CPI 与 LLC 未命中率则介于访存最密集的基准测试,例如 mcf,与更典型的 SPECint 程序之间。该负载具有很高并行性:在 72 核 Intel Xeon E7 系统上,相对于 8 核系统获得线性加速。这是因为它由请求级并行性构成,见第 6 章,进程间通信极少,因此由共享数据读写产生的一致性流量也很少。
数据采集所用 Intel Xeon E788xx 的特征如下:
| 特性 | 数值 |
|---|---|
| 每芯片核心数 | 18 |
| 总核心数,两颗芯片 | 36 |
| 每核心 SMT 线程数 | 2 |
| 缓存块大小 | 64 B |
| 每核心 L1I | 32 KiB,4 路 |
| 每核心 L1D | 32 KiB,8 路 |
| 每核心 L2 | 256 KiB,8 路 |
| 每插槽共享 L3 | 45 MiB,16 路 |
虽然一致性流量很少,这个搜索应用对存储系统的压力仍然很大。图 5.18 给出 L1、L2、L3 的 MPKI,并将平均未命中开销与 MPKI 相乘,估计未命中成本。这会高估实际停顿时间,因为处理器能隐藏一部分未命中时间。L3 未命中的重要性,使 CPI 与 L3 未命中率高度相关;第 2 章考察硬件预取时也观察到了这一点。还要记住,L3 未命中要访问片外 DRAM,其能耗也是 L3 命中的十倍或更多。
由于采用组相联缓存,冲突未命中很少:改用全相联缓存、消除全部冲突未命中,只能使两个 L1 的未命中率下降 7%,L2 和 L3 则下降不足 1%。这个应用长期运行,因此强制性未命中很少;一致性未命中也很少,所以容量未命中占主导。考虑到 WWW 搜索引擎的数据规模,这并不令人意外。
使用较大的 L3 是减少容量未命中的一种方法。如果空间局部性高,增大块也能降低容量未命中率。图 5.19 给出此负载下,改变各级缓存块大小的影响。记住,由于共享很少,通常会随着大块伪共享增加的一致性未命中,在这里影响很小。
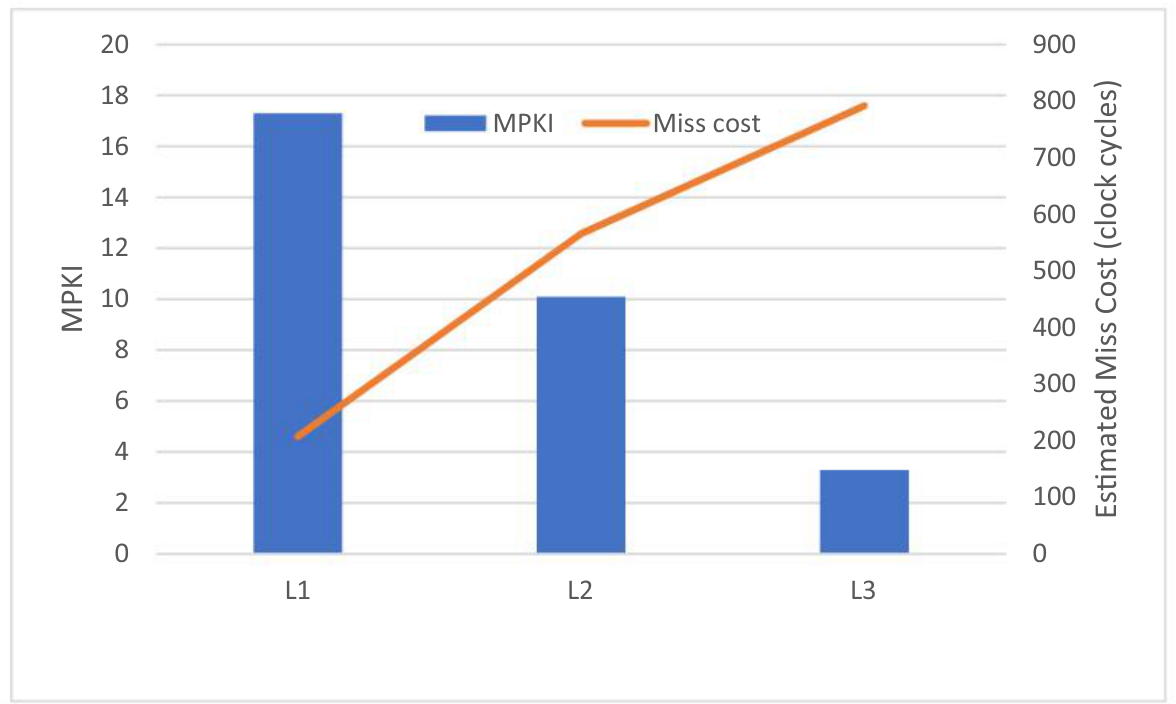
图 5.18(续)。 相比 L3 的 240 周期未命中开销,处理器更容易隐藏 L1、L2 分别为 12、56 周期的开销。因此,相对于图中 L3 的估算,L1、L2 的实际未命中成本会更低。估计假定发往 L3 和内存的未命中中,有 2/3 命中本地 L3 存储体或本地内存,不包括一致性事务成本。
图内术语:MPKI=每千条指令的未命中数;Estimated Miss Cost (clock cycles)=估算未命中成本(时钟周期);Miss cost=未命中成本。
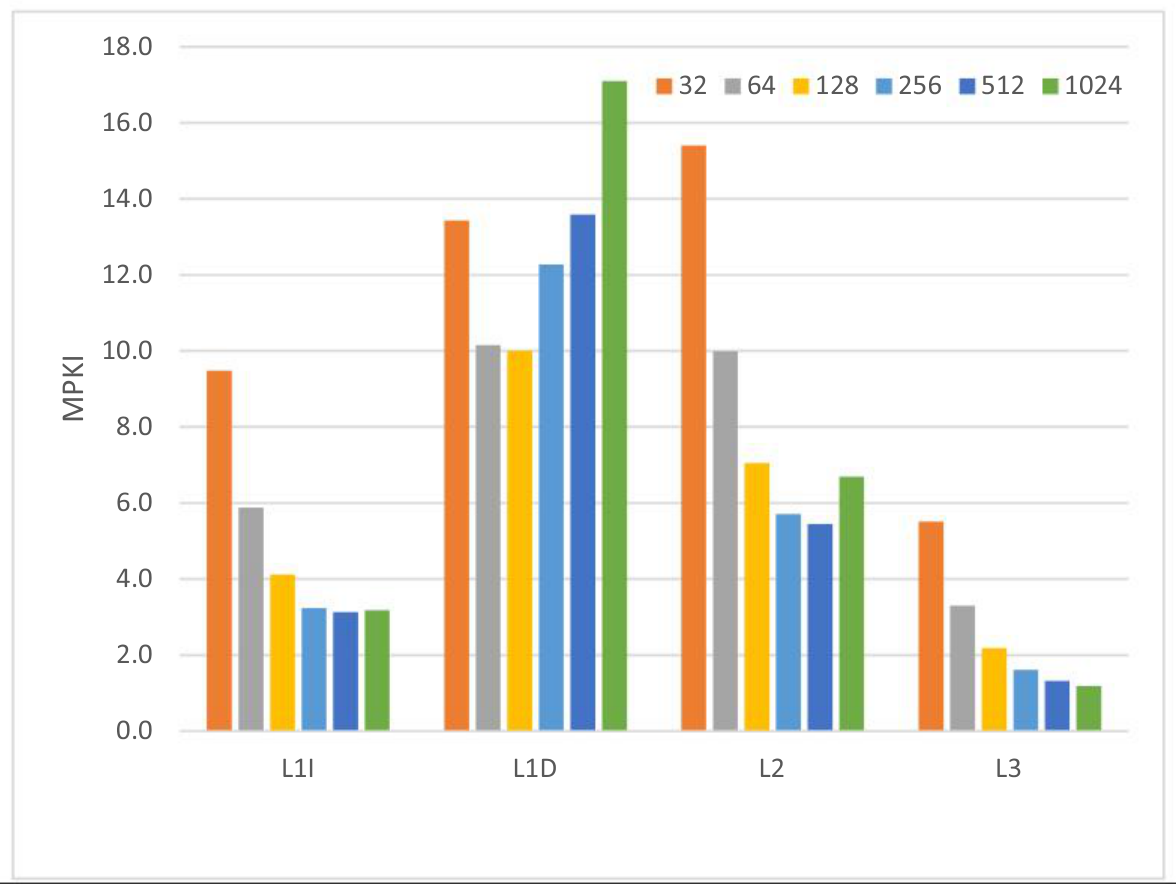
图中纵轴为 MPKI;图例 32、64、128、256、512、1024 表示块大小,单位为字节;L1I 和 L1D 分别为 L1 指令缓存和数据缓存。
正如预料,增大块对 L1 指令缓存未命中的影响最大,但较大的 L3 也有显著收益。L1 数据缓存最敏感:最初未命中率下降约 25%,但块继续变大后,未命中率又上升。
当然,增大块虽然通常能降低未命中率,却会增加流向下一层的流量。因此,性能能否改善,取决于更多内存流量造成的潜在争用、更高的单次未命中成本,以及对功耗的潜在影响。单次未命中成本又取决于存储系统是否优先返回关键字,让访存操作先继续执行;功耗则主要取决于未命中次数,而不是块大小。
图 5.20 展示较大块相对于 32 B 块的内存流量。即使只考虑这一个基准测试,选择最佳块大小也很复杂。例如,增大 L1I 块似乎合理,因为改为 64 B 后未命中率大幅下降,而流量只略增。由于包含性使 L1D 与 L2 采用不同块大小变得棘手,把 L2 块增至 64 B,会使流向 L2 的流量变为 1.5 倍,L2 到 L3 的流量变为 1.3 倍。是否划算,取决于在更广泛的基准测试上分析整个系统的行为。假定不要求包含性,增大 L3 块似乎更有吸引力。不过,还必须考虑怎样跟踪 L2 的一致性信息。尽管如此,流量只增至 1.2 倍,未命中率却降至原来的 ,仍然很有吸引力。
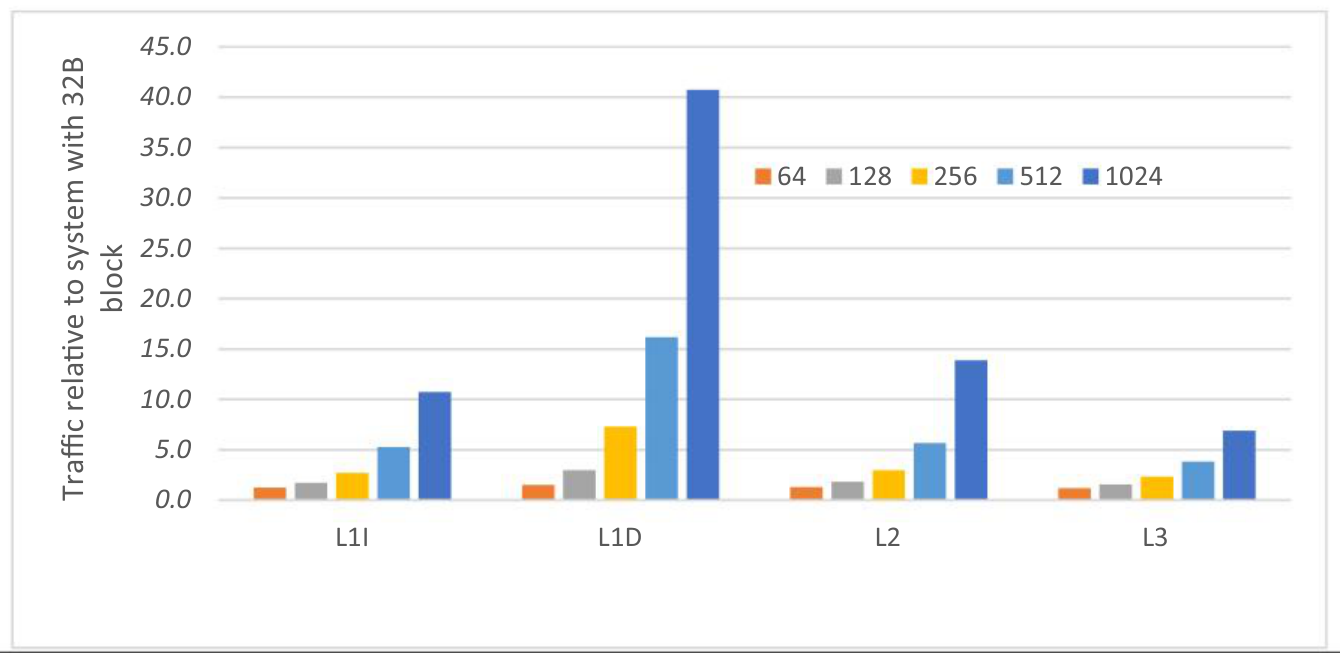
图内术语:Traffic relative to system with 32B block=相对于采用 32 B 块的系统的流量;图例 64、128、256、512、1024 为块大小,单位为字节。
对于数据共享更密集的应用,增大块很可能产生更多一致性未命中,进一步削弱 L1D、L2 使用大块的优势。科学应用中未命中的分析见附录 I。
译注: 此处写为“加入 O 和 I 状态”;但 I(Invalid)在前述基本 MSI 协议中已经存在。此处不猜测作者原拟写的是哪一扩展状态,保留字面表述。 ↩︎