5.6 存储一致性模型简介
缓存一致性保证多个处理器看到一致的内存视图,却没有回答这个视图必须“一致到什么程度”。所谓“一致到什么程度”,实质上是问:另一个处理器更新的值,某处理器必须在什么时候看到?处理器通过共享变量通信,变量既用于保存数据,也用于同步,因此问题可归结为:一个处理器必须以什么顺序观察另一个处理器的数据写入?而观察另一个处理器写入的唯一办法是读取,所以问题又转化为:不同处理器对不同内存位置的读写之间,必须强制保证哪些性质?
这个问题表面简单,实际上非常复杂。下面把进程 P1、P2 的两段代码并排写出:
假定进程运行在不同处理器上,A 和 B 最初都被两个处理器缓存,初值为 0。如果写入总是立即生效,并立即被其他处理器看到,那么标为 L1、L2 的两个 IF 条件不可能同时为真,因为到达 IF 就意味着 A 或 B 已被赋值为 1。但如果写失效延迟,而处理器在延迟期间仍可继续执行,那么 P1 和 P2 读取前,可能都还没有分别看到 B 和 A 的失效请求。问题是:是否应允许这种行为?如果允许,应当满足什么条件?
最直接的存储一致性模型称为顺序一致性(sequential consistency)。它要求任何一次执行的结果,都等同于这样一种执行:每个处理器的内存访问保持原有顺序,而不同处理器之间的访问以任意方式交错。顺序一致性排除了上述例子中不直观的结果,因为在开始 IF 之前,相应赋值必须已经完成。
实现顺序一致性最简单的办法,是要求处理器延迟完成某次内存访问,直到该访问导致的所有失效动作都完成。等价的办法是,在前一次访存完成前,延迟下一次访存。要记住,存储一致性涉及不同变量之间的操作:这里要求排序的两个访问指向不同内存位置。在本例中,必须等先前的写入,即 B=1 或 A=1,完成后,才读取 A 或 B,即判断 A==0 或 B==0。因此,在顺序一致性下,不能简单地把写入放进写缓冲区,然后继续读取。
顺序一致性提供了简单的编程范式,却限制了潜在性能,尤其是在处理器众多或互连延迟较大的多处理器中。下面的例题说明这一点。
例题:等待失效完成的代价
某处理器写未命中时,需要 60 个周期取得所有权,取得后再用 40 个周期发出失效请求;失效请求发出后,还需要 80 个周期完成并收到确认。如果另有四个处理器共享该缓存块,在顺序一致性下,一次写未命中会使写入处理器停顿多久?假定失效必须得到显式确认,一致性控制器才知道它已经完成。如果写未命中取得所有权后,无须等待失效就能继续执行,写入又要多久?
解答。 等待失效时,每次写入需要取得所有权的时间,加上完成失效的时间,总计:
相比之下,取得所有权只需 60 个周期。如果采用适当的写缓冲实现,甚至可以在所有权建立之前继续执行。
为了改善性能,研究者和体系结构设计者探索了两条路线。第一条保留顺序一致性,但采用更积极的实现,用延迟隐藏技术减少开销,5.7 节将讨论。第二条采用限制更少的存储一致性模型,使硬件能够更快。这类模型会影响程序员对多处理器的理解,因此在讨论之前,先看看程序员期待什么。
程序员的视角
顺序一致性虽有性能劣势,却在程序员看来具有简单的优点。挑战在于设计一种易于解释、同时允许高性能实现的编程模型。
一种允许更高效实现的模型,是假定程序已经正确同步。如果对共享数据的全部访问都由同步操作确定次序,程序就是已同步的(synchronized)。所谓一次数据访问由同步操作排序,是指:在每种可能的执行中,某处理器对变量的写入,与另一处理器对该变量的读或写之间,都隔着一对同步操作;写入处理器在写后执行其中一个,访问处理器在访问前执行另一个。如果变量可能在没有同步排序的情况下更新,就称为数据竞争(data race),因为结果取决于处理器的相对速度。与硬件设计中的竞争一样,其结果不可预测。因此,已同步程序也称为无数据竞争(data-race-free)程序。
举个简单例子,两个处理器读取并更新同一个变量。每个处理器都用加锁和解锁包围读与更新,既保证更新互斥,也保证读取一致。显然,现在每次写入与另一处理器的读取之间,都隔着两个同步操作:写后的解锁,以及读前的加锁。如果两个处理器都写变量,其间没有读取,两次写入也同样必须由同步操作隔开。
人们普遍认为,多数程序都是已同步的。主要原因在于,如果访问不同步,程序行为很可能无法预测:执行速度决定哪一个处理器赢得数据竞争,进而影响程序结果。即使采用顺序一致性,要推理这类程序也很困难。
程序员可以尝试自行构建同步机制来保证顺序,但这极其棘手,容易造成错误,而且体系结构未必支持;这意味着它可能无法在未来几代多处理器上工作。因此,几乎所有程序员都会选择使用正确的同步库,并让库针对多处理器及同步原语类型优化。
最后,标准同步原语保证:即使体系结构实现的模型比顺序一致性更宽松,已同步程序的行为仍如同硬件实现了顺序一致性。
宽松一致性模型:基础与释放一致性
宽松一致性模型的核心思想,是允许读写乱序完成,同时用同步操作强制必要的次序,使已同步程序表现得如同处理器具有顺序一致性。不同宽松模型,按它们放松了哪些读写顺序来分类。用形式为 的规则描述顺序,意思是操作 X 必须先完成,才执行 Y。顺序一致性要求保持全部四种可能顺序:
宽松模型则由放松其中哪些顺序来定义:
- 只放松 ,得到全存储序(total store ordering,TSO),原书也称处理器一致性(processor consistency)。因为它保持写操作之间的顺序,许多在顺序一致性下运行的程序,不增加同步也能在此模型下运行。
- 同时放松 和 ,得到部分存储序(partial store order,PSO)。
- 放松全部四种顺序,会产生多种模型,包括 PowerPC 使用的弱序(weak ordering),以及原书所述 RISC-V 使用的释放一致性(release consistency)。
放松这些顺序可带来显著性能优势,这也是原书所述 RISC-V、ARMv8,以及 C++ 和 C 语言标准选择释放一致性的原因。
释放一致性区分两种同步操作:一种取得共享变量的访问权,记为 ;另一种释放对象,允许其他处理器取得访问权,记为 。它基于这样的观察:在已同步程序中,acquire 操作必须先于共享数据的使用;release 操作必须晚于共享数据的全部更新,并先于下一次 acquire。于是可以略微放松顺序:位于 acquire 之前的读或写,不必在 acquire 之前完成;位于 release 之后的读或写,也不必等待 release。因此,只保留涉及 、 的那些顺序,如图 5.22 所示。图 5.23 的例子表明,在五个模型中,它施加的顺序限制最少。
释放一致性是一种限制很少、又易于检查的模型,并确保已同步程序呈现顺序一致的执行。多数同步操作要么是 acquire,要么是 release:前者通常读取同步变量并原子更新,后者通常只写入。但是屏障等操作兼具二者作用,其排序效果与弱序相同。虽然同步操作总会保证先前写入完成,有时仍希望在没有明确同步操作时,保证写入完成。此时使用显式指令,RISC-V 中称为 FENCE,以保证该线程之前的全部指令完成,包括所有内存写入以及相关失效动作完成。
| 模型 | 采用它的系统 | 普通访问的顺序 | 同步访问的顺序 |
|---|---|---|---|
| 顺序一致性 | 多数机器将其作为可选模式 | ||
| 全存储序或处理器一致性 | IBM S/370、DEC VAX、SPARC | ||
| 部分存储序 | SPARC | ||
| 弱序 | PowerPC | ||
| 释放一致性 | MIPS、RISC-V、Armv8、C 和 C++ 规范 | ; |
图 5.22(续)。 从限制最强的顺序一致性到限制最少的释放一致性,实现的灵活性逐步增加。较弱的模型依赖同步操作建立的屏障,而不要求每次内存操作都隐含一个屏障。定义释放一致性需要区分 acquire 和 release,分别记为 、。如果对表中每个 S 都统一展开这两种记号,则包含一个 S 的顺序会变为两条,例如 变为 和 ;每条 则展开为右下单元格末尾的四种顺序。
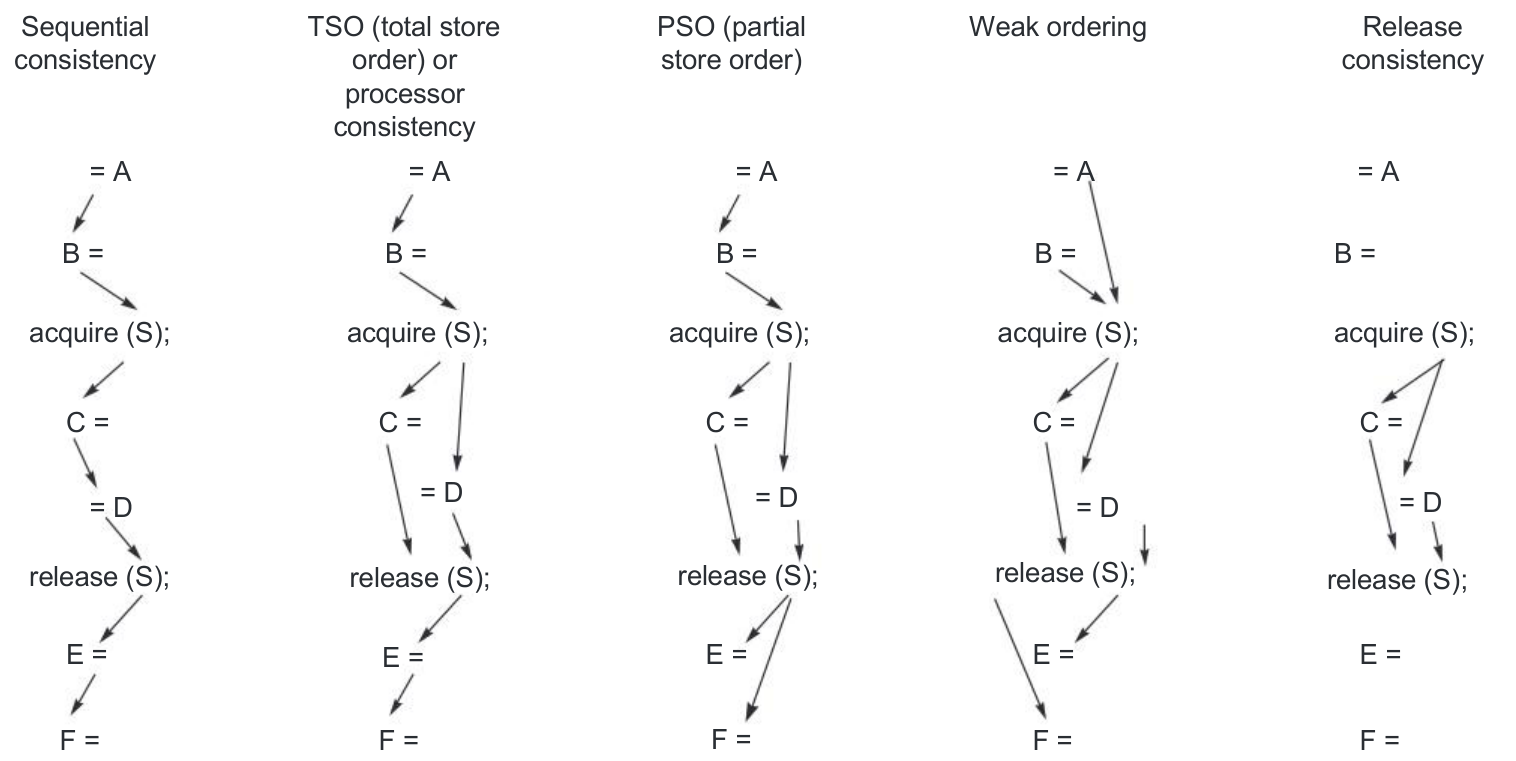
图 5.23(续)。 可以由传递性推导的顺序没有画出,例如顺序一致性中对 C 的写入先于 S 的释放,以及弱序或释放一致性中 acquire 先于 release。
图中从左到右为顺序一致性、TSO(全存储序或处理器一致性)、PSO(部分存储序)、弱序、释放一致性。= A 表示读取 A,B = 表示写入 B,其余类似;acquire(S) 为获取同步对象 S,release(S) 为释放 S。
如前所述,在没有广播介质的较大多处理器中,需要跟踪失效操作,才能知道它们何时完成。关于宽松模型的复杂性、实现问题与性能潜力,我们强烈推荐 Adve 和 Gharachorloo(1996)的出色教程。