5.7 贯穿各层的问题
多处理器重新定义了许多系统特征,例如性能评价、内存延迟,以及可扩展性的重要程度,因此引出了横跨软硬件的有趣设计问题。本节先介绍几个与存储一致性有关的例子,再考察多处理结合多线程后带来的性能收益。
编译器优化与一致性模型
定义存储一致性模型的另一个原因,是明确编译器对共享数据可以合法执行哪些优化。在显式并行程序中,除非同步点定义清楚,而且程序已同步,否则编译器不能交换对两个不同共享数据项的读与写,因为这可能改变程序语义。这种限制甚至阻止一些较简单的优化,例如将共享数据分配到寄存器,因为这一过程通常会交换读写顺序。在隐式并行化的程序中,例如用 High Performance Fortran(HPF)编写的程序,程序必须已同步,而且同步点已知,因此不存在这一问题。
编译器优化共享变量访存的技术究竟能取得多大成功,仍是开放问题。优化技术的现状,以及共享数据常通过指针或数组索引访问的事实,限制了此类优化的应用。如果这项技术成熟,并带来明显性能优势,编译器作者就会希望利用更宽松的编程模型。这种可能性,以及尽量为未来保留灵活性的愿望,使 RISC-V 设计者经过长期争论,最终选择释放一致性。
用推测隐藏严格一致性模型中的延迟
第 3 章已经说明,推测可以隐藏内存延迟。它也可隐藏严格一致性模型引起的延迟,从而获得宽松存储模型的大部分收益。核心思想是利用动态调度重排内存访问,使它们可能乱序执行。
乱序访存可能违反顺序一致性,影响程序执行。推测处理器的延迟提交机制可以避免这一后果。假定一致性协议基于失效:如果某次访存在提交前收到针对其地址的失效请求,处理器就利用推测恢复撤销相关计算,从该访存重新开始。当然,还必须保证这不会给利用推测实施侧信道攻击创造新的机会,见第 3 章。
如果重排后的访存顺序可能产生与顺序一致性不同的结果,处理器就重新执行。关键在于,处理器只需保证结果与全部访问按序完成时相同;检测何时结果可能不同,就能做到这一点。这种办法有吸引力,因为推测重启很少发生:只有未同步访问实际造成竞争时才会触发,见 Gharachorloo et al.(1992)。
Hill(1998)主张,将顺序一致性或处理器一致性与推测执行结合,作为首选模型。他的论证有三点。第一,对这两种模型采用积极实现,可以获得更宽松模型的大多数优势。第二,这几乎不增加推测处理器的实现成本。第三,程序员仍可用较简单的顺序一致性或处理器一致性模型推理。MIPS R10000 团队在 20 世纪 90 年代中期就认识到了这一点,并利用 R10000 的乱序能力,支持这种积极的顺序一致性实现。
包含性及其实现
所有多处理器都使用多级缓存层次,以降低全局互连需求和缓存未命中延迟。如果缓存还具备多级包含性,即每一级都是离处理器更远一级的子集,那么可以利用这种层次,减少监听与处理器访存争用缓存时产生的一致性流量和处理器流量冲突。许多具有多级缓存的多处理器强制保持包含性,不过近来有若干系统选择不强制保持。
乍看之下,维持多级包含性似乎很简单。以两级为例:L1 未命中,要么命中 L2,要么也在 L2 未命中,随后将数据同时装入 L1、L2。类似地,在 L2 命中的失效请求都必须发往 L1,若 L1 有该块,就使它失效。
问题出在 L1 与 L2 块大小不同时。选择不同块大小完全合理,因为 L2 大得多,未命中开销中的延迟部分也长得多,因此希望采用更大的块。这时,“自动”维持包含性会怎样?L2 的一个块对应多个 L1 块,L2 未命中所替换的数据也相当于多个 L1 块。例如,L2 块是 L1 的四倍时,L2 一次未命中会替换相当于四个 L1 块的数据。来看具体例子。
例题:不同块大小如何破坏包含性
假定 L2 块大小是 L1 的四倍。说明一个同时在 L1、L2 引起替换的未命中,如何破坏包含性。
解答。 假定 L1、L2 都直接映射,L1 块为 字节,L2 块为 字节。L1 中有两个块,起始地址为 和 ,且 ,所以 x 也是某个 L2 块的起始地址。这个 L2 块包含 L1 的 、、、 四块。现在处理器访问块 y,它在两级缓存中都映射到包含 x 的块,因此未命中。L2 取得 字节,替换原先包含 、、、 的块;L1 则只取 字节,替换包含 x 的块。L1 中仍有 ,L2 却没有,因此包含性不再成立。
块大小不同时,要维护包含性,必须在低一级发生替换时探查更高各级,确保低级中被替换的任何字,都在高级缓存中失效。各级相联度不同也会造成类似问题。Baer 和 Wang(1988)详细描述了包含性的优势与挑战。到 2017 年,多数设计者选择实现包含性,常采用各级统一块大小的办法。近期 Intel 处理器,包括 i9 和高端 Xeon,以及 AMD EPYC,不强制 L3 包含性,但对 L1、L2 仍要求包含性。这让 L2、L3 可以保存不同数据,提高 L3 的有效利用率;按每核心计算,L3 只比 L2 略大。
多线程给多处理器带来的性能收益
本节简要考察在两个多核处理器上采用多线程的效果:Intel Xeon E7 8800 与 Power8。使用 5.4 节末讨论的高度并行网页搜索基准测试。SMT 的收益取决于处理器数量、支持的线程数以及 ILP 流水线。两种处理器最相关的特征如下:
| 特性 | Intel Xeon E7 | IBM Power8 |
|---|---|---|
| 核心数 | 18 | 12 |
| 每核心 SMT 线程数 | 2 | 8 |
| 每时钟发射数 | 4 | 8 |
| 功能单元数 | 8 | 16 |
回顾前文,网页搜索具有大量请求级并行性,进程间通信很少,因此 Xeon E7 从 8 核扩展到 72 核时获得线性加速。图 5.24 给出增加线程数后,相对于单线程版本的加速比。支持八线程的 Power8 总收益更大,不过这也可能与其更高发射率和更多功能单元密切相关。
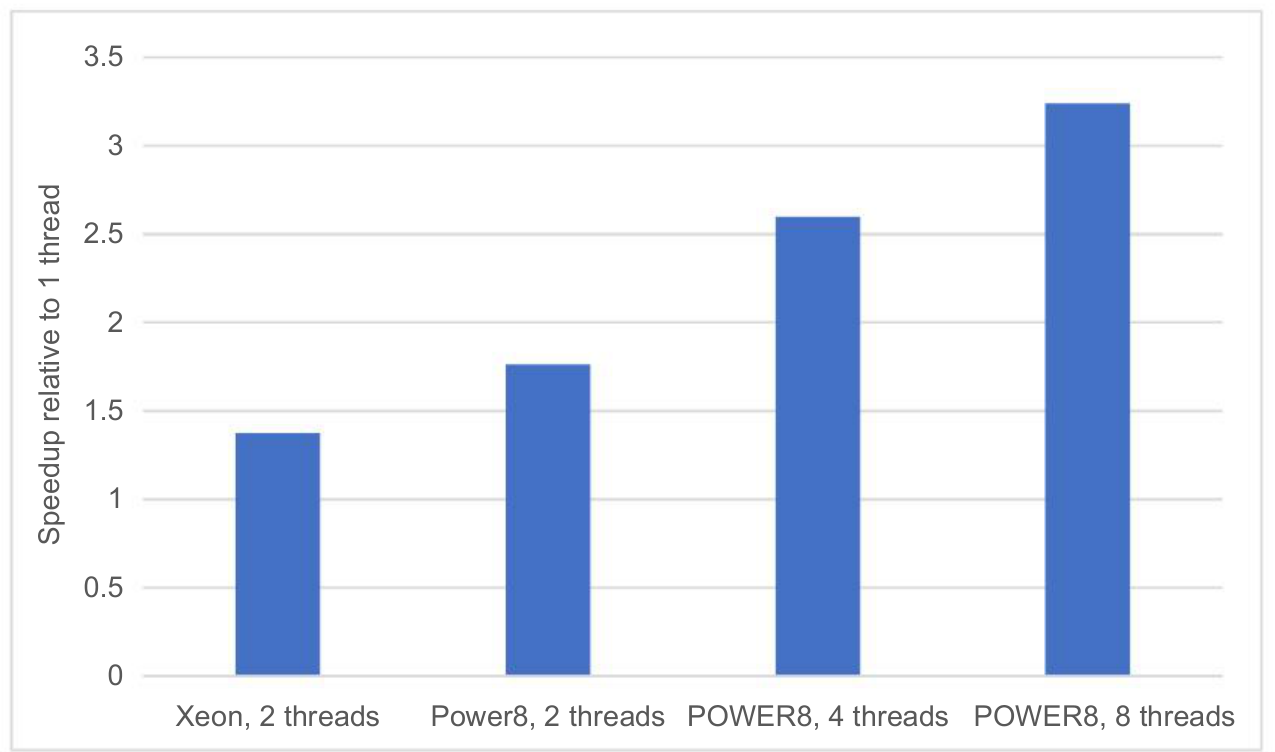
图 5.24(续)。 Power8 是这里唯一在 SMT 核心中提供超过两个线程的处理器。对于这一高度并行应用,Power8 的宽发射和大量功能单元带来了显著性能优势。
图中纵轴为相对于一个线程的加速比;横轴依次为 Xeon 两线程,Power8 两线程、四线程和八线程。