5.8 融会贯通:多核处理器及其性能
大约 15 年来,多核一直是提高性能的主要方向。不过,不同实现差别很大,对更大规模多芯片多处理器的支持也各不相同。
本节考察三种多核设计、它们对更大规模多处理器的支持,以及其中一些系统在性能和能效方面的可扩展性。
三种多核服务器处理器
图 5.25 列出三种面向服务器的多核处理器的主要特征,这些处理器用于 2019–2022 年间上市的系统。
| 特征 | IBM Power10 | Intel Xeon Platinum | AMD EPYC |
|---|---|---|---|
| 每芯片核心数;多芯片模块(MCM) | 每芯片 4–15 核;每插槽 8–30 核 | 每芯片 4–60 核;每插槽 8–120 核 | 每芯片 8 核;每插槽 64 核 |
| 多线程 | SMT | SMT | SMT |
| 每核心线程数 | 8 | 2 | 2 |
| 时钟频率 | 4.15 GHz | 2.2–3.6 GHz | 3.5 GHz |
| L1 指令缓存 | 每核心 96 KiB | 每核心 32 KiB | 每核心 32 KiB |
| L1 数据缓存 | 每核心 64 KiB | 每核心 32 KiB | 每核心 32 KiB |
| L2 缓存 | 每核心 2 MiB | 每核心 1 MiB | 每核心 512 KiB |
| L3 缓存 | 每核心 8 MiB;共享,访问非均匀 | 22–77 MiB,每核心 1.375 MiB;核心数较多的配置共享 | 每核心 4 MiB,采用堆叠存储器时可达每核心 12 MiB;共享 |
| 包含性 | L2 具有包含性 | L2 具有包含性 | L3 对共享块具有包含性 |
| 多核缓存一致性协议 | 扩展 MESI,带行为和局部性提示,共 13 个状态 | MESIF:扩展 MESI,允许直接传送干净块 | MDOEFSI:扩展 MOESI,增加 dirty 和 forward 状态 |
| 多芯片缓存一致性实现 | 混合方式,以监听为主,辅以有限目录 | 混合方式,监听加 L3 目录 | 混合方式,监听加位于 L3 的目录,目录保存 L2 标签副本 |
| 多处理器互连支持 | 最多 16 芯片,任意处理器间 1 或 2 跳 | 最多 8 芯片,直接通过 UPI 互连 | Infinity Fabric 连接每插槽的 4 个 chiplet,最多 2 插槽 |
| 处理器芯片数范围 | 1–16 | 2–8 | 1–2 |
| 核心数范围 | 4–240 | 8–480 | 8–128 |
图 5.25(续)。 表中列出各处理器家族的处理器数量、时钟频率和缓存容量范围。这些处理器都采用 NUCA 与 NUMA 结构。L3 访问时间分别针对本地分片和远程分片,内存访问时间分别针对本地内存和远程内存;所有访问时间均为平均值。最后一行列出已公布性能数据,例如 SPECintRate 数据的系统配置范围,包括处理器芯片数和总核心数。注意,虽然已有 56 核 Intel Xeon,采用最新微体系结构的处理器最多为 40 核。大多数系统提供 chiplet 形式;IBM 和 Intel 设计还支持包含多个 chiplet 的更大型多处理器。
译注: 原图注提到访问时间,但本页表格没有相应数据行;图注的 Xeon 核心数与表内范围也不完全一致。此处分别保留,不补入原书未提供的数据。协议缩写 MDOEFSI 按原表保留。
Intel Xeon Platinum 采用类似 Skylake 微体系结构的核心,但时钟频率比桌面处理器略低,原因是功耗限制;它配备更大的 L3 缓存,也有多得多的核心。Power10 是 IBM Power 系列最新一代,核心更多,缓存更大。本例中,AMD EPYC Milan 系列每个 chiplet 有 8 核,每插槽有 4 个 chiplet。由于这些处理器用于多核、多处理器服务器,它们按家族提供多种配置,在处理器数量、缓存容量等方面有所不同,如图所示。
这三种系统体现了连接片上核心,以及连接多个处理器芯片或 chiplet 的多种技术。图 5.26 展示 Power10 与 Xeon Platinum 的芯片组成。Power10 每个核心直接连接一个 8 MiB 的 L3 存储体;其他存储体通过互连网络访问,网络有 8 条独立总线。
图 5.26B 展示核心数较多时 Xeon Platinum 处理器芯片的组成,图中为 24 核。两组环形互连各自连接一组核心,每个核心都有相应的 L3 分片,以及负责部分地址空间的一致性逻辑。任意核心经过一个或两个环,都能访问其他缓存存储体或核心。Xeon Platinum 提供 3 条 UPI 互连链路,用于连接多颗 Xeon。
AMD EPYC Milan 的单芯片版本最简单,因为每个 chiplet 只有八核。八个核心与八存储体 L3 通过宽度为 32 字节的双向环连接。同一插槽中的其他 chiplet 通过 Infinity Path 连接,它将插槽内八颗多核芯片全连接。这三种多核都属于 NUCA,因为访问 L3 所需时间取决于访问哪个存储体。
由这些多核芯片组成的多处理器采用多种互连策略,如图 5.27 所示。Power10 设计支持连接 16 颗 Power10 芯片,总共 240 核。组内连接把 4 颗处理器芯片构成全连接模块;组间链路把每颗处理器芯片连接到其他各模块中的 3 颗芯片。多颗 Xeon 通过 UPI 互连。在八插槽多处理器中,采用最新公布的 Xeon 时可有 448 核;每颗处理器的 3 条 UPI 链路连接 3 个邻居。图 5.27 展示八颗 Xeon 的一种连接方式:与 Power10 一样,任意两颗处理器相距一跳或两跳。有少数公司制造了规模更大的 Xeon 多处理器,通过接入 UPI 网络并扩展网络及一致性机制,支持更多处理器。EPYC 通过 Infinity Path 连接一个插槽中的八个 chiplet。如图 5.27 所示,同一插槽内的 chiplet 全连接。两个插槽可利用未使用的 Infinity Path 连接相连,使任意两个 chiplet 相距一跳或两跳。
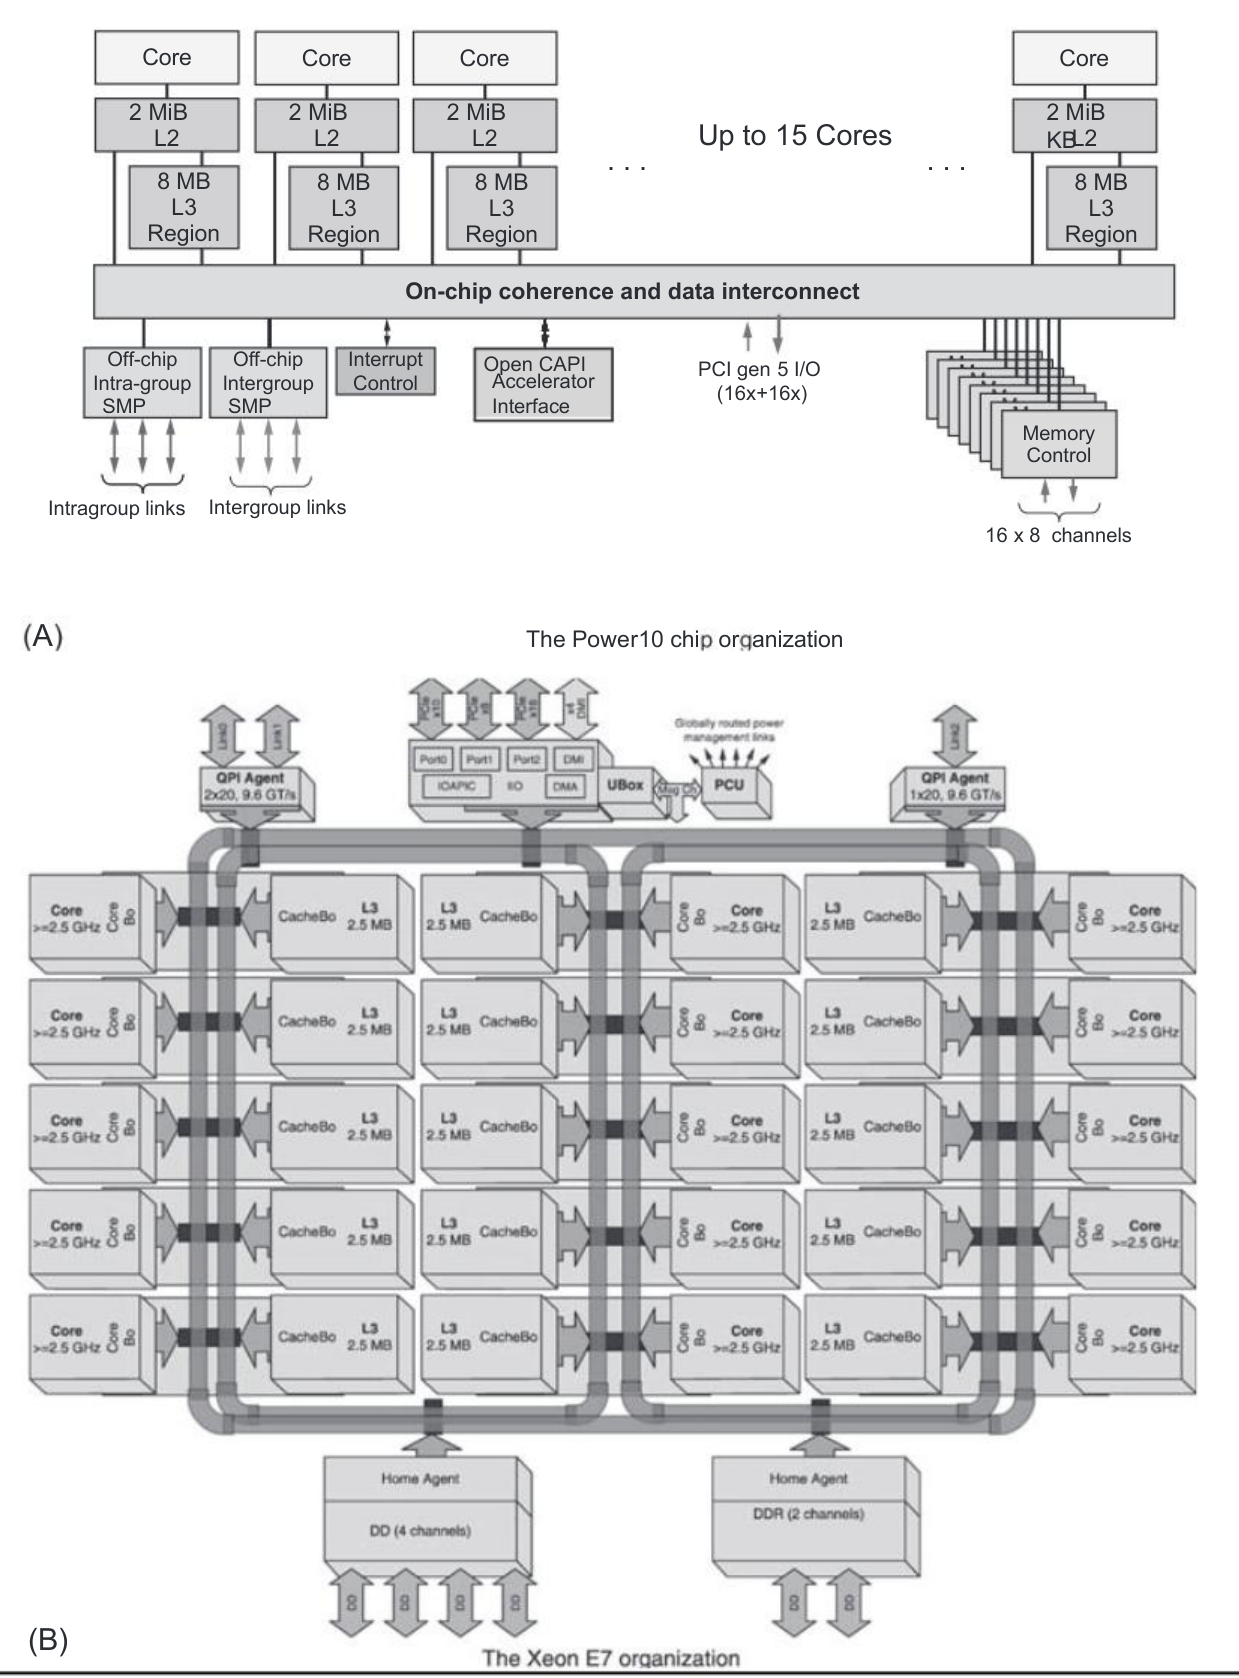
图中文字:Core 为核心,Region 为分区;On-chip coherence and data interconnect 为片上一致性与数据互连;Off-chip Intra-group / Intergroup SMP 为片外组内/组间 SMP;Interrupt Control 为中断控制;OpenCAPI Accelerator Interface 为 OpenCAPI 加速器接口;Memory Control 为存储器控制;Intragroup / Intergroup links 为组内/组间链路。图 A 标有最多 15 核、每核心 2 MiB L2 和 8 MB L3 分区、16 × 8 个存储通道,以及 PCI 第 5 代 I/O(16x + 16x)。图 B 中 Home Agent 为归属代理,QPI Agent 为 QPI 代理,Globally routed power management lines 为全局布线的电源管理信号线;Port、Link、channels 分别为端口、链路、通道。其余接口、缩写和速率保留原标记。图 B 的原始分辨率较低,放大后部分细小标签仍较模糊。
译注: 本节正文称 Xeon Platinum,并称图中为 24 核;图注实际写 Xeon E7,图 B 可见 15 个核心方框(3 列,每列 5 个)。图内 MB、MiB 及接口名称均按原图保留,不能据此将图 B 当作前述 Platinum 配置的精确示意图。
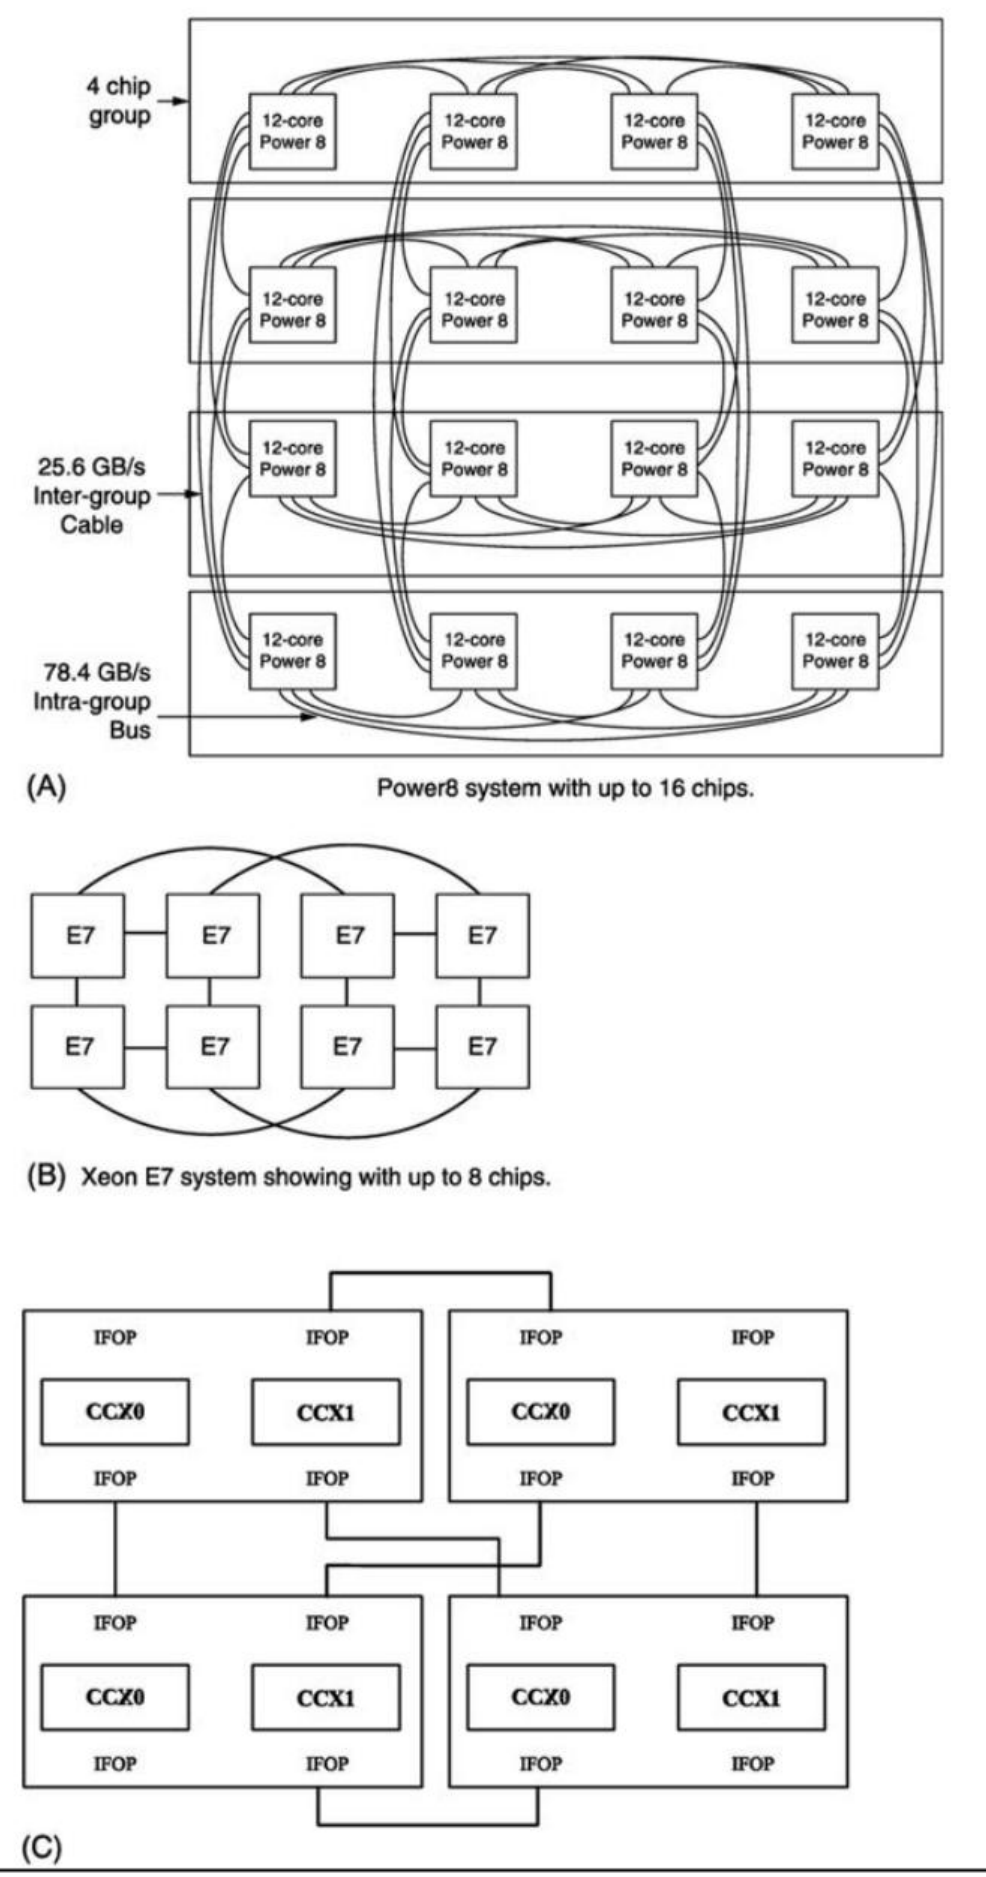
图 5.27(续)。 三种设计都将四颗芯片全连接,一跳即可到达;访问另一组四颗芯片还需一跳,因此任意两颗多核芯片相距一跳或两跳。访问远程多核芯片的缓存,无论取回数据还是使数据失效,都要先经过芯片间互连的一跳或两跳,再经过芯片内部互连;若取回数据,还需类似的返回路径。图中 AMD EPYC 为全连接的四芯片、32 核结构,每个 CCX 有四核;它是每插槽 64 核、最多两插槽系统的构建单元。Infinity Path(IFOP)链路将四颗多核芯片全连接;未使用的 IFOP 链路各可连接另一个 32 核模块。
图中文字:4-chip group 为四芯片组;Intra-group Bus 为组内总线,78.4 GB/s;Inter-group Cable 为组间电缆,25.6 GB/s;上部标题为“最多 16 芯片的 Power8 系统”,中部标题为“最多 8 芯片的 Xeon E7 系统”。CCX、IFOP 为原图标识符。
译注: 本图图注使用 Power10、Xeon Platinum,图内则明确标为 Power8、12-core Power8 和 Xeon E7,存在版本标注不一致。EPYC 的 chiplet 数量在本节表格、正文与图注中也有不同配置表述;原文分别保留。
多核多处理器运行多道程序工作负载时的性能
先用 SPECintRate 比较三种多核处理器的性能可扩展性,最大配置采用提交给 SPEC 的最大单系统配置,核心数为 128–220。图 5.28 相对于最小的 15 核或 16 核配置绘制性能,并假定该配置分别实现理想的 15 倍或 16 倍加速。这幅图没有比较不同处理器之间的性能。例如,16 核 AMD EPYC 的性能是 Intel Xeon 的 1.14 倍。图 5.28 只展示各处理器家族增加核心后,性能如何扩展。
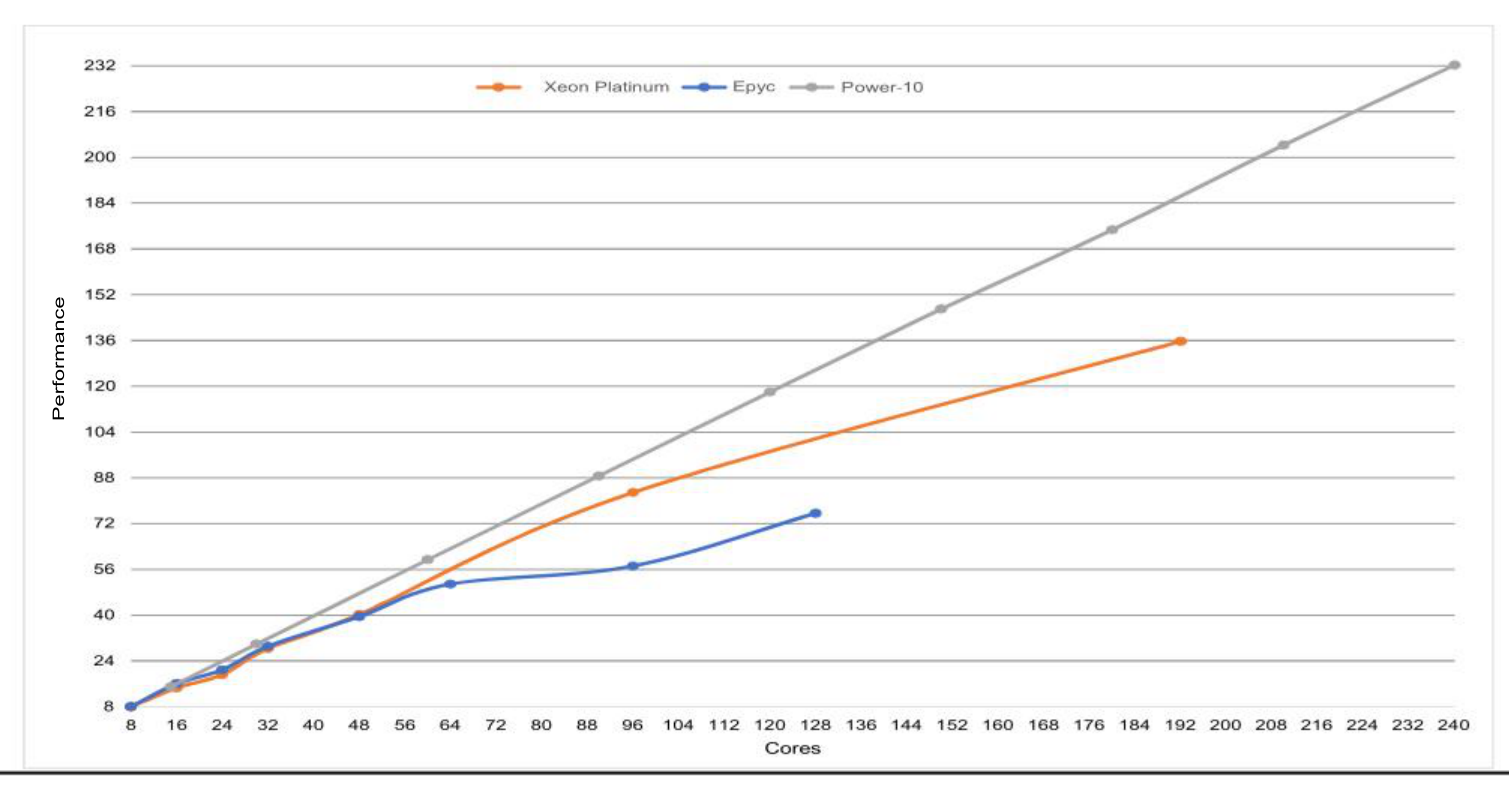
图 5.28(续)。 Intel、AMD 的性能相对于 16 核配置绘制,IBM 则相对于 15 核配置,并假定最小配置已经获得理想加速比。图中显示某种多处理器增加核心后的扩展情况,没有提供不同处理器之间的性能比较。注意,即使假定 16 核处理器实现理想加速,当核心数较多时,AMD 和 Intel 的实际加速比也只有理想值的约 50%–60%。IBM 的扩展情况好得多:在 220 核时,相对于 15 核版本达到 97% 的效率。由于扩展更好、每核心性能也略高,210 核 Power10 的吞吐量是 240 核 Xeon Platinum 的 1.3 倍,每核心性能约高 50%;我们估计,其中 70%–80% 的优势来自更高的核心性能,20%–30% 来自扩展到更多核心时的更好表现。由于已公布数据的可得性及核心配置不同,Intel、AMD 的测量结果可能取自略有不同的处理器配置。横轴为核心数,纵轴为性能。
随着核心数增加,AMD 和 Intel 系统的加速效果都减弱。例如,240 核 Xeon 系统相对于 16 核系统的加速比为 157.8,而非 240。
相对于八核结果,这意味着约 70% 的效率;当然,八核系统相对于单核也不太可能实现理想加速。AMD EPYC 在核心较少时更快,但到 64 核时遇到性能限制。这些限制既可能来自系统问题,也可能来自体系结构。在 128 核时,EPYC 相对于 16 核版本的效率约为 66%。按相对于最小配置的加速比衡量,IBM Power10 的可扩展性最好,220 核时效率为 97%。SPECintRate 不大受缓存一致性问题影响,因此内存和互连带宽很可能起到重要作用。
译注: 原书在本段及图 5.28 中混用了若干核心数与归一化基准。例如正文先以 16 核为基准,随即又称与八核比较;图中 Power10 曲线终点约为 240 核,而图注与正文讨论 220 核。原文个别位置将 Xeon 拼为 Xenon,此处产品名统一为 Xeon。
Xeon Platinum 在两种不同工作负载下的可扩展性
接下来简要考察 Xeon Platinum 多处理器运行科学并行计算工作负载,以及基于 Java 服务器的工作负载时的可扩展性;后一种测试同时测量性能和功率。
SPEComp2012 包含 14 个采用 OpenMP 共享内存并行标准编写的科学与工程程序。程序用 Fortran、C 和 C++ 编写,覆盖流体动力学、分子建模及图像处理等领域。不同于 SPECintRate,这些程序的进程会经常通过共享地址空间通信。与前一组结果一样,图 5.29 假定最小的 28 核配置实现线性加速。到 72 核为止,相对于 28 核系统,较小配置可以实现线性加速;92–108 核时效率降至约 90%,随后在 172–220 核时降至约 50%。
最后用 SPECpower2008 比较 Xeon 系统的性能与能效。SPECpower 模拟运行多个 Java 流的服务器,会执行 Java 虚拟机、垃圾回收和即时(JIT)编译器。工作负载随系统规模扩展,模拟实际服务器。测试报告 10%–100% 负载下的性能与功率。100% 表示系统在满足服务质量保证的前提下能处理的最大负载,并随计算机能力调整,即更大的配置运行更大的工作负载。图 5.30 展示 28–224 核在最大负载下的吞吐量增长及能效,后者为性能除以平均功率。对于这种高度并行、随规模扩展的基准测试,Xeon Platinum 从 28 核扩展到 224 核,基本实现理想加速。初看图表,也许会以为 224 核时能效急剧下降;请仔细观察坐标并阅读图注。
SPECpower 还测量从空闲到 100% 负载的平均功耗,以衡量能效。图 5.31 给出 224 核 Xeon Platinum 的结果。注意,在 50% 负载下,系统平均功耗为满载时的 60%,因此相对能效约为 85%。
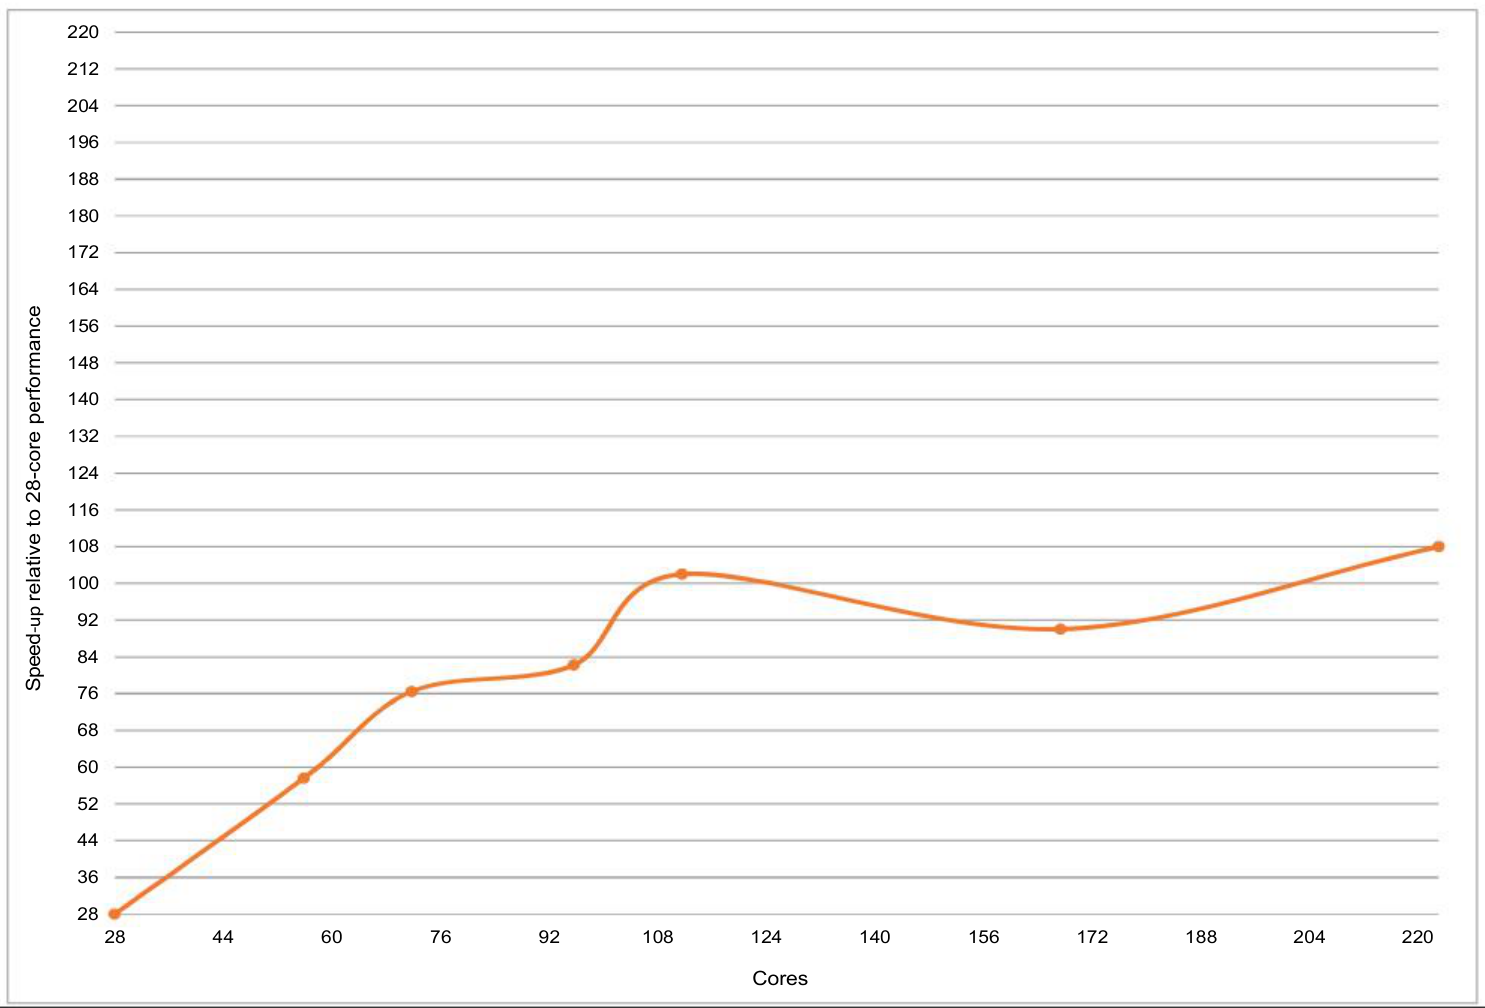
图中横轴为核心数,纵轴为相对于 28 核性能的加速比,按正文所述把 28 核配置标为 28。
观察 SPECpower 时,要记住它由许多独立任务组成,而且任务数随处理器规模增加。因此,与并行任务交互更多,或工作负载不随规模增加的情况相比,它获得的性能提升要好得多。例如 SPECintRate 虽然也主要由独立任务组成,扩展效果仍只有理想值的 60%–70%;SPECOMP 扩展到大量核心时,效率约为 50%。附录 I 更详细地讨论扩展及其对应用和性能的影响。
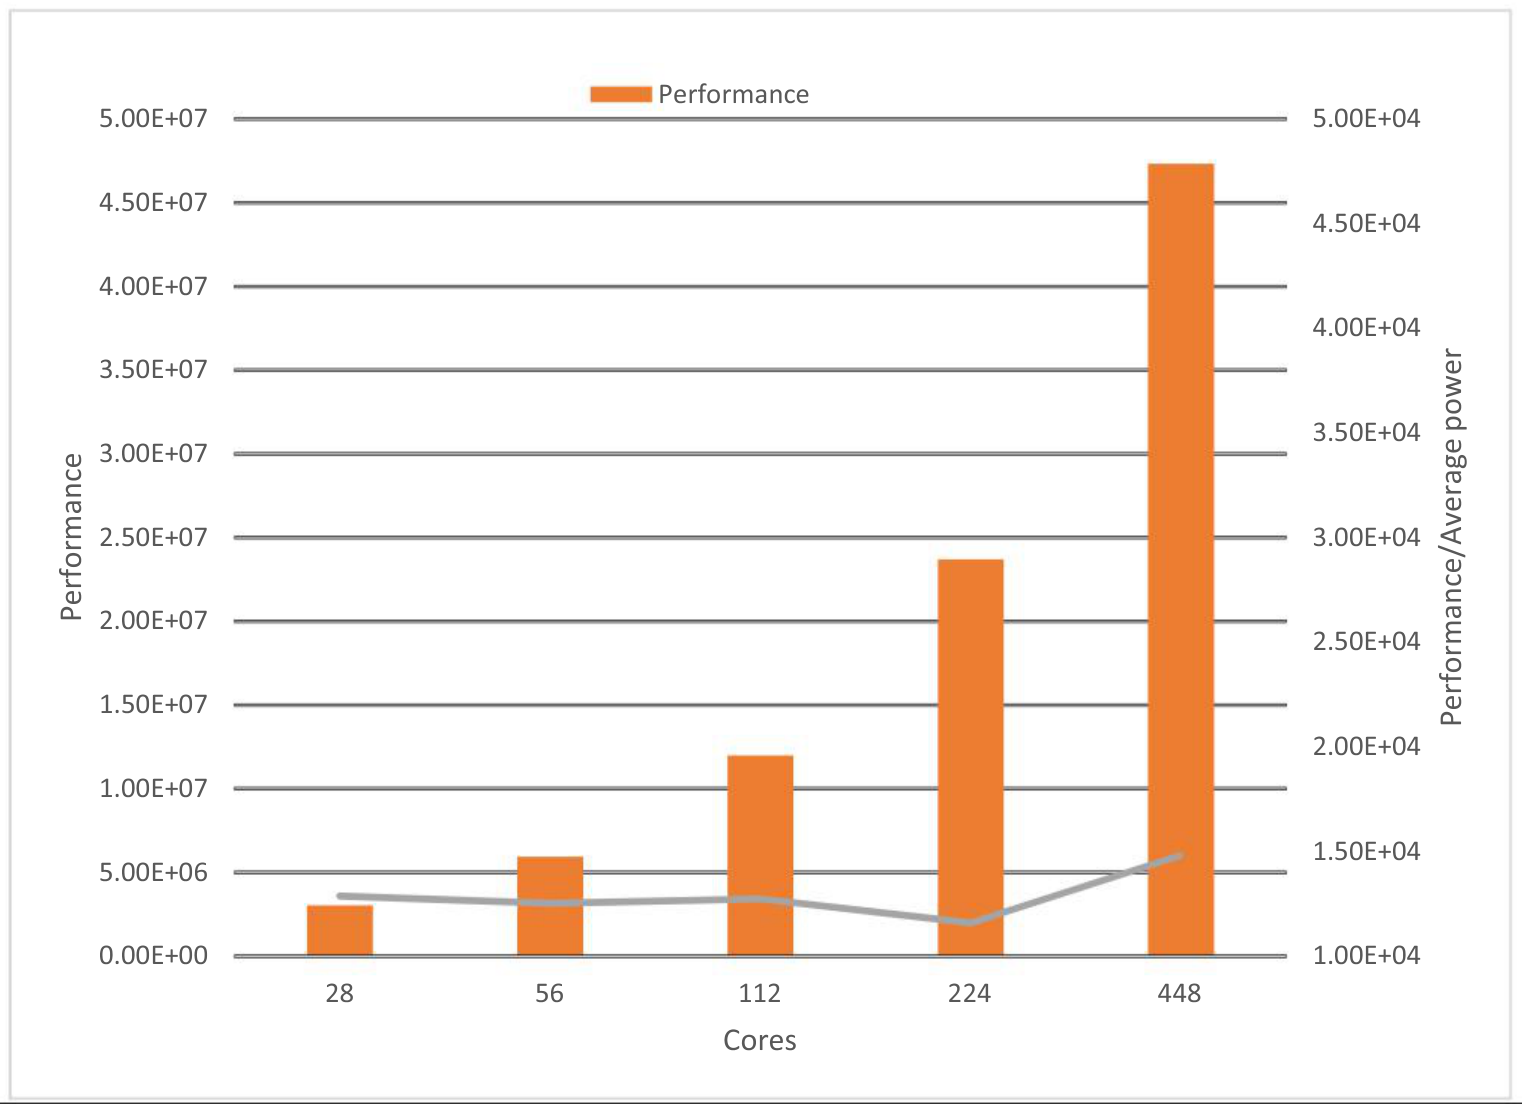
图 5.30(续)。 吞吐量取最大工作负载下的 ss_jops,使用左侧纵轴。相对于 28 核版本,56、112、224、448 核版本的吞吐量效率为 99%–100%。折线表示能效,单位见右侧纵轴。整个核心数范围内,能效变化只有几个百分点。灰色:性能/平均功率。横轴为核心数,橙色柱为性能。
译注: 正文讨论到 224 核,图及图注还包含 448 核。图注所称能效仅变化“几个百分点”也应结合右轴实际范围阅读:右轴从 起,并非从零开始。
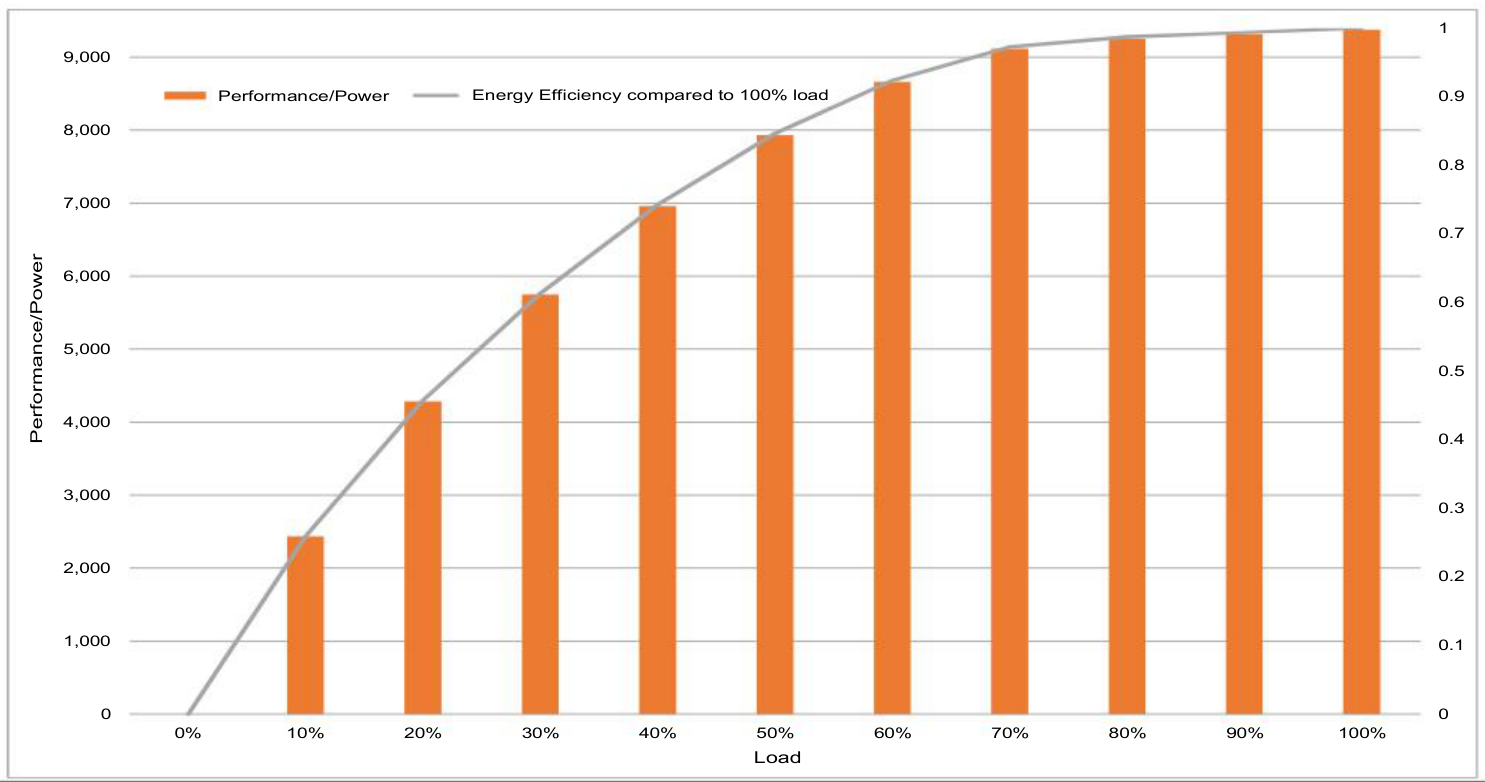
图 5.31(续)。 柱形图按左轴绘出性能/功率;折线按右轴绘出相对于满载系统的效率,即性能/功率的相对值。负载不超过峰值 30% 时,能效不到满载系统的 65%;负载达到峰值 70% 或更高时,能效至少为满载系统的 97%。横轴为负载。