5.9 谬误与陷阱
以我们目前对并行计算的理解来看,仍有许多潜在陷阱,有的将由谨慎的设计者发现,有的则会让不幸的设计者付出代价。多年来围绕多处理器的大量炒作,也产生了许多常见谬误。这里选取其中一部分。
陷阱:用线性加速比而非执行时间衡量多处理器性能
图 5.28、5.29 这类绘制性能与处理器数量关系的曲线,会依次出现线性加速、平台期和下降,长期以来人们用它们判断并行处理器是否成功。加速比虽然反映并行程序的一个方面,却不是性能的直接度量。首先要看所扩展处理器本身的能力:一个能够线性扩展到 100 颗 Intel Atom——用于上网本的低端处理器——的程序,仍可能比运行在八核 Xeon 上的版本慢。对于浮点密集型程序尤其要小心:没有硬件辅助的处理单元可能扩展得很好,整体性能却很差。同样,像 SPECpower 这样的基准测试,包含大量独立并行任务,并随多处理器规模扩大问题规模,也能达到很高的效率。
只有比较各计算机上的最佳算法时,执行时间的比较才公平。在两台计算机上运行完全相同的代码,看起来公平,实际上未必如此:并行程序在单处理器上可能比串行版本更慢。开发并行程序有时会带来算法改进,因此,把原先已知最好的串行程序与并行代码比较,虽然看似公平,比较的却不是等价算法。为体现这种区别,有时使用“相对加速比”(relative speedup,同一程序)和“真实加速比”(true speedup,最佳程序)两个术语。
若结果显示超线性性能,即程序在 个处理器上运行,比等价单处理器快 倍以上,可能说明比较不公平;不过,确实也有“真实”的超线性加速。例如,一些科学应用在处理器数量小幅增加时,从 2 或 4 个增加到 8 或 16 个,经常出现超线性加速。这往往是因为,关键数据结构放不进 2 或 4 个处理器的缓存总容量,却能放进 8 或 16 个处理器的缓存总容量。
总的来说,用加速比比较性能,最好也只能说需要十分谨慎,最坏则会误导。正如上一节所见,两个不同多处理器的加速比并不一定能说明它们的相对性能。即使是在同一多处理器上比较两种算法,也需要谨慎:必须采用真实加速比,而非相对加速比,才能得到有效比较。
陷阱:认为 Amdahl 定律不适用于并行计算机
1987 年,一位研究机构负责人宣称,某种 MIMD 多处理器已经打破 Amdahl 定律,见 1.9 节。但这绝不意味着该定律对并行计算机失效:程序中未获改进的部分仍会限制性能。要理解当时媒体报道的依据,不妨看看 Amdahl(1967)的原话:
此时可以得出一个相当明显的结论:除非串行处理速度也取得几乎同等幅度的进展,否则为实现高并行处理速度付出的努力将是徒劳的。〔第 483 页〕
对这一定律的一种解释是:每个程序都有必须串行执行的部分,所以具有经济价值的处理器数量存在上限,例如 100 个。在 1000 个处理器上实现线性加速,推翻的是对 Amdahl 定律的这种解释。
所谓“克服” Amdahl 定律,其依据是采用扩展加速比,也称弱扩展(weak scaling)。研究者将基准测试的数据集扩大到原来的 1000 倍,再比较扩大规模后的基准测试在单处理器与并行系统上的执行时间。对于这一特定算法,串行部分为常量,与输入规模无关,其余部分完全并行,因此能在 1000 个处理器上获得线性加速。由于运行时间的增长快于线性,扩大规模后的程序即使用 1000 个处理器,实际运行时间仍更长。
假定输入规模随之扩大的加速比,不等于真实加速比;把它当成真实加速比报告,会产生误导。并行基准测试经常运行在规模不同的多处理器上,所以必须说明允许怎样扩展应用,以及如何扩展。简单地让数据规模与处理器数量成比例,通常并不合适;但当处理器数量增加很多时,仍假定问题规模固定,即强扩展(strong scaling),往往也不合适,因为用户拥有大得多的多处理器后,很可能会选择运行规模更大或细节更丰富的应用。附录 I 进一步讨论这一重要问题。
陷阱:认为只有线性加速才能让多处理器具有成本效益
人们普遍认可,并行计算的主要优势之一,是比最快的单处理器更早得到结果。然而,许多人也认为,除非实现完美的线性加速,否则并行处理器的成本效益无法与单处理器相比。
其论点是:多处理器成本与处理器数量呈线性关系,所以只要加速比低于线性,性能/成本比就会下降,并行处理器就不如单处理器合算。
这一论点的问题在于,成本不仅取决于处理器数量,还取决于内存、I/O 和系统开销,例如机箱、电源、互连等。在每颗芯片含多个处理器的多核时代,这种说法更站不住脚。
Wood 和 Hill(1995)指出了将内存计入系统成本的影响。我们用较新的 TPC-C 和 SPECrate 数据举例;使用并行科学应用工作负载也可以论证同一点,而且结论很可能更有力。
图 5.32 给出 IBM eServer p5 多处理器配置 4–64 个处理器时,TPC-C、SPECintRate 与 SPECfpRate 的加速比。只有 TPC-C 超过线性加速。SPECintRate 和 SPECfpRate 的加速比低于线性,但成本增长也低于线性,因为与 TPC-C 不同,它们所需主存和磁盘的增长均低于线性。
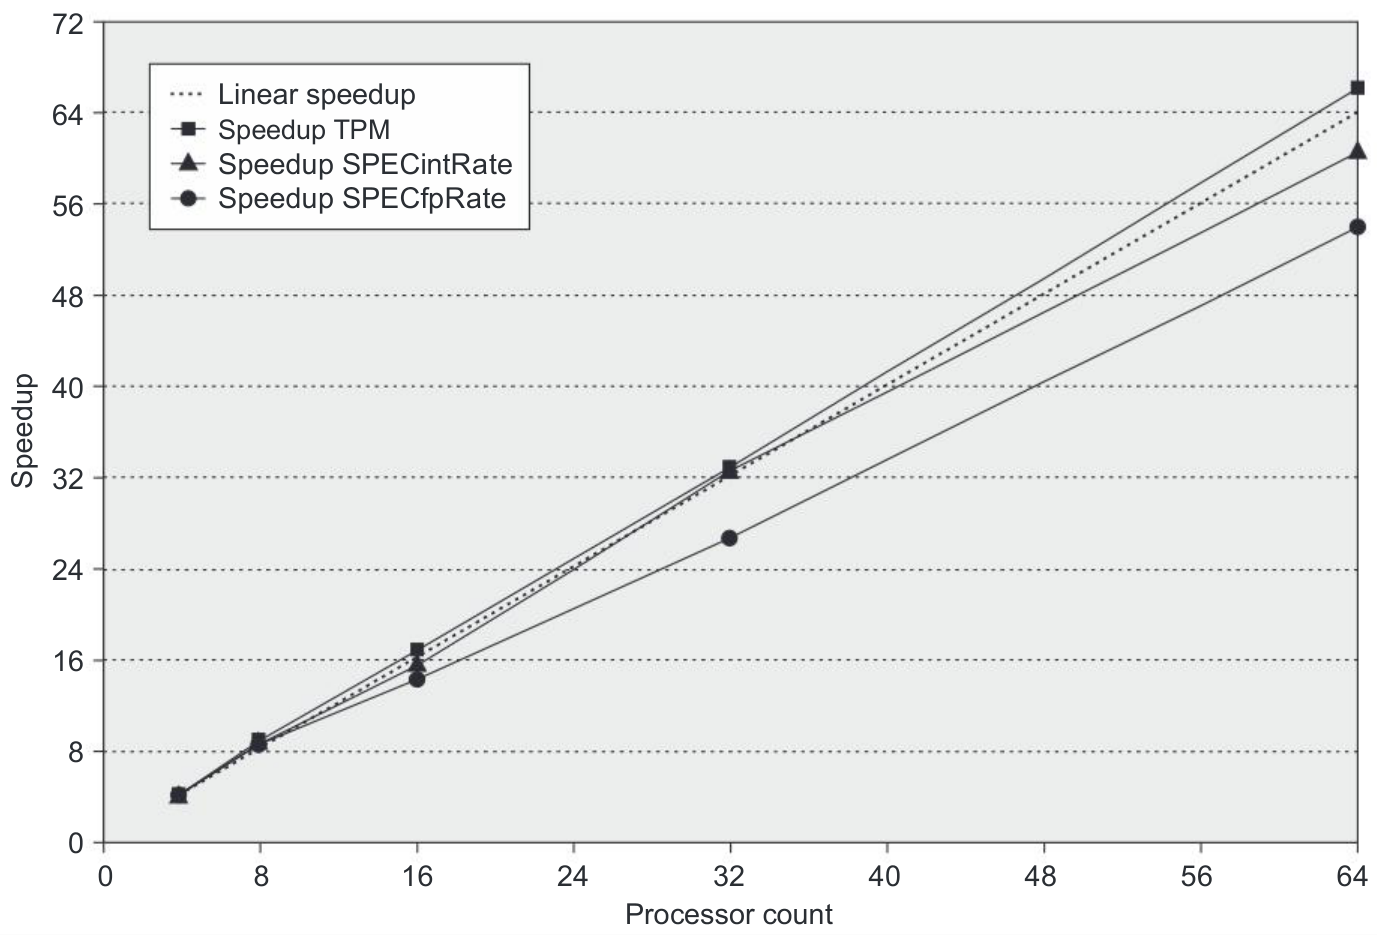
图中横轴为处理器数量,纵轴为加速比;三条测量曲线依次为 TPM、SPECintRate、SPECfpRate 的加速比。
如图 5.33 所示,更多处理器可能比四处理器配置更具成本效益。比较两台计算机的性价比时,必须准确估计系统总成本及可达到的性能。对于许多内存需求较大的应用,这样的比较会显著增加多处理器的吸引力。
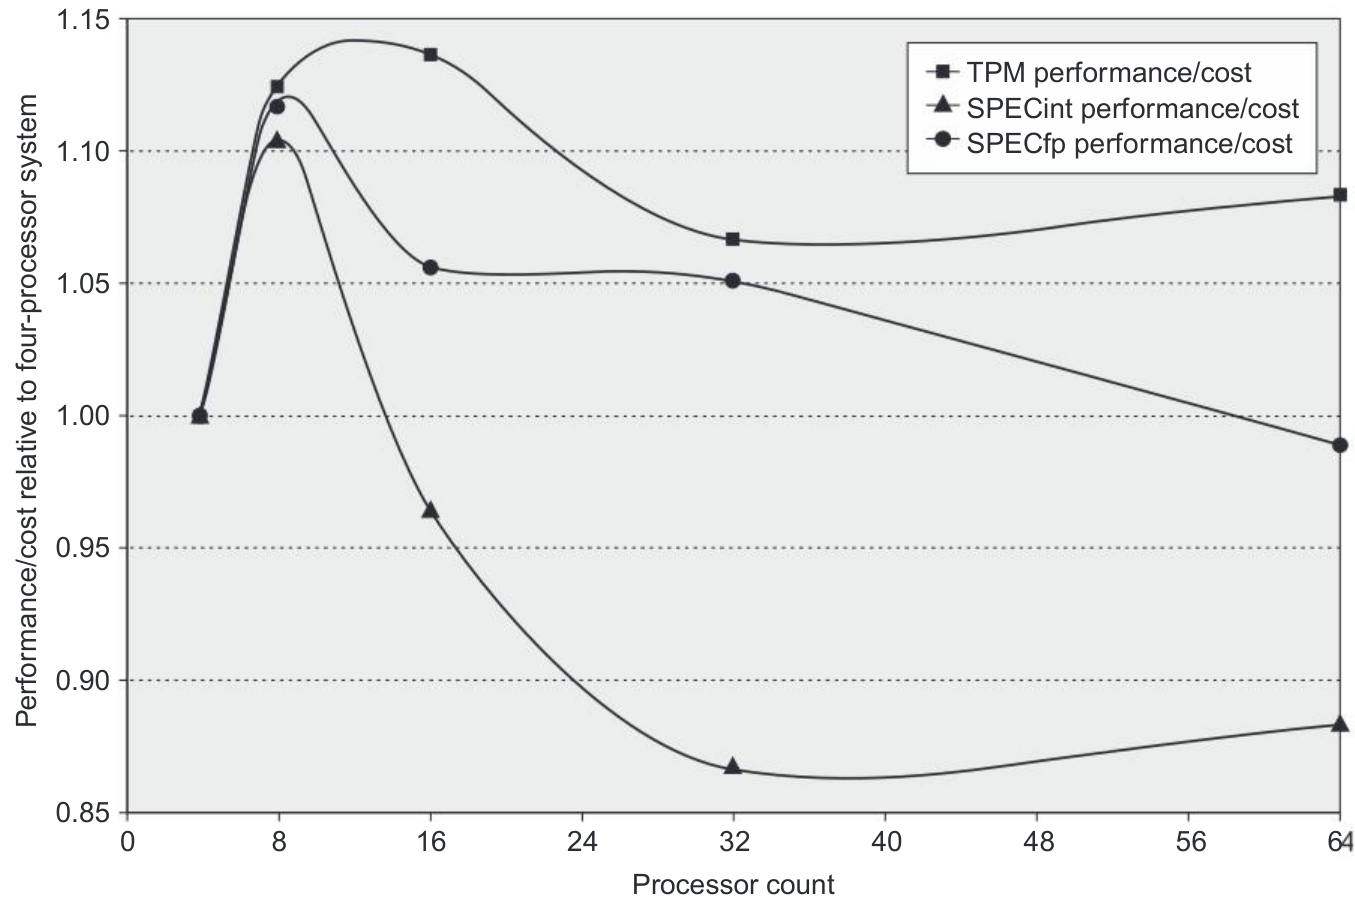
图 5.33(续)。 大于 1.0 的测量值表示该配置比四处理器系统更具成本效益。八处理器配置对三种基准测试均有优势;16 和 32 处理器配置则有两种基准测试显示性价比优势。TPC-C 使用正式测试的配置,所以磁盘和内存几乎与处理器数量线性增长,64 处理器系统的成本约为 32 处理器系统的两倍。相比之下,SPECrate 的磁盘和内存增长较慢,虽然仍快于 64 处理器时获得最佳 SPECrate 所必需的增长。具体而言,磁盘从四处理器版本的一块,增加到 64 处理器版本的四块,共 140 GB;内存从四处理器系统的 8 GiB 增加到 64 处理器系统的 20 GiB。横轴为处理器数量,纵轴为相对于四处理器系统的性能/成本;三条曲线分别为 TPM、SPECint、SPECfp 的性能/成本。
陷阱:没有开发能利用多处理器体系结构、或针对它优化的软件
多处理器软件长期落后于单处理器软件的发展,可能是因为问题难得多。可以选择的例子很多,这里举一个,说明问题有多微妙。
常见问题出现在将单处理器软件改用于多处理器环境时。例如,2000 年 SGI 的操作系统最初用一把锁保护整个页表数据结构,因为设计者假定页面分配并不频繁。在单处理器上,这不会造成性能问题;在多处理器上,却可能成为某些程序的主要瓶颈。
考虑一个使用大量页面、并在启动时初始化这些页面的程序;UNIX 对静态分配的页面就会这样做。假定程序已经并行化,由多个进程分配页面。页面分配要使用页表,而页表每次使用时都会加锁,因此即使操作系统内核支持多个线程,只要各进程同时尝试分配页面——初始化时完全可能如此——也会被串行化。
页表操作串行化消除了初始化阶段的并行性,显著影响整体并行性能。即使采用多道程序,这个瓶颈仍存在。例如,把并行程序拆成彼此独立的进程,每个处理器运行一个,进程间完全不共享数据。有位用户确实这样做过,因为他合理地怀疑,性能问题来自应用中意外的数据共享或相互干扰。不幸的是,那把锁仍使所有进程串行化,所以多道程序的性能也很差。
这一陷阱说明,软件在多处理器上运行时,会出现微妙却严重影响性能的问题。与许多关键软件组件一样,操作系统的算法和数据结构也必须放在多处理器环境中重新考虑。把锁的保护范围缩小到页表的较小部分,就能有效消除这一问题。存储结构中也存在类似问题,即使实际上没有共享数据,也会增加一致性流量。
当多核成为从桌面到服务器的主流方向后,并行软件投入不足的问题逐渐显现。由于此前缺少足够关注,软件系统很可能还要经过多年,才能充分利用不断增加的核心数。