案例研究与习题
作者:Amr Zaky。
案例研究 1:单芯片多核多处理器
本案例阐释以下概念:
- 监听一致性协议的状态转换与操作。
- 监听一致性协议的性能。
- 监听一致性协议的实现优化。
- 同步及其对缓存一致性支持的利用。
事务记法
本案例采用如下记法:
Pi, r/w, Mj 表示处理器核心 i 读/写内存块 j。例如,P2, r, M3 表示处理器核心 2 读取内存块 3。
缓存配置与策略
案例中的 L1、L2 都采用直接映射、写回、写分配策略。假定 L2 包含与之相连的各 L1 缓存。所有 L1 和 L2 缓存的缓存行大小相同,且等于一个内存块的大小。
一致性协议
采用 5.3 节中的写失效监听协议,状态为 M、S、I。
内存分布与寻址
习题 5.1
[20]〈5.3〉 图 5.35 是一个四处理器 SMP。每个处理器核心有私有 L1,所有核心共享 L2;缓存配置和策略见案例引言。
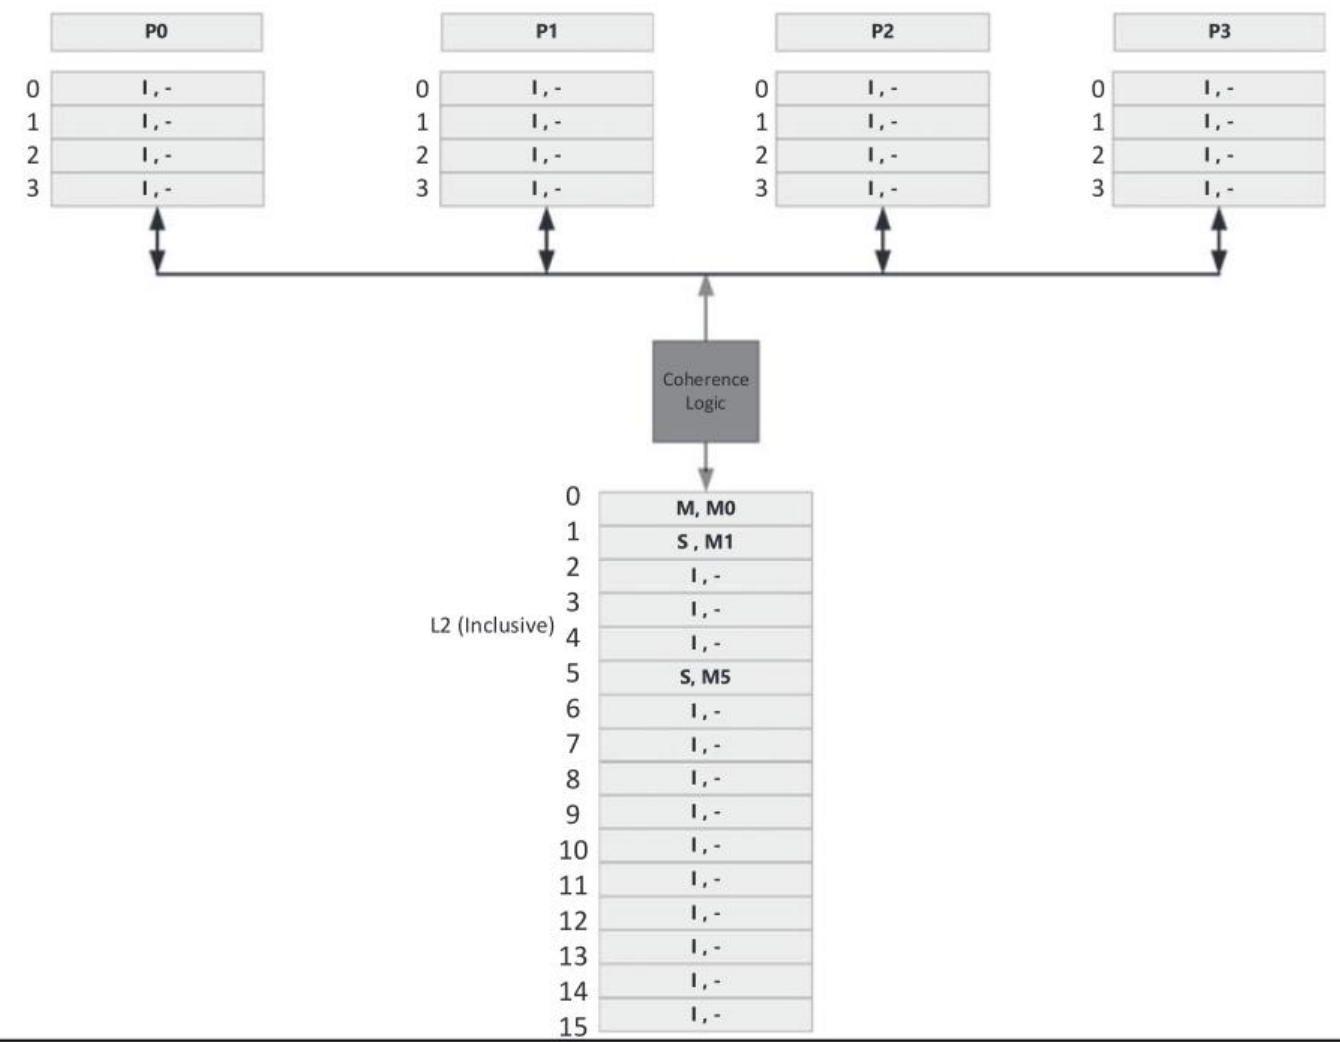
图中 Coherence Logic 为一致性逻辑,L2(Inclusive)为具有包含性的 L2。P0–P3 的四个 L1 表项均为 I;L2 有 16 项,其中 0 项为 M、M0,1 项为 S、M1,5 项为 S、M5,其余为 I。
L2 缓存行的初始状态和数据见图。L2 块表项中的 Mi 表示该项缓存了内存块 i。
- 对下面依次发生的内存读写,描述缓存行状态的变化,以及缓存和监听逻辑采取的操作。序列中 x || y 表示操作 x 之后执行操作 y;Mi 表示物理内存块 i。
习题 5.2
[30]〈5.3〉 图 5.36 给出所用监听协议的一种实现中,各操作的延迟,单位为处理器周期。
| 访问 | 处理器周期 | 用途 |
|---|---|---|
| L1 标签访问 | 1 | L1 读/写命中;未命中的第一个周期;来自一致性逻辑的监听查询 |
| L1 数据访问 | 1 | L1 读,与标签访问并行;L1 写 |
| L2 标签访问 | 6 | L1 未命中 |
| L2 数据访问 | 12 | L1 写回、L1 重填 |
| 一致性逻辑访问 | 1 | L1 未命中;L1 升级未命中,即失效操作;L1 对一致性逻辑的响应 |
图 5.36 附注。 标签访问与读数据访问并行进行;读未命中时,丢弃读出的数据。写操作则必须等标签访问确认写命中后,才能访问数据阵列,因此写命中需要两个周期。这里假定时钟周期过短,无法在一个周期内先后完成标签访问和数据访问。
示例。 若某内存块在 P2 的 L1 中处于已修改状态,P1 对它写未命中的延迟如图 5.37 所示。
| 步骤 | 延迟 |
|---|---|
| P1 标签访问 | 1 周期 |
| P1 未命中,发出失效请求 | 1 周期 |
| 一致性监听查询 P2 及所有核心的标签 | 1 周期 |
| P2 写回 L2 | 12 周期 |
| L2 重填 P1 | 12 周期 |
| 合计 | 27 周期 |
假定总线上的处理器能在一个周期内报告它们相对于待失效缓存行的状态:L1 命中共享行、L1 命中已修改行,或 L1 未命中。
- 计算习题 5.1 的读写序列总共需要多少延迟周期。
习题 5.3
[10/10]〈5.3〉 假定一个缓存行恰好容纳数组 A 的一个元素,且数组 A 完全位于 L2 中,但不在 P0 的 L1 中。
- 上述 for 循环每次迭代的两次内存访问需要多少周期?
- 如果协议由 MSI 改为 MESI,这些内存访问需要多少周期?
习题 5.4
[15]〈5.3〉 为进一步研究 MSI、MESI 的性能,解释为什么使用 MSI 时,下列两个循环的数据访问需要不同的周期数,而使用 MESI 时,周期数应不会有明显差异。假定 A[i] 最初不在 L1 中,但整个数组 A 都在 L2 中。
习题 5.5
[15/15]〈5.3〉 考虑以下内存读写序列:
假定访问的内存块都不在 L1 中,但全部在 L2 中。
- 计算上述读写序列的总延迟周期数。
- 如果处理器核心可以直接向另一核心提供数据,而不必等待 L2 提供,计算总延迟周期数。假定一个处理器的 L1 向另一个 L1 传送数据需要 4 周期。
现在采用图 5.38 中另一种 L2 结构。每两个核心共享一个私有 L2,该 L2 包含与之连接的核心的 L1。还假定 LLC 包含两个 L2。L1 缓存行未命中由 L2 提供服务,除非 L2 也未命中;此时从 LLC 取得该行,而 LLC 可能还要从内存获取。从 LLC 取回的缓存行先写入 L2,再传给请求它的 L1。如果存在一致性逻辑,这一过程通常需要执行一致性操作;如果其他缓存,包括 L1、L2 或 LLC,已有该行,还可能需要改变其状态。
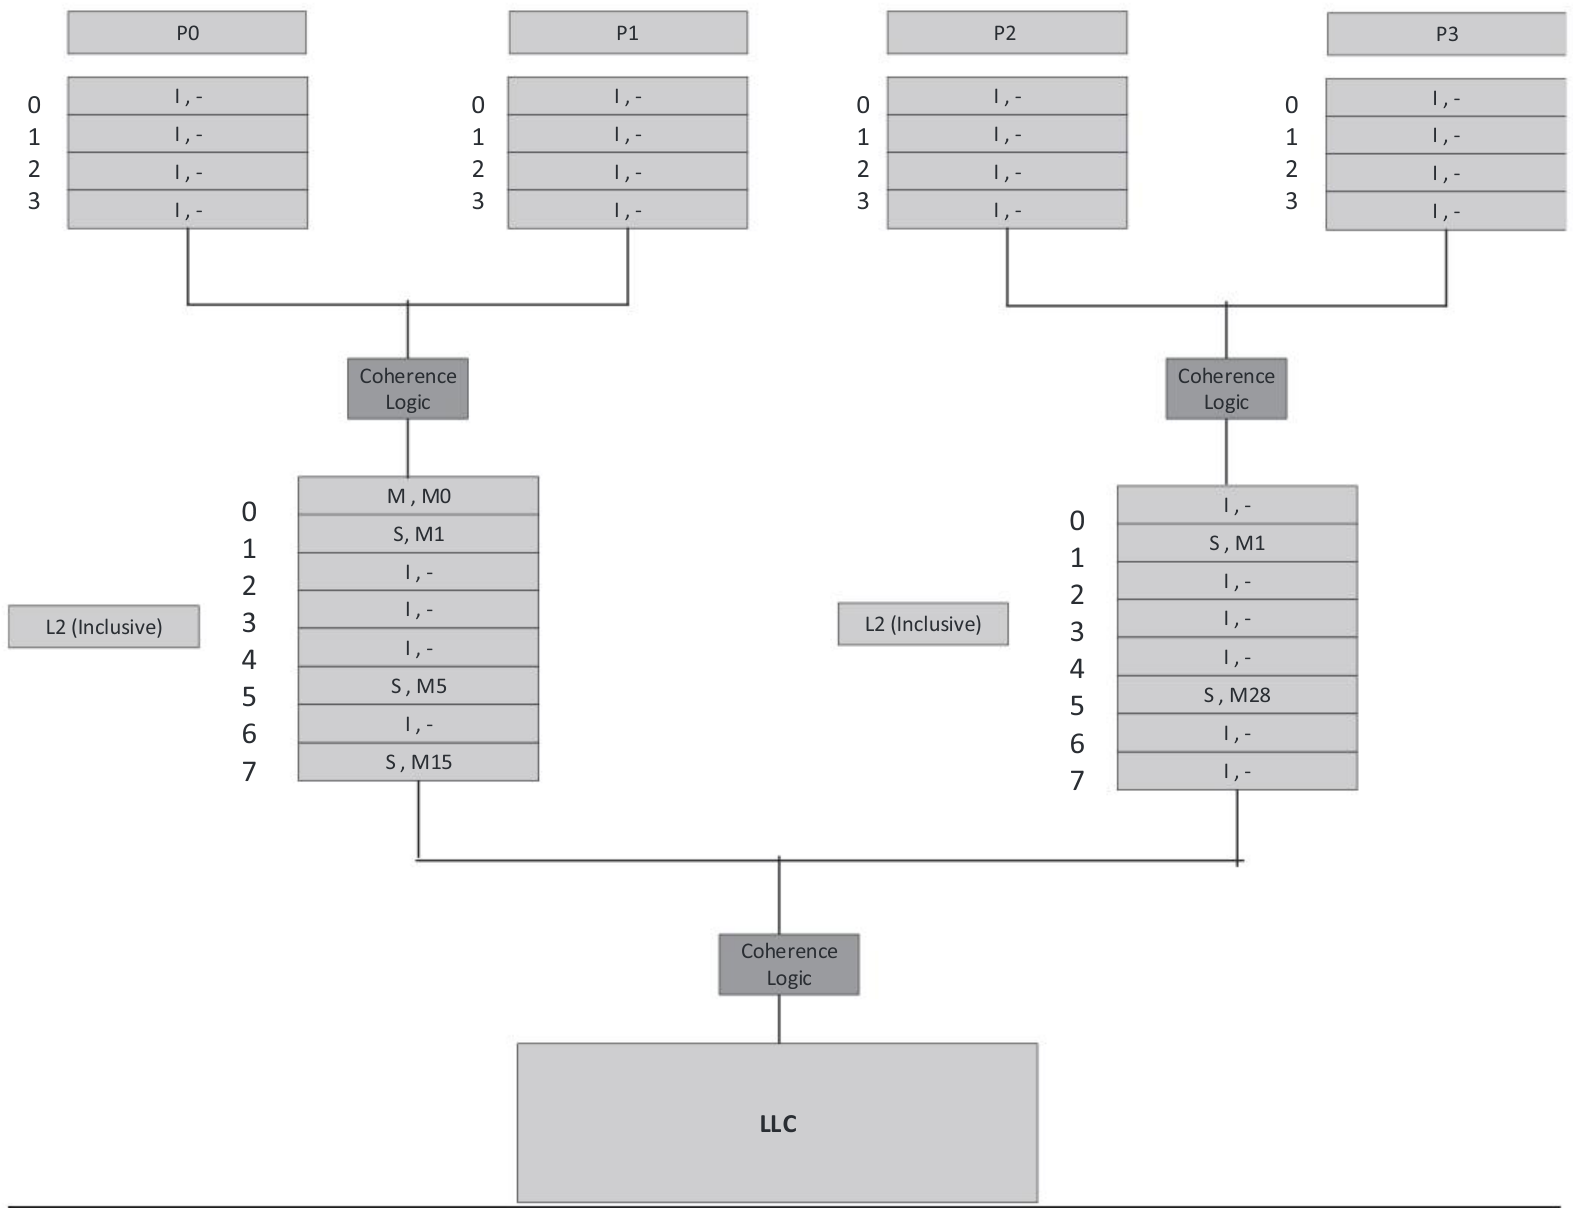
图中 Coherence Logic 为一致性逻辑,L2(Inclusive)为具有包含性的 L2,LLC 为末级缓存。四个 L1 最初均为 I。左侧 L2 的 0、1、5、7 项分别为 M、M0;S、M1;S、M5;S、M15,其余为 I。右侧 L2 的 1、5 项分别为 S、M1 和 S、M28,其余为 I;状态与块号按原图保留。
习题 5.6
[20]〈5.3〉 讨论新配置的监听协议实现。例如,对内存块 M38 的访问在 L1、L2 都未命中后,P0 的 L1 和 P0/P1 的 L2 将处于什么状态?我们也许会想完全省去 L1 一致性逻辑,即 L1 与 L2 之间的逻辑,只使用 L2 与 LLC 之间的一致性逻辑;但实现 L1/L2 一致性逻辑可以创造一些性能优化机会。请举例说明。
习题 5.7
[10]〈5.3〉 解释为什么在 L2 中采用 MESI,同时在 L1 中采用 write-once 协议,可以减少这一配置的一致性流量。write-once 策略在首次写某缓存行时按直写缓存工作,后续写则按写回缓存工作。
习题 5.8
[20]〈5.3〉 假定采用 MSI,计算以下访存序列的读写总延迟周期数。
习题 5.9
[20]〈5.5〉 下面给出 5.5 节讨论的两种自旋锁循环实现。
实现一:
实现二,按原页排列:
- 当 P0、P1 竞争 P2 持有的锁时,分别给出两种实现中自旋锁循环的时序。
译注: 原页第二段确有连续两条相同的 bnez,且 EXCH 之后没有分支;这里未擅自移动指令。请结合 5.5 节的 test-and-test-and-set 循环理解其意图,原题代码本身存在排列疑点。
案例研究 2:简单的目录一致性
本案例阐释以下概念:
- 目录一致性协议的状态转换。
- 一致性协议的性能。
- 一致性协议的优化。
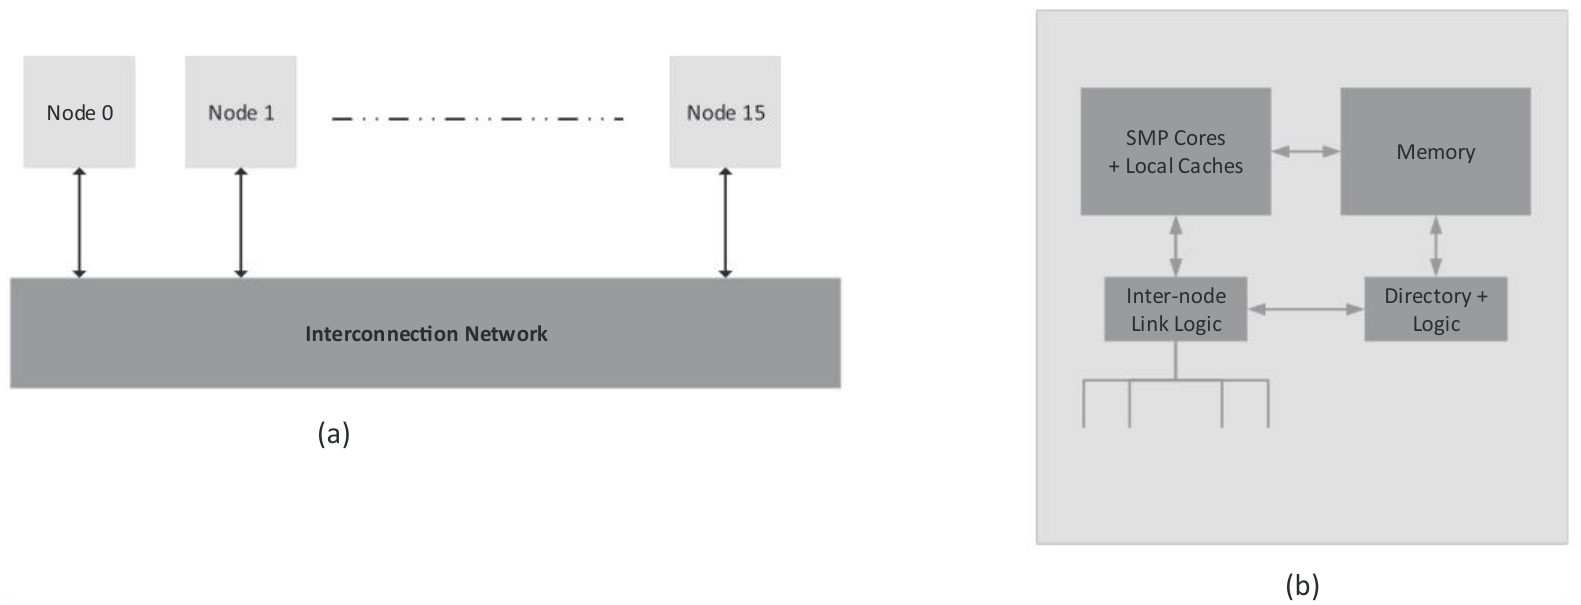
图 5.39(续)。 考虑图(a)中的分布式共享内存系统:16 个处理器核心节点连接到互连网络 IN。图(b)给出节点内部结构,允许每个节点含多个以 SMP 方式连接的核心;开始时可以先假定每节点只有一个核心。如果有多个核心,则可假定它们通过监听维护彼此间的一致性。Node 为节点,Interconnection Network 为互连网络,SMP Cores + Local Caches 为 SMP 核心及本地缓存,Memory 为内存,Inter-node Link Logic 为节点间链路逻辑,Directory + Logic 为目录及其逻辑。
一致性协议
采用 5.4 节中的目录式写失效协议,状态为 M、S、I。
内存分布与寻址
内存均匀分布在各节点上。内存块地址的最高 4 位表示该内存所在的节点编号。除非题目另有说明,否则不指定内存块大小及分布式内存中的块数。
事务记法
本案例采用以下记法:
Ni, r/w, M(m, n) 表示处理器节点 i 读/写位于节点 m 的内存块 n。例如,N2, r, M(3,7) 表示节点 2 读取节点 3 的内存块 7。
缓存配置与策略
案例中的 L1、L2 等缓存都采用直接映射、写回、写分配策略。假定每级缓存包含更靠近处理器的各级缓存。所有缓存的缓存行大小相同,且等于一个内存块的大小。
习题 5.10
[20]〈5.4〉 假定所有缓存块最初均无效。对以下依次发生的访存,描述缓存行状态变化、目录控制器采取的操作,以及交换的一致性消息。x || y 表示操作 x 之后执行操作 y。
习题 5.11
[5/10]〈5.4〉 假定每节点分配 1 GiB 分布式内存,内存块为 128 字节。
a. 描述一种直接的节点目录数据结构布局,计算实现它所需的总位数,并计算目录容量占内存容量的百分比。
b. 使用 a 中的布局,画出节点 1 的目录内容。提醒:所有目标为 M(1, *) 的访问都会访问节点 1 的目录。
习题 5.12
[5/5/5]〈5.4〉 为缩小目录,可以采用下面一种或两种结构调整:
- 让每个目录项记录比一个块更大的内存区域的一致性状态,从而减少目录项数。
- 让目录项记录一组节点而非单个节点的内存使用情况,从而缩小每个目录项。
a. 若每项记录 4 KiB 内存的使用情况,每节点分配 1 GiB 分布式内存,目录有多少项?
b. 若将 16 节点分为四组、每组四节点,目录项记录一组节点而非单个节点对内存块的所有权,一个目录项有多大?
c. 同时采用上述两种优化,目录有多大?
习题 5.13
[15/5]〈5.4〉 考虑案例习题 5.11 的直接目录实现,画出执行 MSI 所需的一组一致性消息。应提供足够细节,明确地址、源/目标节点、数据和命令。
a. 画出各类消息的字段,按位计算每类消息的大小。
b. 重做 a;必要时增加填充位,使消息长度为整数字节。
习题 5.14
[10/10/10/10/5]〈5.4〉 习题 5.12 的目录容量优化,会以执行目录一致性协议所需消息数增加为代价。用下面的访存序列比较不同优化下交换的消息数。
a. 未优化目录容量,即采用 5.11 的实现时,描述采取的操作和交换的一致性消息。
b. 采用 5.12a 的修改,每个目录项管理 4 KiB 内存块时,描述采取的操作和交换的一致性消息。
c. 采用 5.12b 的修改时,描述采取的操作和交换的一致性消息。四组分别为 G0:N0、N1、N2、N3;G1:N4、N5、N6、N7;G2:N8、N9、N10、N11;G3:N12、N13、N14、N15。
d. 同时采用 5.12a、b 时,描述采取的操作和交换的一致性消息。分组仍为 G0:N0、N1、N2、N3;G1:N4、N5、N6、N7;G2:N8、N9、N10、N11;G3:N12、N13、N14、N15。
e. 填写下表,对不同的一致性组节点数和每项管理的内存块大小,给出每节点目录位数,以及完成上述事务序列所交换的消息数。
| 每个一致性组的节点数 | 每项管理的内存块大小 | 每节点目录大小,位 | 上述事务序列交换的消息数 |
|---|---|---|---|
| 1 | 128 字节 | ||
| 1 | 4 KiB | ||
| 4 | 128 字节 | ||
| 4 | 4 KiB |
习题 5.15
[10]〈5.4〉 把 5.12c 的优化推到逻辑上的极端,可以完全省去节点目录,不再记录哪个节点使用哪个内存块。假定保留一部分目录逻辑,这种组成会需要大量一致性消息。即使消息开销如此之高,保留目录逻辑是否仍有价值?提示:假定任意节点 i 发往节点 j 的消息在互连网络中遵循确定路径,且按序处理;节点 i 和 j 都需要读或写节点 k 中的同一内存块。
案例研究 3:存储一致性
本案例阐释以下概念:
- 顺序一致性(SC)模型允许的程序行为。
- SC 模型允许的硬件优化。
- 用同步原语使一种一致性模型模拟约束更严格的模型。
习题 5.16
[10/5/5/]〈5.6〉 下列代码是两个处理器上运行的两个进程所使用的 Peterson 互斥算法。该算法旨在说明,不借助硬件同步原语也可以保证互斥。
初始条件:enter0, enter1 = false,即 P0、P1 最初都不希望进入临界区。
a. 证明,当两个进程都想进入临界区,且处理器遵循顺序一致性模型时,每次只能有一个进程进入临界区。
b. 给出一种符合 SC 的 P0、P1 读写顺序,使 P0 先于 P1 进入临界区。
c. 给出一种符合 SC 的 P0、P1 读写顺序,使 P1 先于 P0 进入临界区。
习题 5.17
[10]〈5.6〉 说明处理器实现释放一致性(RC)模型时,Peterson 算法不保证正确。给出一种符合 RC 的操作顺序,使进程 P1、P2 同时进入临界区。
译注: 原题写 P1、P2,前题代码中的两个进程则为 P0、P1;进程名不一致,按原题保留。
习题 5.18
[5/5/5]〈5.6〉 假定 a、b 初值均为 0。
a. 使用 SC 时,这两个进程可能打印哪些输出?
b. 将代码原样放在采用 RC 的系统上执行,两个进程可能永远无法越过 while 循环。解释原因。
c. 给出一种编译器代码重排,使 SC 系统上也可能出现 b 所述的效果。
译注: 原页没有标出 while 的空循环体或终止分号,print 的缩进也与 while 接近。
习题 5.19
[10]〈5.6〉 在 5.18 中,如果 P0 在 P1 将 b 置为 1 之前,就把 b 预取到自己的缓存,在 SC 系统上会产生意外结果吗?假定存在缓存一致性机制。
习题 5.20
[10/10]〈5.6〉 为习题 5.15 的互斥代码加入同步原语,使它在实现 RC 的系统上正确工作。
译注: 原题引用 5.15,但该题讨论目录;本页互斥代码实际属于 5.16。
习题 5.21
[20/20/20]〈5.6〉 顺序一致性要求所有读写看起来按某个全序执行。因此,在某些情况下,处理器提交读或写指令前必须停顿。考虑:
其中 write A 缓存未命中,read B 缓存命中。在 SC 下,处理器必须让 read B 等待,直到能给 write A 确定顺序并执行它。简单的 SC 实现会让处理器停顿,直到缓存收到数据、可以执行写。
较弱的一致性模型放宽读写顺序约束,减少必须停顿的情况。Total Store Order(TSO)要求所有写看起来按某个全序发生,但允许一个处理器的读越过它自己的写。因此可以采用写缓冲区,保存已经提交、但尚未与其他处理器的写确定相对顺序的写操作。TSO 下的读可以越过写缓冲区,也可能从缓冲区旁路获得数据;SC 不允许这样做。
假定每周期可执行一个内存操作;缓存命中,或可由写缓冲区满足的操作,不产生停顿。未命中带来 100 周期内存延迟。分别在 SC、TSO 下,计算每个操作前有多少停顿周期。写缓冲区最多容纳一次写。访存使用 5.1 中的记法。
a. [20]〈5.6〉
b. [20]〈5.6〉
c. [20]〈5.6〉
习题
习题 5.22
[15/20/10]〈5.1〉 本题研究互连网络拓扑对运行在 64 处理器分布式内存多处理器上的程序 CPI 的影响。处理器时钟频率为 2.0 GHz;应用的所有访问都在缓存中命中时,基础 CPI 为 0.75。假定 0.2% 的指令涉及远程通信访问。一次远程通信访问的代价为 ns,其中 h 是访问远程处理器内存并返回时经过的网络跳数。所有通信链路均为双向。
a. [15]〈5.1〉 64 个处理器分别排列成环、 网格及超立方体时,计算最坏情况下的远程通信代价。提示:含 个节点的超立方体,其最长通信路径有 n 条链路。
b. [20]〈5.1〉 将不含远程通信时的基础 CPI,与 a 中三种拓扑各自达到的 CPI 比较。
译注: 原题难度标记含三个数,但原页实际只有 a、b 两问。
习题 5.23
[15]〈5.2〉 如何修改图 5.6 的基本监听协议,使之适用于直写缓存?与写回缓存相比,直写缓存不再需要哪项主要硬件功能?
习题 5.24
[20/20]〈5.2〉 回答以下问题。
a. [20]〈5.2〉 为图 5.6 的基本监听缓存一致性协议增加干净独占状态,按图中的有限状态机格式绘出协议。
b. [20]〈5.2〉 在 a 的协议中增加 owned 状态,仍用图 5.6 的有限状态机格式描述。
习题 5.25
[15]〈5.2〉 一种解决伪共享的建议是为每个字增加有效位。这样,协议可以仅使一个字失效,不必移除整个块;一个处理器可在缓存中保留块的一部分,另一个处理器则写块的另一部分。这会给图 5.6 的基本监听缓存一致性协议增加哪些复杂性?请考虑所有可能的协议操作。
习题 5.26
[15/20]〈5.3〉 本题研究:设计共享内存多处理器系统时,处理器采用更积极的 ILP 技术会带来什么影响。考虑除处理器外完全相同的两个系统。A 的处理器采用简单的单发射、顺序执行流水线;B 采用四发射、乱序执行及 64 项重排序缓冲区。
a. [15]〈5.3〉 按图 5.11 的划分,把执行时间分为指令执行、缓存访问、内存访问及其他停顿。你预期 A、B 的这些部分各有何不同?
b. [10]〈5.3〉 根据 5.3 节对 OLTP 行为的讨论,OLTP 与其他基准测试之间哪项重要差别,限制了它从更积极的处理器设计中获得的收益?
习题 5.27
[15]〈5.3〉 如何修改应用代码以避免伪共享?哪些工作可由编译器完成,哪些可能需要程序员指示?
习题 5.28
[15]〈5.3〉 某应用统计一个词在大量文档中出现的次数。大量处理器分工搜索不同文档,生成一个巨大的数组 word_count;元素为 32 位整数,每个元素记录该词在一篇文档中的出现次数。第二阶段将计算移到一台四处理器小型 SMP 服务器,每个处理器对约四分之一的元素求和,最后由一个处理器计算总和。
a. 假定每个处理器都有一个 32 字节 L1 数据缓存,指出上述代码存在的缓存行共享,是真共享还是伪共享。
b. 重写代码,减少访问 word_count 元素时的未命中次数。
c. 指出一种手工修改代码的方法,消除所有伪共享。
译注: 原题写的是“32-byte L1 data cache”,未明确说 32 字节是缓存总容量还是缓存行大小;译文不擅自补上“行”。最后一行代码的终止分号也依原页未补。
习题 5.29
[15]〈5.4〉 假定采用目录一致性协议。目录当前记录处理器 P1 以 exclusive 模式持有某块数据;若此时又收到 P1 对同一缓存块的请求,可能意味着什么?目录控制器应如何处理?这类情况称为竞争条件(race conditions),也是一致性协议难以设计和验证的原因。
习题 5.30
[20]〈5.4〉 目录控制器可能向已被本地缓存控制器替换的缓存行发送失效消息。为避免这些消息并保持目录一致,可以使用替换提示(replacement hints),通知控制器某块已经被替换。修改 5.4 节的目录一致性协议,使其采用这类提示。
习题 5.31
[20/15/20/15]〈5.4〉 采用完整位向量直接实现目录的缺点之一,是目录信息总量按“处理器数 × 内存块数”增长。如果内存容量与处理器数量线性增长,目录总容量就按处理器数的平方增长。实践中,目录对每个内存块只需要 1 位,而一个块通常为 32–128 字节,所以处理器数量较少或中等时问题不严重。例如,块大小为 128 字节、处理器数为 P,目录存储量相对于主存为 ;P = 128 时,开销为 12.5%。注意到需要保留的信息量只须与各处理器的缓存容量成比例,就可以避免这一问题。下面研究几种方案。
译注: 此处原文“每个内存块只需要 1 位”,结合紧接着的公式,应按每个处理器、每个内存块一个共享位理解;不是整个系统每个块总共一位。
a. [20]〈5.4〉 一种可扩展目录协议把多处理器组织为逻辑层次结构,处理器位于叶节点,目录位于各子树根部。每个子树的目录记录哪些后代缓存了哪些内存块,还记录归属于该子树、但缓存在子树外部的内存块。假定各目录全相联,计算目录记录处理器信息所需的存储量。答案应同时包含各层节点数和总节点数。
b. [15]〈5.4〉 另一种缩小目录的方法,是任一时刻只允许目录所管理的有限个内存块被共享。将目录实现为四路组相联缓存,保存完整位向量。目录缓存未命中时,选出一个目录项并使其失效。描述这种组成如何工作,详细说明块被读、写、替换及写回内存时会发生什么。修改图 5.20 的协议,体现这种目录组成所需的新状态转换。1
c. [20]〈5.4〉 不减少目录项数,也可以采用非稠密位向量。例如,把每个目录项设为 9 位。若块在归属节点之外仅被一个节点缓存,该字段保存节点编号;若被多个外部节点缓存,该字段就是位向量,每一位代表八个处理器的一组,组内至少有一个缓存该块。针对由八个八处理器组组成的 64 处理器 DSM 系统,说明这种方案如何工作。
d. [15] 缩小目录的一种极端方法,是实现“空”目录:每个处理器的目录都不存储任何内存状态,只接收请求并适当地转发。在 DSM 系统中,与完全没有目录相比,保留这种目录有何好处?
习题 5.32
[10]〈5.5〉 使用 load linked/store conditional 指令对,实现经典的 compare-and-swap 指令。
习题 5.33
[15]〈5.5〉 常见性能优化是在同步变量周围填充空间,让同一缓存行内没有其他有用数据。构造一个例子,说明这种优化在某些情况下极其有效。假定采用监听式写失效协议。
习题 5.34
[30]〈5.5〉 在多核处理器中实现 load linked/store conditional 的一种方法,是限制它们采用不经过缓存的内存操作。一个监视单元截获任意核心发往内存的所有读写,跟踪 load linked 的来源,以及它与对应 store conditional 之间是否插入其他存储。监视单元能阻止任何失败的 store conditional 写入数据,并通过互连信号通知处理器该存储失败。
为支持四核 SMP 的存储系统设计这种监视单元。注意,读写请求的数据长度通常可以不同,为 4、8、16 或 32 字节。任意内存位置都可能是 load linked/store conditional 的目标;监视器应假定,对任意位置的这类访问都可能与同一位置的普通访问交错。监视器复杂度应与内存容量无关。
习题 5.35
[25]〈5.5〉 证明:在 L1 更靠近处理器的两级缓存层次中,如果 L2 的相联度至少与 L1 一样高,两级都采用 LRU 替换且块大小相同,则不需要额外操作就能维持包含性。
译注: 原题的结论还涉及 L2 是否得知 L1 命中并同步更新替换次序等条件;题面没有说明。
讨论
[Discussion]〈5〉 为详细评价多处理器性能,系统设计者使用三类工具之一:分析模型、轨迹驱动模拟和执行驱动模拟。分析模型用数学表达式描述程序行为。轨迹驱动模拟先在真实机器上运行应用,生成通常由内存操作组成的轨迹,再将轨迹送入缓存模拟器或具有简单处理器模型的模拟器重放,以预测参数变化后的性能。执行驱动模拟器则模拟整个执行过程,为处理器状态等维护等价结构。
a. 这些方法在精度与速度之间有何权衡?
b. CPU 轨迹若采集不慎,可能带入采集系统自身的特征。以分支预测和自旋等待同步为例讨论这一问题。提示:纯 CPU 轨迹方法只有轨迹,无法取得程序本身。
习题 5.36
[40]〈5.7,5.9〉 多处理器和集群通常随处理器数量增加而提高性能,理想情况是 n 个处理器获得 n 倍加速。本题这个有意偏置的基准测试,目标是构造一个处理器越多、性能反而越差的程序。例如,在多处理器或集群上,一个处理器运行最快;两个更慢,四个比两个更慢,以此类推。对于这两种组成方式,各有哪些关键性能特征会产生与线性加速相反的效果?
译注:原题引用图 5.20,但本版图 5.20 展示不同块大小的访存流量,并非目录协议状态图;本章目录项状态转换图为图 5.17。 ↩︎