6.2 云计算:效用计算的回归
如果我所倡导的这种计算机成为未来的计算机,那么,计算或许有一天也能像电话系统一样,组织成一项公共服务……计算服务可能成为一个重要新产业的基础。
——John McCarthy,MIT 百年校庆(1961)
效用计算(utility computing,即按使用量付费的计算服务)可以追溯到 20 世纪 60、70 年代的商业分时系统,甚至批处理系统。当时,企业只需支付终端与电话线路的费用,再按实际使用的计算量付费。分时计算时代结束以后,人们多次尝试提供这种按使用量付费的服务,却往往以失败告终。推动云计算——效用计算在现代的成功形式——的变化,是互联网服务自 2000 年代以来的极度普及。人们主要通过广泛使用的瘦客户端访问商业、娱乐或教育在线服务:在个人计算机上使用浏览器应用,在智能手机上使用提供交互界面的应用。互联网服务的应用逻辑和数据管理运行在后端服务器上;这些服务器必须具有高可用性、足够快的速度和可扩展性,才能满足服务不断变化的要求。云计算让各种类型、各种规模的互联网服务提供商,都能为其服务后端租用当时所需的资源。云提供商在多个地理区域维护多座 WSC,为客户提供支持。
云计算为用户带来显著优势:
- 进入门槛低。 任何持有信用卡的人,都能启动一个有几个核心的小型虚拟机,在几秒钟内开始使用,每小时只需几美分,而且不必作出长期承诺。相比之下,视已有条件而定,为自有后端采购计算、存储和网络设备可能需要数周,花费数千美元,还需要签订场地与运维支持的长期合同。
- 按使用量付费,随规模调整。 云用户可以迅速增加或减少所用虚拟机的数量,改变其类型,以紧密适应服务的负载与性质。在大多数云模式中,用户按所用资源付费,计费粒度可细至秒。相比之下,随着负载变化,自有后端总会面临配置过大(过于昂贵)或配置过小(资源不足)的问题。按使用量付费对初创企业尤其重要,因为它们的产品可能一夜之间走红。能够使用更多资源,为不断扩大的客户群提供良好服务质量,而无需巨额前期 IT 支出,会从根本上改变其商业模式。
- 运维成本低。 场地租金、保险和运维人员工资等运行成本,是自有基础设施总成本的重要组成部分。即使只有 10 台服务器,服务提供商仍须雇用一位在安全、网络、软件配置和可靠性方面具有充分专业知识的计算机管理员,才能运营服务。云计算显著降低了运维成本。云提供商负责基础网络、安全与可靠性等许多运维工作;成本由数千个用户与数千台服务器共同分摊,并通过本章后面将讨论的自动化与协同设计进一步降低。
- 可靠性与安全性更好。 除了成本较低,大多数云用户还享有显著改善的可靠性与安全性。小型服务供应商不具备、或者负担不起可靠且安全地运营自有基础设施所需的专业能力。云提供商具备这些能力,提供的安全与可靠性功能,有些内置于基础服务中,例如自动恢复并重启失效的 VM;另一些按使用量付费,例如为灾难恢复进行自动复制。不过,云基础设施的共享性质也带来了新的安全挑战,云提供商必须加以应对。
- 使用最新技术。 云提供商有动力迅速采购并部署最新的硬件或软件技术,以提高效率,或取得相对于竞争对手的优势。由于规模大,云提供商往往能优先获得最新芯片等新技术。它们也会自行开发一些最新的软硬件技术。即使只运行几个虚拟机,云用户也能受益于这些新技术。
云提供商能够获利,原因如下:
- 规模经济。 AWS、Microsoft Azure、Google Cloud Platform、Alibaba Cloud 和 Tencent Cloud 等大型云提供商,在所有地点合计运营着数百万台服务器,因此可以从多个方面受益于规模经济。例如,购买芯片等组件时,可以获得可观的批量折扣。对于优化供应链、新型自动化工具、适合自身场景的定制芯片、新型分布式系统,或能长期降低资本支出与运行支出的 WSC 协同设计,其研发成本也很容易摊销。
- 协同设计带来的效率。 正如本章将看到的,WSC 的各个方面,包括芯片、系统、软件、冷却和供电,都经过协同设计,从而显著改善各种效率指标,例如降低功耗或云管理开销。
- 通过复用提高利用率。 云提供商将多个用户和工作负载复用到基础设施上,取得远高于任一用户单独使用时所能达到的利用率。这使其能更好地摊销占总成本主要部分的资本支出,例如计算、存储和网络硬件的购置成本。本章后面将讨论在 WSC 中复用工作负载所面临的一些挑战,以及云提供商开发的一些解决方案。
- 更高层次的服务。 云平台最初出租的是服务器的一部分或多台服务器所提供的原始计算能力。随着时间推移,云提供商开始提供众多更高层次的服务,例如数据库即服务、ML 即服务,以及跨地理区域分布的内容分发网络(CDN)。这些高层服务的价格明显高于其消耗的原始计算周期成本,因为它们减少了客户必须自行部署和运维的软件数量。
云提供商运营 IT 基础设施的成本,远低于客户自行运营的成本,因此既能为客户节省开支,也能取得可观利润。Hamilton(2010)援引一项 2006 年的研究,将 WSC 与只有 1000 台服务器的传统 IT 数据中心比较,报告了以下优势:
- 存储成本降至原来的约 。 当时,WSC 磁盘存储每 GB 每年的成本为 $4.6,传统数据中心为 $26。
- 管理成本降至原来的约 。 WSC 中每位管理员管理超过 1000 台服务器,传统数据中心只有 140 台。
- 网络成本降至原来的约 。 当时,WSC 的互联网带宽成本为每 Mbit/s 每月 $13,传统数据中心为 $95。不难理解,订购 1000 Mbit/s 的带宽,比订购 10 Mbit/s 更容易谈到低得多的每 Mbit/s 价格。
云计算让所有人都能享受到 WSC 的优势。它使成本具有可组合性,并在不增加用户额外成本的情况下,营造出能够无限扩展的效果:使用 1000 台服务器 1 小时,费用不会高于使用 1 台服务器 1000 小时。确保有足够的服务器、存储和互联网带宽来满足需求,是云提供商的责任。前述优化后的供应链能够把新计算机的交付时间缩短到一周,对于在不使提供商破产的前提下提供这种效果,大有帮助。风险转移、成本可组合性、按使用量计价,以及更好的可靠性与安全性,共同构成了强有力的理由,使不同规模的企业选择云计算,而非自有的本地部署系统。
如今,云计算已取得极大成功,而且越来越普及。据估计,2021 年全球最终用户在公有云上的支出超过 4000 亿美元(Gartner,2022)。预计未来几年增长率将接近 20%,因此到 2025 年,云服务支出预计将超过传统 IT 支出。换句话说,云计算已经是,而且很可能继续是,推动计算机体系结构发展的主要力量。
云计算模式
图 6.2 展示了云计算服务的三种主要模式。这些模式的区别在于:哪些基础设施组件由云提供商管理,哪些仍由云用户管理。
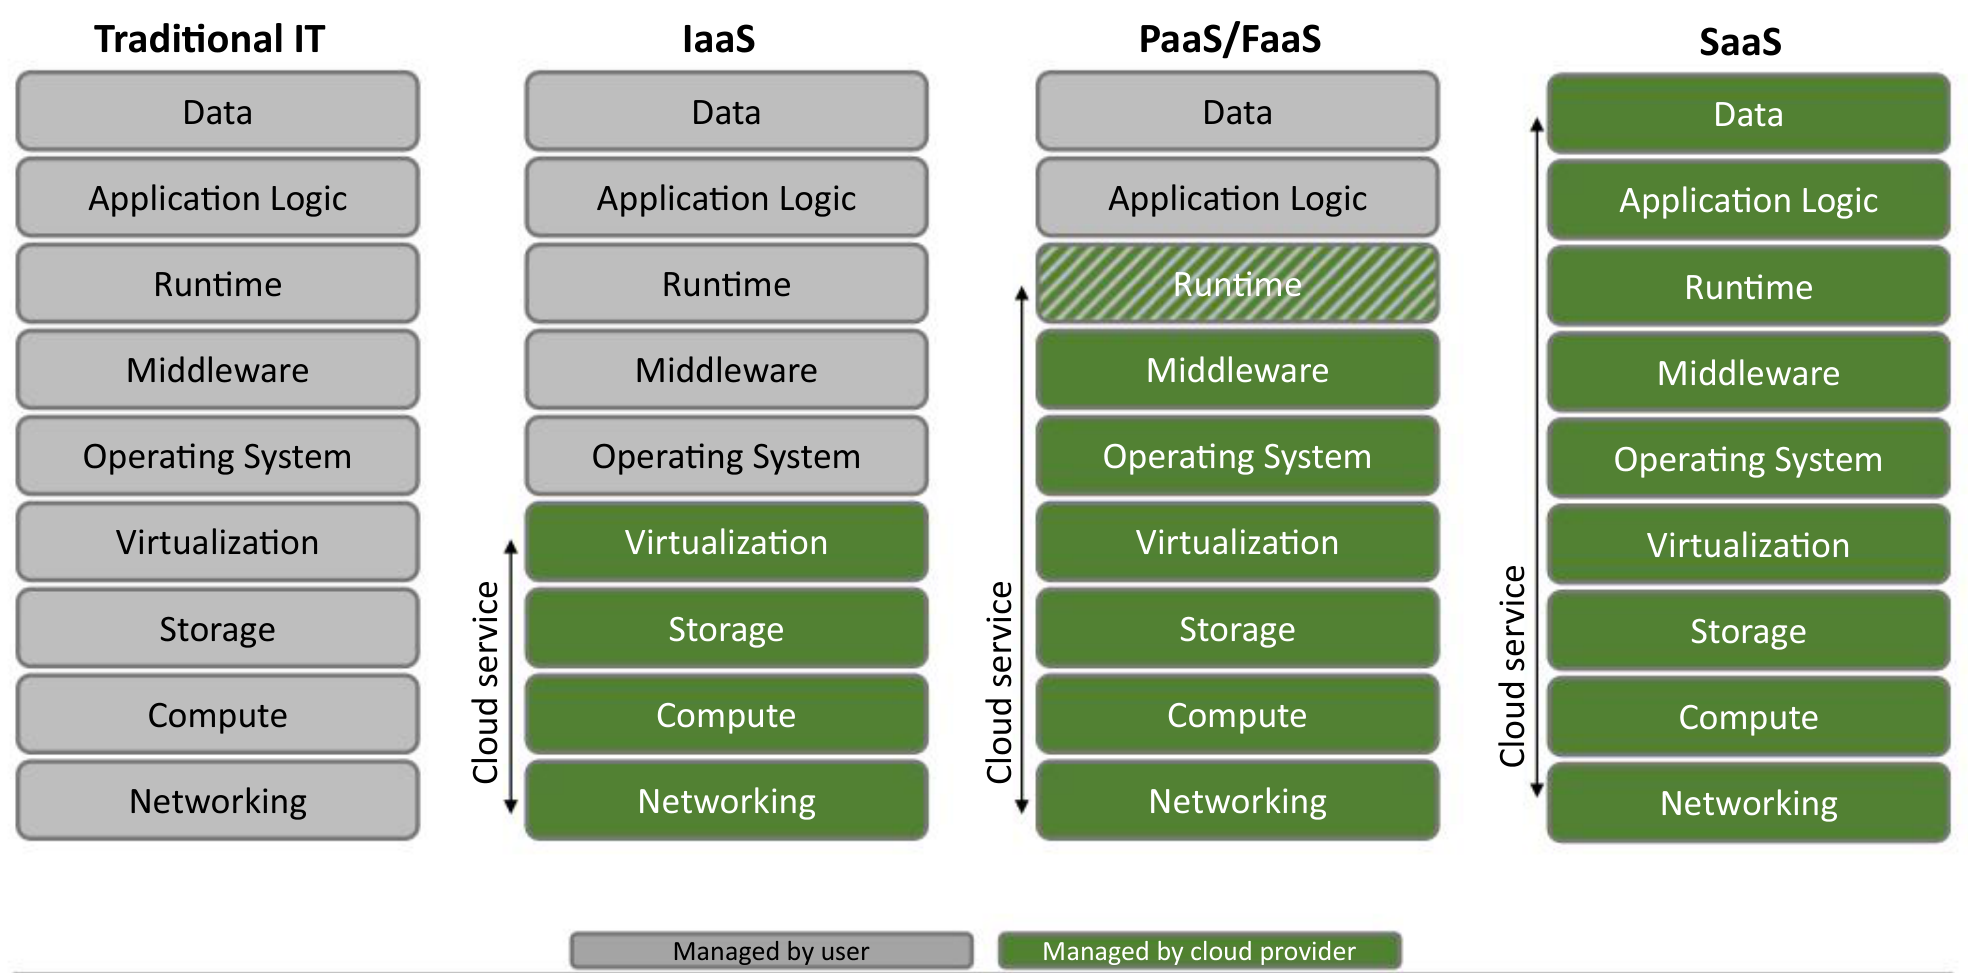
图内术语:Traditional IT=传统 IT;Data=数据;Application Logic=应用逻辑;Runtime=运行时;Middleware=中间件;Operating System=操作系统;Virtualization=虚拟化;Storage=存储;Compute=计算;Networking=网络;Cloud service=云服务;Managed by user=用户管理;Managed by cloud provider=云提供商管理。PaaS/FaaS 中运行时层的斜纹表示这一层的管理责任因具体服务而异。
- 基础设施即服务(Infrastructure as a Service,IaaS)。 云提供商向用户提供虚拟化的计算、存储和网络资源。这些资源的规模可灵活调整,例如虚拟机可以有 1–256 个核心、0.5–1024 GB 内存;它们在功能上等价于物理硬件资源,但实际是利用 6.3 节将讨论的虚拟化技术,划分物理硬件来实现的。用户在这套虚拟硬件之上启动自己选择的软件栈,包括操作系统、一个或多个中间件与运行时框架,以及一个或多个应用。计算资源按规模和使用时间计费;存储资源按容量和预配置的吞吐量计费。网络带宽通常与计算资源规模相关:更大的虚拟机配置更多网络带宽。
- 平台即服务(Platform as a Service,PaaS)。 云提供商管理操作系统、中间件的所有方面,而且通常还管理运行用户代码的运行时框架。例如,AWS 的 Elastic MapReduce 服务管理 Hadoop 集群,用户可在其上编写分布式分析作业。AWS 的 Elastic Kubernetes Service 管理运行 Kubernetes 编排框架的集群,让用户运行容器化应用。PaaS 的计价方式与 IaaS 相似,按虚拟机的使用时间和规模计费,再加上管理额外软件组件的溢价。
- 函数即服务(Function as a Service,FaaS)。 这一模式通常称为无服务器计算(Serverless Computing)。它与 PaaS 相似,云提供商管理操作系统和应用运行时,例如容器执行框架或托管语言的运行时系统。在 PaaS 中,用户代码作为长期运行的服务执行,能够接收并处理多个外部请求;在 FaaS 中,用户代码在短生命周期的函数中执行,函数因单个外部事件或一小批事件而启动。FaaS 让用户能够迅速把云资源使用规模从零扩大到数千个实例,从而随着应用负载变化优化成本与性能。因此,对于负载变化很大的应用,例如物联网(IoT)应用与交互式分析负载,FaaS 尤其有吸引力。
- 软件即服务(Software as a Service,SaaS)。 提供商提供一个完整应用,用户通过客户端设备访问。提供商管理应用的各个方面,包括核心逻辑和所处理的用户数据。许多云客户利用 IaaS 与 PaaS 资源运行应用,再以 SaaS 的形式提供给消费者或企业客户。云提供商自身也提供一些 SaaS 服务,例如电子邮件和基于云的办公套件。价格依据用户数量、数据量,以及其他与具体应用有关的功能和指标确定。
IaaS 是最早的云模式,后来逐渐增加了许多简化虚拟机管理的功能。例如,提供商会整理维护流行操作系统稳定版本的镜像,以减轻操作系统安装与更新的负担;用户可以在虚拟机上自动启动这些镜像。云提供商的基础设施会跟踪机器级或应用级指标,据此自动增加(向外扩展,scale out)或减少(向内收缩,scale in)分布式应用所用的虚拟机数量。用户可以配置可靠性选项,例如定期保存虚拟机状态快照,以及采用主备或双活复制来进行故障恢复。最后,为提高容错能力,用户可以将虚拟机配置为分散在不同机架、独立集群或多个地理区域。这些功能也适用于 PaaS 模式。
云安全是重要问题,因为在所有这些模式中,物理机器都可能由多个用户共享。云安全的基石是硬件辅助虚拟化技术,它为并发运行的虚拟机提供内存隔离(见 6.3 节)。网络虚拟化也得到网络接口芯片的硬件支持(见 6.5 节),使云提供商和用户能够有选择地开放 WSC 内部或经互联网建立的网络连接。存储服务提供静态数据加密和传输中数据加密。在最新硬件支持的实例上,内存中的数据也会加密。云提供商监控其管理的软件,并在必要时更新软件以修复安全漏洞。最后,云提供商还提供身份管理服务,让企业客户能够对其员工或客户进行身份验证与授权,实现访问控制。
不过,有些使用场景对云环境中多租户带来的安全风险尤其敏感,例如处理金融或医疗数据的应用。微体系结构侧信道攻击可能绕过内存隔离机制,这类攻击的发现也引发了新的安全忧虑。云提供商目前提供两种缓解方案。第一种是利用 Intel SGX 和 Arm TrustZone 等硬件 enclave,提供可信执行环境(TEE)。硬件 enclave 对部分内存加密,并保护允许处理加密数据的函数的进入与退出过程。其本质是再增加一层保护:即使攻击者绕过了操作系统与虚拟化所提供的内存隔离机制,或者云提供商中不守规矩的员工能够探测共享机器的内存总线,也仍有这一层防护。enclave 越来越多地被用于实现 TEE 和更高层次的机密计算框架。这项技术正快速演进,以满足新需求、降低开销、扩大适用范围,并回应微体系结构攻击也可能绕过 enclave 保护的担忧。
第二种方案是裸金属云模式,让用户直接访问云 WSC 中的一整台物理机器。这台机器不与其他用户共享,也不运行虚拟化软件栈。云提供商只管理网络,以保护裸金属机器免受其他云用户的侵害,同时保护其他用户不受这台机器的侵害。网络隔离通常由网络交换机实现,或者在裸金属机器与数据中心网络之间串接额外设备(bump-in-the-wire)。裸金属模式也让专业用户能够进一步细致调整机器上软件栈的各个方面,而不用担心虚拟化开销。
无论云客户使用 PaaS 容器、FaaS 函数,还是在 IaaS 虚拟机或裸金属机器上运行自己选择的软件栈,都可以读写云提供商管理的分布式存储服务中的数据。这些服务采用各种接口——块、文件系统或键值存储——针对不同速度进行优化并定价,例如基于 Flash、基于磁盘,或者面向归档优化的服务。计算与存储分离是云计算的一项基本理念。它让云用户能够方便地扩展计算资源,在可用的云模式之间灵活切换,并改变应用的组织方式;与此同时,数据接口保持稳定,并在逻辑上与计算分开。
进一步了解 IaaS 云服务
IaaS 是其他所有云模式与服务的基础。它依靠虚拟化技术划分一台物理机器,并在其上运行多个虚拟机实例。云提供商从不同配置的物理机器出发,创建种类与规模繁多的 IaaS 实例。图 6.3 列出了 AWS EC2 服务中若干实例类型的主要特征;这一 IaaS 服务于 2006 年首次推出。EC2 的实例类型与规模组合超过 600 种,图中展示其中 19 种,涵盖文中所称的四类实例:面向多种负载的通用实例;面向游戏、媒体转码等计算密集型负载的计算优化实例;面向高性能数据库的内存优化实例;面向分布式文件系统和 MapReduce 等负载的存储优化实例;以及提供 GPU、FPGA 和 ML 加速器等设备的加速计算实例。通过选择合适的实例系列、类型与规模,用户能够使虚拟基础设施的性能和成本恰好适应应用需求。
译注: 原文称“四类”(four families),随后列举且图 6.3 展示的是五类。
IaaS 实例可按四种方式购买:
- 按需实例。 用户可启动实例,并按使用秒数付费。
- 预留实例与节省计划。 相比按需实例,这些方式有显著折扣,但要求对单个实例或一组实例作出长期使用承诺。
- Spot 实例。 用户可以很低的折扣价租用当前尚未分配的计算能力。不过,如果其他类型的实例需要这些资源,Spot 实例可能被抢占。
- 专属宿主机与专属实例。 这些选项使用户能够确保自己的实例运行在不与其他用户共享的硬件上。
用户可以为长期运行的工作负载选择预留实例,为不规律的负载选择按需或 Spot 实例。
| 类别 | 实例 | vCPU 数 | 内存(GiB) | 存储(GB) | 网络(Gbps) | EBS(Gbps) | 加速器 | 每小时费用 |
|---|---|---|---|---|---|---|---|---|
| 通用 | t4g.nano | 2 | 0.5 | 仅 EBS | ≤5 | ≤2.1 | — | $0.0042 |
| 通用 | t4g.large | 2 | 8 | 仅 EBS | ≤5 | ≤2.7 | — | $0.0672 |
| 通用 | m6i.8xlarge | 32 | 128 | 仅 EBS | 12.5 | 10 | — | $1.5360 |
| 通用 | m6id.8xlarge | 32 | 128 | 1 × 1900 NVMe SSD | 12.5 | 10 | — | $1.8984 |
| 通用 | m6id.32xlarge | 128 | 512 | 4 × 1900 NVMe SSD | 50 | 50 | — | $7.5936 |
| 通用 | m6id.metal | 128 | 512 | 4 × 1900 NVMe SSD | 50 | 40 | — | $7.5936 |
| 计算优化 | c6in.8xlarge | 32 | 64 | 仅 EBS | 50 | 20 | — | $1.8144 |
| 计算优化 | c6in.32xlarge | 128 | 256 | 仅 EBS | 200 | 80 | — | $7.2576 |
| 内存优化 | r6i.large | 2 | 16 | 仅 EBS | ≤12.5 | ≤10 | — | $0.1260 |
| 内存优化 | r6i.32xlarge | 128 | 1024 | 仅 EBS | 50 | 40 | — | $8.0640 |
| 内存优化 | r6i.metal | 128 | 1024 | 仅 EBS | 50 | 40 | — | $8.0640 |
| 存储优化 | h1.16xlarge | 64 | 256 | 8 × 2000 HDD | 25 | — | — | $3.7440 |
| 存储优化 | im4gn.large | 2 | 8 | 1 × 937 Nitro SSD | ≤25 | ≤9.5 | — | $0.1819 |
| 存储优化 | im4gn.16xlarge | 64 | 256 | 4 × 7500 Nitro SSD | 100 | 38 | — | $5.8206 |
| 加速计算 | p4de.24xlarge | 96 | 1152 | 8 × 1000 NVMe SSD | 400 | 19 | 8 × A100 GPU;320 GB HBM2;600 GB/s NVSwitch | $40.9657 |
| 加速计算 | trn1.32xlarge | 128 | 512 | 4 × 2000 NVMe SSD | 8 × 100 | 80 | 16 × Trainium 芯片;512 GB HBM2 | $21.5000 |
| 加速计算 | inf1.xlarge | 4 | 8 | 仅 EBS | ≤25 | ≤4.75 | 1 × Inferentia 芯片 | $0.0280 |
| 加速计算 | inf1.24xlarge | 16 | 96 | 仅 EBS | 25 | 4.75 | 16 × Inferentia 芯片,具有直接互连 | $4.7210 |
| 加速计算 | f1.16xlarge | 64 | 976 | 4 × 940 NVMe SSD | 25 | 14 | 8 × Xilinx VU9p FPGA | $13.2000 |
AWS 提供多种与 EC2 实例解耦的持久化存储选项。AWS S3 是一个简单的对象存储,为 WSC 内部及互联网范围内的各种负载实现具有最终一致性的分布式存储。它提供多个数据层级:面向活跃访问数据的 standard,面向低频访问数据的 infrequent,面向可能需要快速恢复的备份数据的 glacier,以及面向数字保存数据的 glacier deep archive。每个层级都代表存储系统在性能与成本权衡中的一个不同设计点。AWS Elastic Block Storage(EBS)以固态硬盘(SSD 层级)或机械硬盘(HDD 层级)实现高性能分布式块存储。AWS Elastic File Storage(EFS)支持类似 NFS 的完整文件系统语义,完全由 AWS 管理,其存储容量具有弹性,会随着文件的创建或删除自动增减。最后,AWS FSx 是一个 HPC 文件系统,支持 Lustre、ZFS、ONTAP 与 Windows File Server 的文件系统接口。持久化存储按容量、预配置吞吐量与突发吞吐量计费。
云计算指标与 WSC 体系结构的驱动因素
在 6.7 节分析 WSC 效率之前,值得先了解几个直接影响 WSC 优化方式的云计算关键业务指标。
只要提供商能够持续以低于客户愿付价格的成本建设并运营共享基础设施,效用计算就是可行的业务。这使总拥有成本(TCO)成为 WSC 的首要指标。TCO 既包括购买建筑物与服务器等一次性的资本支出,也包括电费、员工工资等经常性运行支出。其次,共享基础设施的收入与高利用率直接相关。因此,WSC 的硬件与软件必须能够缓解把工作负载密集安排在共享服务器上所带来的问题,例如安全隔离和性能隔离问题。
体系结构还需要足够灵活,以便迅速部署新的软硬件组件。例如,一种新的 ML 加速器芯片,可能使客户工作负载的性价比达到原来的 10 倍。若能在芯片发布后的数周内、而非数月之后,将它集成到云基础设施中,就能显著影响云提供商的利润与客户的收益。客户也期望云服务具有很高的可靠性与可用性。这一要求推动了云体系结构的若干关键设计:分布于多个地理地点;每个地点有多座相互独立的 WSC;每座 WSC 内采用分布式体系结构;计算与存储分离。它还意味着,云硬件与软件偶尔进行的维护,对云用户而言应基本透明。有些客户工作负载是分布式应用,可以应对偶发的实例失效;但也有很多是依赖单台机器高可靠性的传统企业应用。云提供商追求软件的无中断升级(hitless upgrade),使客户实例在提供商更新管理 WSC 中虚拟机、交换机或存储的软件时,仍能持续运行。
本节主要讨论托管客户工作负载的公有云平台,例如 Amazon、Microsoft、Google、Alibaba、Oracle 和 Tencent 所运营的平台。也有少数计算需求庞大的公司,建设并运营私有云,为自身工作负载与互联网服务提供支持。例如,Google 在 2000 年代率先开发了许多 WSC 软硬件技术,以支持运行网页搜索、在线地图、YouTube 和广告投放等大规模工作负载的私有云。Meta 也运营着一个大型私有云,支撑 Facebook 和 Instagram 等社交网络服务。对全部工作负载实行严格控制,可以让公司简化云平台的某些方面。例如,如果所有工作负载都按分布式方式设计,支持单台服务器无中断升级的重要性就会降低。进程级和容器级隔离已足以满足安全要求,从而不再需要虚拟机。类似地,如果所有程序都使用同一个远程过程调用(RPC)库,就可以在这个库中实现原本需要网络虚拟化才能提供的安全功能。不过,私有云与公有云的 WSC 已足够相似,尤其在硬件体系结构方面,因此本章后续不再区分二者。