6.4 仓库级计算机的计算机体系结构
一座 WSC 由 50,000–100,000 台计算服务器和存储模块组成,通过分层网络相互连接。计算、存储与网络设备安装在机架中,机架还容纳交流转直流电源转换器、备用电池等供电设备。图 6.6 是 Google 的 WSC 机架实例。
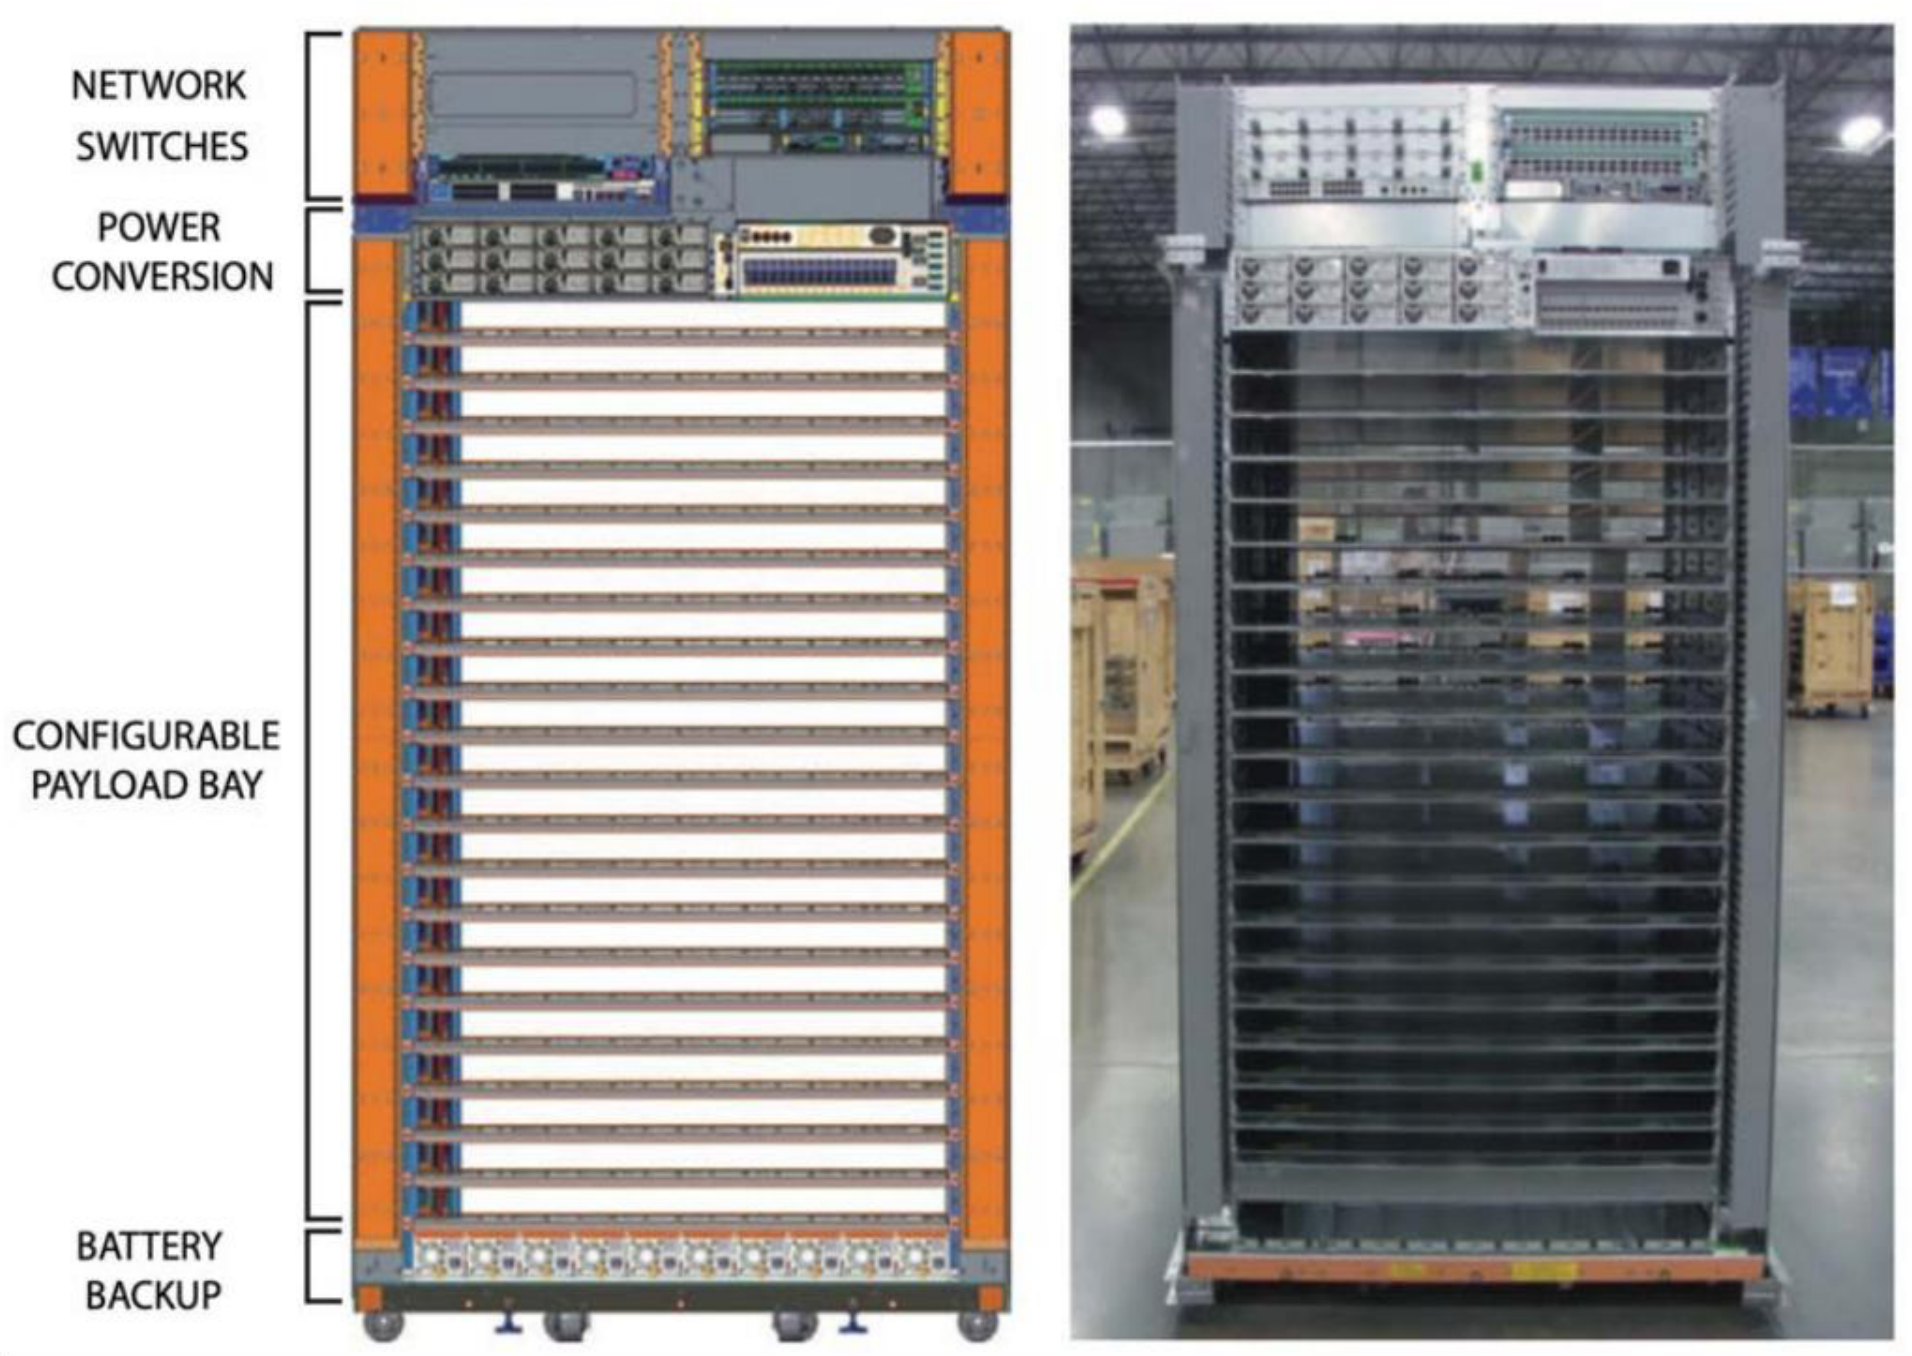
图内术语:Network switches=网络交换机;Power conversion=电源转换;Configurable payload bay=可配置设备安装区;Battery backup=备用电池。
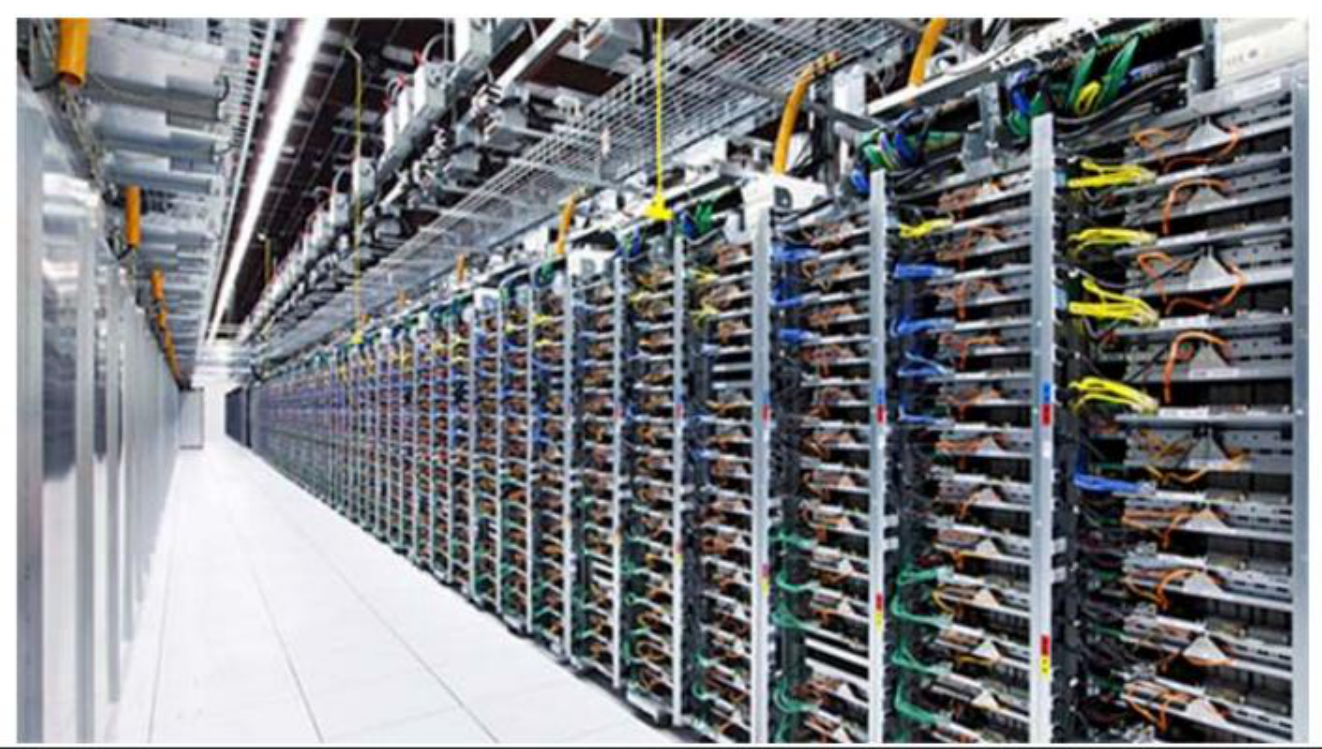
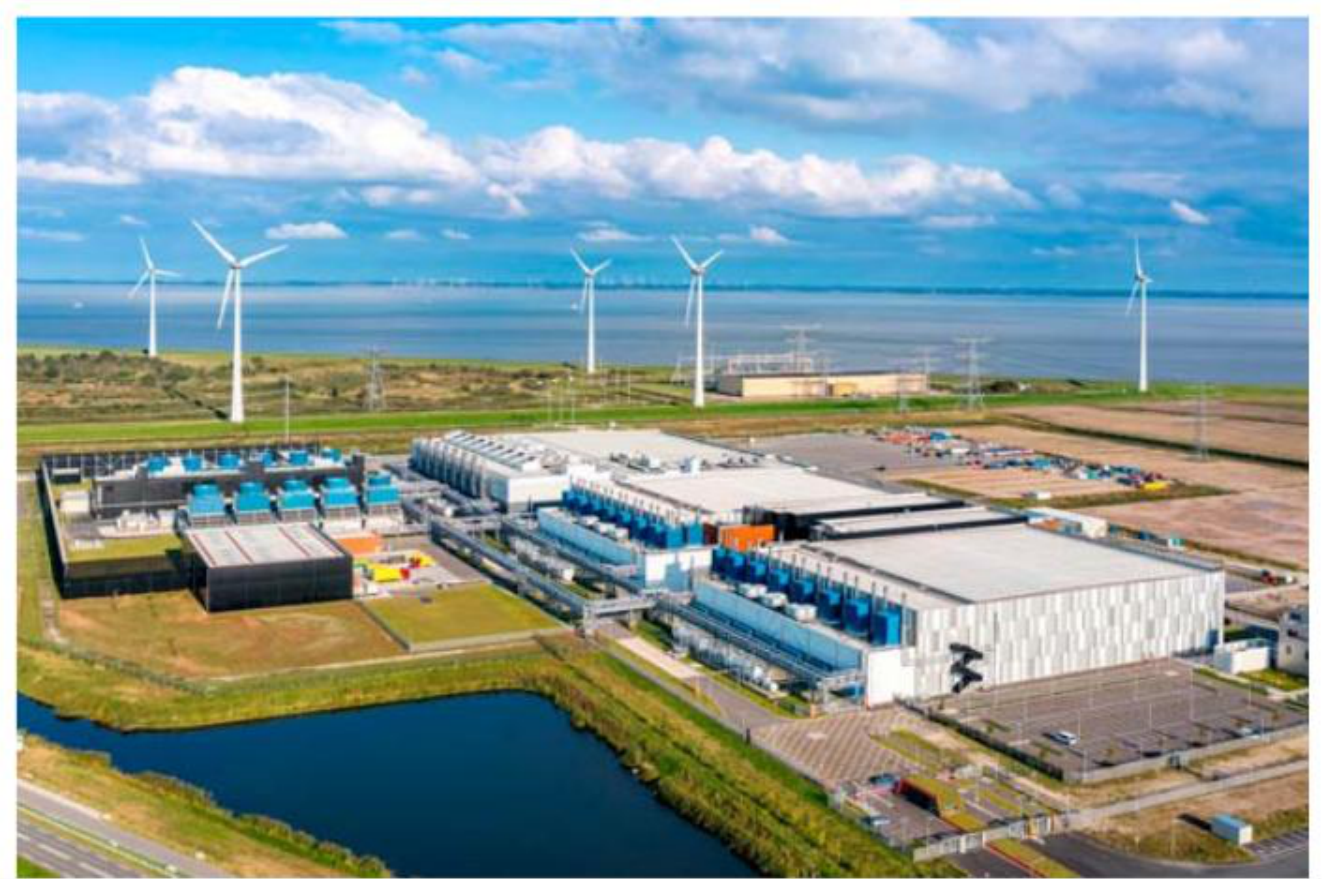
机架尺寸差异很大。传统机架宽 19 英寸、深 48 英寸;一些近期设计则更浅、更宽,以便在每个水平托盘中容纳多台服务器。机架通常高 70–84 英寸,以机架单位(rack unit)表示, 英寸 cm。每个机架可容纳的服务器数量,还受到可用功率(例如每架 10–30 kW)、冷却与气流条件,以及机架连接到网络的可用带宽限制。机架在仓库建筑中成排布置,如图 6.7 所示。图 6.8 展示了一处包含多栋仓库规模建筑的 WSC 设施,建筑中容纳机架,以及运行这些机架所必需的电气与冷却设备。
本节介绍 WSC 的计算、存储与网络组件,并重点介绍 Open Compute Project(OCP) 中的几个实例。OCP 维护 Meta、Google、Microsoft 和 Alibaba 等 WSC 运营商设计的硬件组件的详细规范。6.6 节将讨论供电与冷却设备:它们对 WSC 运行至关重要,而且与电子组件协同设计。
WSC 的计算系统
与传统企业数据中心相比,WSC 相对同构,但仍然包含多种服务器配置。采用异构配置的主要动机,是让硬件能力和成本更好地适应关键 WSC 工作负载的特征。图 6.9 总结了 Meta 在 2017 年的 WSC 中使用的七种服务器,以及各配置对应的负载。只要满足整体供电与冷却限制,一个机架既可以只安装一种服务器,也可以安装多种。因此,一些机架可能不会装满。在仓库整个寿命期内,硬件逐步安装和更换,所以 WSC 同时存在多代服务器与机架类型。
| 项目 | I 型 | III 型 | IV 型 | V 型 | VI 型 | VII 型 | VIII 型 |
|---|---|---|---|---|---|---|---|
| 使用场景 | Web 服务 | 数据库 | 数据分析 | 照片 | 多种服务 | 冷存储 | 分离式 Flash |
| CPU | 4 × Xeon D | 2 × Xeon E5 | 2 × Xeon E5 | 2 × Xeon E5 | 2 × Xeon E5 | 2 × Xeon E5 | 2 × Xeon E5 |
| 内存 | 32 GB | 256 GB | 128 GB | 32 GB | 256 GB | 256 GB | 32 GB |
| 存储 | 1 × 500 GB SATA | 2 × 3.2 TB PCIe Flash | 15 × 5 TB PCIe Flash | 30 × 4 TB SAS HDD | 1 × 1.8 TB PCIe Flash | 240 × 4 TB SATA HDD | 15 × 5 TB SATA/PCIe Flash |
图 6.9 来源:OCP Summit 2017: Facebook news recap。类型编号按原表保留,原表没有 II 型。
图 6.10 展示一台 1 RU 双插槽服务器。这是 WSC 的常见配置,因为它可以配置适当的计算与内存容量,处理广泛的应用。机箱金属件、主板、风扇、NIC 等固定成本分摊到两个 CPU 插槽,因此这种配置具有成本效益,即使服务器被划分为多个小 VM,也能很好地工作。还有一些设计进一步改善了成本与模块化程度。图 6.11 展示 Meta Yosemite 多节点服务器设计。其 4U 机箱包含三个 sled(可抽取的托架),每个可容纳 1–4 个不同配置的服务器刀片。基本配置的每个 sled 包含四台单插槽服务器,顶部另有一块小板,安装四个刀片共享的基板管理控制器(BMC)与 NIC。
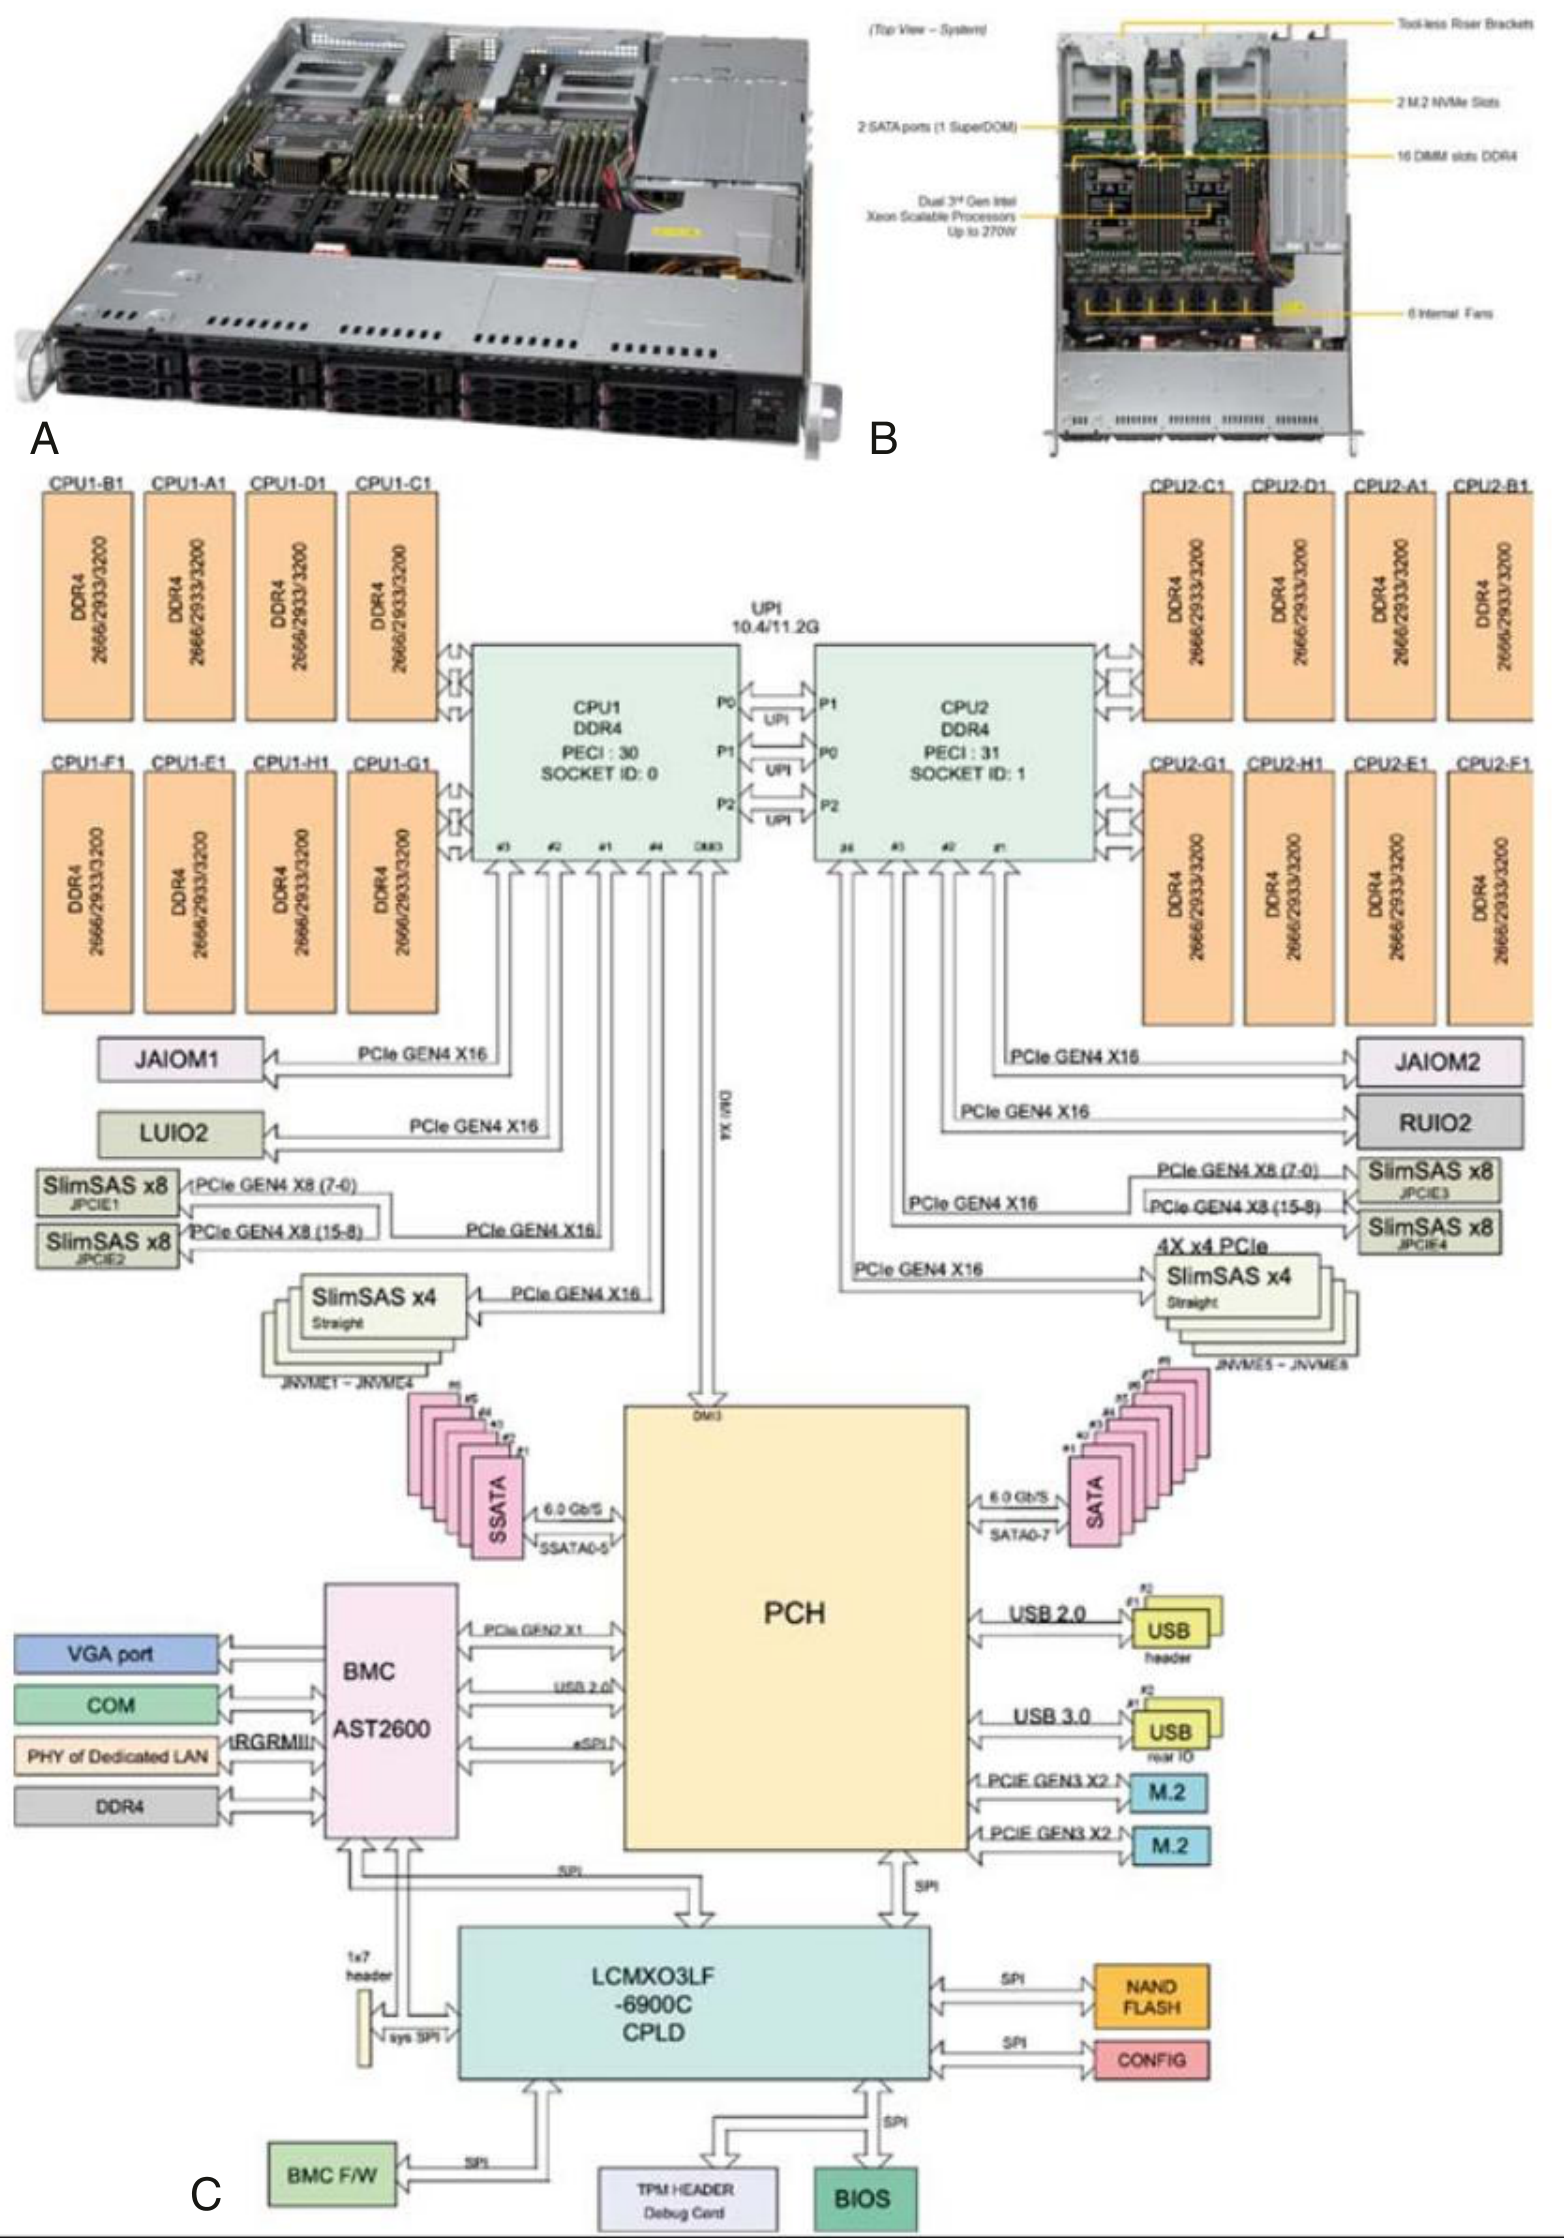
详细规范:SuperMicro SYS-120C-TN10R。图内术语:Top View—System=系统俯视图;Tool-less Riser Brackets=免工具转接卡支架;2 SATA ports (1 SuperDOM)=两个 SATA 端口(其中一个为 SuperDOM);2 M.2 NVMe Slots=两个 M.2 NVMe 插槽;16 DIMM slots DDR4=16 个 DDR4 DIMM 插槽;Dual 3rd Gen Intel Xeon Scalable Processors / Up to 270W=双路第三代 Intel Xeon 可扩展处理器,功耗最高 270 W;6 Internal Fans=六个内部风扇;Socket ID=插槽标识;Straight=直式;VGA port=VGA 端口;COM=串行端口;header=插针座;rear I/O=后部 I/O;PHY of Dedicated LAN=专用局域网接口的物理层;NAND FLASH=NAND 闪存;BMC F/W=BMC 固件;CONFIG=配置;TPM HEADER=TPM 插针座;Debug Card=调试卡。CPU、DDR4、UPI、PCIe、SATA、USB、BMC、PCH、CPLD、TPM、BIOS 及端口标识均保留原文。
译注: 原图注尺寸的最后一项也标为 D,和前一项重复。
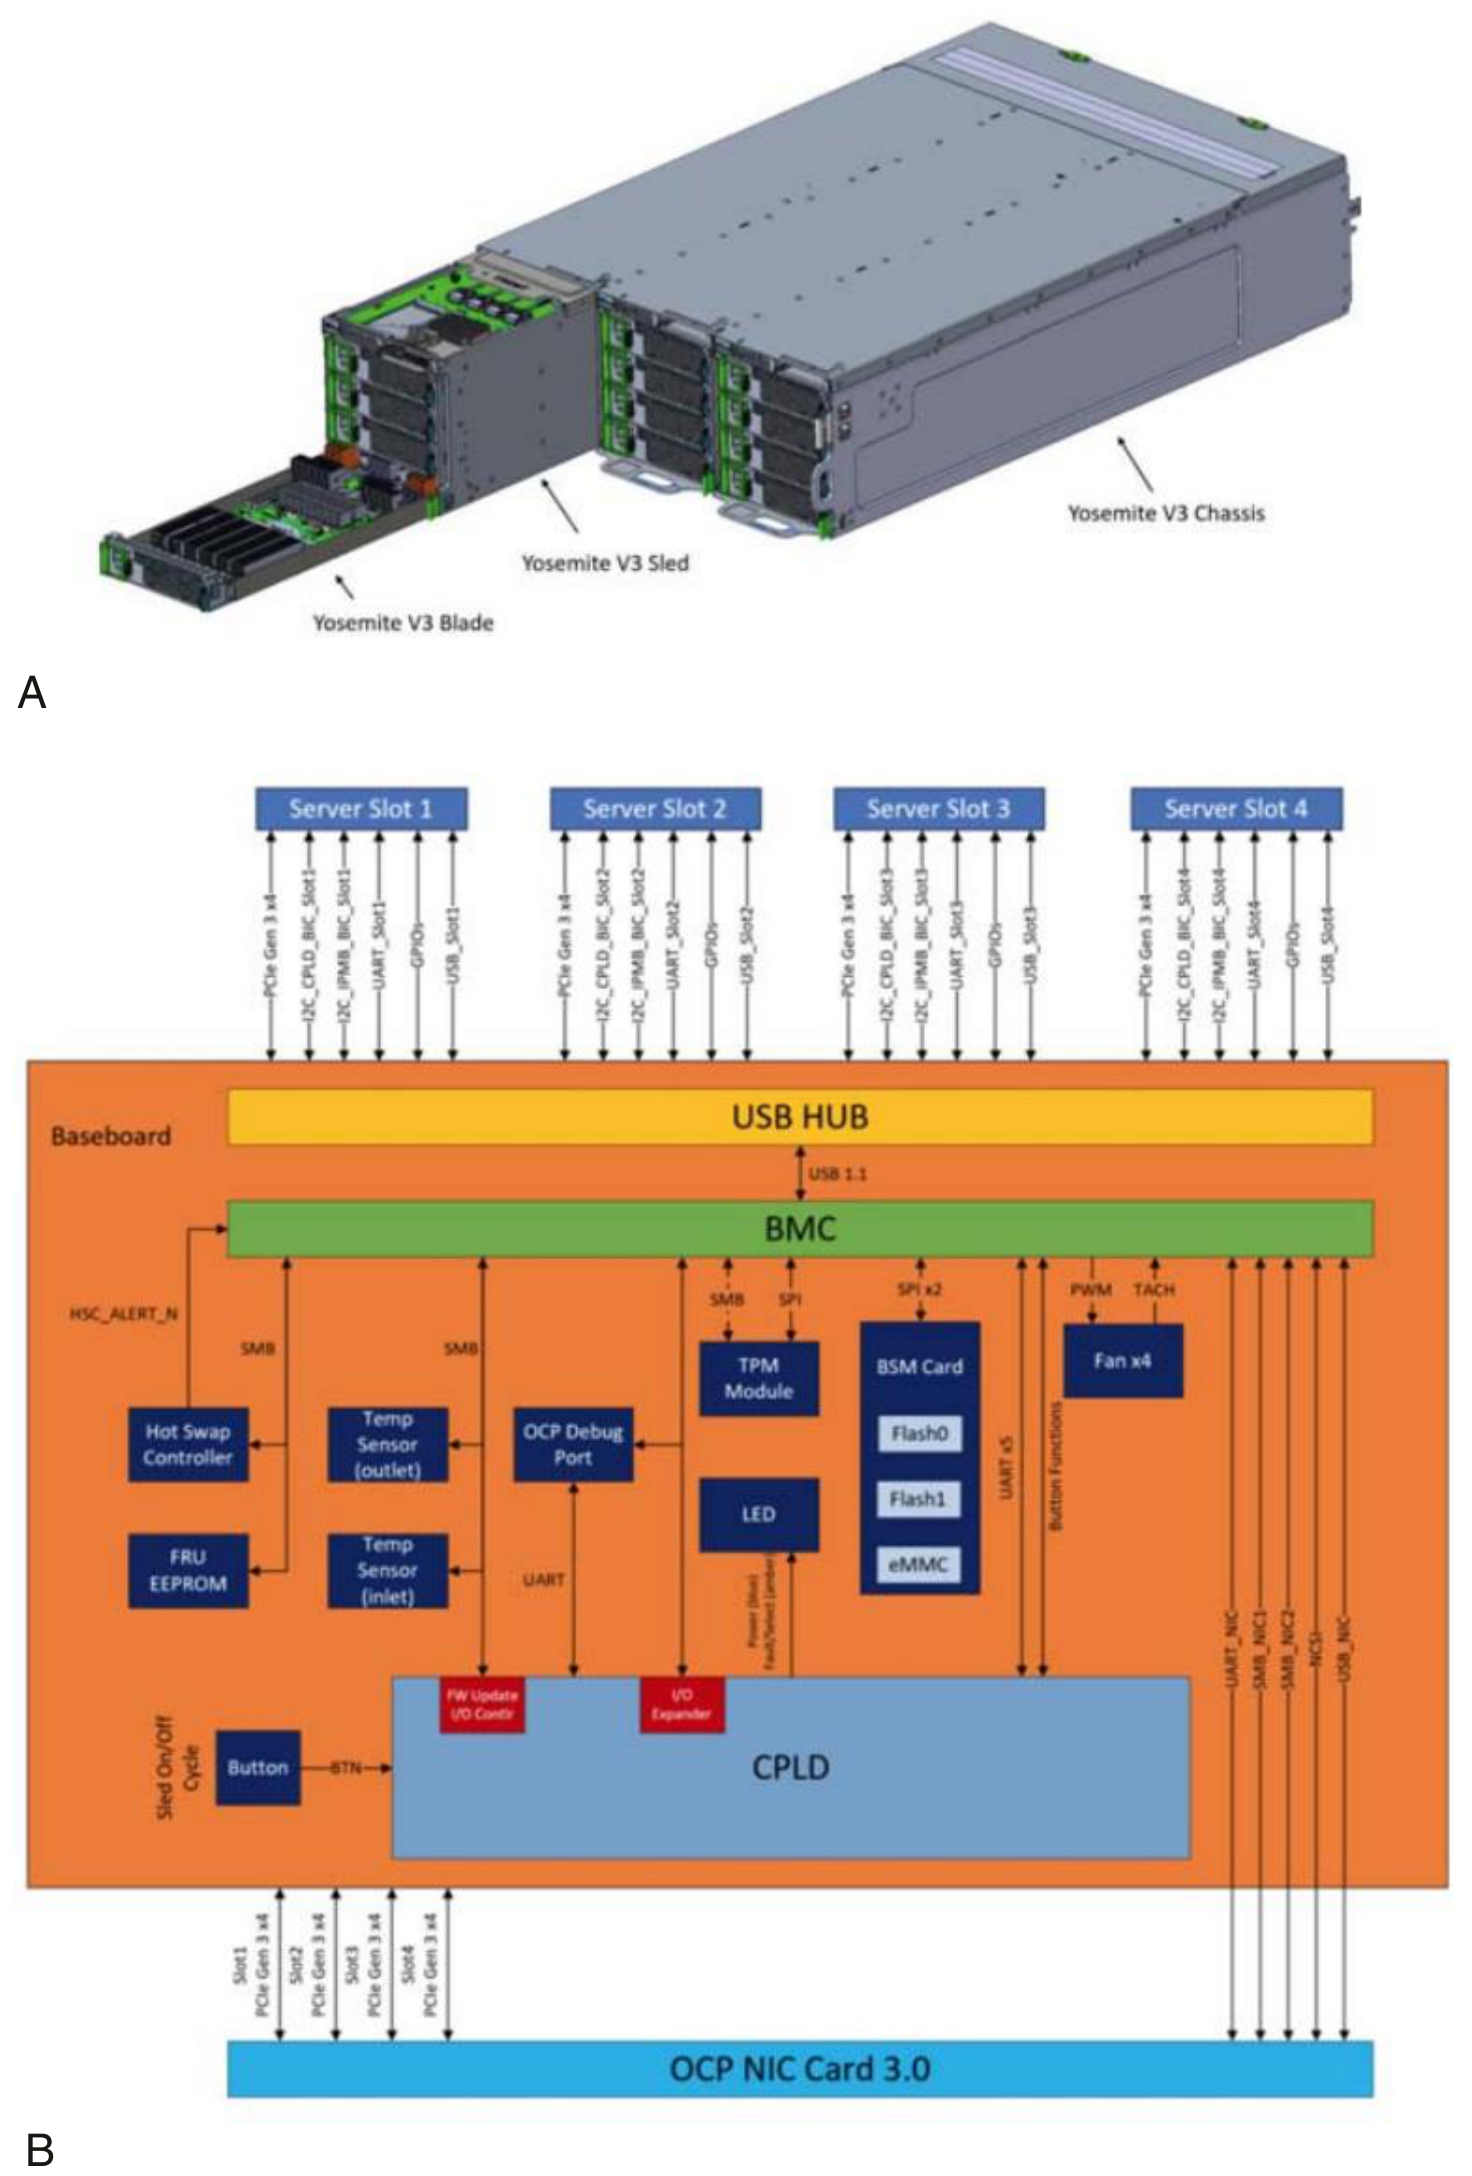
详细规范:OCP Yosemite v3 Platform Design Specification。图内术语:Chassis=机箱;Sled=可抽取托架;Blade=刀片;Server Slot=服务器插槽;Baseboard=基板;USB HUB=USB 集线器;Hot Swap Controller=热插拔控制器;Temp Sensor (outlet/inlet)=出口/入口温度传感器;OCP Debug Port=OCP 调试端口;TPM Module=TPM 模块;Fan=风扇;Button=按钮;Sled On/Off Cycle=sled 上电/断电循环;FW Update I/O Config=固件更新 I/O 配置;I/O Expander=I/O 扩展器;OCP NIC Card=OCP 网卡。BMC、BSM、CPLD、FRU EEPROM、LED、eMMC 及总线标识保留原文。
译注: 正文将 Yosemite 机箱写为 4U,图 6.11 图注则写为 3RU。
BMC 管理安全启动、风扇、稳压器及各种系统传感器。NIC 内含一个四路 PCIe 交换机,为每台服务器提供物理上独立的 NIC 资源接口。对于会话级并行性充足、内存需求较小的负载,例如前端 Web 服务器、横向扩展的微服务,以及中小型 VM,这种配置具有成本效益。这些负载使用两台单插槽服务器,能获得与一台双插槽服务器相同的吞吐量,因此没有必要使用双插槽服务器所需的更昂贵 CPU 芯片。Yosemite 设计让多台单 CPU 服务器分摊 BMC 与 NIC 的成本。Yosemite sled 也能容纳其他刀片配置,包括共享存储或共享领域专用加速器(DSA)的刀片。
ML 推理或视频转码芯片等小型 DSA,可以作为 PCIe 或 M.2 外设板卡,安装在上述服务器中。然而,大语言模型(LLM)等大型 ML 模型的训练与服务,在重要性、规模和计算强度方面不断增长,促成了 DSA 专用服务器的部署。这些服务器容纳 4–16 个高端 DSA 芯片,每个芯片功耗可达 800 W 或更高。每台服务器连接三种网络:第一,连接分布式存储和公共互联网的普通数据中心网络;第二,直接连接服务器内部 DSA 的高带宽网络;第三,独立的服务器间互连,支持跨多台服务器的分布式训练与推理。这些服务器是第 7 章讨论的 DSA 超级计算机的基本构件。
图 6.12 展示用于 GPU ML 训练的 NVIDIA DGX H100 服务器。这台 3U 服务器包含八个 H100 Tensor Core GPU;每个 GPU 配备 80 GB HBM,FP8 运算能力最高为 8 PFLOPS,BF16 或 FP16 运算能力为 2 PFLOPS。八个 GPU 通过四个交换芯片,利用 NVLink 互连直接通信,每 GPU 峰值带宽为 900 GB/s,即 18 条链路、每条 50 GB/s。四个交换机还向外提供 72 条链路,用于构建更大系统。通过增加一层 NVLink 交换机,DGX pod 系统最多可连接 32 台 DGX 服务器,即 256 个 GPU。更大系统采用 InfiniBand 网络连接 DGX pod,每 GPU 配备一个 400 Gbps CX7 NIC。两个 x86 CPU 管理这些 GPU,另外最多配备 2 TB 内存,并通过独立 NIC 连接普通 WSC 网络。单台 DGX 服务器功耗最高为 10 kW。类似的 GPU 服务器在公有云和私有 WSC 中都很常见。第 7 章将从端到端的角度考察 DSA 系统设计。
除 DSA 广泛采用之外,WSC 计算系统还有两个重要趋势。在 x86 垄断二十年之后,所有主要云提供商如今都提供使用 Arm CPU 的服务器。AWS 和 Alibaba 已开发出自己的 Arm CPU 芯片,利用其庞大采购量,并创造针对自身 WSC 环境进一步优化的机会。与十年前的预期不同,这些 Arm CPU 配备强大的乱序执行核心,能够与 x86 对手竞争,参见 6.9 节的陷阱讨论。
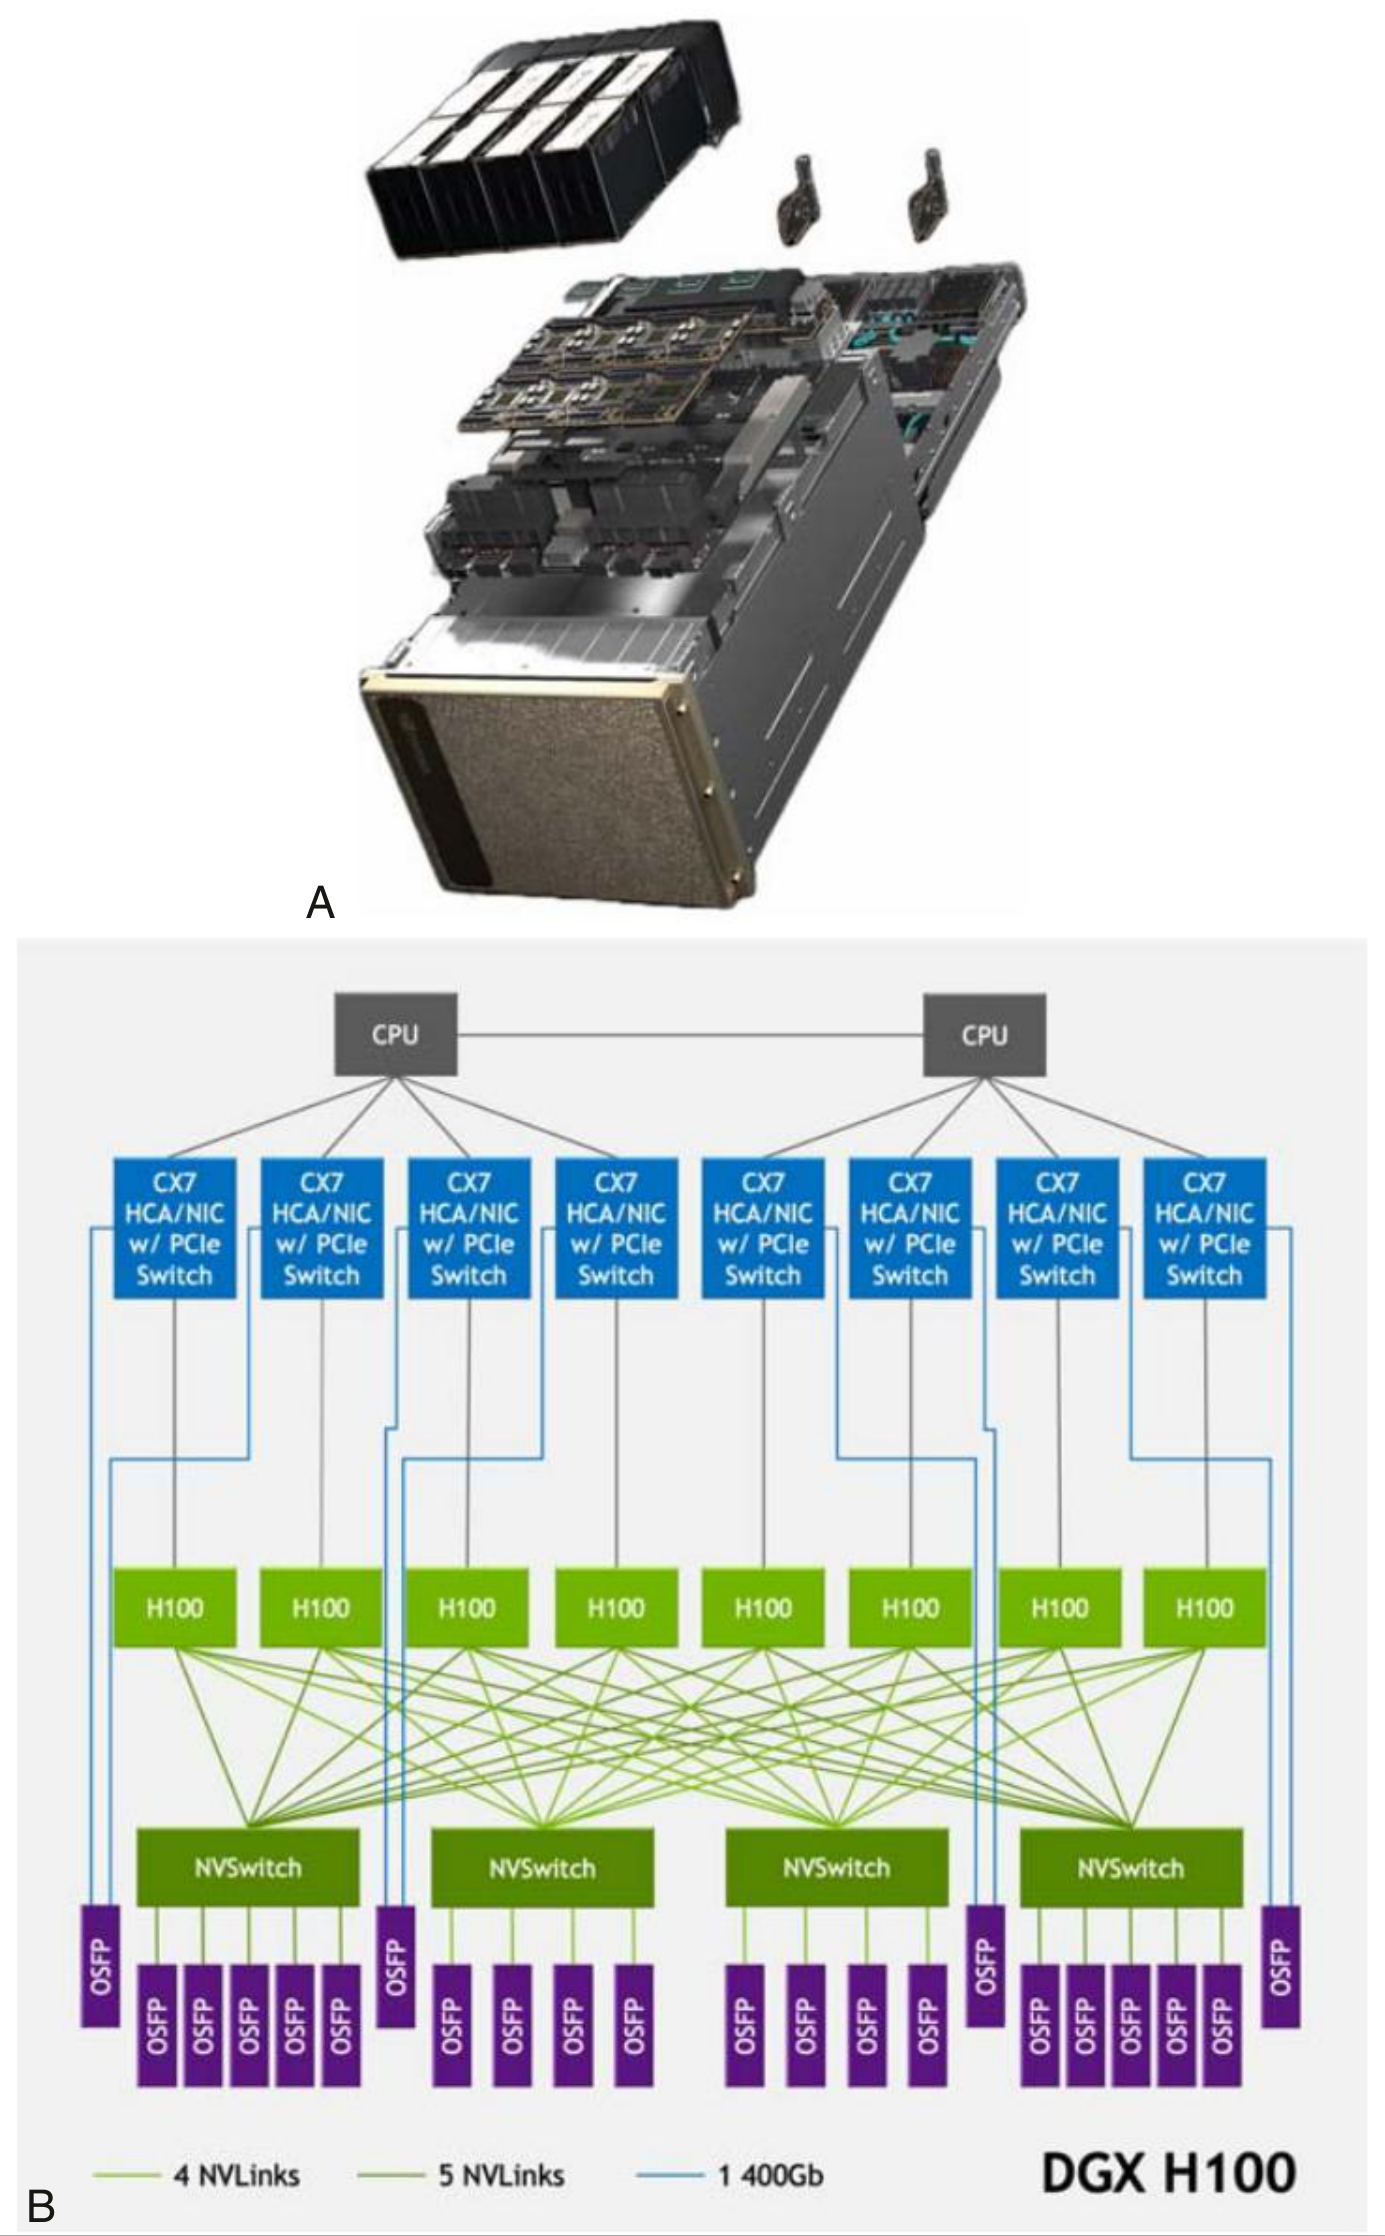
图内术语:CX7 HCA/NIC w/ PCIe Switch=带 PCIe 交换机的 CX7 主机通道适配器/网卡;4 NVLinks、5 NVLinks=四条、五条 NVLink 链路;1 400Gb=一条 400 Gb 链路;OSFP、NVSwitch、H100 保留产品或接口名称。
主存系统也正在发生重大变化。随着半导体缩放继续,CPU 芯片核心数量迅速增加。CPU 厂商还将多个 chiplet 共同封装,形成具有 64 个或更多核心的大型 CPU 插槽,每插槽功耗最高 400 W,需要很大的内存带宽。目前,CPU 集成内存控制器,通过 DDR 通道直接与 DRAM 模块通信。由于难以在 DRAM 工艺中设计更快的收发器,每个 DDR 引脚的速率限制在 3.2–8.4 Gb/s。相比之下,制造 CPU 的逻辑工艺可实现每引脚 64 Gb/s(PCIe)或 100 Gb/s(Ethernet)的收发器。新出现的趋势,是将部分或全部 DRAM 控制器移到独立的缓冲芯片中——这与 2000 年代中期以前的做法相似——并以 PCIe 级速率的链路连接 CPU 和缓冲芯片。缓冲芯片连接大量 DDR 通道,实现高容量、高带宽的内存系统。与 GPU 和其他 DSA 类似,CPU 封装也可能集成一定数量的堆叠式 HBM DRAM。Compute Express Link(CXL)联盟 推动的片外内存控制器趋势,还为内存系统设计创造了其他机会。CXL 缓冲芯片简化了新型非易失性存储技术的部署,也让少数服务器能够共享 DRAM 容量(Li 等,2023),类似 Yosemite sled 中四台服务器共享 NIC。基于交换的 CXL 网络可以进一步支持更大规模的内存分离。
WSC 的存储系统
许多 WSC 服务器包含本地存储,例如 1–8 块 HDD 或 Flash SSD。某些企业负载预期运行在具有本地设备的服务器上,或需要高于 WSC 网络能为单台服务器提供的存储吞吐量,因此必须使用本地存储。例如,八块基于 NVMe 的 SSD 可提供 400 Gbps 峰值读带宽。使用本地存储的 VM 必须认识到:磁盘或服务器失效时,数据会丢失。如果本地存储保存的并非临时数据,VM 软件就有责任保障持久性,例如将数据复制到多个实例。本地存储数据使用客户提供的密钥加密,以免物理硬件先后供不同 VM 使用时泄露数据。
大多数 WSC 负载把持久数据存储在分布式存储系统中。云提供商提供各种采用块、文件或对象接口的存储框架,后端使用 HDD 或 SSD,对应不同性能与价位。分布式存储系统有若干优势。计算硬件与持久化存储在物理上分离,简化了管理。VM 可以迁移,也可以在失效后重启,但仍通过网络连接同一存储卷或文件系统。保障持久性、进行故障和灾难恢复,以及扩展所分配存储容量与吞吐量的责任,都转移给了云提供商。
实现分布式存储的硬件组件,是称为 JBOD(just a bunch of disks)的磁盘阵列。图 6.13 展示 Meta Grand Canyon JBOD 阵列,在 4U 机箱内容纳 72 块 HDD。
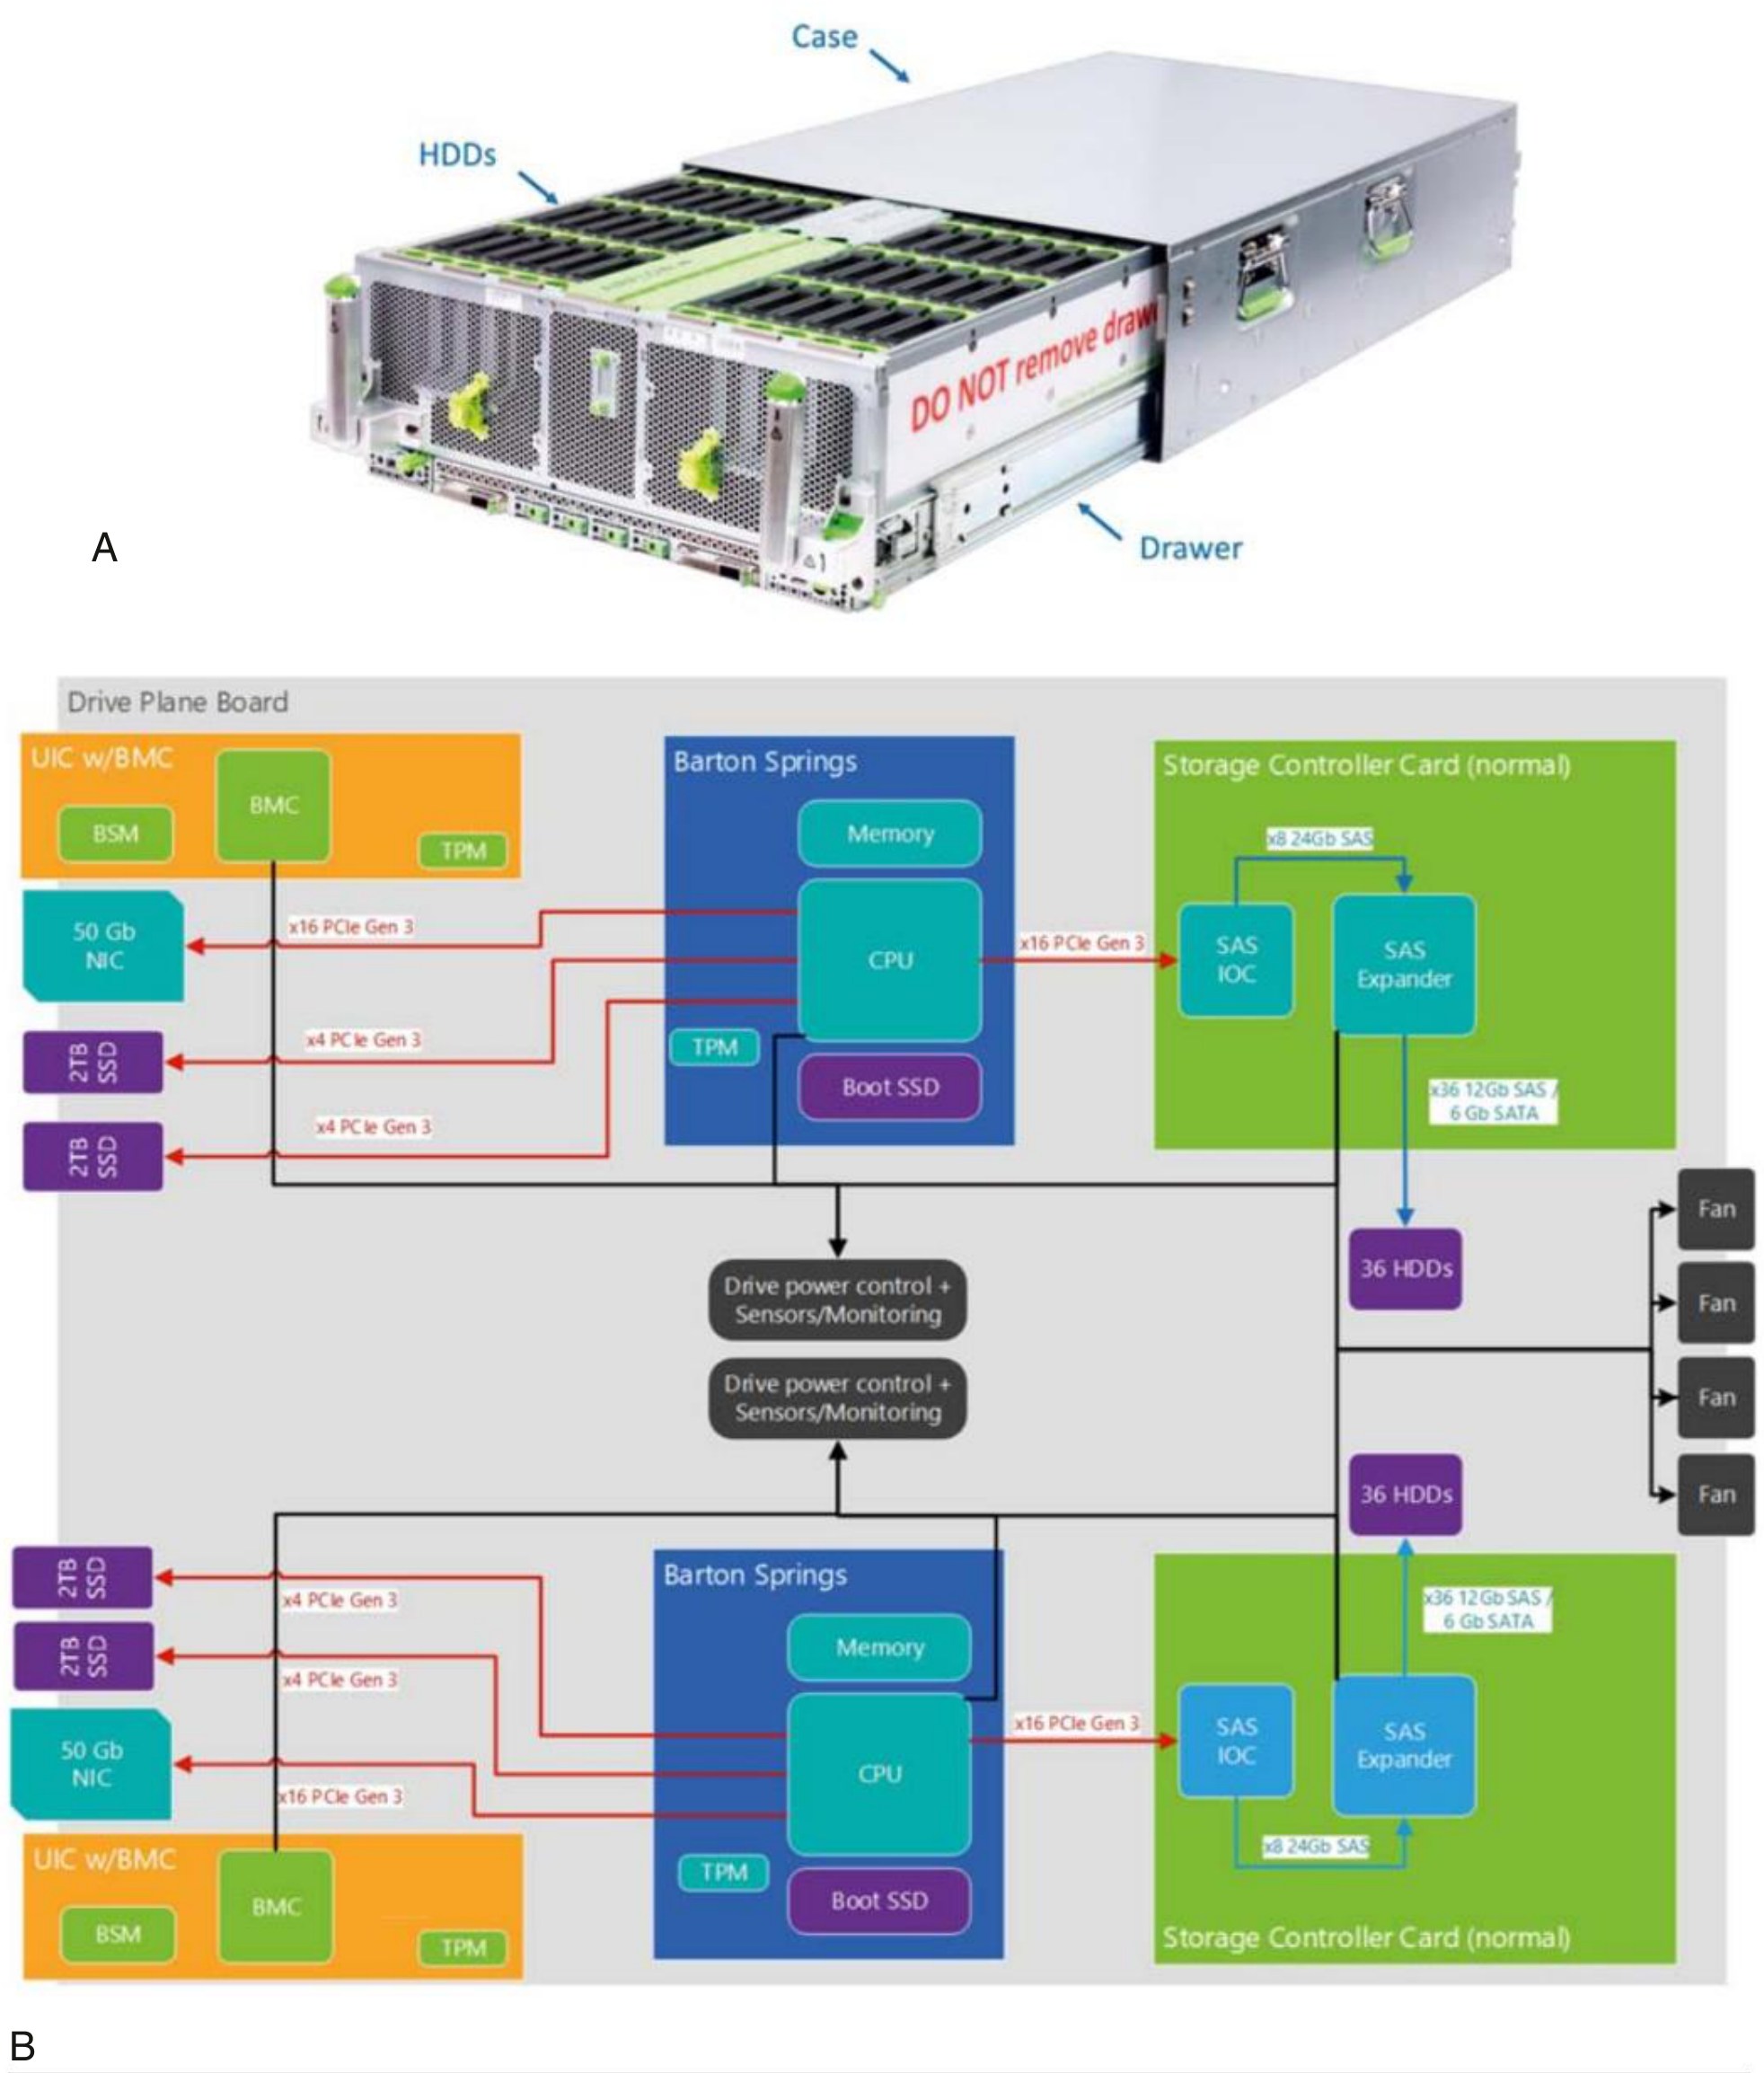
详细规范:Grand Canyon Storage System Specification。图内术语:Case=机壳;Drawer=抽屉;HDDs=机械硬盘;Drive Plane Board=驱动器背板;Memory=内存;Boot SSD=启动 SSD;Storage Controller Card (normal)=存储控制器卡(常规);SAS Expander=SAS 扩展器;Drive power control + Sensors/Monitoring=驱动器电源控制及传感器/监控;Fan=风扇。Barton Springs、UIC、BSM、BMC、TPM、SAS IOC、NIC 及总线规格保留原标识。
若每块 HDD 为 16 TB,这就是 PB 级存储设备。图 6.14 展示 Meta Lightning JBOF 阵列,它包含两个独立的 Flash 托盘。每个托盘有 15 个槽位,每槽可容纳两个 M.2 形态(2.5 英寸)的 SSD,或一个 U.2 形态(3.5 英寸)的 SSD。JBOD 与 JBOF 阵列包含供电、信号完整性、遥测和管理所需的设备,也支持热插拔。不过,阵列内部并不实现复制或 RAID 编码等可靠性机制。
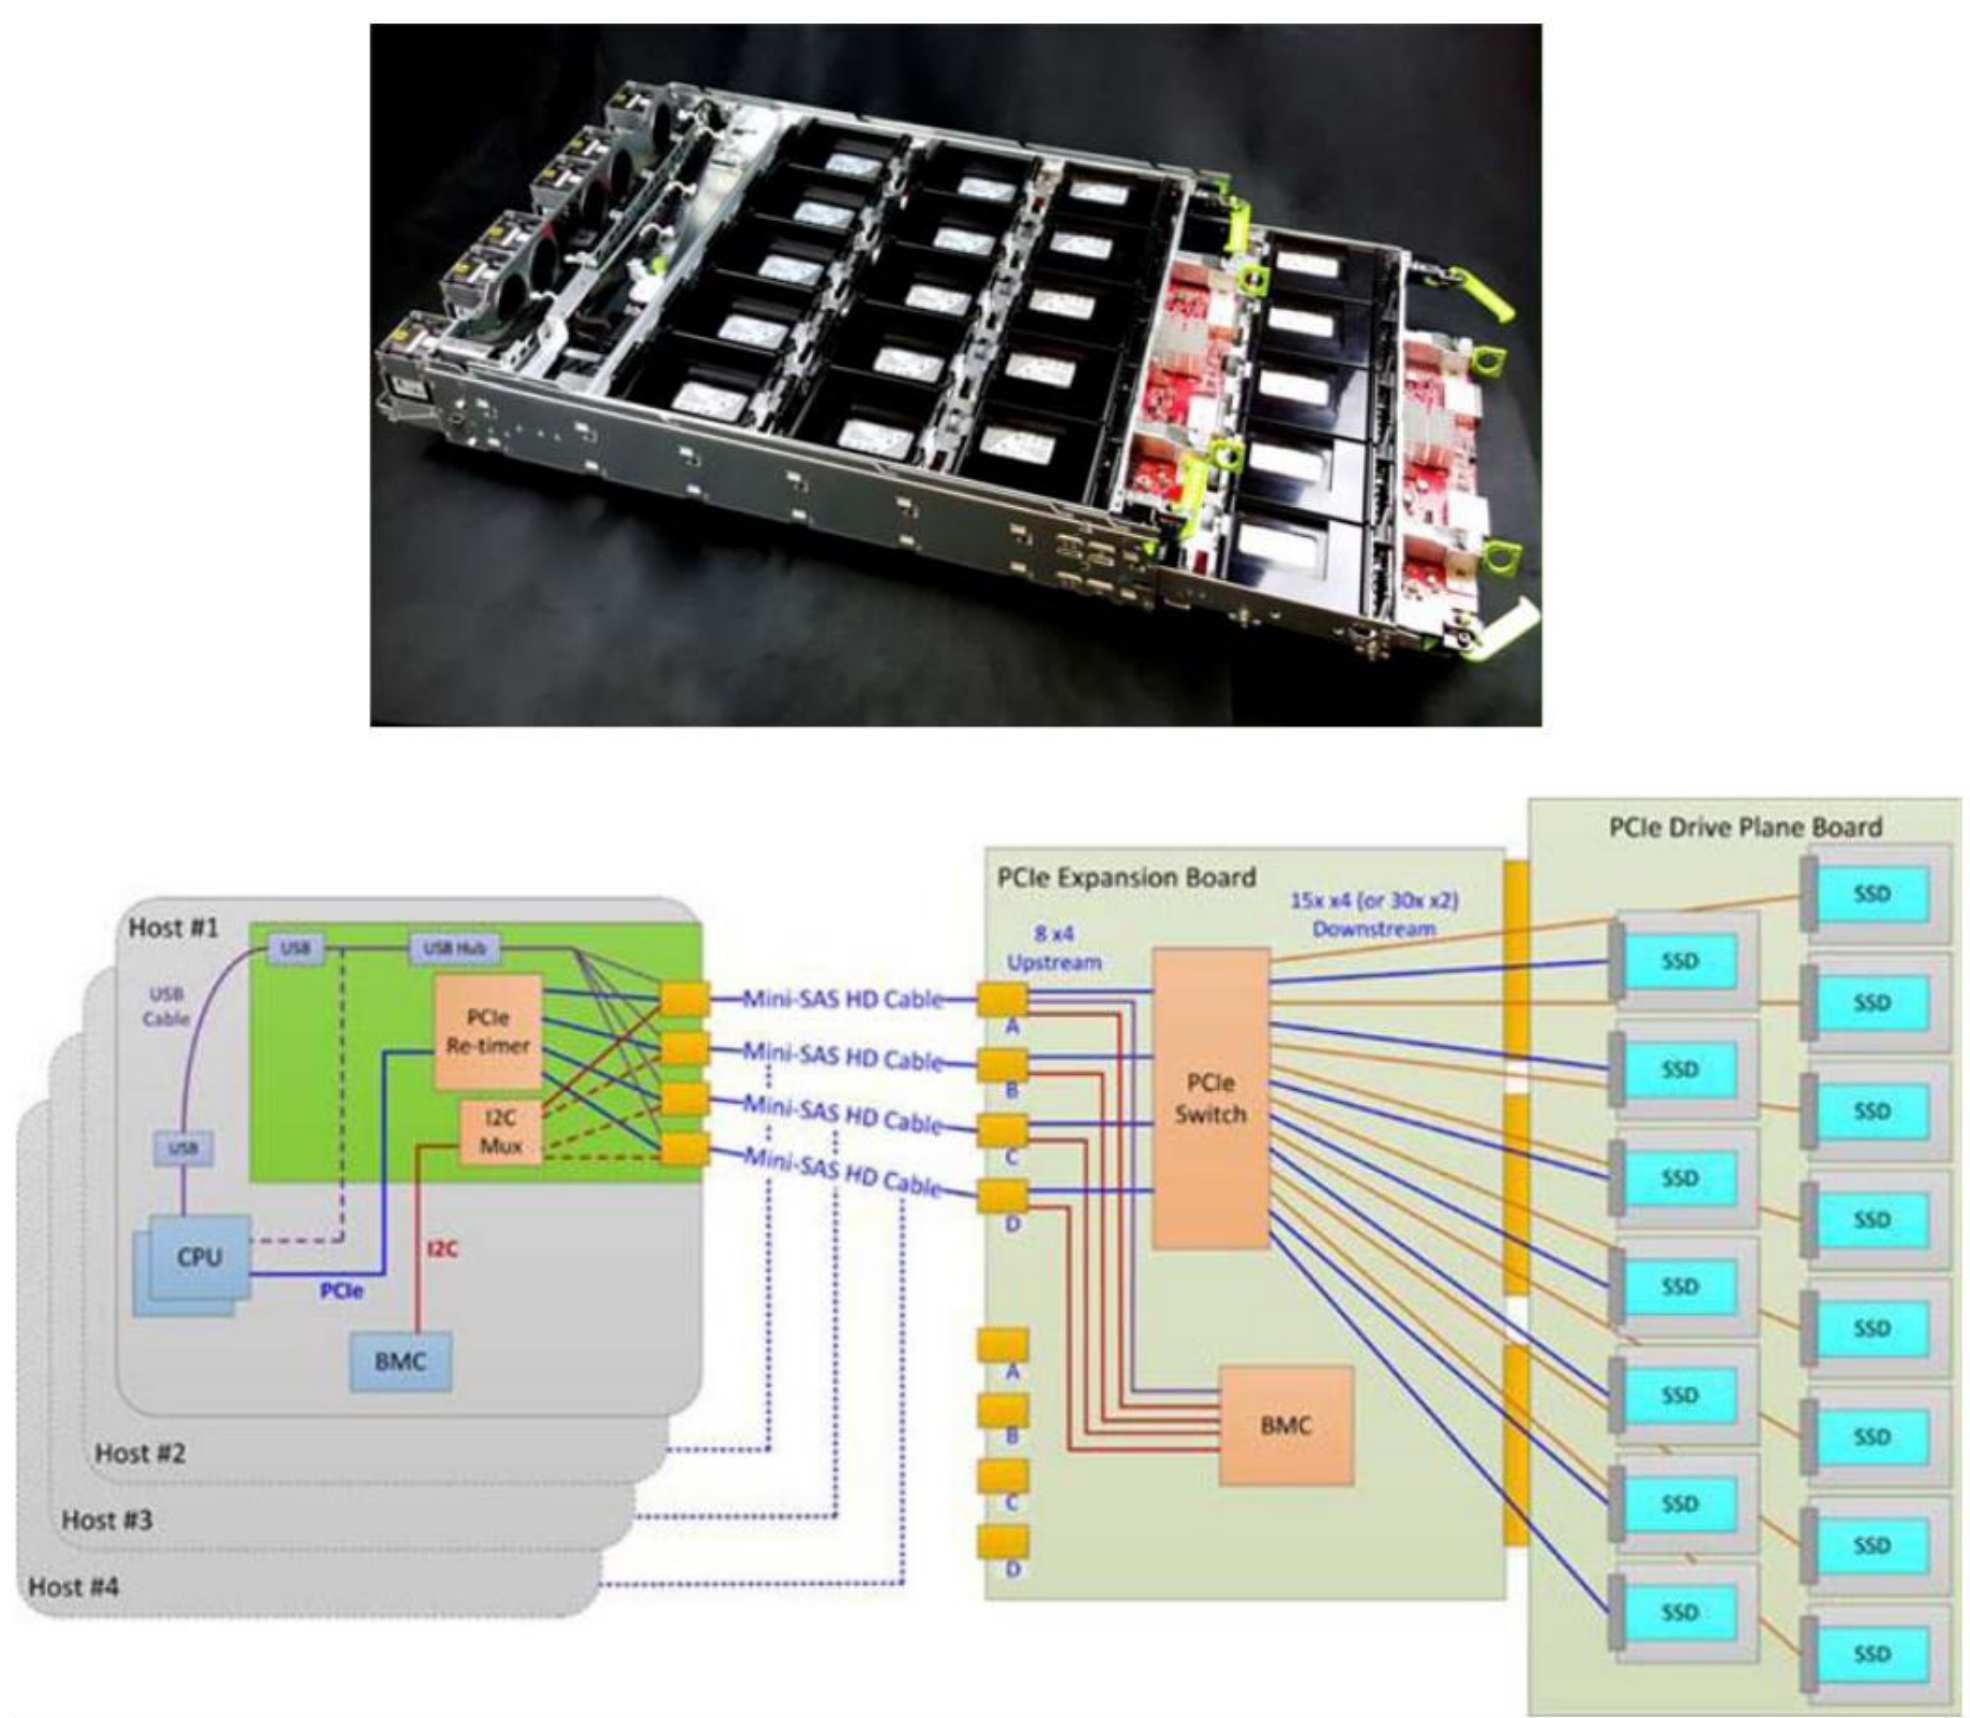
详细规范:Facebook Lightning Hardware Specification。图内术语:Host=宿主机;USB Cable=USB 电缆;USB Hub=USB 集线器;PCIe Re-timer=PCIe 重定时器;I2C Mux=I2C 多路复用器;Mini-SAS HD Cable=Mini-SAS HD 电缆;PCIe Expansion Board=PCIe 扩展板;PCIe Switch=PCIe 交换机;Upstream/Downstream=上行/下行;PCIe Drive Plane Board=PCIe 驱动器背板。
译注: 原文将 M.2、U.2 分别与“2.5 英寸”“3.5 英寸”并列。这两种接口/外形规范与上述尺寸并非固定对应关系。
这些阵列通过 PCIe 电缆连接机架中位于它们上方或下方的服务器,这些服务器通常称为头节点。服务器上运行的 WSC 存储软件实现分布式存储功能,包括跨机架、跨排、跨集群的复制或纠删码,使数据能够在 WSC 中各种失效情况下恢复:磁盘失效、机箱失效、服务器软硬件失效、机架失效或网络失效。只要副本或编码块分布在整个 WSC,无论是磁盘失效,还是服务 JBOD 阵列的网络链路失效,分布式存储软件都能以相同方式恢复数据。用统一机制处理多种失效情况,还能减少所需副本或编码块的总数。
WSC 体系结构设计者可以调整存储阵列的部署,为从热数据高速存储到低成本归档存储的不同场景进行优化。首先,可以部署针对吞吐量或容量优化的不同 HDD 与 SSD。其次,可以调整头节点数量、阵列与头节点之间的连接带宽,以及分配给 WSC 网络连接的带宽。例如,一个 Lightning JBOF 托盘既可由单个头节点通过一条 x8 PCIe 连接提供服务,也可由四个节点通过四条 PCIe 连接提供服务。最后,可以调整容错机制,在速度与存储开销之间权衡。三副本方案能容忍两块磁盘失效,恢复即时,但存储开销为 200%。相比之下,Reed–Solomon 码能够降低容错开销,却会引入恢复延迟。例如,RS(9,6) 码为每组六个数据块增加三个块,存储开销为 50%,恢复任一失效块时需要读取六个块。RS(14,10) 码的开销为 40%,但恢复任一失效块需要读取十个块。
WSC 的网络系统
随着 WSC 节点数量增加,以及每个节点计算或存储能力提高,WSC 网络流量迅速增长。图 6.15 显示,Google WSC 服务器之间的网络流量在短短十年间增长到 235 倍。显然,若不精心设计,WSC 网络很容易成为性能或成本瓶颈。
理想的 WSC 网络是一台完美的交叉开关,能够以全对分带宽连接 50,000–100,000 个节点:所有两两配对的节点都可以同时以各自 NIC 的全速通信,例如 100 Gbps。WSC 网络还必须具有韧性:即使大型系统中偶尔有网络链路或交换机失效,服务器仍应能高速通信。遗憾的是,这种理想交换机不切实际,因为对于 个端口或节点,其成本按 增长。到 2010 年代初,人们已经清楚,任何企业网络方案都无法满足 WSC 的规模与成本要求。因此,云提供商开发出新一类 WSC 网络,将超级计算的思想——拓扑结构——与商用网络的思想——交换芯片和传输协议——结合起来。
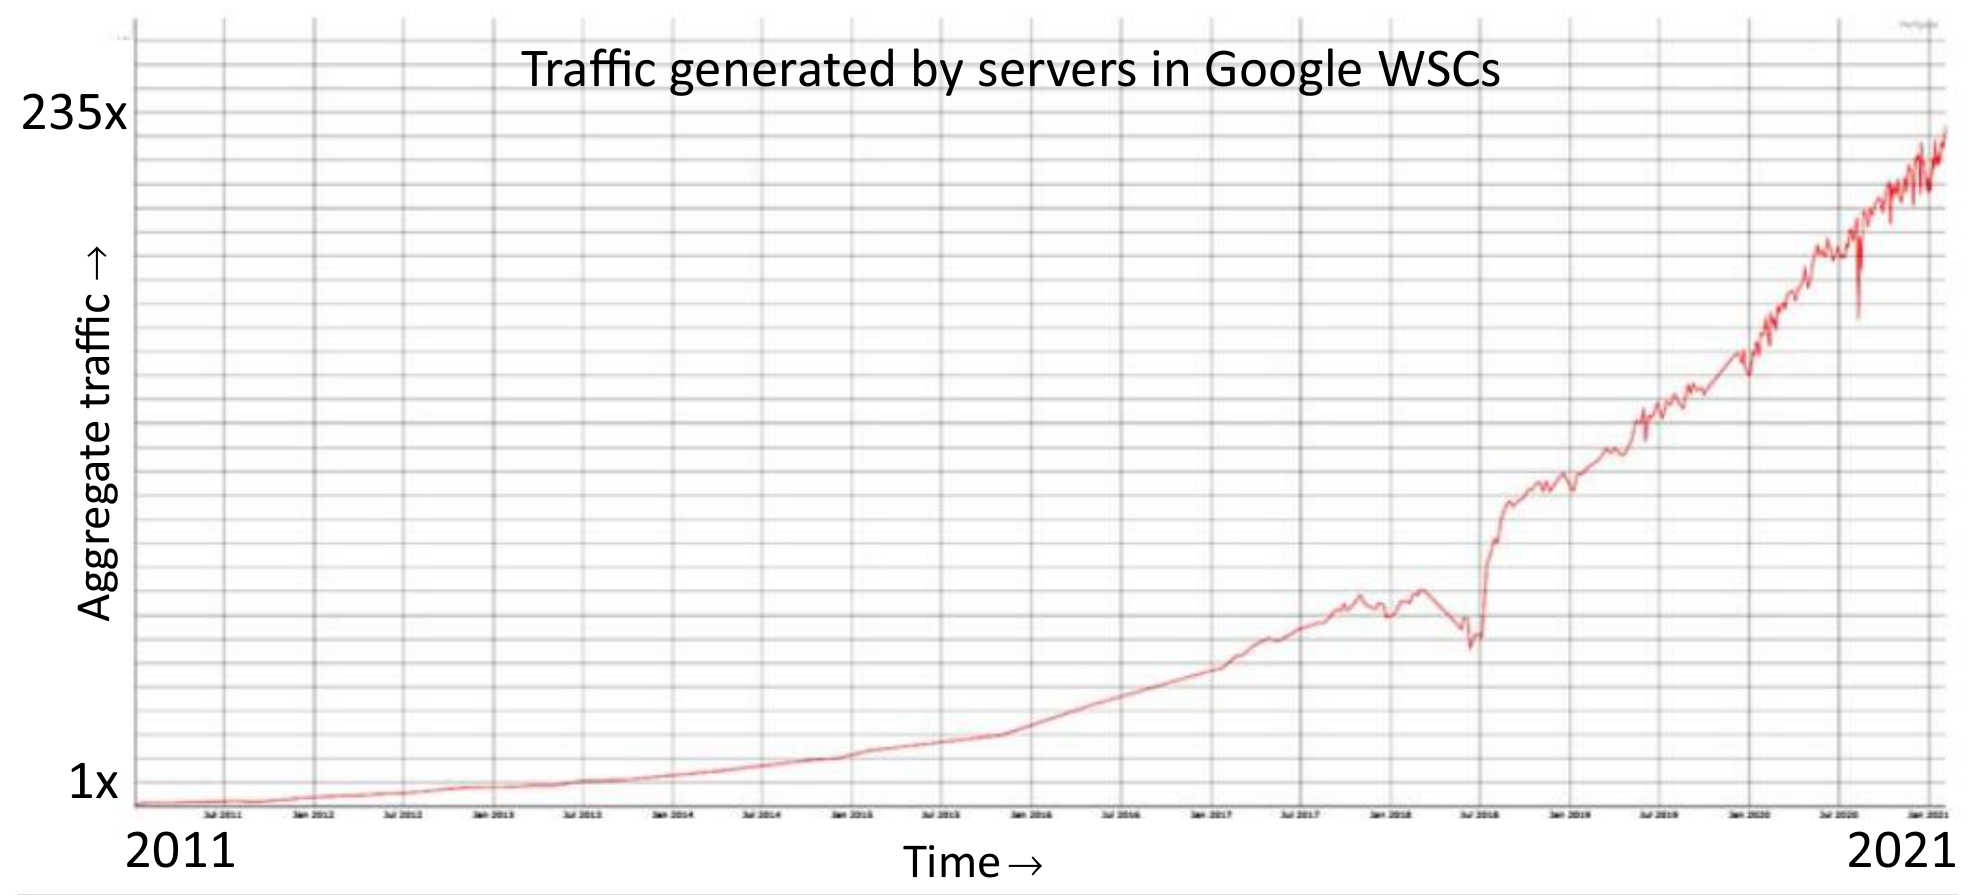
图内术语:Traffic generated by servers in Google WSCs=Google WSC 服务器产生的流量;Aggregate traffic=总流量;Time=时间;1× 与 235× 为相对起点的倍数。
现代 WSC 网络采用多级拓扑,例如 Clos 拓扑。这种拓扑最初为电路交换电话网而发明,以形式化研究其性质的电信专家命名(Clos,1953)。多级交换机使其能以显著更低的成本,逼近大型交叉开关的连通能力。图 6.16 展示 WSC 中 Clos 网络的一般结构。第一级是每个机架上的机架顶部交换机(top-of-the-rack,TOR),也称 L1 交换机。TOR 以向下的链路连接服务器,以向上的链路连接一组叶交换机(leaf,L2)。每个叶交换机连接全部脊交换机(spine,L3)。通过增加叶交换机组,这种模块化拓扑可以扩展到数万个节点;也可以遵循叶到脊的连接模式,增加更多层级。附录 L 深入讨论互连网络,包括拓扑和交换机微体系结构。
Clos 拓扑具有成本效益,因为三个层级的交换系统都由同一种商用交换芯片构建。图 6.17 展示 Google Jupiter 互连所用的交换机;这是 Google 第五代定制 WSC 网络,于 2012 年首次部署(Singh 等,2015)。TOR、叶和脊交换机都由一块或多块板卡实现,每块板卡包含四个 16 端口交叉开关芯片。达到最大规模时,Jupiter 的对分带宽高达每秒 1.3 Pbit( bit)。请注意,整个互联网的对分带宽可能只有 0.2 Pbit/s;原因之一是 Jupiter 专为高对分带宽而建,互联网则不是。图 6.18 回顾了 Google 五代定制 WSC 网络中,各级交换机的演变。
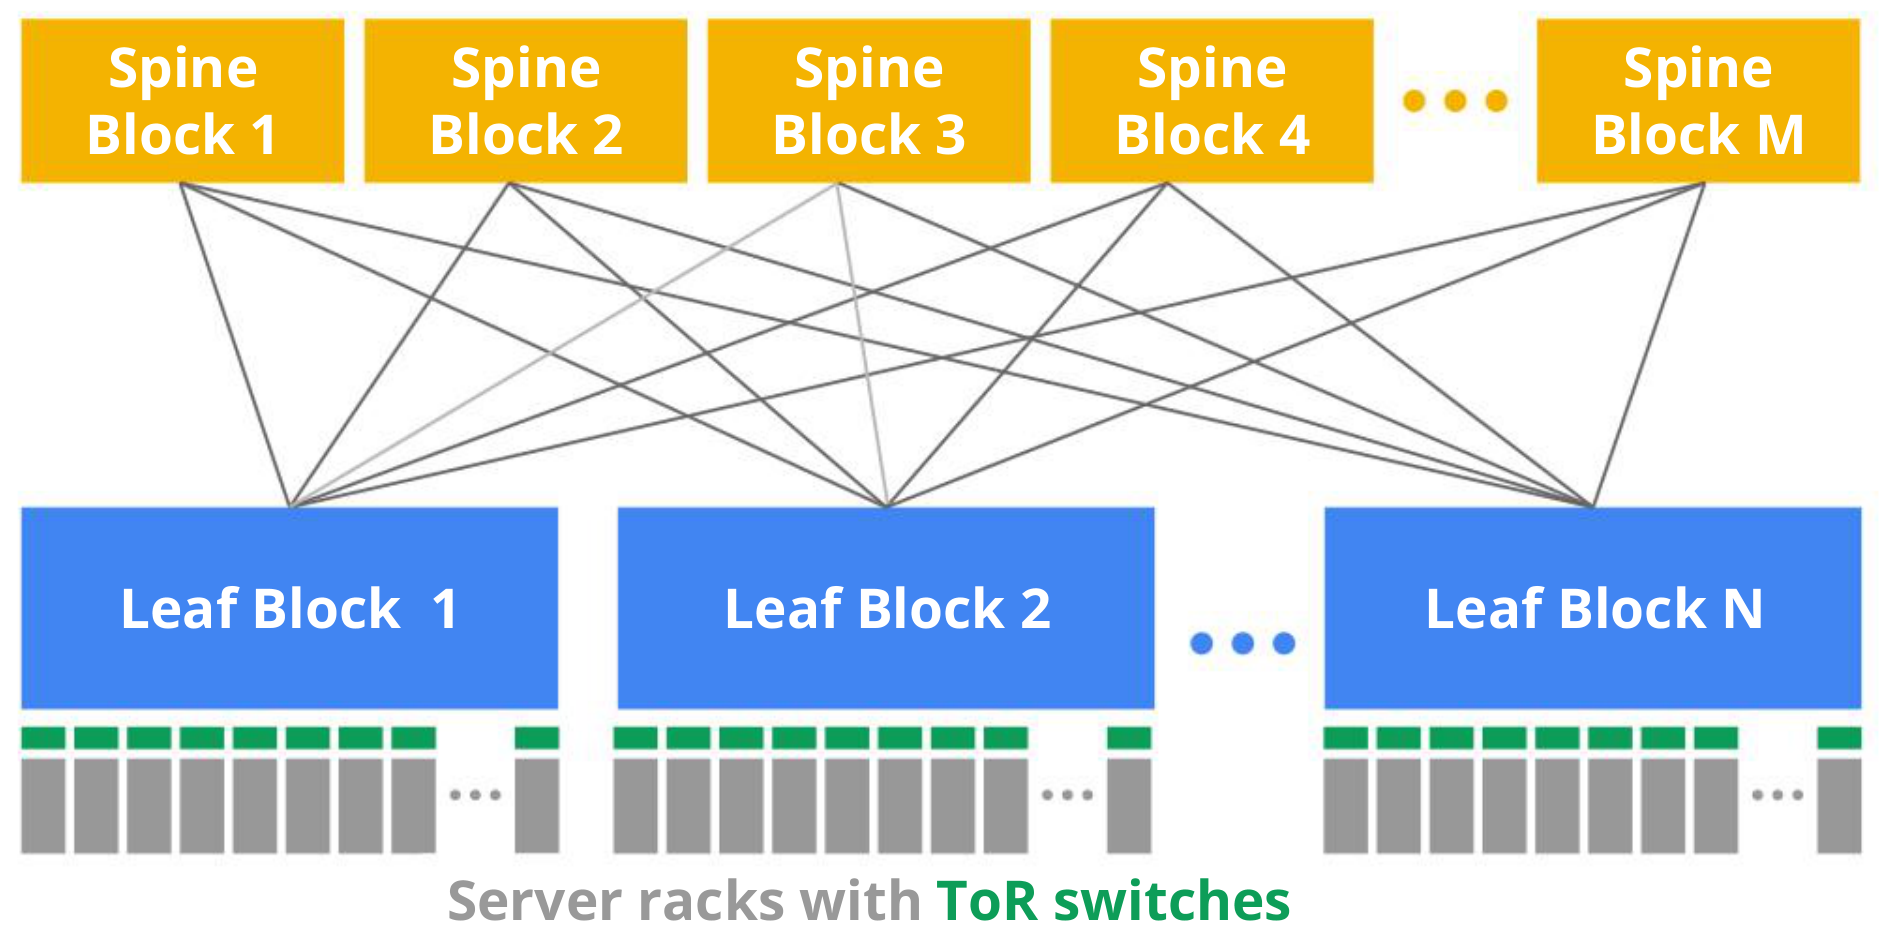
图内术语:Spine Block=脊交换模块;Leaf Block=叶交换模块;Server racks with ToR switches=带 TOR 交换机的服务器机架。
Clos 拓扑通常不提供全对分带宽。在上述 Jupiter 配置中,每个 TOR 交换机的下行与上行带宽比为 3∶1,称为 3∶1 超额订阅比(oversubscription ratio)。任意两台服务器都能以链路最高速率 40 Gbps 通信;但若一个机架内的全部服务器同时向其他机架发送数据,每台服务器的有效带宽就只有最高速率的三分之一。WSC 中不同通信路径相互重叠,叶与脊交换机的拥塞也会限制有效带宽。WSC 运营商采用多种技术减轻超额订阅与拥塞:把不太可能同时向网络核心全速发送的负载放在同一机架;尽量把分布式工作负载的进程调度到相邻位置,使大部分流量只经过一个 TOR 或一个叶交换机。遗憾的是,容错要求又倾向于把这些进程均匀分散到整个 WSC,以确保任一链路或机架失效对可用性的影响尽量小。运营商还会随机选择连接通过多路径 Clos 网络的路径,尽量均匀地分散流量,避免网络核心拥塞。
图 6.17 的 Clos 实现天然具有容错能力。任意两个 TOR 都能通过叶模块和脊模块中的多条路径通信。叶或脊模块中任何单条链路、单个芯片的失效,都不能使 TOR 断网。一些云部署在机架中放置一对冗余的 TOR 交换机,使不具备容错能力的应用免受 TOR 失效或维护的影响。
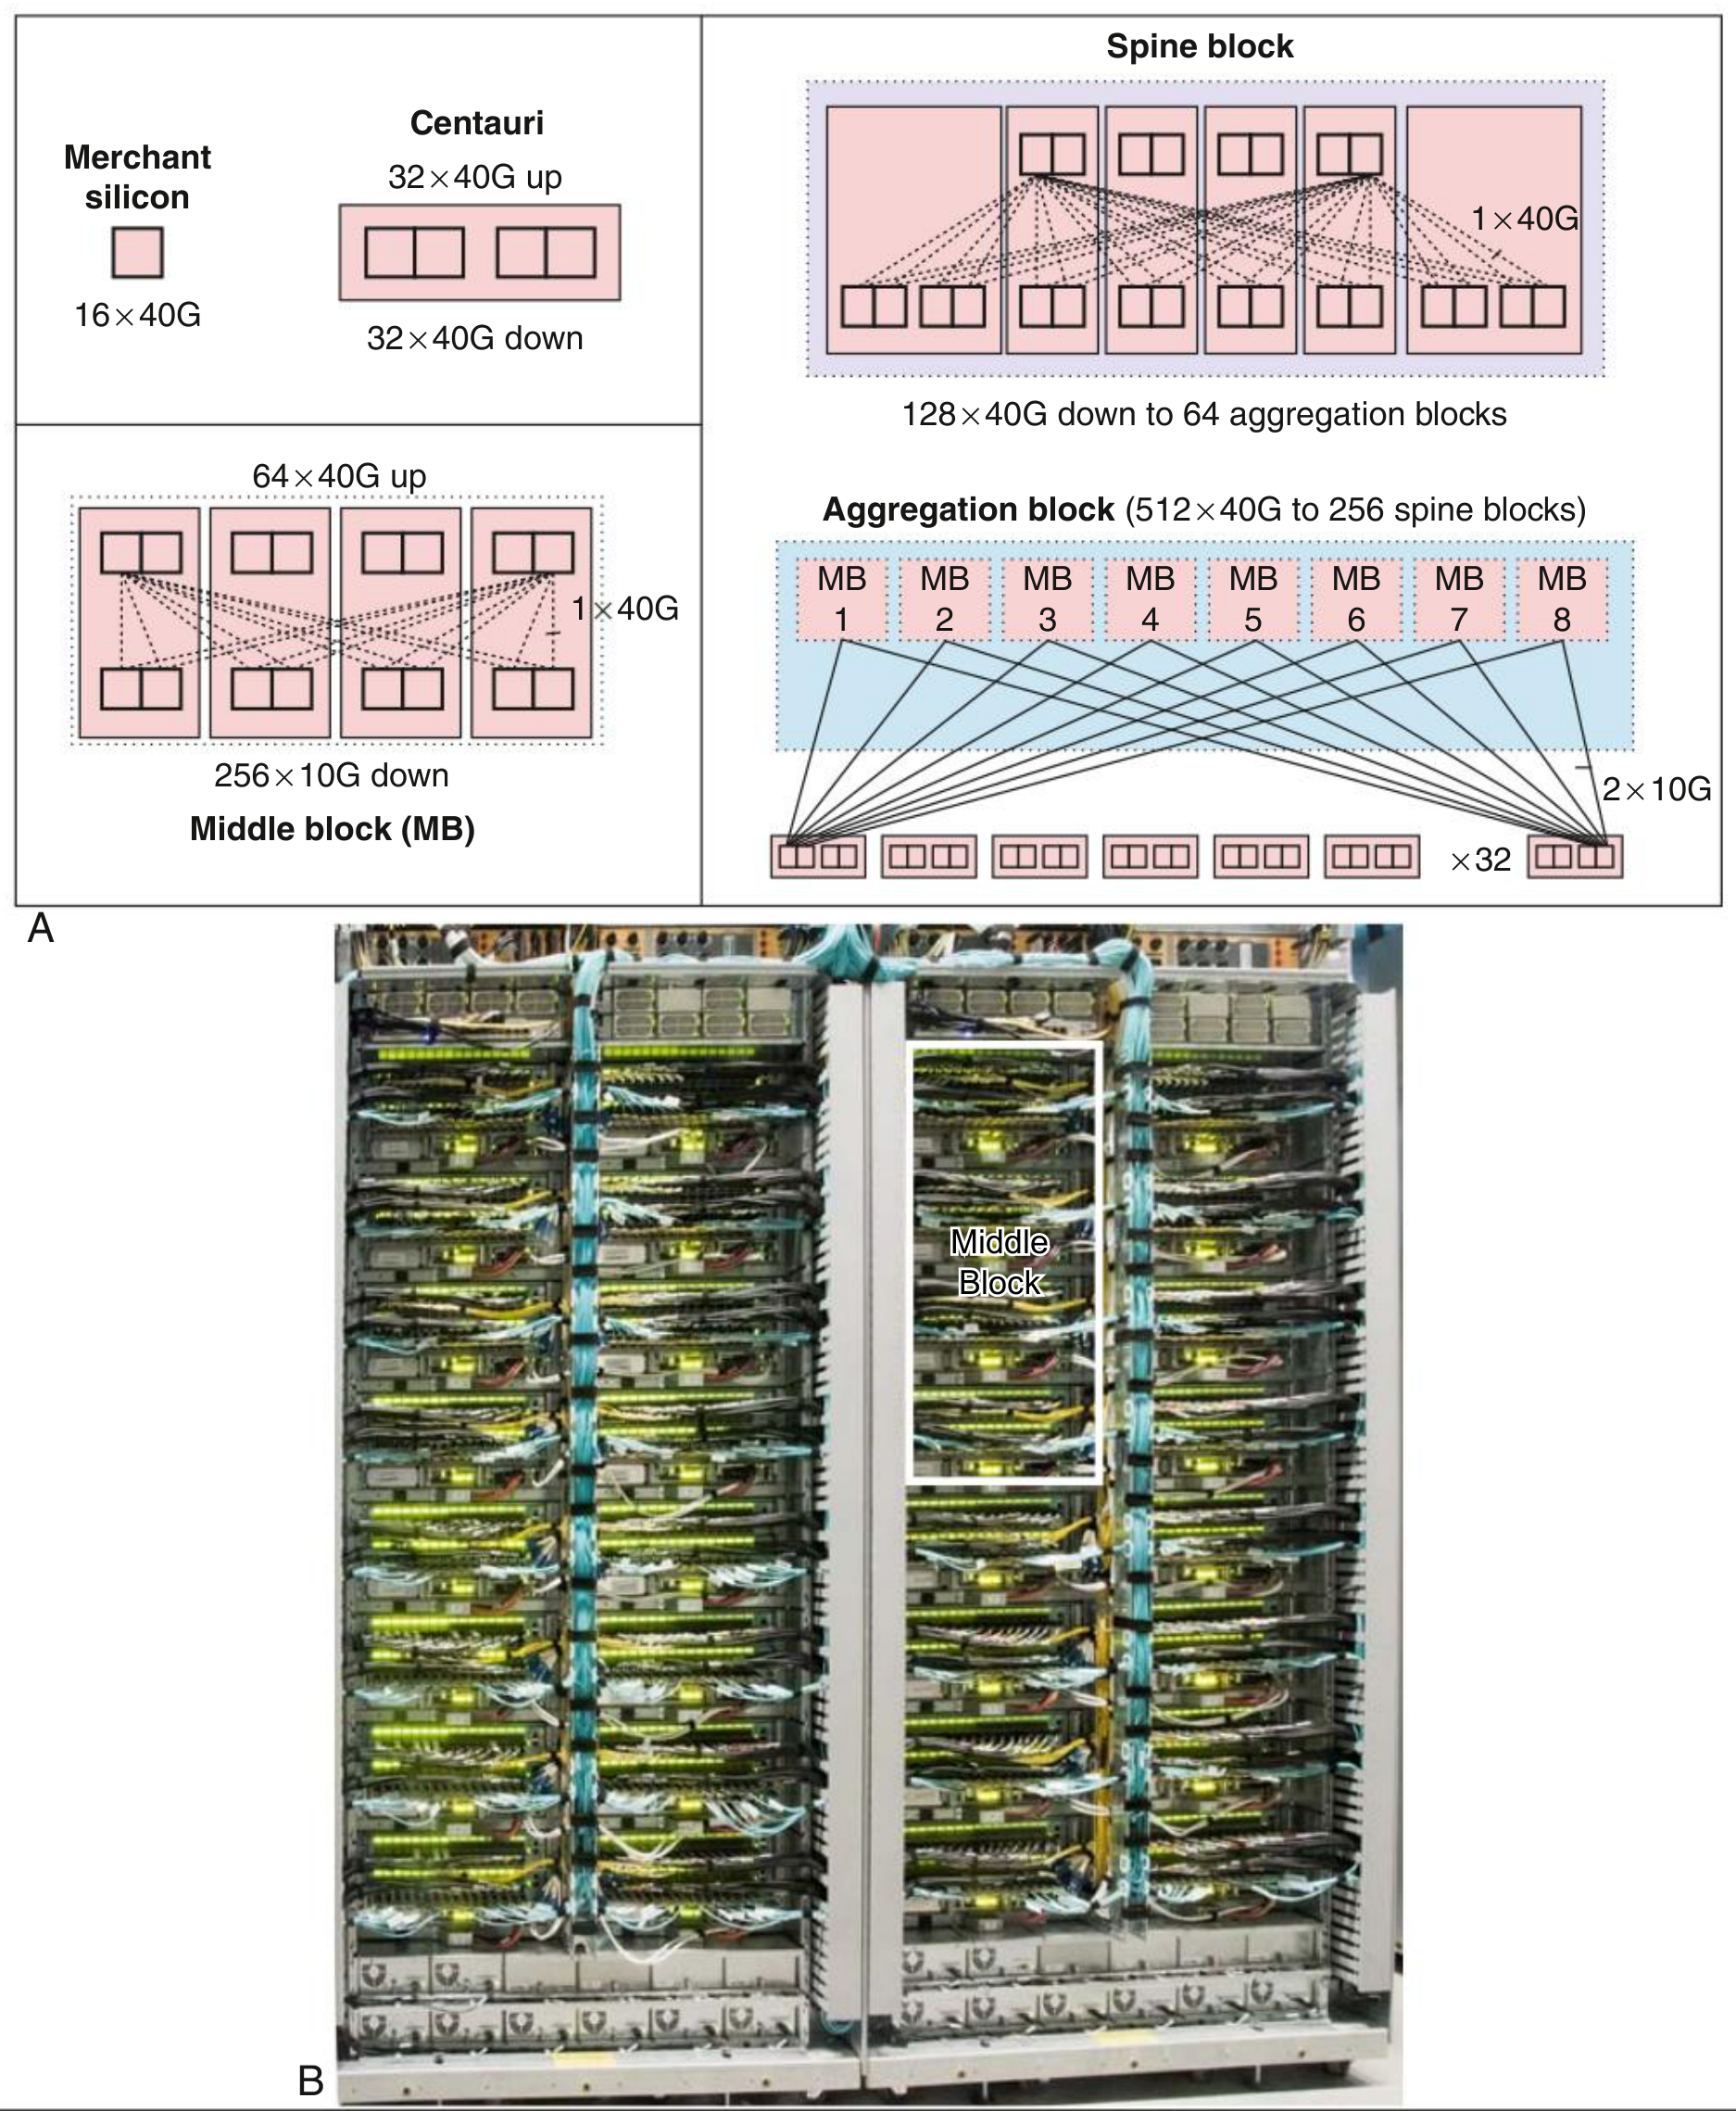
图内术语:Merchant silicon=商用交换芯片;Middle block(MB)=中间交换模块;Spine block=脊交换模块;Aggregation block=汇聚模块;up/down=上行/下行。图中速率与端口标记保持原样。
译注: 图中 middle block 下行标为“256 × 10G”,下方汇聚连接又标有“2 × 10G”;图注与随后例题则按 64 条 40 Gbps 下行、成对 40 Gbps 连接计算。正文说明了 40 Gbps 链路可以拆分为四条 10 Gbps 链路,但图示与例题并非完全相同的端口配置,阅读时应分别对应。
使用更新的商用交换芯片,可以设计类似的 Clos 拓扑。例如,Broadcom 于 2022 年发布的 Tomahawk 5,可以充当连接 800 Gbps 链路的 64 端口交叉开关、连接 400 Gbps 链路的 128 端口交叉开关,或连接 200 Gbps 链路的 256 端口交叉开关。这些选项为芯片使用方式带来额外灵活性。设计者可在拓扑核心采用更高速率,而在机架内部采用每链路 200 Gbps,以最大化系统中可连接的服务器端口数。
例题
利用图 6.17 中的构件,Jupiter 拓扑最多能支持多少台服务器?假设每台服务器通过一条 40 Gbps 链路连接 TOR,TOR 层的超额订阅比为 3∶1。还假设每个 TOR 到每个 middle box、每个汇聚模块到每个脊模块,都使用一对冗余的 40 Gbps 链路。如果 TOR 层的超额订阅比为 1∶1,容量又是多少?
解答
先回顾图 6.17 中的构件:
- 脊模块(L3)向汇聚模块提供 128 条 40 Gbps 下行链路。每个汇聚模块通过一对冗余链路连接每个脊模块,因此系统最多有 个汇聚模块。
- TOR(L1)具有 64 个 40 Gbps 端口。3∶1 超额订阅配置使用 48 条下行链路连接服务器,16 条上行链路连接汇聚模块。这 16 条上行链路足以按每处一对冗余链路,连接汇聚模块中的八个 middle box。
- 在汇聚模块(L2)层,每个 middle box 有 64 条连接 TOR 的下行链路,因此每个 middle box 可连接 32 个 TOR。
系统最大服务器数量为:
实际服务器数量会更少,因为某些汇聚模块用于连接其他 WSC 集群和公共互联网。不过,也可将每条 40 Gbps 链路拆分为四条 10 Gbps 链路,以较低的单服务器带宽支持更多服务器。
超额订阅比为 1∶1 时,每个 TOR 有 32 条上行和 32 条下行链路。假定汇聚模块设计不变,每个汇聚模块现在可容纳 16 个 TOR,每个 TOR 用四条链路连接每个 middle box。系统最大服务器数量为:
要容纳更多服务器,就必须使用更多汇聚模块和更大的脊模块。虽然机架内大量服务器高速发送时,超额订阅可能造成拥塞,但对于连接给定数量的服务器,它能够大幅降低 WSC 网络成本。
| 数据中心网络代际 | 首次部署 | 商用交换芯片 | TOR 配置 | 边缘汇聚模块 | 脊模块 | 网络内部速率 | 主机速率 | 对分带宽 |
|---|---|---|---|---|---|---|---|---|
| Four-Post CRs | 2004 | 厂商设备 | 48 × 1 Gbps | — | — | 10 Gbps | 1 Gbps | 2 Tbps |
| Firehose 1.0 | 2005 | 8 × 10 Gbps;TOR 为 4 × 10 Gbps | 上行 2 × 10 Gbps;下行 24 × 1 Gbps | 2 × 32 × 10 Gbps | 32 × 10 Gbps | 10 Gbps | 1 Gbps | 10 Tbps |
| Firehose 1.1 | 2006 | 8 × 10 Gbps | 上行 4 × 10 Gbps;下行 48 × 1 Gbps | 64 × 10 Gbps | 32 × 10 Gbps | 10 Gbps | 1 Gbps | 10 Tbps |
| Watchtower | 2008 | 16 × 10 Gbps | 上行 4 × 10 Gbps;下行 48 × 1 Gbps | 4 × 128 × 10 Gbps | 128 × 10 Gbps | 10 Gbps | n × 1 Gbps | 82 Tbps |
| Saturn | 2009 | 24 × 10 Gbps | 24 × 10 Gbps | 4 × 288 × 10 Gbps | 288 × 10 Gbps | 10 Gbps | n × 10 Gbps | 207 Tbps |
| Jupiter | 2012 | 16 × 40 Gbps | 16 × 40 Gbps | 8 × 128 × 40 Gbps | 128 × 40 Gbps | 10/40 Gbps | n × 10 Gbps / n × 40 Gbps | 1300 Tbps |
WSC 网络包含大量链路,因此电缆成本与布线复杂性是重要考虑因素。目前,服务器与 TOR 之间通常采用成束铜缆。例如,一条 200 Gbps 链路可能由四根各 50 Gbps 的电缆,或两根各 100 Gbps 的电缆组成。在 1–3 m 的短距离、100–400 Gbps 的链路速率下,铜缆实用且具有成本效益。L1、L2、L3 交换机之间的链路长得多,达到几十至几百米,且速率更高,因此优先采用光缆。光缆往往预先捆扎成束,以降低 WSC 部署复杂性。随着配备 GPU 或其他 DSA 的服务器需要越来越高的带宽,服务器到 TOR 的铜缆连接越来越难实现。我们或许很快就会看到以下技术在数据中心广泛部署:含中继器的有源铜缆,用于扩大铜缆的传输距离和带宽;或与计算芯片共同封装的光收发器,用于降低服务器到 TOR 连接的光收发器成本与功耗。
为 WSC 安装 100,000 台服务器,需要数月乃至数年;装满之后,还会逐步用最新硬件升级。叶交换机可以按需添加和更换,不影响网络其他部分;脊交换机则带来困难的权衡。如果随着 WSC 装机逐步增加脊交换机,每次添加都须大量调整叶与脊之间的布线,造成长时间的性能下降。如果一开始就安装全部脊交换机,则可预先铺好未来叶交换机所需的线路;但这也意味着脊交换机采用数据中心中最老的技术。若 Clos 网络最初使用 100 Gbps 链路,将部分叶交换机升级为 200 Gbps,并不会提高带宽,除非脊交换机也升级。这一矛盾促使 WSC 运营商在叶与脊之间加入一层光电路交换机(optical circuit switch,OCS)。OCS 是微机电系统(MEMS),可在毫秒内重新编程,改变输入光纤与输出光纤的连接。它只反射光,不作分组级决策,因此与链路速率无关。图 6.19 展示 Google 如何使用 OCS 层,支持 Jupiter 网络中叶模块和脊模块的逐步部署,让每个阶段都能针对现有叶交换机构建尽可能好的拓扑(Poutievski 等,2022)。随着交换机逐步增加,所有布线也都可以增量完成。
Google 工程师又将这一想法推进一步,用 OCS 完全替代脊交换机。叶交换机只连接 OCS,OCS 之间也有直接连接。图 6.20 展示 Google 如何编程设置 OCS 内部连接,配置叶交换机之间所需的拓扑与连接速率(Poutievski 等,2022)。请注意,一对采用 200 Gbps 链路的新叶交换机,现在能直接以全速通信,即使它们与所有其他旧叶交换机通信时仍须降至 100 Gbps。之所以能做到这一点,是因为 OCS 与脊交换机不同,它只反射光,与速率无关。
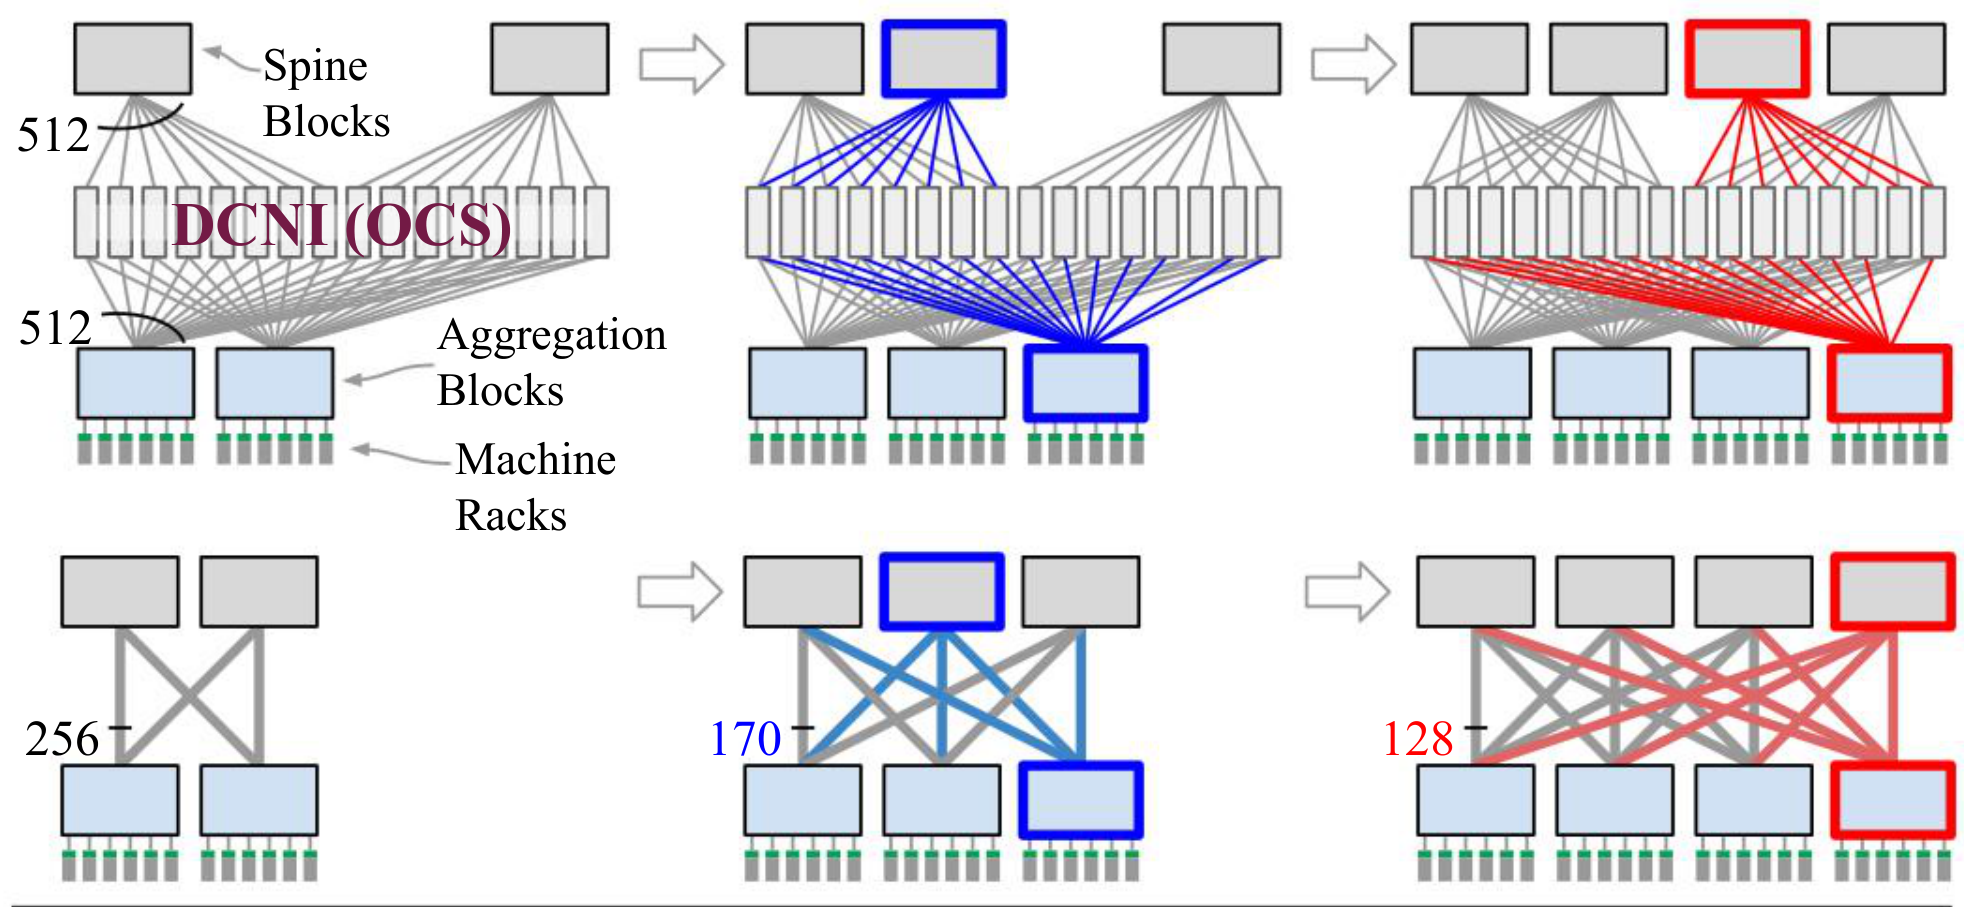
图内术语:Spine Blocks=脊模块;Aggregation Blocks=汇聚模块;Machine Racks=机器机架;DCNI (OCS)=由 OCS 实现的 DCNI 光交换层。
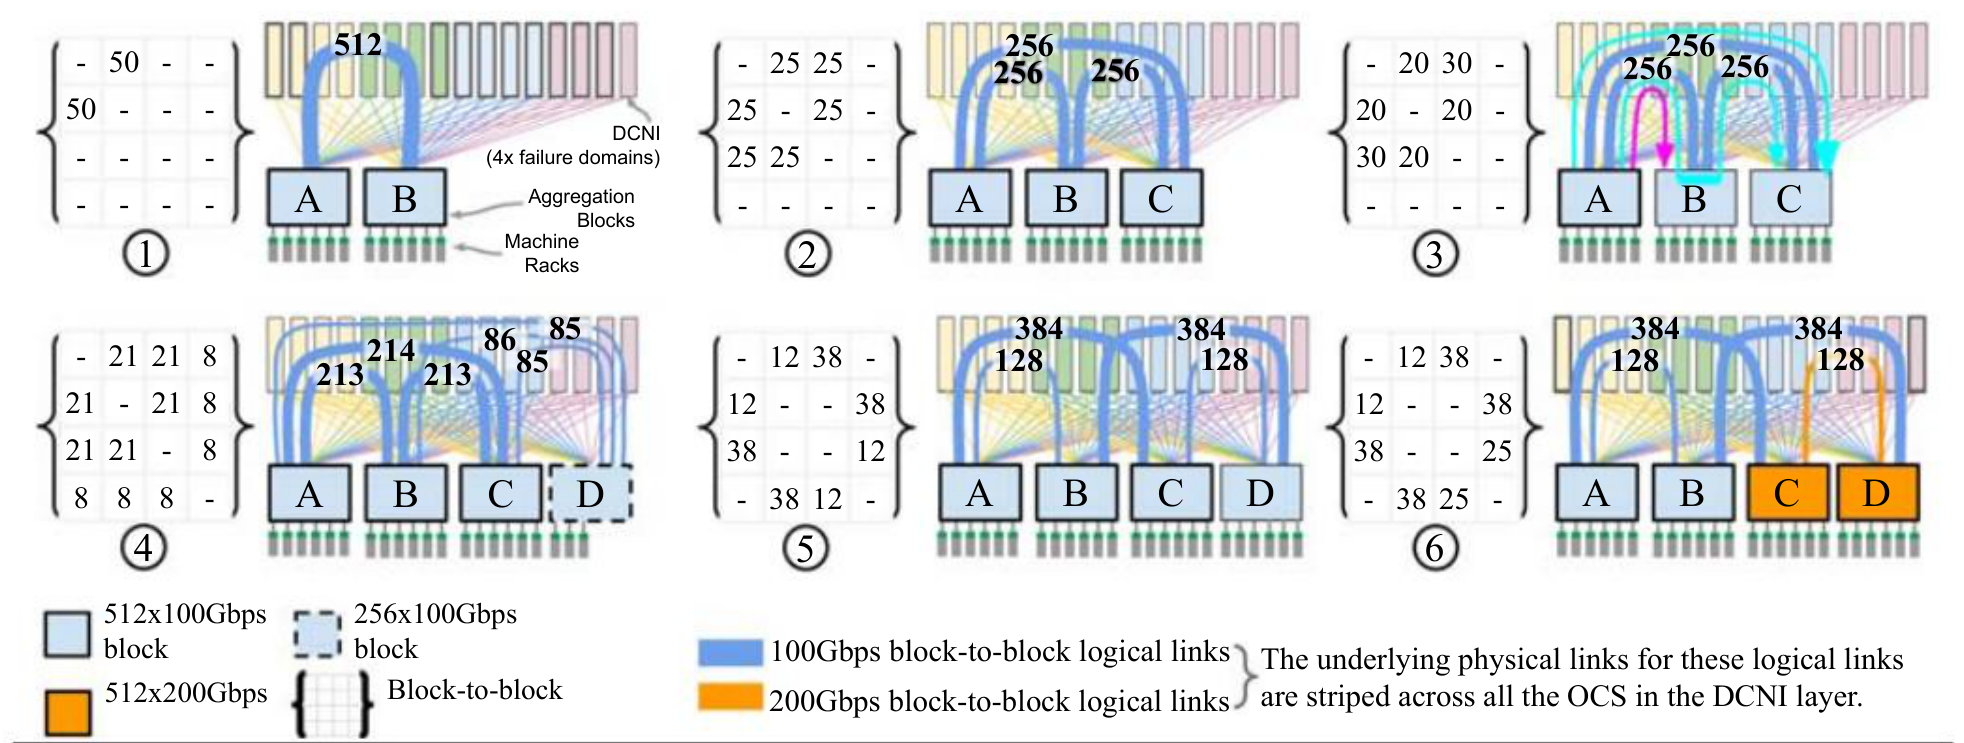
图内术语:DCNI (4× failure domains)=DCNI(四个故障域);block-to-block=模块间;100/200 Gbps block-to-block logical links=100/200 Gbps 模块间逻辑链路;512×100 Gbps、256×100 Gbps、512×200 Gbps block=具有相应链路数量与速率的模块。图下注明:这些逻辑链路对应的底层物理链路,分条带分布在 DCNI 层的全部 OCS 上。A–D 与六幅需求矩阵的数值保持原图。
从整体看,Clos 拓扑的脊层提供一种机制,将流量分散并均衡到接收节点所在叶模块的全部链路。这种分散方式能很好地处理许多流量模式,甚至最坏的全对全置换模式,但代价是脊交换机需要大量光收发器。Google 工程师发现,其网络流量模式相对可预测,远没有达到脊层所针对的最坏置换模式。OCS 层使他们不必一味分散流量,而可以进行拓扑工程:根据每天的应用流量模式,编程设置叶交换机之间所需的连接关系与带宽数量。
WSC 网络还需要相应的控制平面系统,处理全部网络设备的配置、路由、管理与实时控制。互联网依赖分布式、相互独立的管理;WSC 控制平面则利用逻辑上集中的网络状态视图,在性能、可扩展性、安全性与活性方面进行优化,超越一次只考虑一条网络连接所能达到的水平(Ferguson 等,2021)。控制平面的决策,由网络各层级每个交换设备所关联的 CPU 控制器执行。WSC 网络也推动了通信应用所使用的传输协议快速演进。由于 WSC 网络是同构且集中控制的系统,可以从交换机取得拥塞与遥测信息,或准确测量往返时间,以构建更好的拥塞控制算法。也可以部署远程直接内存访问(RDMA)协议,获得低延迟、低开销通信。
程序员眼中的 WSC
WSC 体系结构影响各种类型的工作负载。即使只使用一个 VM 的负载,也需要理解访问远程服务器存储的影响。分布式或云原生负载,则必须针对 WSC 中大量机器与网络的性能和可靠性特征进行优化。
程序员需要理解 WSC 的存储层次结构。图 6.21 列出其延迟、带宽与容量,图 6.22 用图形展示同一数据。两图基于以下假设:
- 服务器的两个插槽合计有 16 个内存通道,安装 32 GB DDR4-3200 内存模块。总内存容量为 512 GB,访问延迟为 100 ns,全部通道的峰值带宽为 409.6 GB/s。
- 服务器包含一个 3.84 TB NVMe Flash 驱动器,最大读带宽为 6.9 GB/s,无负载读延迟为 100 μs;另有一块 20 TB 硬盘,平均访问时间为 5 ms,持续传输速率为 300 MB/s。两个 CPU 插槽共享一个 100 Gbps 以太网 NIC。
- 本例中,每个机架包含 48 台服务器。NIC、交换机与网络软件使 DRAM 和 Flash 的访问时间增加 100 μs,磁盘访问时间增加 500 μs。100 Gbps NIC 将远程接收带宽限制为12.5 GB/s,但数据可以由机架中的多个设备共同提供。机架总存储容量约为 24.5 TB DRAM、184.3 TB Flash 和 960 TB 磁盘。
- 一排有 30 个机架,因此整个阵列的存储容量提高到 30 倍:735 TB DRAM、5.5 PB Flash 和 29.8 PB 磁盘。多级网络设备及可能的拥塞,使阵列范围内 DRAM 的延迟增加 200 μs,Flash 增加 300 μs,磁盘增加 1 ms。超额订阅使每台服务器远程访问 DRAM、阵列 Flash 或阵列磁盘时可用的带宽,限制为 20 Gbps,即 2.5 GB/s。
| 指标 | 本地 | 机架 | WSC 一排机架 |
|---|---|---|---|
| DRAM 延迟(μs) | 0.1 | 100.0 | 200.0 |
| Flash 延迟(μs) | 100.0 | 200.0 | 300.0 |
| 磁盘延迟(μs) | 5000.0 | 5500.0 | 6000.0 |
| DRAM 带宽(MB/s) | 409600 | 12500 | 2500 |
| Flash 带宽(MB/s) | 6900 | 12500 | 2500 |
| 磁盘带宽(MB/s) | 300 | 12500 | 2500 |
| DRAM 容量(GB) | 512 | 24500 | 735000 |
| Flash 容量(GB) | 3840 | 184320 | 5500000 |
| 磁盘容量(GB) | 20000 | 960000 | 29800000 |
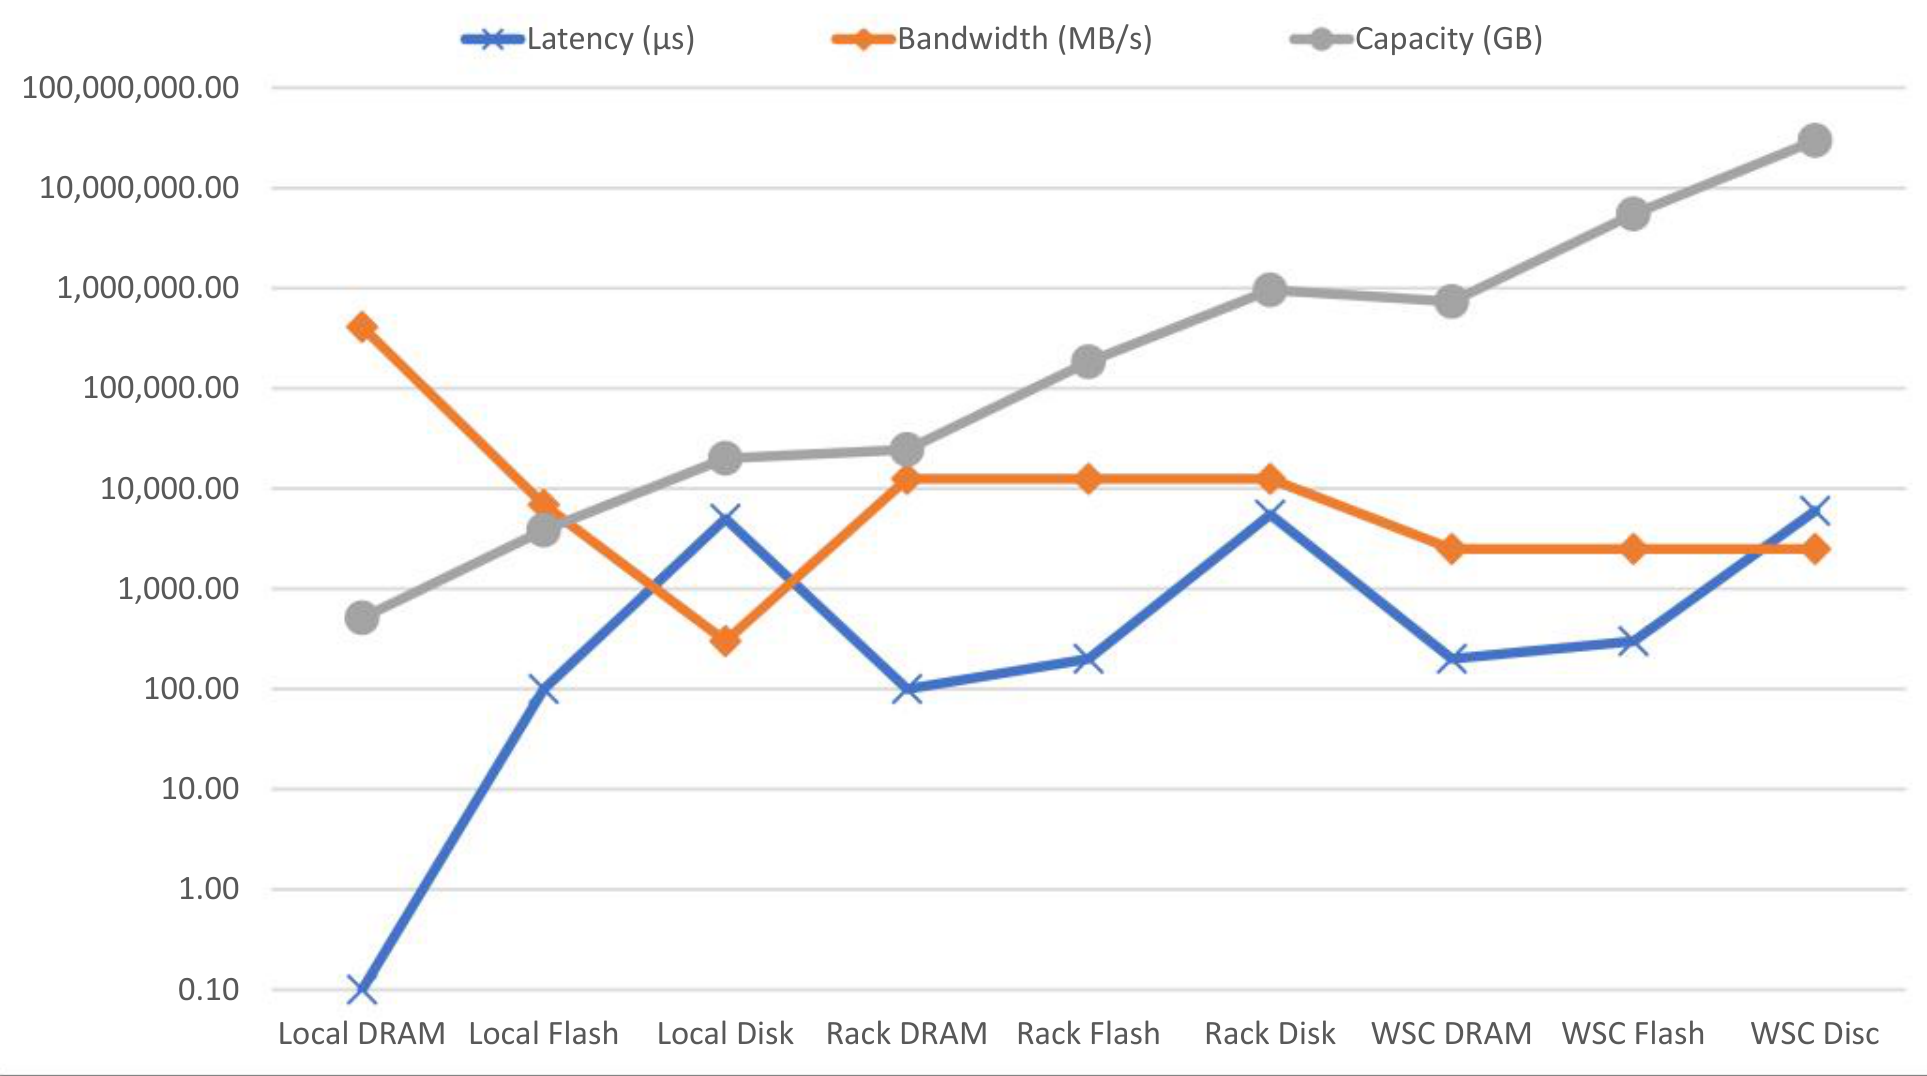
图内术语:Latency=延迟(μs);Bandwidth=带宽(MB/s);Capacity=容量(GB);Local=本地;Rack=机架范围;WSC=本例中一排机架的范围;DRAM、Flash、Disk/Disc 分别为 DRAM、Flash 与磁盘。纵轴使用对数刻度。
译注: 图 6.21 与正文均将一排机架的磁盘容量列为 29.8 PB;按同处给出的每架 960 TB、30 架计算,应为 28.8 PB,原值保留。正文还把阵列 DRAM 与 Flash 的延迟写成“增加 200 μs、300 μs”,而表中这两个数是远程访问的总延迟;表中的 Flash 总延迟 300 μs 对应在本地 100 μs 基础上增加 200 μs。原述与表值均保留,后续例题按表中总延迟计算。
图 6.21 和图 6.22 表明,对于机械硬盘和 Flash 设备,从本地访问改为远程访问,总延迟不会显著增加,因为设备本身的延迟远大于新增的网络延迟。如果数据来自多个远程磁盘,远程磁盘带宽会显著高于本地磁盘带宽。Flash 带宽在机架内部较高,跨一排机架时较低。这些观察推动了 WSC 中计算与存储的分离,为可扩展性和可靠性带来很大益处。许多分布式应用发起无状态计算任务,将其调度到 WSC 各处,并依赖分布式远程存储保存输入和输出。计算很容易扩展;分布式存储则通过将数据分片或分区到多个存储节点,达到所需的容量、带宽与可靠性。计算和存储都可以独立扩展,并利用大型 WSC 的并行性。
相比之下,两图显示,无论在同一机架还是同一排内,网络开销都会显著增加远程 DRAM 的访问延迟。尽管如此,远程 DRAM 与远程 Flash 的访问速度,仍比本地磁盘快十倍以上。网络使机架范围内 DRAM、Flash、磁盘之间的带宽差异消失,也使阵列范围内这三者之间的带宽差异消失。基于这些观察,许多 WSC 应用使用基于 DRAM 或 Flash 的分布式键值存储(KVS),快速访问海量数据。例如,Facebook 社交网络使用基于 DRAM 的 Memcache KVS,以交互式延迟提供服务;原文将服务规模写为“每天每用户数亿”(Nishtala 等,2013)。
译注: 原句写作“serve hundreds of millions per user each day”,没有明确说明“数亿”所计数的对象,且“per user”使量词关系可疑。
本地 DRAM 到远程 DRAM 的延迟骤增,推动了新 WSC 技术的部署。RDMA 网络技术消除了网络软件的开销和不可预测性。大多数网络开销,来自超额订阅引起的网络拥塞,或网络软件延迟;交换机本身每跳的直通延迟只有 200–500 ns。利用 NIC 硬件实现的 InfiniBand、RoCE 等网络协议,RDMA 可将远程内存访问延迟降至几微秒。新兴的 CXL 交换网络,也有望实现 WSC 内部的快速内存共享,即内存分离。
例题
假设 90% 的访问位于本地服务器,9% 位于服务器之外但在同一机架内,1% 位于机架之外但在同一排内,平均内存访问延迟是多少?
解答
AMAT 为:
与 100% 本地访问相比,约慢 100 倍。显然,服务器内部的访问局部性对 WSC 性能至关重要。
例题
在同一服务器内的磁盘之间、同一机架不同服务器的磁盘之间,以及同一排不同机架的服务器磁盘之间,传输 1000 MB 数据各需要多长时间?在这三种情况下,改为 DRAM 之间传输 1000 MB,速度能快多少?
解答
磁盘之间传输 1000 MB 需要:
在机架内及一排机架内传输时,带宽瓶颈是磁盘,而非网络。
内存到内存的块传输需要:
译注: 第一行保留原式; 实际约为 ,并非原书的 。按相同带宽口径计算,服务器内 DRAM 传输约需 2.44 ms。
因此,对于单台服务器之外的大块传输,数据位于内存还是磁盘并不重要。在网络限制下,关键在于采用多大的并行度,才能充分利用网络。对于大块传输,多个远程磁盘可以与远程内存竞争。