6.5 高性能 I/O 设备的体系结构
下面进一步考察 NIC 与 Flash 存储设备的体系结构。二者分别是 WSC 网络和存储的关键 I/O 组件。用于提高其带宽、降低延迟的许多软硬件优化,也适用于连接 CPU 宿主机,或直接连接 DSA 的其他 I/O 设备。
网络接口
图 6.23 展示一个简单网络接口(NIC)的框图,它有两个以太网端口,每个端口速率为 100 Gbps。每个端口都配有一个以太网介质访问控制(MAC)模块,以及一组发送/接收队列。MAC 模块用硬件实现网络栈的物理层——编码与信号传输——以及数据链路层——底层比特发送与接收。其余各层均可由宿主机软件实现,包括互联网通信常用的 IP 与 TCP 协议。下文将说明,现代 NIC 为其中一些软件任务提供完整或部分加速器。软件通过以太网设备驱动与 NIC 交互。发送和接收队列分别在两个方向上,将 MAC 层与软件栈解耦。每个队列至少需要存放两个以太网分组,每个分组最长可达 9000 字节。实际 NIC 的片上缓冲区更大。
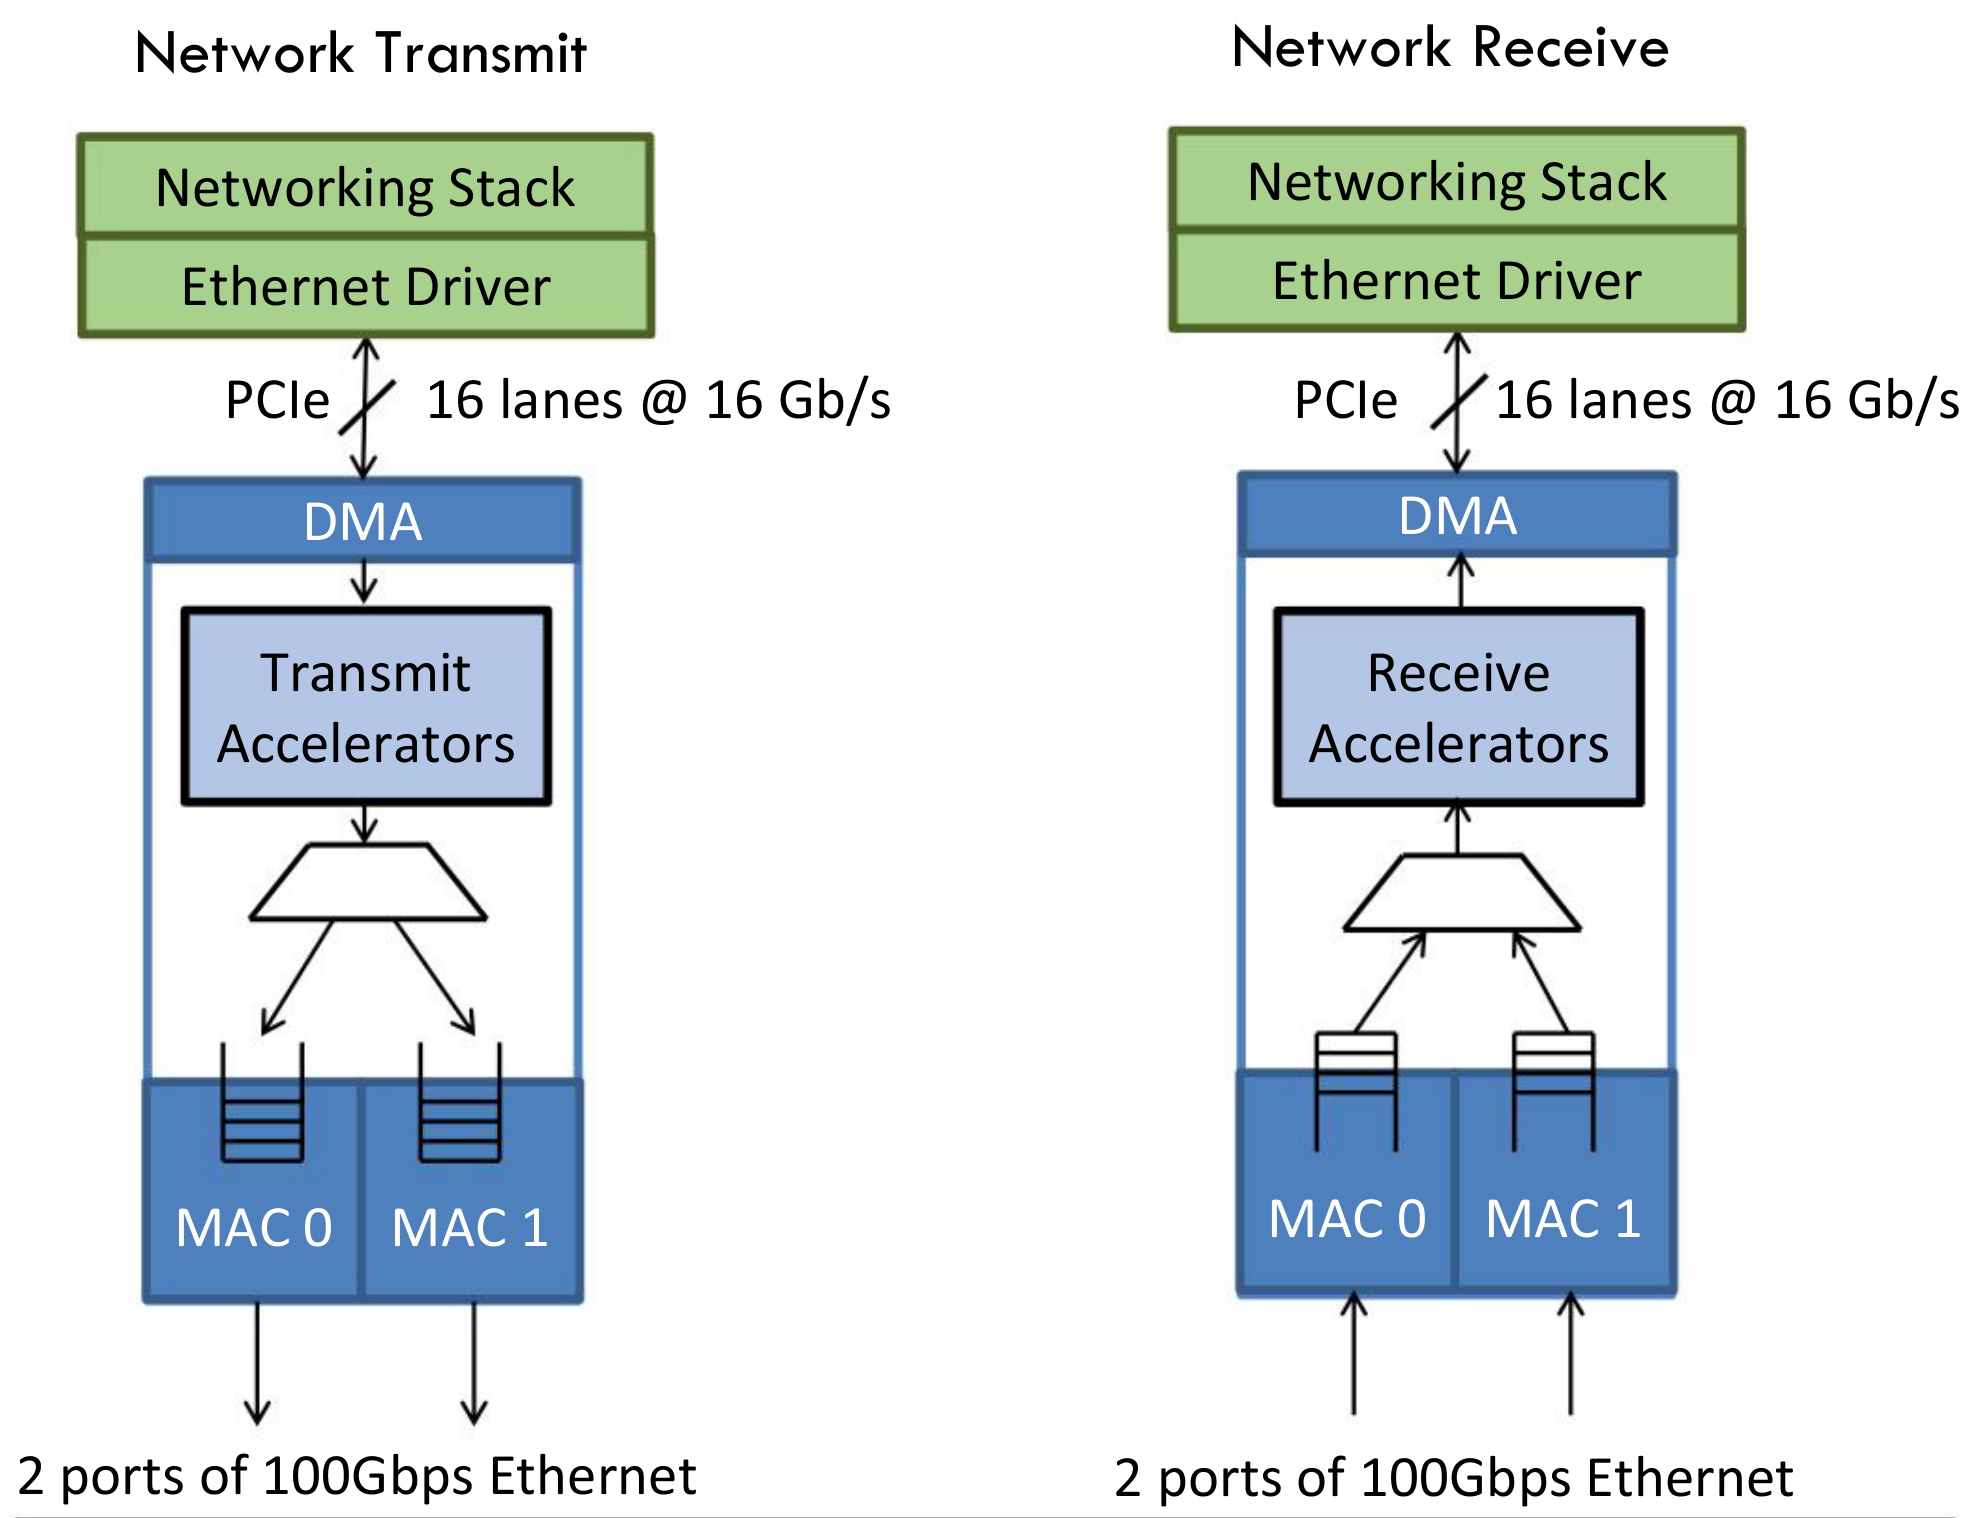
图内术语:Network Transmit/Receive=网络发送/接收;Networking Stack=网络协议栈;Ethernet Driver=以太网驱动;Transmit/Receive Accelerators=发送/接收加速器;16 lanes @ 16 Gb/s=16 条通道,每条 16 Gb/s;2 ports of 100 Gbps Ethernet=两个 100 Gbps 以太网端口;DMA=直接内存访问;MAC 0、MAC 1 为两个端口的 MAC 模块。
通过网络发送一个分组,要经过以下步骤。用户级软件在内存缓冲区中准备待发送数据,通过 write() 或 send() 等系统调用,沿预先建立的连接——例如 TCP/IP socket——发送。操作系统很可能先把数据复制到自身的内存缓冲区,再执行 TCP、IP 等一系列网络协议。每种协议都添加首部和尾部信息,例如源地址、目的地址、序号与纠错信息。分组准备好之后,操作系统设备驱动通过两个 FIFO 数据结构与 NIC 通信:发送队列(SQ)和完成队列(CQ)。它们都位于宿主机内存中,采用带首尾指针的环形缓冲区。操作系统驱动将描述符写入 SQ,其中包括分组的内存地址和目标以太网端口,然后递增 SQ 尾指针。接着,驱动写入映射到宿主物理地址空间的 NIC 寄存器,完成敲门铃(ringing a doorbell)操作,通知 NIC。NIC 随即访问 SQ 中第一个分组描述符,递增首指针,并设置 DMA 引擎,将分组从宿主内存复制到选定以太网端口的发送缓冲区。以太网 MAC 从缓冲区取出数据,以和上游以太网交换机协商好的速率发送,例如 100 Gbps。发送完成后,NIC 把分组描述符写入 CQ,递增 CQ 尾指针,并向宿主操作系统产生中断。处理中断时,操作系统可能释放该分组的内存缓冲区。对于 TCP 等协议,操作系统可能等到接收方确认收到数据后,才释放缓冲区。如果发送失败,可能重新发送分组。
通过网络接收分组,则经过以下步骤。NIC 与操作系统驱动通过一对 FIFO 数据结构通信:接收队列(RQ)和完成队列(CQ)。两者同样是宿主内存中带首尾指针的环形缓冲区。操作系统定期把为接收分组而分配的内存缓冲区地址填入 RQ。分组到达时,NIC 从 RQ 读取一个缓冲区地址,递增 RQ 首指针,再设置 DMA 引擎,将分组从 NIC 接收队列复制到操作系统缓冲区。DMA 传输完成后,NIC 释放其接收队列中的空间,将分组描述符写入 CQ,更新 CQ 尾指针,最后向宿主操作系统产生中断。操作系统随后通过 IP、TCP 等一系列协议处理分组,用错误检测码确认正确接收,并移除全部首部和尾部。接着,它把数据复制到监听该连接的应用的用户级缓冲区。最后,操作系统释放或回收自己的分组缓冲区,并可能生成确认消息,通知发送方分组是否无误收到。
上述简化的收发过程存在多处低效,会造成网络带宽低、延迟高。第一个问题是网络协议处理占用大量 CPU。NIC 通过所谓的无状态卸载(stateless offload)部分缓解这一问题,即用硬件加速器执行网络协议任务。最常见的卸载,是在发送时为 Ethernet、IP、TCP、UDP 等常用协议生成检错码,在接收时检查。NIC 在收发分组的过程中即时生成或检查检错码,并将结果告知宿主操作系统。NIC 还支持大段卸载(large segment offload):发送端逻辑把大消息拆分为网络支持的小分组;接收端则把小分组重新组装成大消息,即使分组乱序到达也能处理。因此,发送或接收 1 MB 数据块只需执行一次网络协议,而不是 次。大段卸载需要 NIC 配备更大的缓冲区,而且实现复杂,因为以太网分组经过 WSC 网络时可能重排,偶尔也会丢失。
第二个问题是中断处理开销。100 Gbps NIC 若接收最小的 64 B 以太网分组,每秒可能产生 2 亿次中断。为了避免 CPU 不堪重负,NIC 实现中断调节(interrupt moderation),限制中断频率,每次中断可表示多个分组到达。NIC 还包含中断导向逻辑,选择由哪个 CPU 核心接收中断。一种简单选择,是把所有分组的中断发给同一核心,使其用于网络处理的指令和数据缓存保持预热。在高网络速率下,这个核心会成为瓶颈,因此 NIC 也可以对每个分组的连接信息散列,把中断分散到多个核心,这称为接收端扩展(receive side scaling)。散列保证同一连接的全部中断交给同一核心,从而尽量减少同步开销。还应注意,操作系统完成网络处理后,可能需要再发一次中断,调度等待该分组的应用进程。因此,有些 NIC 会跟踪每条活跃连接最近在哪个核心发起发送系统调用;同一连接的分组到达时,就中断该核心。如果这个核心仍在运行建立连接的应用,就无需额外中断。操作系统与应用也可以通过轮询 NIC 的入站分组,完全避免中断。有些操作系统采用混合方案:NIC 中断使其开始执行网络子系统代码之后,会暂时保持轮询模式,以摊销中断成本。
第三个问题涉及内存与缓存开销。收发分组需要在 NIC、操作系统缓冲区和应用缓冲区之间多次复制。未经优化的系统消耗的内存带宽,会达到网络带宽的 5–8 倍。第一项优化是数据直接 I/O(DDIO):将收到的分组直接放入 CPU 的末级缓存。若分组很快得到处理,DDIO 能加速网络处理,并减少内存带宽消耗;否则,分组逐步被逐出到主存。第二项优化是首部分离(header splitting):将分组元数据与分组数据放在不同缓冲区。操作系统通常只处理首部,应用自己处理数据,因此分离能改善网络处理的局部性。首部分离也是零复制网络所必需的:载荷从 NIC 直接复制到应用缓冲区,省去经操作系统缓冲区进行的冗余复制。零复制要求接收应用预先提交可接收入站数据的缓冲区地址。分组重排和丢失会使零复制复杂化。
WSC 使用的大多数 NIC 是以太网设备,实现了上述若干优化。近几年,NIC 又出现两个趋势。第一,多个针对 ML 优化的集群采用 InfiniBand(IB)或融合以太网上的 RDMA(RoCE)网络设备。RoCE 在以太网之上实现 InfiniBand 协议。IB 与 RoCE 把全部网络协议处理卸载到 NIC,并对 CPU 或 GPU 内存中的应用缓冲区实现零复制网络。第二,开始部署 SmartNIC,在网卡上集成可编程核心,卸载广泛任务,包括网络协议处理、远程存储协议处理和各种 hypervisor 任务。公有云平台所用 NIC 还包含网络虚拟化硬件模块,即可编程逻辑:添加或移除支持私有虚拟网络所需的多层首部,并在共享 WSC 中执行安全规则(Firestone 等,2018)。
NVMe Flash 驱动器
Nonvolatile Memory Express(NVMe)驱动器广泛用于 WSC,构建针对高吞吐量与低延迟优化的存储系统。对于以每存储比特成本低为优化目标的系统,机械硬盘仍很常见。
图 6.24 展示 NVMe 驱动器的组成。关键组件是由垂直堆叠 Flash 存储芯片形成的封装,原文称每堆栈超过 100 个芯片,整体表现为一个高密度芯片。多个此类封装组织为通道,以提供并行性。每条通道一次只能支持一个访问,但设备控制器可以让不同通道的访问重叠。封装的访问粒度是 1–8 KB 的页,并包含一些用于纠错编码的备用存储空间。读一页需要几十微秒;写一页则更慢,也更复杂。页被组织为块,每块 64–256 页。首先用擦除操作重置块内容,需要数毫秒;随后可以按 0、1、2……的顺序逐页写入,每次写页需要一两毫秒。写入速度较低,源于 Flash 单元的性质——用浮栅上的电荷记录状态——以及为提高容量而广泛采用多级单元(MLC),还有 Flash 单元阵列的 NAND 组织方式。最后,Flash 块的耐久性有限。每块可擦除 100,000–1,000,000 次,之后便不能再正常存储数据。
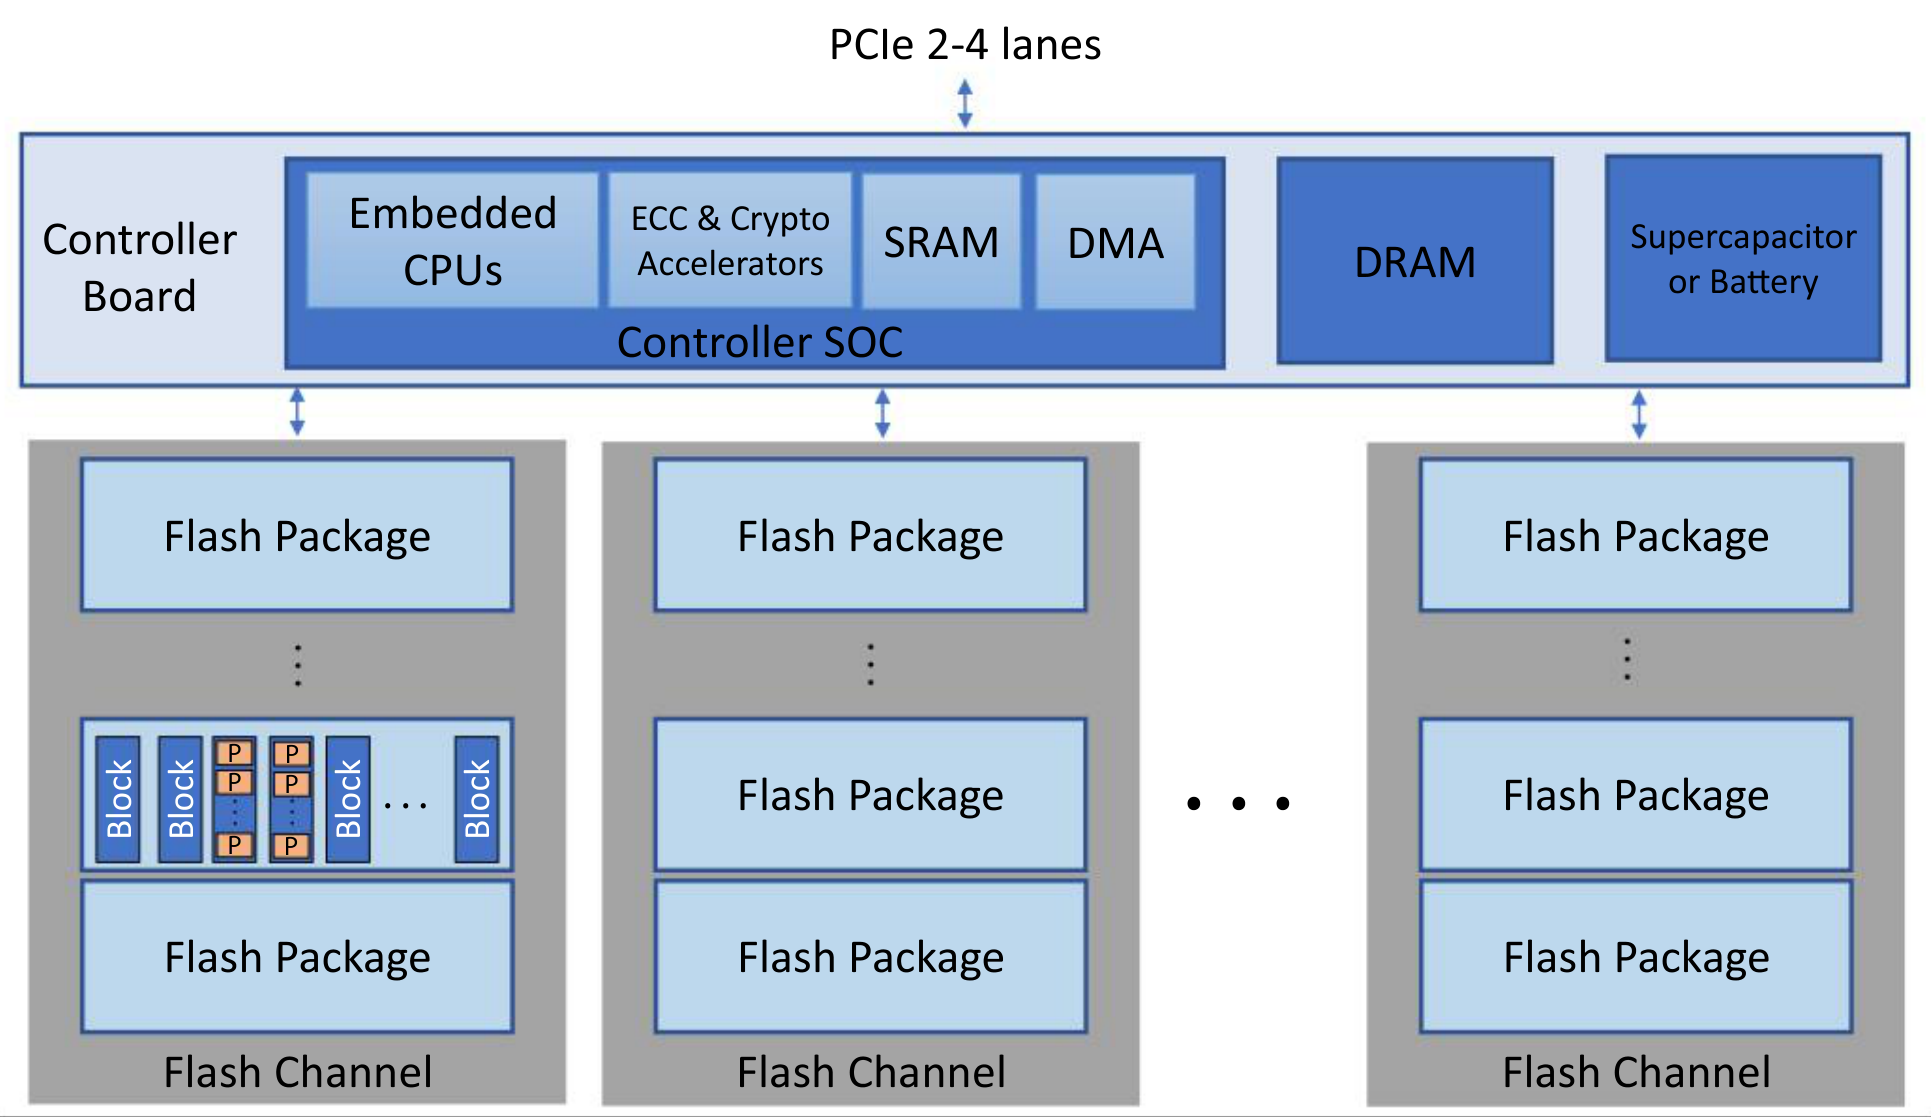
图内术语:Controller Board=控制器板;Controller SoC=控制器片上系统;Embedded CPUs=嵌入式 CPU;ECC & Crypto Accelerators=纠错码与密码加速器;Supercapacitor or Battery=超级电容或电池;Flash Channel=Flash 通道;Flash Package=Flash 封装;Block=块;P=页;PCIe 2–4 lanes=2–4 条 PCIe 通道。
这些设备特征使操作系统难以直接使用 Flash。因此,NVMe 控制器实现 Flash 转换层(FTL),将块存储读写访问转换为 Flash 的读、擦除与写操作,并把写入引起的磨损均匀分摊到全部可用块。图 6.25 展示 FTL 维护的关键数据结构。第一种是映射表,将宿主操作系统可见的逻辑块地址(LBA),映射到包含通道、封装、块和页编号的 Flash 设备地址。每次读取都查此表,确定要访问的物理页。第二种结构跟踪设备中每个块的状态,包括健康状况、是否已擦除,以及保存的有效页数。最后,还有指向当前写入点的指针,标识当前接收写入的块及块中下一个可用页。写逻辑块时,控制器在当前写入点写入新数据,更新映射表,记录逻辑块与物理页的新对应关系;最后,更新此前保存该逻辑块数据的 Flash 块的信息,将其有效页数减一。控制器选择擦除次数较少的 Flash 块作为下一个写入点,以均衡磨损。
| 数据结构 | 记录(LBA 或块号) | 物理页地址〈通道,封装,块,页〉 | 已擦除 | 擦除次数 | 有效页数 | 坏块标志 |
|---|---|---|---|---|---|---|
| 块映射表 | LBA 0 | 〈2,4,59,3〉 | — | — | — | — |
| 块映射表 | LBA 1 | 〈2,5,12,8〉 | — | — | — | — |
| 块映射表 | … | … | — | — | — | — |
| 块映射表 | LBA 8k | 〈4,0,33,129〉 | — | — | — | — |
| 块信息表 | 块 0 | — | False | 15 | 15 | False |
| 块信息表 | 块 1 | — | True | 33 | 0 | False |
| 块信息表 | … | — | … | … | … | … |
| 块信息表 | 块 2 | — | False | 1 | 4 | False |
| 写入点 | 写入点 | 〈3,1,12,24〉 | — | — | — | — |
NVMe 控制器在后台定期扫描块信息表,决定是否对有效页数较少的块进行垃圾回收。被回收块的所有有效页都复制到写入点,空块则安排擦除。这种紧凑整理对于利用全部可用容量至关重要,但会产生写放大问题:增加磨损,并延迟那些被额外写入阻塞的读取。针对不同访问模式与目标,垃圾回收和写入点选择存在多种权衡与算法。FTL 通常作为固件,运行在 NVMe 设备的一个或多个嵌入式核心上。图 6.25 的数据结构保存在 Flash 板上的 DRAM 中,并定期保存到 Flash,以保证非易失性。NVMe 设备通常配有超级电容,断电时控制器可以迅速把全部数据结构写入 Flash。FTL 还负责待处理访问的调度,以及利用 DRAM 缓存经常访问的数据。
NVMe 设备与宿主 CPU 软件之间的接口,类似于 NIC 的接口。它通过 PCIe 实现,采用命令队列与完成队列组成的队列对。发给 NVMe 的读写命令延迟不定,可能乱序完成。命令可能先排队,再由控制器调度。有些读命令很快完成,另一些则可能因对应 Flash 块、封装或通道存在待完成写入或垃圾回收任务,而延迟数毫秒。典型 NVMe 设备容量为 0.5–10 TB,无负载读延迟为 50–100 μs,吞吐量为每秒 1,000,000–2,000,000 次操作,功耗为 5–15 W。作为比较,典型硬盘容量为 1–25 TB,无负载读延迟为 5000–10,000 μs,吞吐量为每秒 100–200 次操作,功耗为 5–10 W。
I/O 设备虚拟化
如 6.3 节所述,可通过半虚拟化,或在加载/存储访问内存映射 I/O 地址时陷入 hypervisor,让它截获客户 VM 的全部 I/O 请求,以实现设备虚拟化。如今,NIC 和 NVMe 驱动器等高性能设备的设计,允许客户 VM 无需 hypervisor 协助便直接访问 I/O。
设备一侧的关键技术是 PCIe 接口虚拟化。按照 PCIe 标准的单根 I/O 虚拟化(SR-IOV)扩展,I/O 设备实现多个接口功能。唯一的物理功能(PF)包含管理设备全部功能所需的寄存器。非虚拟化系统中,唯一的操作系统运行设备驱动,使用 PF 完成 I/O;虚拟化系统中,hypervisor 使用 PF,并把设备实现的众多虚拟功能(VF)接口之一,映射到每个客户 VM 的客户物理地址空间,供其操作系统使用。每个 VF 都包含设备基本操作所需的全部寄存器:NIC 的分组收发,或 NVMe 驱动器的块读写。VF 不暴露管理功能,例如启用或禁用 VF、配置各 VF 可访问的存储块范围,或设置各 VF 可用的网络带宽比例。
宿主机一侧,支持 VM 直接访问 I/O 设备的关键技术是 6.3 节讨论的 IOMMU。hypervisor 配置 IOMMU,使其转换 I/O 设备各 PF/VF 使用的 DMA 地址,并正确重映射中断,从而让客户 VM 直接访问 VF。在每个 PF/VF 内,I/O 设备通常支持多个网络或存储访问队列对。这些队列对可以进一步分离和隔离客户 VM 内不同应用的 I/O 请求。例如,网络设备为每个应用使用独立队列对,可让操作系统控制各应用的带宽使用量,也可能把入站数据直接递送到应用的虚拟地址空间。