6.7 仓库级计算的成本与效率
了解了 WSC 的体系结构,包括其机械组件之后,现在可以讨论其成本,以及为何这些设施虽然昂贵,却仍被认为具有成本效益。
WSC 的成本
如引言所述,WSC 设计者既关心建设成本,也关心运行成本。会计上将后者称为运营支出(OPEX),前者称为资本支出(CAPEX)。
为了把能源成本放到总体背景下考察,Hamilton(2010)通过案例研究估算一座 WSC 的成本。他确定,一座 8 MW 设施的 CAPEX 为 8800 万美元;约 46,000 台服务器及相应网络设备,再为 WSC 增加 7900 万美元 CAPEX。图 6.32 列出了这一案例的其他假设。
Hamilton 的研究折合每瓦的建筑、供电和冷却成本为 $11。Barroso 等(2018)报告的多个案例与之相符,每瓦成本为 $9–$13。
按照资本成本换算,可以将 CAPEX 转换为 OPEX,假定借款成本为 5%;这是美国会计规则中的一种标准惯例。也就是说,可以在设备有效寿命内,把 CAPEX 按固定金额逐月摊销。图 6.33 列出 Hamilton 案例每月 OPEX 的构成。请注意,各类资产的摊销年限差别很大:设施为 10 年,网络设备为 4 年,服务器为 3 年。因此,WSC 设施使用十年,但服务器每三年更换,网络设备每四年更换。通过摊销 CAPEX,Hamilton 得出每月 OPEX,其中也计入为建设 WSC 借款所需的资金成本,即年利率 5%。每月 OPEX 为 380 万美元,约占 CAPEX 的 2%,或每年占 24%。
这一数据还可以推导一条方便的经验准则,在考虑能耗、选择组件时作为参考。将供电与冷却基础设施摊销计入后,WSC 中每瓦每年的全部成本为:
| 项目 | 假设或成本 |
|---|---|
| 设施规模(关键负载,W) | 8,000,000 |
| 平均功率使用比例 | 80% |
| PUE | 1.45 |
| 电价(美元/kWh) | $0.07 |
| 供电与冷却基础设施占设施总成本比例 | 82% |
| 设施 CAPEX,不含 IT 设备 | $88,000,000 |
| 服务器数量 | 45,978 |
| 每台服务器成本 | $1450 |
| 服务器 CAPEX | $66,700,000 |
| 机架交换机数量 | 1150 |
| 每台机架交换机成本 | $4800 |
| 阵列交换机数量 | 22 |
| 每台阵列交换机成本 | $300,000 |
| 第 3 层交换机数量 | 2 |
| 每台第 3 层交换机成本 | $500,000 |
| 边界路由器数量 | 2 |
| 每台边界路由器成本 | $144,800 |
| 网络设备 CAPEX | $12,810,000 |
| WSC 总 CAPEX | $167,510,000 |
| 服务器摊销年限 | 3 年 |
| 网络设备摊销年限 | 4 年 |
| 设施摊销年限 | 10 年 |
| 年资金成本 | 5% |
来源:Hamilton, J., 2010. Cloud computing economies of scale. AWS Workshop on Genomics and Cloud Computing,2010 年 6 月 8 日,Seattle, WA。报告原址。
译注: 图 6.32 原图注引用“图 6.14”,但该图是 Lightning JBOF;包含人员成本的实际是图 6.33。上方保留原引用并在此指出。
成本大约为每瓦每年 $2。从短期经济角度看,为节能而降低成本,所增加的支出不应超过每节约一瓦每年 $2,见 6.9 节。从长期环境角度看,更高的节能支出也可能合理,见 7.8 节。
图 6.33 中,超过三分之一的 OPEX 与电力有关;随着时间推移,这部分成本呈上升趋势,而服务器成本呈下降趋势。网络设备也很重要,占总 OPEX 的 8%,相当于服务器 CAPEX 的 19%。网络设备成本下降没有服务器那么快,可能是因为更高网络带宽的需求持续增长。机架之上的网络层级中的交换机尤其如此,它们占网络成本的大部分。安保与设施管理人员成本仅占 OPEX 的 2%。用图 6.33 的 OPEX 除以服务器数量与每月小时数,得到每台服务器每小时成本约为 $0.11。
| 支出类别及占比 | 项目 | 月成本 | 占月成本比例 |
|---|---|---|---|
| 摊销后的 CAPEX(85%) | 服务器 | $2,000,000 | 53% |
| 同上 | 网络设备 | $290,000 | 8% |
| 同上 | 供电与冷却基础设施 | $765,000 | 20% |
| 同上 | 其他基础设施 | $170,000 | 4% |
| OPEX(15%) | 每月电力消耗 | $475,000 | 13% |
| 同上 | 每月人员工资与福利 | $85,000 | 2% |
| 合计 | 总 OPEX | $3,800,000 | 100% |
Barroso 等(2018)按每瓦每月成本评估 CAPEX 和 OPEX。一座 12 MW 的 WSC 若按十二年折旧,折旧成本为每瓦每月 $0.08。他们假定企业通过年利率 8% 的贷款取得建设资金;企业贷款利率通常在 7%–12%。利息再增加 $0.05,使合计成本达到每瓦每月 $0.13。他们以类似方法计入服务器成本。一台 500 W、价格 $4000 的服务器,相当于每瓦 $8;按四年折旧,为每瓦每月 $0.17。服务器贷款的 8% 利息再增加 $0.02。网络成本估计为每瓦每月 $0.03。他们报告,多 MW 级 WSC 的典型 OPEX 为每瓦每月 $0.02–$0.08,全部合计为每瓦每月 $0.37–$0.43。对于 8 MW WSC,扣除电费后的月成本约为 300 万–350 万美元。若从 Hamilton 的计算中减去每月电费,其月成本估计为 330 万美元。虽然采用的成本预测方法不同,二者结果却相当一致。
例题
美国各地区电价不同,从每 kWh $0.03 到 $0.15 不等。这两个极端电价对服务器每小时成本有何影响?
解答
将关键负载 8 MW 乘以图 6.32 中的平均 PUE(原文指“第二行”),计算平均功率使用量:
于是,图 6.33 中原为 $475,000 的每月电费,在每 kWh $0.03 时降至 $205,000,在每 kWh $0.15 时升至 $1,015,000。电费变化使每台服务器每小时成本由 $0.11,分别变为 $0.10 和 $0.13。
译注: 图 6.32 第二行是 80% 的平均功率使用比例,PUE 1.45 实际位于第三行;原解算式同时使用了二者。
例题
如果把所有摊销年限统一设为五年,每月成本会怎样变化?每台服务器每小时成本会怎样变化?
解答
原始电子表格可在线获取。把摊销年限改成五年后,图 6.33 的前四行变为:
| 项目 | 月成本 | 占比 |
|---|---|---|
| 服务器 | $1,260,000 | 37% |
| 网络设备 | $242,000 | 7% |
| 供电与冷却基础设施 | $1,115,000 | 33% |
| 其他基础设施 | $245,000 | 7% |
总月 OPEX 为 $3,422,000。如果所有设备每五年更换,每台服务器每小时成本为 $0.103;与图 6.33 相比,摊销成本中更多部分转移到设施,服务器所占部分相应减少。
每台服务器每小时约 $0.10 的成本,可能远低于许多企业自行拥有和运营较小传统数据中心的成本。WSC 的成本优势促使大型互联网企业像供电一样,把计算作为公共服务提供,用户只需为实际使用量付费。
这些年来,WSC 规模显著扩大,大型设施如今功耗超过 100 MW。上述 TCO 计算方法与结论仍然适用。现代 WSC 的建设成本为每瓦 $7–$10。图 6.34 的案例研究显示,装满设备的 WSC,其 TCO 以资本支出为主,尤其是计算、网络与存储设备成本(60%–65%),以及设施成本(10%);电力和 PUE 开销则低得多,分别约为 5% 和 3%。
通过电力配置提高效率
即使按每瓦 $7 计,一座 100 MW WSC 的建设成本也达 7 亿美元。提高成本效益的第一种方法,是容纳尽可能多的服务器,以摊销这笔成本。令人意外的是,扣除配电与冷却开销后,WSC 究竟能支持多少服务器,并不显而易见。服务器厂商标出的铭牌额定功率总是保守值:它表示所有组件同时达到最大功耗时,服务器可能消耗的最大功率。因此,第一步是在准备部署到 WSC 的各种负载下测量单台服务器,从功耗压力极端的 power-virus 基准测试,到更真实的工作负载。网络设备通常约占功耗的 5%,开始时可忽略。这些测量给出服务器实际峰值功率的估计,通常比铭牌功率低 60%,使 WSC 能部署的服务器数量大幅增加。
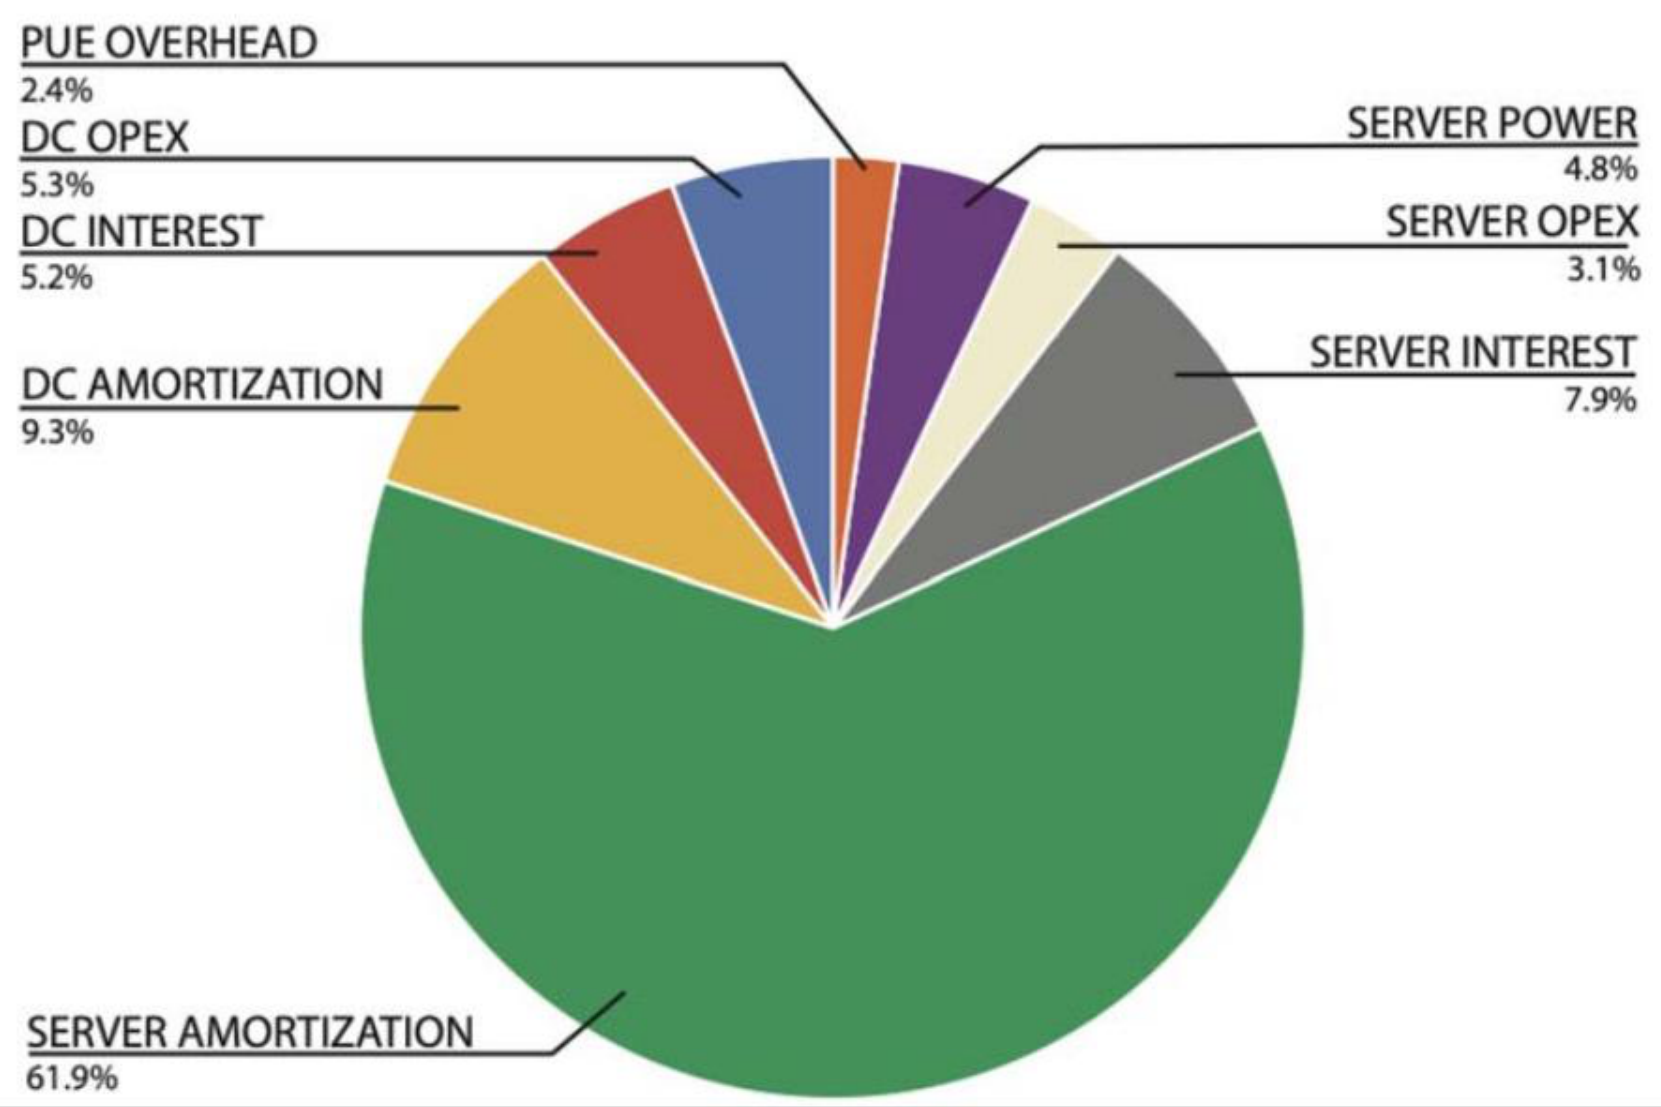
图内各项:服务器摊销(Server amortization)61.9%;服务器利息(Server interest)7.9%;服务器 OPEX 3.1%;服务器电力(Server power)4.8%;PUE 额外开销 2.4%;数据中心 OPEX 5.3%;数据中心利息(DC interest)5.2%;数据中心摊销(DC amortization)9.3%。
Fan 等(2007)表明,按服务器实际峰值功率配置仍然过于保守。他们发现,数千台服务器在理论最坏情况下可能达到的功耗,与实际会达到的功耗之间存在显著差距,因为没有真实负载会让数千台服务器同时保持峰值。以单台服务器实测峰值为基础,他们发现服务器数量可以安全地超额配置最多 40%。这种电力超额配置在 WSC 中已很常见,但需要全面的监测框架,检测同一机架、同一 PDU 之后,或整个 WSC 的服务器是否出现相关的功耗峰值。可使用以下技术缓解暂时超出机架、PDU 或 WSC 供电能力的问题:
- a. 降低部分服务器的时钟频率,从而降低功耗;
- b. 暂时从每个机架的电池中取得额外电力;
- c. 暂停低优先级任务,或将其从运行调度中撤下;
- d. 在机架、PDU 或 WSC 之间迁移任务,均衡电力需求,避免相关的功耗尖峰。
只要这些手段很少使用,对工作负载性能和电池寿命的影响就很小。
充分利用 WSC 中每一瓦可用功率,也是为 ML 等关键工作负载开发 DSA 的重要原因。第 7 章将说明,DSA 的每瓦性能比通用 CPU 高两个数量级。DSA 显著减少了为满足工作负载性能需求而新建 WSC 的必要性。这些节省很容易抵消大型定制 ASIC 的软硬件开发成本;2022 年,这类成本为 5000 万–1 亿美元。
通过提高利用率提高效率
由于服务器 CAPEX 主导 TCO,让服务器在大多数时间得到利用,对总体效率十分重要。WSC 面向公众提供效用计算,即云计算,也可面向一家大公司的工作负载提供私有云。在同一服务器池上复用用户和工作负载,不同负载需求的高峰与低谷相互平均,因而提高利用率。尽管如此,让 WSC 长期接近满负载运行仍然困难。图 6.35 展示 Google 两个集群在三个月期间的平均利用率分布。集群(a)用于混合负载,包括多种面向用户的服务。这些服务具有昼夜周期:工作时间或重要事件期间活跃度高,夜间或假日活跃度低,因此利用率在 10%–50% 之间变化。集群(b)用于大型持续批处理负载,长时间内需求变化小,因此利用率在 50%–85% 之间变化。
用户负载变化是许多 WSC 利用率中等或偏低的主要原因,但不是唯一原因。开发者也很难准确决定应用所需资源,以及实例的数量与类型。他们倾向于过度配置资源,以绕过 WSC 硬件异构导致的性能变化,以及共同调度的负载偶尔产生的干扰(Delimitrou 与 Kozyrakis,2014)。例如,占用 CPU 大部分核心的负载,更不容易受到同机内存密集型负载引发的缓存未命中影响。多数开发者对性能问题的可见性与理解有限,因此,大幅增加预留资源对他们而言是一种实用办法。
多年来,人们开发了多种提高利用率的技术,包括根据实际需求自动确定和伸缩云工作负载资源的工具,即适量配置(right sizing)与自动伸缩(autoscaling);预测或跟踪负载间干扰,并调整分配以减轻干扰的调度器,即干扰感知调度;以及允许低优先级任务,例如运行批量分析的可抢占 Spot 实例,安全使用已预留但暂时空闲资源的调度器,即 resource harvesting。设计空间很大,启发式方法难以安全高效地探索,因此经常采用 ML 与在线学习技术。硬件层面则越来越重视共同调度负载之间的性能隔离,使用缓存与内存带宽分区(Lo 等,2016),以及网络、存储系统的服务质量(QoS)技术。
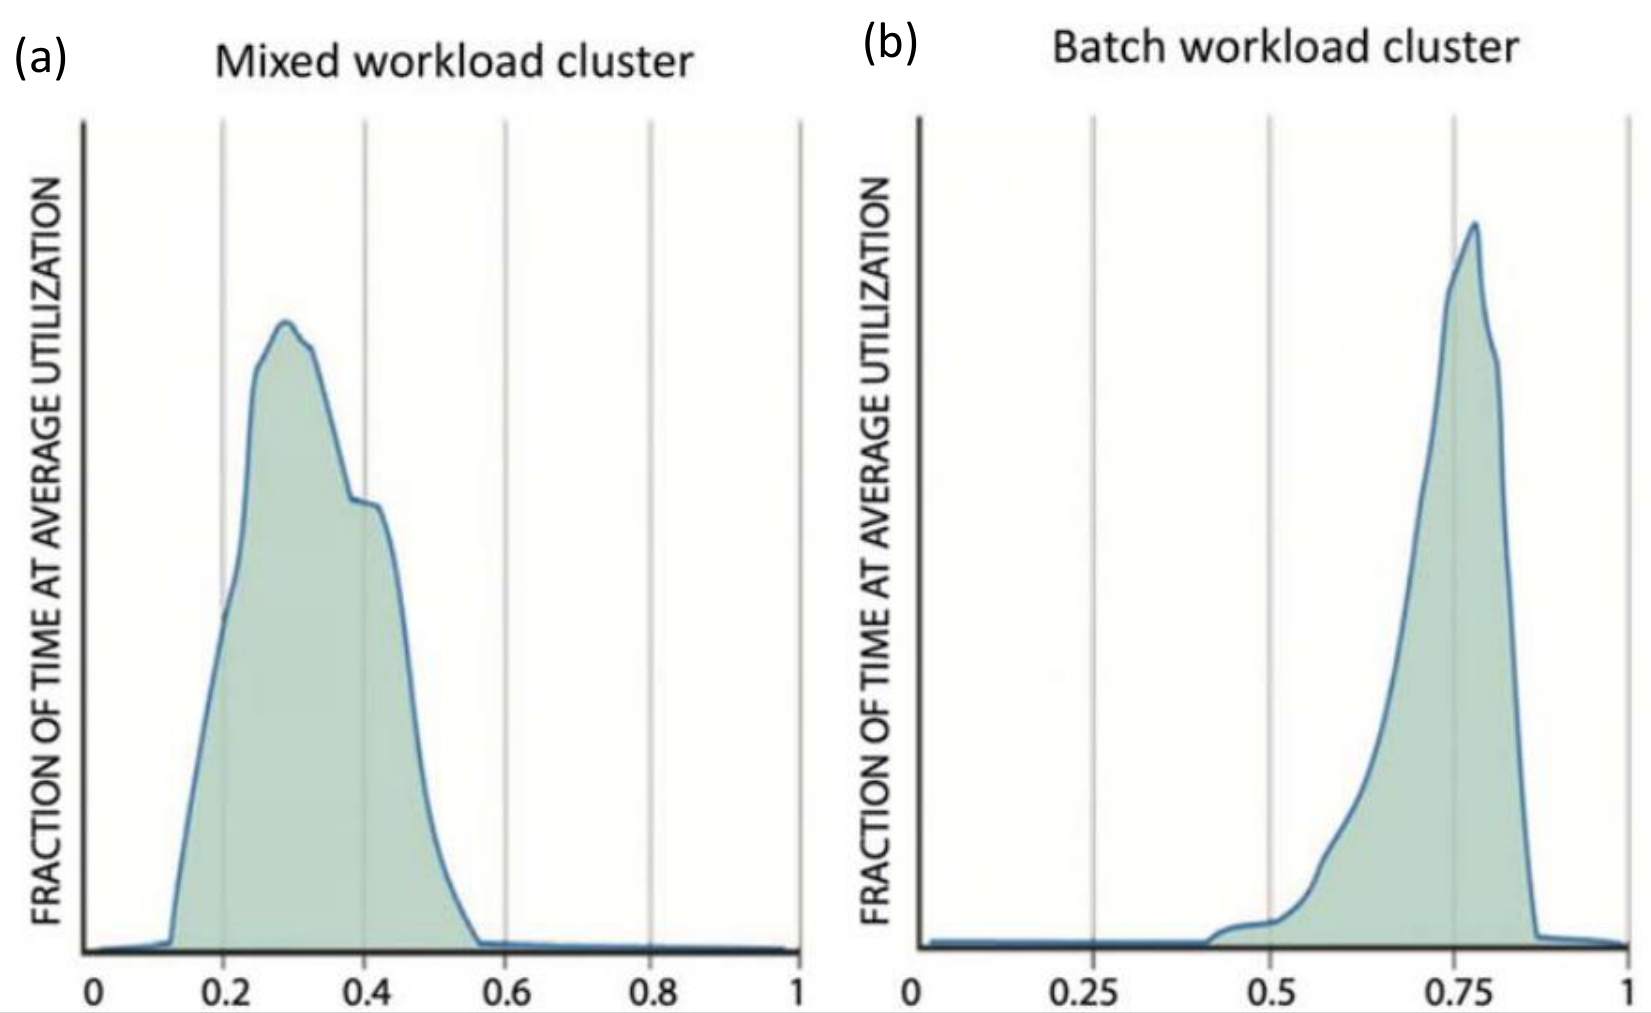
图内术语:Mixed workload cluster=混合负载集群;Batch workload cluster=批处理负载集群;Fraction of time at average utilization=处于相应平均利用率的时间比例;横轴为平均 CPU 利用率。
通过提高性能提高效率
既然每美元性能是最终指标,仍需要测量性能。分布式工作负载性能受到许多因素影响,包括随着数据距离增加而出现的带宽下降与延迟上升。在 WSC 中,服务器内部 DRAM 带宽是机架内部的 40 倍,机架内部又是整个 WSC 范围的 4–10 倍,见图 6.21。因此,在 WSC 中放置数据与程序时,还要考虑这一类局部性。
互联网服务开发者也关心延迟,因为用户能够感受到它。用户满意度与工作效率和服务响应时间密切相关。分时计算时代的多项研究指出,用户工作效率与一次交互所需时间成反比;交互时间通常分为人工输入时间、系统响应时间,以及用户看到响应后、进行下一次输入前的思考时间(Doherty 与 Thadhani,1982)。实验显示,系统响应时间减少 30%,交互时间却减少了 70%(Brady,1986)。这个看似不合理的结果,可以从人的行为解释:响应更快时,人们不易分心,能保持顺畅投入的状态,因此思考时间也更短。
图 6.36 展示 Bing 搜索引擎一项较近期实验的结果:研究者在搜索服务器中插入 50–2000 ms 延迟(Schurman 与 Brutlag,2009)。与先前研究的预期一致,到下一次点击的等待时间增量约为服务器延迟的两倍,例如服务器延迟 200 ms,会使到下一次点击的时间增加 500 ms。收入随延迟增大近似线性下降,用户满意度也如此。Google 搜索引擎的另一项研究发现,这些影响在为期四周的实验结束后仍长期存在。五周以后,在经历过 200 ms 延迟的用户中,每日搜索者数量仍减少 0.1%;经历过 400 ms 延迟的用户,搜索次数减少 0.2%。考虑到搜索业务的收入规模,即使这么小的变化也令人不安。实际上,结果负面到研究者提前终止了实验。
| 服务器延迟(ms) | 到下一次点击的时间增加量(ms) | 每用户查询量 | 每用户任意点击量 | 用户满意度 | 每用户收入 |
|---|---|---|---|---|---|
| 50 | — | — | — | — | — |
| 200 | 500 | — | −0.3% | −0.4% | — |
| 500 | 1200 | — | −1.0% | −0.9% | −1.2% |
| 1000 | 1900 | −0.7% | −1.9% | −1.6% | −2.8% |
| 2000 | 3100 | −1.8% | −4.4% | −3.8% | −4.3% |
正因为如此重视互联网服务中所有用户的满意度,性能目标通常要求高比例请求低于某个延迟阈值,而不只是规定平均延迟。这种阈值目标称为服务级目标(SLO)。例如,某个 SLO 可以要求 99% 的请求低于 100 ms。因此,Amazon Dynamo 键值存储系统的设计者决定:为了让建立在 Dynamo 之上的服务提供良好延迟,存储系统必须在 99.9% 的情况下达到其延迟目标(DeCandia 等,2007)。例如,Dynamo 的一次改进,对第 99.9 百分位延迟的改善远大于对平均情况的改善,体现了它的优先考虑。
Dean 与 Barroso(2013)提出 tail tolerant 一词,描述为满足这类目标而设计的系统:
正如容错计算旨在用较不可靠的部件构建可靠的整体,大型在线服务也需要用较不可预测的部件,构建响应时间可预测的整体。
不可预测性的来源包括:缓存、网络等共享资源争用,排队,Turbo 模式等优化和 DVFS 等节能技术造成的微处理器性能变化,软件垃圾回收,以及许多其他因素。Google 认为,与其试图消除 WSC 中这种变化,不如开发能够容忍尾部延迟的技术,掩盖或绕过暂时的延迟尖峰。例如,细粒度负载均衡可以在服务器之间迅速移动少量工作,减少排队延迟。
通过能耗与工作量成比例提高效率
如 6.6 节所述,PUE 虽然衡量 WSC 能效,却不反映 IT 设备内部发生的事情。另一种电力低效来自服务器内部电源,它把输入的较高交流或直流电压,转换为芯片和磁盘使用的低电压。2007 年,许多电源效率只有 60%–80%,因此服务器内部的损耗,甚至高于从公共电网高压线路,经多次转换到服务器低压供电的全部损耗。原因之一是电源额定功率经常超过主板实际需要。而且,这类电源通常在负载不超过 25% 时效率最差;图 6.35 表明,许多 WSC 服务器恰好工作在这个区间。计算机主板上的稳压模块(VRM)效率也可能较低。
Barroso 与 Hölzle(2007)认为,整台服务器应以 energy proportionality 为目标,即能耗与完成的工作量成比例。十五年后,我们已接近,却仍未达到这一理想。例如,第 1 章中 SPECpower 评价最高的服务器,空闲时仍消耗满负载功率的约 20%,负载只有 20% 时却消耗近 50%。相较 2007 年,这已是巨大进步:当时计算机空闲时使用满负载功率的 60%,20% 负载时使用 70%;但仍有改善空间。
传统系统软件的设计,只要可能提高性能,就会利用所有可用资源,而不考虑能耗影响。例如,操作系统会把全部内存用于程序数据或文件缓存,即使其中很多数据很可能永远不会被使用。近来,WSC 软件设计者开始针对能源使用及其与工作量的比例关系进行优化。例如,Lo 等(2014)设计了一个动态控制器,通过细粒度功率管理,让一组服务器刚好满足在线服务的 SLO 要求。这样改善了能耗与工作量的比例关系:服务器在 10%–60% 利用率下运行时,可节省 20%–30% 的能耗。