6.8 融会贯通:AWS 云中的定制芯片
Amazon Web Services(AWS)于 2006 年推出,是第一家提供 IaaS 云实例的厂商。截至 2023 年初,AWS 是最大的公有云提供商,提供超过 200 项云服务,按当时收入速度折算的年收入为 800 亿美元。AWS 在全球拥有云基础设施,已启用 30 个地理区域和 410 个接入点,包括边缘站点与缓存。在这 30 个区域中,AWS 运营 96 个可用区;每个可用区由一座或多座独立 WSC 组成,各自位于独立设施中,具有冗余供电、网络与连接。
AWS 一直为其云基础设施开发软硬件技术,总体目标是降低 TCO,并改善客户工作负载的性能与成本。除 6.7 节的效率优化之外,近期 AWS 云系统的发展还针对以下目标:
- 消除虚拟化开销。 这既降低基础设施成本,也让客户能将全部可用计算周期用于应用,还显著减少能源使用,以及运行阶段和制造建设阶段的碳排放。
- 减少新技术部署与维护的时间和成本。 新 CPU、加速器、新 DRAM 或 Flash 芯片等技术,为云运营商与客户带来显著的成本和性能改善。为取得最大收益,需要把部署时间从数月缩短到数周,并使客户工作负载感知的维护停机时间实际上降为零。
- 提高可用性与可靠性。 云设施正在成为像电力和电信系统一样的关键公共服务,因此不能轻易停摆。
- 扩大使用场景与目标市场。 例如,AWS 设计了 Outpost 机架,让一组 AWS 计算和存储单元能够安全地放在客户或第三方场地,支持因延迟、安全或监管原因而要求本地部署或边缘部署的应用。
过去十年,定制芯片在 AWS 基础设施中扮演着越来越重要的角色。2015 年,AWS 收购无晶圆厂半导体公司 Annapurna Labs,此后该公司开发了一系列针对云计算基础设施优化的芯片与系统。AWS 的使用规模足以支持自行开发芯片,与在 WSC 中使用商用芯片相比,获得以下收益:
- 纵向创新。 在横向分工的 IT 生态中,芯片、硬件和软件厂商各自在交付边界内优化。自行设计芯片后,AWS 可以纵向创新,例如增加能在系统级或 WSC 级节省成本的芯片功能。
- 专门化。 AWS 芯片设计优先实现能在其使用场景中带来显著端到端收益的功能。商用芯片则必须针对多个潜在客户的场景优化;长长的功能清单导致设计折中,也增加设计时间、芯片面积与功耗。
- 开发速度。 软件团队通常在新商用芯片部署之后,才开始相应开发。控制芯片与软件设计周期后,AWS 可以并行开发两者,确保硬件一部署,软件就已准备好,从每代芯片取得最大价值。
- 安全性。 定制芯片让 AWS 从整体设计整个系统,缩小攻击面。AWS 使用自有芯片提供硬件信任根,对芯片上运行的固件进行形式化验证,并把服务器内部交互限制在一组范围很窄的安全 API 中。
- 更低成本。 商用芯片售价比成本高 20%–100%。以 AWS 的规模,省去芯片厂商利润空间能带来大量节省,足以支撑自研芯片的成本。
到 2023 年初,AWS 已在 WSC 中部署以下定制芯片:
- Nitro: 一系列芯片,用于卸载并加速 hypervisor 与 I/O 任务,例如 VM 网络、VM 存储和 RDMA。
- Nitro Security: 部署在 AWS 主板上的小型芯片,支持主动监控硬件接口的安全性,并进行安全固件升级。
- Graviton: 面向云工作负载、兼顾性能、功耗与成本效率的 CPU 系列。
- Trainium 与 Inferentia: 用于 ML 训练和推理的 DSA 系列。第 7 章讨论 ML DSA 芯片的体系结构。
Nitro 系统
hypervisor 介入每次 I/O 操作,是云工作负载性能开销的重要来源。例如,在网络方面,它必须实现虚拟私有网络(VPC)所需的封装与解封装,执行安全规则和速率限制,并实现路由。现代 I/O 设备速度很高,例如 200 Gbps 以太网 NIC 和 5 Gbps NVMe 驱动器;现代服务器又可承载大量客户 VM,因此 hypervisor 任务可能占据宿主 CPU 的多个核心。如果专门为 hypervisor 预留这些核心,宿主机有效容量就显著降低;如果不预留,随着整体 I/O 流量变化,客户工作负载可能经历显著的性能抖动。最后,在与客户 VM 相同的 CPU 上运行复杂 hypervisor,也带来安全风险。
Nitro 项目的目标,是把几乎全部 hypervisor 任务卸载到 AWS 定制芯片,将所有 CPU 周期留给 VM 工作负载。AWS 自 2013 年起逐步实现这一目标。到 2017 年,原先基于 Xen 的 hypervisor 被极简的 Nitro hypervisor 替代。这个基于 KVM 的 hypervisor,只在 VM 启动或调整规模时,通过配置 VT-x、VT-d 等 CPU 功能,分配核心、内存与中断。如果 CPU 支持 posted interrupts,其他所有事件,包括频繁的 I/O 流量,都无需 hypervisor 介入。Nitro hypervisor 的功能范围有限,使其 CPU 开销可以忽略,也缩小了与 VM 的接口,提高安全性。
其余 hypervisor 任务由基于 AWS 定制芯片的一系列 Nitro 卡实现:
- Elastic Network Adapter(ENA)控制器。 这是 PCIe 以太网 NIC,通过 SR-IOV 让客户 VM 直接访问 ENA 虚拟功能。ENA 接口采用 6.5 节介绍的提交队列和完成队列。NIC 实现 VPC 数据平面任务,包括封装/解封装、安全规则、速率限制、路由、时间同步和流量加密。
- Elastic Fabric Adapter(EFA)控制器。 这是针对数据密集型 ML 与 HPC 应用优化的 PCIe NIC。与 RoCE 和 IB NIC 类似,EFA 在 NIC 中实现完整网络传输协议,支持绕过操作系统。AWS SRD 协议提供可靠数据报服务,利用 WSC 网络的多路径特征实现高吞吐量与低延迟(Shalev 等,2020)。应用通过 OFI Libfabric 或 NVIDIA Collective Communications Library(NCCL)等常用通信框架使用 EFA。NIC 为 GPU 和其他 DSA 支持零复制网络,也支持全部基础 VPC 数据平面任务。
- Elastic Block Storage(EBS)控制器。 PCIe EBS 控制器向客户 VM 暴露一组 NVMe 虚拟功能,使其经网络访问块存储卷。因此,VM 可以动态增删卷、调整卷大小,也可以暂停一段时间,或迁移到新机器后重新连接持久化 EBS 卷。控制器实现经网络访问远程存储所需的全部系统软件,包括零复制、数据完整性检查、屏障与快照,以及加密存储卷所需的密码算法。
- 实例存储控制器。 这块 PCIe 卡向客户 VM 暴露一组 NVMe 虚拟功能,使其访问本地 Flash 和硬盘。控制器实现透明加密;VM 终止时销毁密钥,使磁盘上的临时数据无法再访问。它为共享磁盘提供限速,实现完整性检查、快照与驱动器监控。对于 Flash 存储,它还实现 FTL 逻辑,即 Nitro-SSD。
- Nitro Controller 卡。 通过被动 API 端点与 EC2 控制平面交互,并协调其他全部 Nitro 卡及 Nitro hypervisor,实现资源分配和实例生命周期管理。
迄今,AWS 已实现五代 Nitro 卡芯片。全部芯片都包含 Arm 核心,使功能可以不断演进。每代有多种板卡,有时还采用多个芯片版本,支持特定用途。通常每种有独立产品型号(SKU),例如 EFA 网络专用 SKU、EBS 专用 SKU、面向大批量服务器配置、把所有功能集成在一个芯片中的主流“一体化”SKU,以及不含 Nitro 功能的简单 NIC SKU。Nitro 卡支持无中断升级:更新卡上固件时,不必停止宿主 CPU 上运行的 VM。
图 6.37 展示 Nitro 卡与 hypervisor 如何协作启动 VM 实例。收到客户请求后,EC2 控制平面寻找能够承载请求的服务器。首先,控制平面向该服务器的 Nitro Controller 发送启动命令(步骤 1)。接着,Nitro Controller 为 VM 分配特定核心与内存区域(步骤 2),要求 hypervisor 按这一分配配置 CPU(步骤 3)。随后,它映射包含 VM 启动镜像的 EBS 卷(步骤 4),通过 NVMe 接口将其提供给宿主机(步骤 5);并设置该 VM 关联的其他 EFA、ENA、EBS 与本地实例存储设备(步骤 6)。最后,将实例置为可运行状态,使其能够启动(步骤 7)。VM 开始运行后,只有核心、内存或设备分配变化,或 VM 自身调用 hypervisor 时,hypervisor 才执行。由于它基本不再介入运行路径,VM 实例与裸金属实例的性能几乎相同,如图 6.38 所示。
Nitro 系统加快了新技术部署。几乎全部虚拟化任务都由 Nitro 卡实现,因此部署新 CPU、DSA、存储系统,或支持新操作系统,无需投入大量精力移植或扩展 hypervisor。让服务器以裸金属配置运行,等价于启动 VM 而不在宿主 CPU 上运行 hypervisor。实例和服务器的管理都通过 Nitro 卡统一完成。
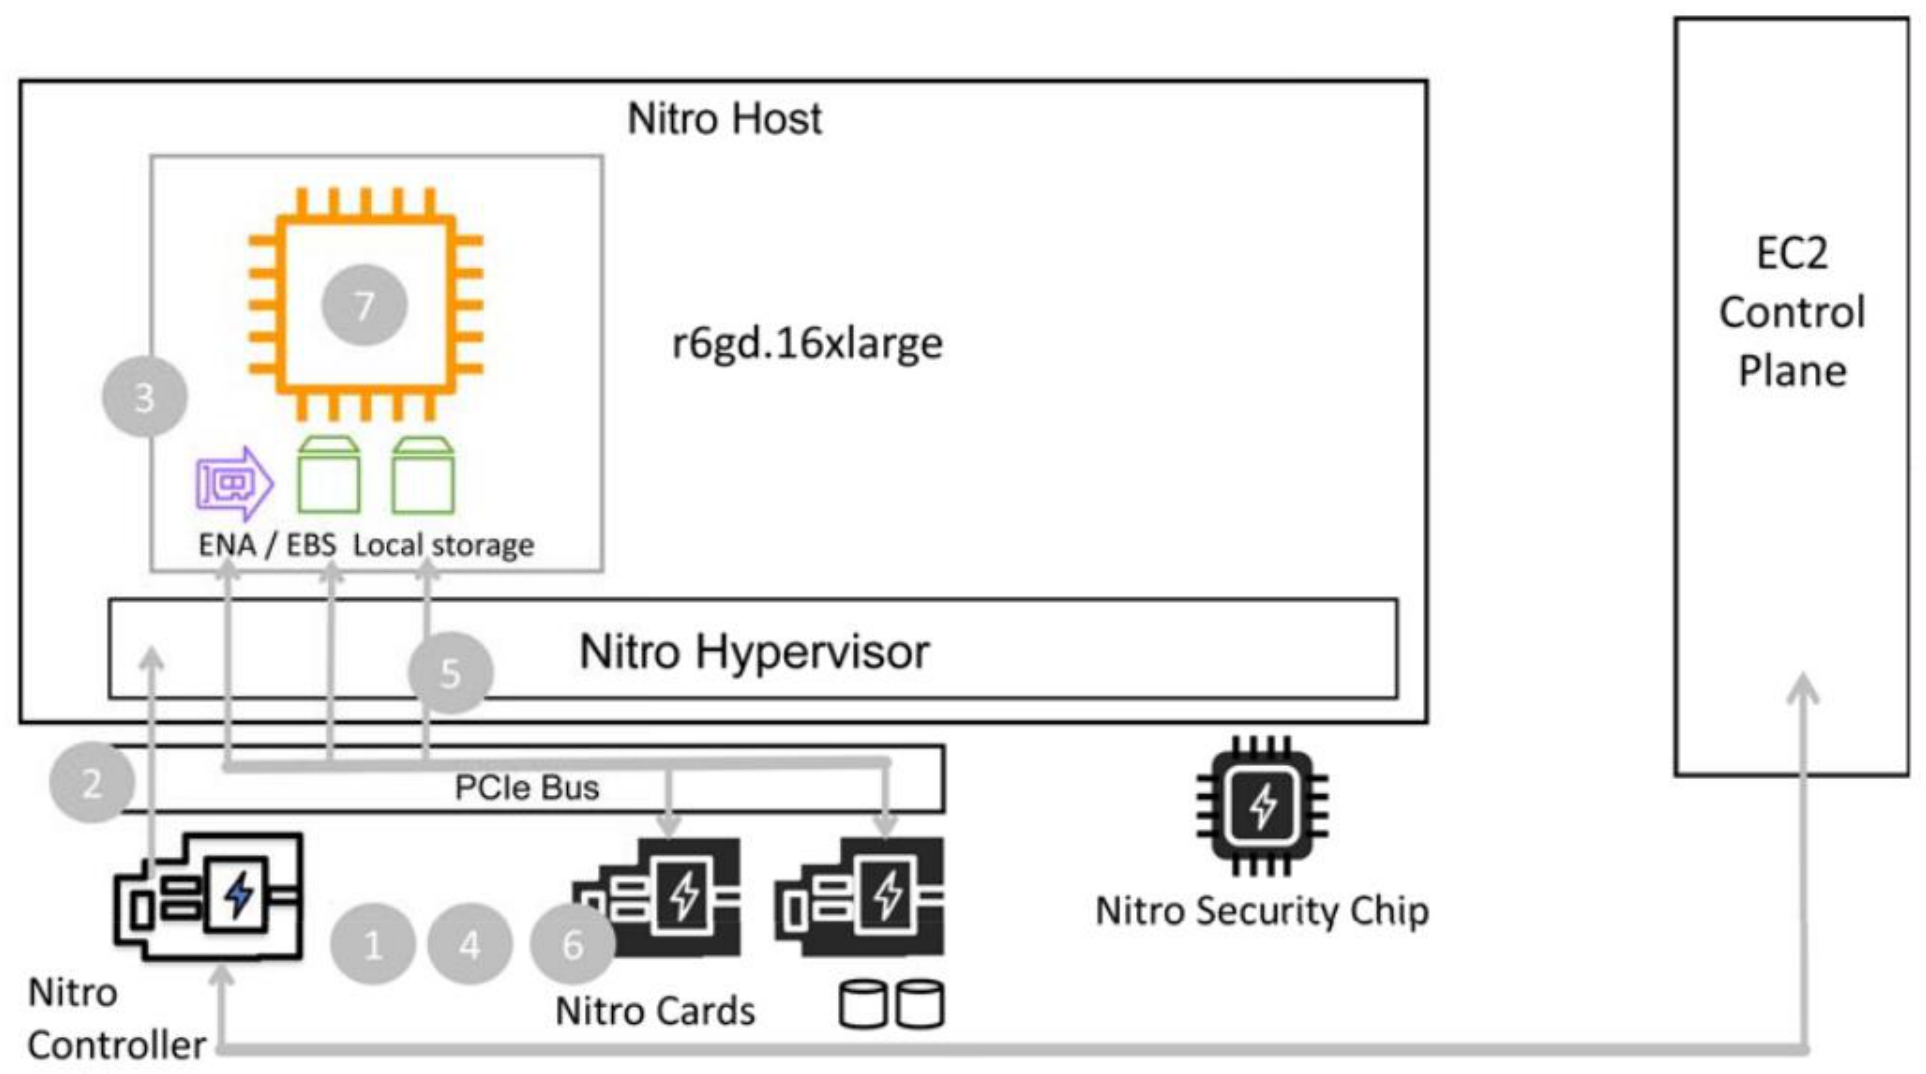
图内术语:Nitro Host=Nitro 宿主机;EC2 Control Plane=EC2 控制平面;Local storage=本地存储;Nitro Hypervisor=Nitro 虚拟机监控器;PCIe Bus=PCIe 总线;Nitro Controller=Nitro 控制器;Nitro Cards=Nitro 卡;Nitro Security Chip=Nitro 安全芯片。步骤 1–7 对应正文。
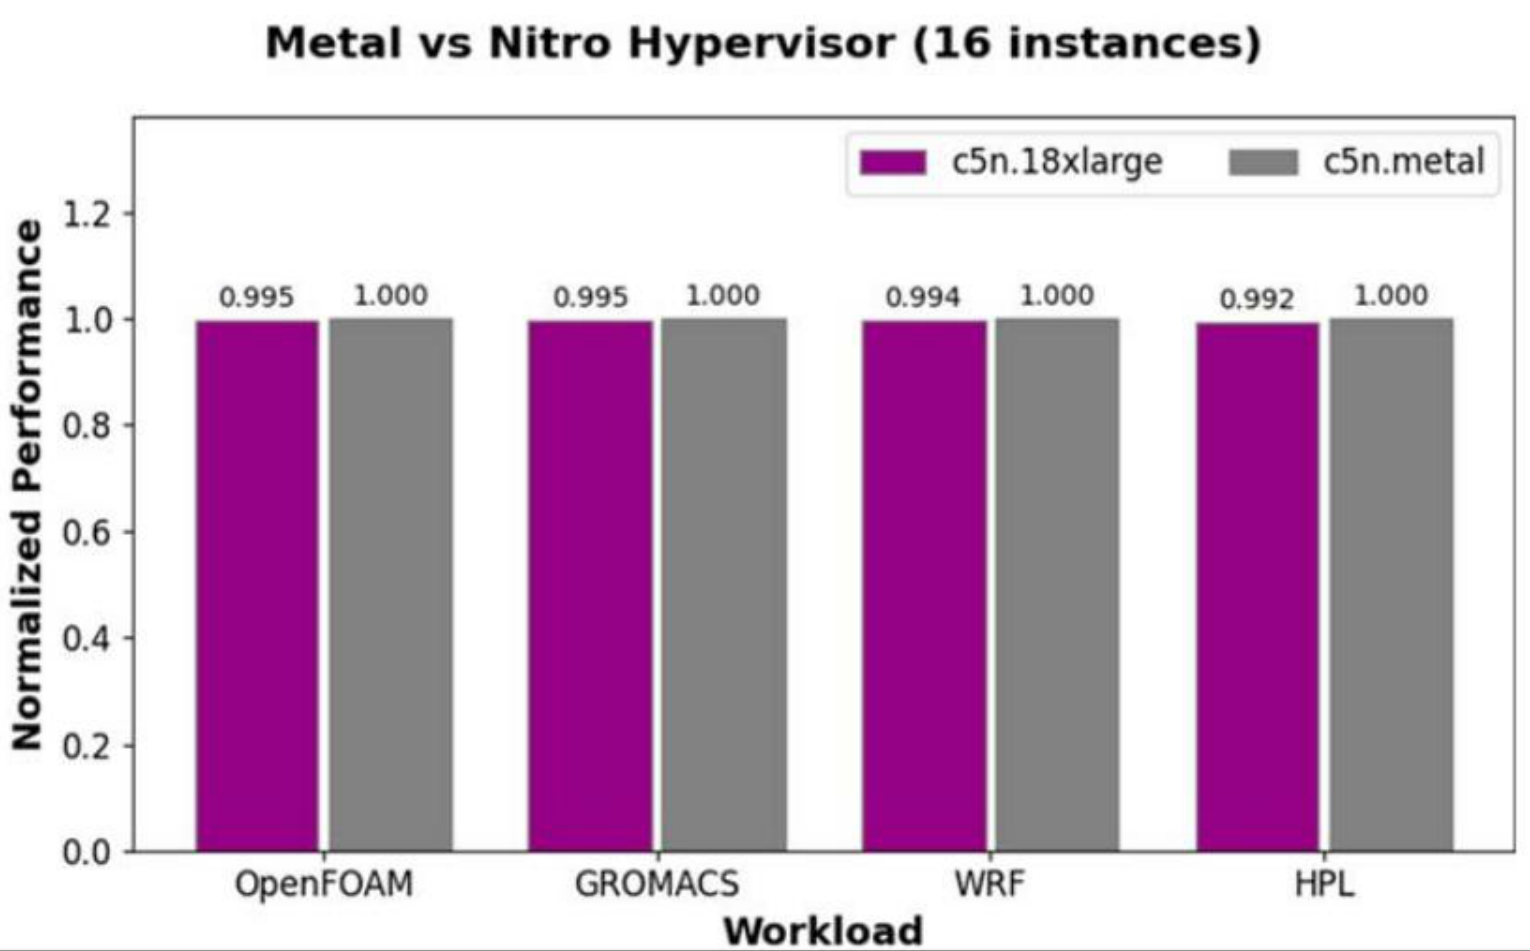
工作负载细节:Bare metal performance with the AWS Nitro System。图内标题 Metal vs Nitro Hypervisor (16 instances)=裸金属与 Nitro hypervisor 对比(16 个实例);Normalized Performance=归一化性能;Workload=工作负载。以裸金属为 1.000,VM 在 OpenFOAM、GROMACS、WRF、HPL 上分别为 0.995、0.995、0.994、0.992。
译注: 原图注将 EFA 带宽写为“100 GBps”,大写 B 表示字节。
Nitro 系统出现之前,AWS 大约提供 70 种 EC2 实例。到 2023 年初,已超过 600 种,涵盖多种 CPU(Intel 和 AMD x86、AWS 和 Apple Arm)、加速器(GPU、ML DSA、视频 DSA、FPGA)、存储与网络选项,以及操作系统(Linux、Windows、Unix、macOS)。
Nitro 的安全机制
Nitro Security 是一块放在服务器主板上的小芯片,通过 SPI 或 I2C 总线等接口,监控对本地非易失性存储设备的全部操作,检测异常,并负责提供与验证主板固件。在基于 x86 的宿主机中,它还位于 BMC 与 CPU 之间。这块芯片有两个重要作用。第一,禁止 CPU 上运行的任何软件更新包括 BMC 固件在内的所有固件;固件更新通过 Nitro Controller 提供,主板上不保存固件。这样消除了针对 SPI Flash 等存储设备的零日攻击和供应链攻击。第二,协助 Nitro Controller 完成安全启动与证明过程。
启动开始时,Security 芯片让服务器 CPU 与 BMC 保持复位,直到 Nitro Controller 完成自身安全启动与服务器身份验证。Nitro Controller 使用抗篡改的可信平台模块(TPM),通过密码学度量并验证自身启动 ROM 的完整性和有效性。TPM 保存用于对已知良好度量值进行数字签名的密钥。如果启动 ROM 有效,Nitro Controller 就继续度量和验证后续启动阶段使用的固件,以及服务器运行期间使用的软件镜像,从而扩展信任链。如果检测到无效固件,立即将服务器撤出服务,在问题解决前不运行客户负载。AWS 已形式化验证 Nitro 系统早期启动代码的内存安全属性(Cook 等,2021)。Nitro 完成安全启动后,下载并验证服务器主板固件;此时,Security 芯片才允许 CPU 与 BMC 启动。
Nitro 的安全启动保护裸金属服务器,因为 CPU 上的操作系统无法修改服务器的 BIOS、BMC 或其他固件。它也阻止因失误或恶意而部署未经正确签名、未经正式生产部署流程发布的固件。最后,它使 Nitro 系统能够部署到 AWS 设施之外,例如 Outpost 机架和边缘场景。AWS 可以远程证明 Nitro 服务器正在运行获准的固件与软件镜像组合,然后才允许它们运行客户负载,并连接 AWS 数据中心中的服务。
除安全启动之外,Nitro 的另一项重要安全特性,是让 AWS 员工无需直接访问用户数据,就能进行云管理。
本地存储与主存使用 VM 专属密钥加密,VM 终止时销毁密钥。持久化存储卷可以使用客户提供的密钥加密。AWS 数据中心之间的全部网络流量,在物理层透明加密;对大多数 EC2 实例类型,VPC 内全部流量在 Nitro 卡中透明加密。所有 AWS 管理 API 都经过加密、身份验证与授权,并记录日志。
Graviton CPU 芯片
AWS 开发基于 Arm 的 Graviton CPU,目标是为 EC2 实例提供尽可能好的性价比,并构建能效更高的服务器。2018 年,Graviton1 成为首个在大型云提供商中支撑 IaaS 实例的 Arm CPU,证明 Arm 软硬件生态可以大规模支持云应用。
图 6.39 列出三代 Graviton 的关键特征。利用第 3、4 章讨论的乱序执行与 SIMD 技术,每核心性能持续提高。
| 特征 | Graviton 1 | Graviton 2 | Graviton 3(E) |
|---|---|---|---|
| 发布年份 | 2018 | 2019 | 2021 |
| 制造工艺 | 16 nm | 7 nm | 7 nm |
| 晶体管数(十亿) | 5 | 30 | 55 |
| 指令集 | ARMv8.0a | ARMv8.2a + fp16、rcpc、dotprod、crypto | ARMv8.4 + sve、rng、bf16、int8、crypto |
| 时钟频率 | 2.3 GHz | 2.5 GHz | 2.6 GHz |
| 核心数 | 16 | 64 | 64 |
| 核心类型 | Cortex-A72 | Neoverse-N1 | Neoverse-V1 |
| 取指/译码/发射宽度 | 3 / 3 / 5 | 4–8 / 4 / 8 | 8 / 5–8 / 15 |
| 功能单元数:整数、FP/SIMD、LD/ST、BR | 3 / 2 / 2 / 1 | 3 / 2 / 2 / 1 | 4 / 4 / 5 / 2 |
| SIMD 功能单元 | 2 × 128 位(Neon) | 2 × 128 位(Neon) | 4 × 128 位(Neon);2 × 256(SVE) |
| ROB 大小 | 128 | 128 | 256 |
| 每核 L1I/L1D/L2 | 48 KB / 32 KB / — | 64 KB / 64 KB / 1 MB | 64 KB / 64 KB / 1 MB |
| LLC 大小 | 8 MB | 32 MB | 32 MB |
| DRAM 类型 | DDR4-2633 | DDR4-3200 | DDR5-4800 |
| DRAM 控制器数 | 2 | 8 | 8 |
| DRAM 带宽 | 40 GB/s | 200 GB/s | 300 GB/s |
| DRAM 加密 | 否 | 是 | 是 |
| PCIe 代际 | Gen4 | Gen4 | Gen5 |
| PCIe 通道数 | 32 | 48 | 64 |
Graviton2 核心约为 Graviton1 的两倍快;Graviton3 又将整数和浮点性能分别提高 30% 和 60%。多年来,每芯片内存带宽从 50 GB/s 提高到 300 GB/s,以支撑更高单核性能和四倍的核心数量。
图 6.40 展示 Graviton3 的体系结构。封装由七个 chiplet 组成。主 chiplet 包含 64 个核心及其缓存,以对分带宽 2 TB/s 的网状互连连接。左右各两个 chiplet 包含内存控制器与卸载功能,底部两个 chiplet 则包含 PCIe 接口和其他 I/O 功能。Graviton3 的多个方面针对云部署优化。第一,采用不支持 SMT 的核心,避免共享 SMT 核心的两个线程相互干扰,提高 L1 缓存、分支预测器与 TLB 的效率。第二,不支持双插槽服务器配置。这限制了单个 VM 能使用的核心数,却不再要求软件栈进行 NUMA 优化,并降低成本与功耗。类似 6.3 节讨论的 Meta Yosemite 服务器,Graviton3 机箱内包含三台单插槽服务器,共享 Nitro 卡、BMC 和电源,以摊销系统级成本。第三,采用 DDR5-4800 内存。内存带宽提高 50%,使较小的 L3 缓存成为可能;云实例使用大量核心时,这对性能尤其重要。最后,Graviton3 实现多种安全功能,包括始终启用的主存加密、Arm 指针认证扩展,以及为 Arm TRNG 指令提供的真随机数发生器。它也支持 posted interrupts,使 I/O 中断无需 hypervisor 介入即可直接递送给客户 VM。
译注: 正文称内存带宽从 50 GB/s 提高,图 6.39 的 Graviton1 却列为 40 GB/s,两者均保留。原文把 Meta Yosemite 的介绍指向 6.3 节,实际位于 6.4 节。图 6.39 和后面的图 6.41 均将 Graviton3 工艺写为 7 nm;本文忠实保留这一原书规格及其论述,未将它改写成其他版本的数据。
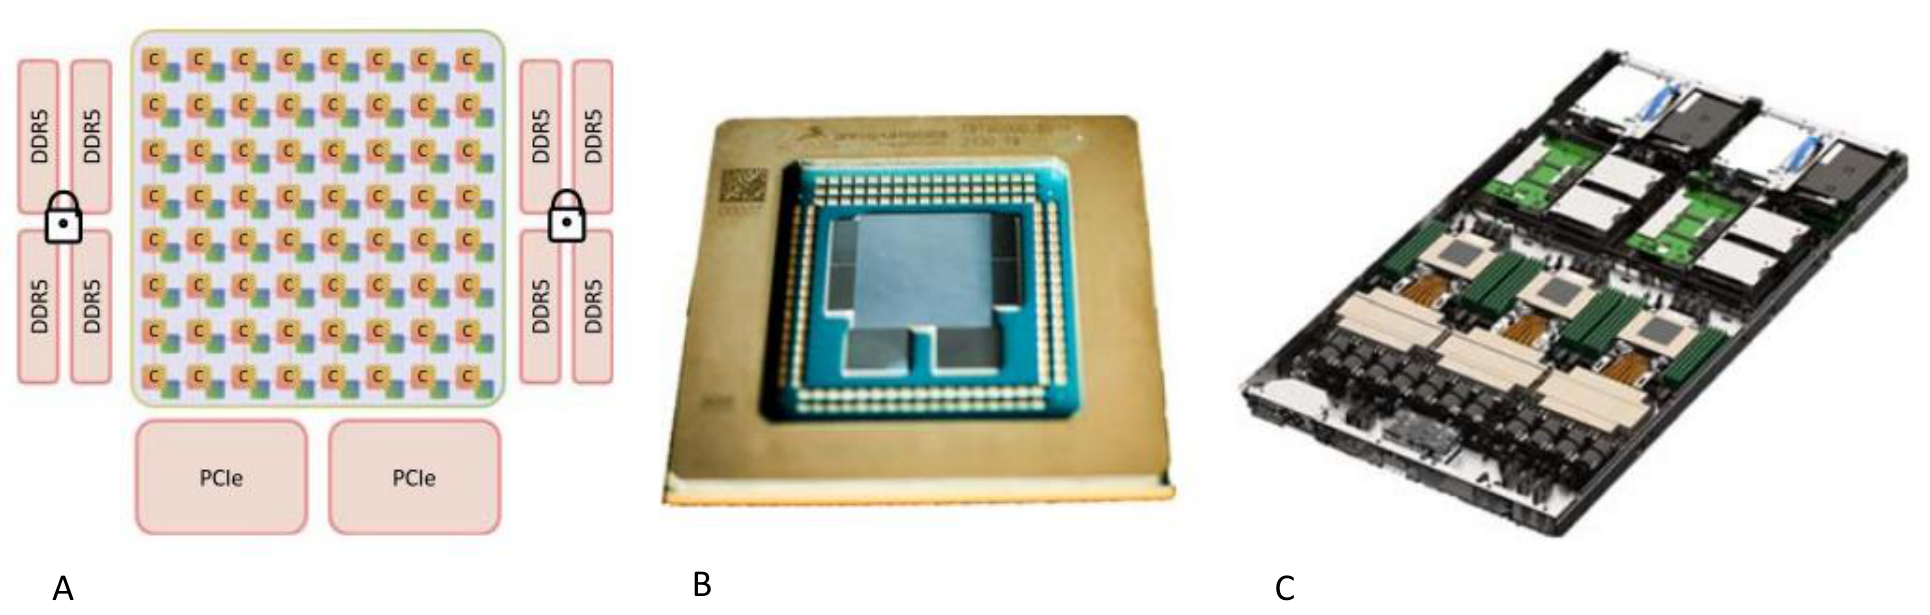
图内 DDR5、PCIe 为内存和 I/O 接口标识;中央 C 表示核心。
AWS 虽然自行生产 CPU,仍部署 x86 CPU 和 Apple CPU。它服务数百万客户,各自的软件兼容性限制与性能需求不同。某种 CPU 可能最适合代码占用大、随机访存多的负载,另一种则可能最适合 I/O 密集型负载。AWS 提供 CPU 体系结构、时钟频率、网络和存储配置不同的广泛实例,让客户为自己的负载选择最佳方案。在确定自有 CPU 规模时,AWS 追求性价比。有些 CPU 只要约一半核心满载,就会达到热设计功耗(TDP)限制;云厂商不得不让其余核心空闲,承担更高成本,或让所有核心以较低时钟频率、或启用节流机制运行,接受较低性能。AWS 考察整个服务器群负载分布第 50、90、99 百分位的 CPU 功耗及每瓦性能,偏好在第 50 和 90 百分位下,按性能归一化后功耗更低的设计。Graviton CPU 以能耗随工作量成比例为设计目标,50% 负载时消耗约 50% TDP。AWS 还通过协同优化 CPU、网络与存储追求端到端效率。应用在每个实例上达到尽可能好的性能,同样负载就需要更少实例,从而为客户节省费用、为云提供商降低 TCO,并减少运行排放和制造建设阶段的碳排放。
面向云计算的 CPU 效率
为了理解云计算选择 CPU 时的权衡,下面考察 2022 年第四季度可用的六种 AWS 计算实例,在 SPEC CPU2017 基准测试套件上的性能估计。图 6.41 列出实例配置及所用 CPU。所有实例都占用一整台物理服务器,可能是单插槽或双插槽。六种 CPU 代表 Intel、AMD、AWS 各两代产品,在乱序核心数量、存储层次结构与功耗方面差异显著。
图 6.42 展示每个实例只使用一个虚拟核心(vCPU)时的 SPEC CPU2017 性能估计。对支持 SMT 的 CPU 微体系结构,原文列举 AMD Milan 和两代 Intel CPU,这相当于测量一个核心以单线程模式运行时的性能。符合预期的是,采用 Intel、AMD、AWS 2021 年芯片的 m6i、m6a、c7g,分别优于同一厂商 2019 年芯片对应的 c5、c5a、c6g。各 CPU 厂商都逐步改善处理器的 ILP 能力,采用更长的向量指令,有时还提高时钟频率。使用 Intel Ice Lake 的 m6i 在整数负载上表现最好,使用 AMD Milan 的 m6a 在浮点负载上表现最好。不过,对于具体基准测试,最优核心可能差异很大。三种 2021 年核心各有一项比其他两者高出 25% 以上:Intel Ice Lake 对应 520.omnetpp,AMD Milan 对应原文所写的 519.lbr,AWS Graviton3 对应 549.fotonik3d。这种差异说明云平台提供 CPU 选择的优势。客户可以在不同实例上测试自己的具体负载,选择硬件特性与负载最匹配的一种。
| 项目 | c5.metal | c5a.24xlarge | c6g.metal | m6i.32xlarge | m6a.48xlarge | c7g.16xlarge |
|---|---|---|---|---|---|---|
| 实例信息 | ||||||
| CPU 插槽数 | 2 | 1 | 1 | 2 | 2 | 1 |
| 每实例总核心数 | 48 | 48 | 64 | 64 | 96 | 64 |
| 每实例总 vCPU 数 | 96 | 96 | 64 | 128 | 192 | 64 |
| CPU 芯片信息 | ||||||
| CPU 芯片 | Intel Xeon 8275L | AMD EPYC 7R32 | AWS Graviton2 | Intel Xeon 8375C | AMD EPYC 7R13 | AWS Graviton3 |
| 体系结构 | Cascade Lake | Rome | Graviton2 | Ice Lake | Milan | Graviton3 |
| 推出年份 | 2019 | 2019 | 2019 | 2021 | 2021 | 2021 |
| 工艺 | 14 nm | 7 nm | 7 nm | 10 nm | 7 nm | 7 nm |
| 每芯片核心数 | 24 | 48 | 64 | 32 | 48 | 64 |
| 每核 SMT 线程数 | 2 | 2 | 1 | 2 | 2 | 1 |
| 全核 Turbo 频率(GHz) | 3.00 | 2.80 | 2.50 | 3.50 | 2.90 | 2.60 |
| 最高单核 Turbo 频率(GHz) | 3.90 | 3.30 | 2.50 | 3.50 | 3.60 | 2.60 |
| L3 缓存大小(MB) | 36 | 192 | 32 | 54 | 256 | 32 |
| 每插槽 DRAM 通道数 | 6 | 8 | 8 | 8 | 8 | 8 |
| DRAM 类型 | DDR4-2933 | DDR4-3200 | DDR4-3200 | DDR4-3200 | DDR4-3200 | DDR5-4800 |
| 每插槽 DRAM 带宽(GB/s) | 141 | 205 | 205 | 205 | 205 | 300 |
| 每插槽估计功耗(W) | 240 | 280 | 130 | 280 | 300 | 170 |
图 6.43 展示每种实例使用全部可用 vCPU 时的 SPEC CPU2017 性能估计。对于所有整数基准测试,m6a 实例吞吐量最高,因为它支持最多的并发 vCPU:96 个 AMD Milan 核心,每核两个线程,共 192 个 vCPU。
| 类别 | 基准测试 | c5.metal | c5a.24xlarge | c6g.metal | m6i.32xlarge | m6a.48xlarge | c7g.16xlarge |
|---|---|---|---|---|---|---|---|
| 整数 | 500.perlbench_r | 5.88 | 4.27 | 3.68 | 6.55 | 5.02 | 5.09 |
| 整数 | 502.gcc_r | 6.79 | 6.01 | 4.58 | 7.68 | 7.07 | 7.27 |
| 整数 | 505.mcf_r | 5.63 | 5.55 | 4.95 | 5.90 | 6.70 | 7.15 |
| 整数 | 520.omnetpp_r | 5.95 | 3.49 | 3.81 | 6.76 | 5.07 | 5.37 |
| 整数 | 523.xalancbmk_r | 6.54 | 6.04 | 4.40 | 6.76 | 8.30 | 6.64 |
| 整数 | 525.x264_r | 9.49 | 9.14 | 7.35 | 10.39 | 10.85 | 11.76 |
| 整数 | 531.deepsjeng_r | 4.27 | 4.07 | 3.92 | 4.33 | 5.10 | 4.80 |
| 整数 | 541.leela_r | 4.00 | 3.56 | 3.54 | 4.13 | 4.32 | 4.23 |
| 整数 | 548.exchange2_r | 11.2 | 10.15 | 8.05 | 11.90 | 11.83 | 11.58 |
| 整数 | 557.xz_r | 3.65 | 2.88 | 2.58 | 3.78 | 3.67 | 3.25 |
| 浮点 | 503.bwaves_r | 36.49 | 61.14 | 35.68 | 45.33 | 74.52 | 74.39 |
| 浮点 | 507.cactuBSSN_r | 5.44 | 6.31 | 4.75 | 6.24 | 7.68 | 8.78 |
| 浮点 | 508.namd_r | 3.91 | 4.03 | 3.30 | 4.38 | 4.74 | 4.98 |
| 浮点 | 510.parest_r | 6.44 | 7.43 | 5.64 | 6.68 | 8.86 | 8.71 |
| 浮点 | 511.povray_r | 6.53 | 5.73 | 4.46 | 7.50 | 6.98 | 6.41 |
| 浮点 | 519.lbm_r | 3.93 | 6.21 | 3.62 | 4.71 | 7.55 | 6.00 |
| 浮点 | 521.wrf_r | 9.05 | 9.92 | 6.42 | 9.95 | 12.2 | 9.65 |
| 浮点 | 526.blender_r | 5.76 | 5.49 | 4.41 | 6.71 | 6.83 | 6.36 |
| 浮点 | 527.cam4_r | 7.41 | 8.25 | 5.12 | 8.33 | 9.85 | 8.16 |
| 浮点 | 538.imagick_r | 7.20 | 6.94 | 5.68 | 7.86 | 8.46 | 9.60 |
| 浮点 | 544.nab_r | 6.20 | 5.97 | 4.51 | 6.96 | 7.75 | 6.47 |
| 浮点 | 549.fotonik3d_r | 10.22 | 16.27 | 10.28 | 12.31 | 18.09 | 24.46 |
| 浮点 | 554.roms_r | 6.43 | 9.42 | 4.78 | 7.30 | 10.83 | 8.02 |
| 汇总 | 整数几何平均值 | 5.98 | 5.09 | 4.44 | 6.39 | 6.33 | 6.21 |
| 汇总 | 浮点几何平均值 | 7.22 | 8.48 | 5.84 | 8.23 | 10.22 | 9.69 |
译注: 正文写作“519.lbr”,表中实际为“519.lbm_r”;上方保留完整表名,正文原写法也已明示。图 6.41 表明 AMD Rome 同样有每核两个线程,原文前段列举支持 SMT 的 CPU 时没有把它列入。
| 类别 | 基准测试 | c5.metal | c5a.24xlarge | c6g.metal | m6i.32xlarge | m6a.48xlarge | c7g.16xlarge |
|---|---|---|---|---|---|---|---|
| 整数 | 500.perlbench_r | 230 | 226 | 198 | 333 | 478 | 272 |
| 整数 | 502.gcc_r | 233 | 199 | 127 | 330 | 436 | 166 |
| 整数 | 505.mcf_r | 151 | 124 | 106 | 236 | 261 | 204 |
| 整数 | 520.omnetpp_r | 146 | 126 | 104 | 200 | 249 | 124 |
| 整数 | 523.xalancbmk_r | 227 | 224 | 177 | 327 | 540 | 259 |
| 整数 | 525.x264_r | 442 | 487 | 440 | 625 | 1041 | 722 |
| 整数 | 531.deepsjeng_r | 226 | 255 | 237 | 315 | 572 | 299 |
| 整数 | 541.leela_r | 232 | 259 | 222 | 337 | 570 | 270 |
| 整数 | 548.exchange2_r | 511 | 593 | 502 | 828 | 1214 | 738 |
| 整数 | 557.xz_r | 166 | 164 | 119 | 223 | 346 | 140 |
| 浮点 | 503.bwaves_r | 486 | 285.92 | 360 | 716 | 597 | 630 |
| 浮点 | 507.cactuBSSN_r | 213 | 183.81 | 171 | 305 | 384 | 332 |
| 浮点 | 508.namd_r | 190 | 224.05 | 204 | 276 | 462 | 315 |
| 浮点 | 510.parest_r | 127 | 91.15 | 98 | 200 | 264 | 183 |
| 浮点 | 511.povray_r | 258 | 313.94 | 276 | 401 | 641 | 407 |
| 浮点 | 519.lbm_r | 54 | 32.55 | 36 | 75 | 71 | 63 |
| 浮点 | 521.wrf_r | 223 | 157.71 | 163 | 344 | 327 | 268 |
| 浮点 | 526.blender_r | 265 | 285.33 | 239 | 392 | 632 | 331 |
| 浮点 | 527.cam4_r | 296 | 271.04 | 227 | 410 | 661 | 368 |
| 浮点 | 538.imagick_r | 321 | 416.57 | 341 | 441 | 892 | 611 |
| 浮点 | 544.nab_r | 349 | 376.27 | 279 | 526 | 820 | 409 |
| 浮点 | 549.fotonik3d_r | 143 | 95.36 | 107 | 209 | 195 | 183 |
| 浮点 | 554.roms_r | 96 | 69.3 | 58 | 150 | 138 | 118 |
| 汇总 | 整数几何平均值 | 236 | 234 | 192 | 340 | 503 | 266 |
| 汇总 | 浮点几何平均值 | 202 | 174 | 164 | 298 | 380 | 276 |
对于浮点基准测试,m6i 在 64 个 Intel Ice Lake 核心上运行 128 个 vCPU,在约三分之一的测试中可与 m6a 竞争。这说明线程数量并不是高吞吐量计算唯一应考虑的因素;缓存、片上互连和功率管理等系统体系结构问题同样重要。
单台机器的绝对性能,并非云提供商或客户重视的唯一效率指标。云提供商很可能优化每瓦性能,以便在 WSC 有限功率预算内服务尽可能多的客户。云客户则很可能考虑性价比,寻找以最低成本达到某种性能水平的方法;也可能考虑每 vCPU 性能,因为 vCPU 是云实例的伸缩单位。图 6.44 比较 m6i、m6a、c7g 在 SPEC CPU2017 整数与浮点测试中的这些指标。基于 Graviton3 的 c7g,在其专门优化的每瓦性能与性价比两项指标上,具有显著的 2–3 倍优势。这对使用数十至数千个实例的横向扩展负载非常重要,无论它们是客户应用,还是数据库即服务、分析即服务等云服务。
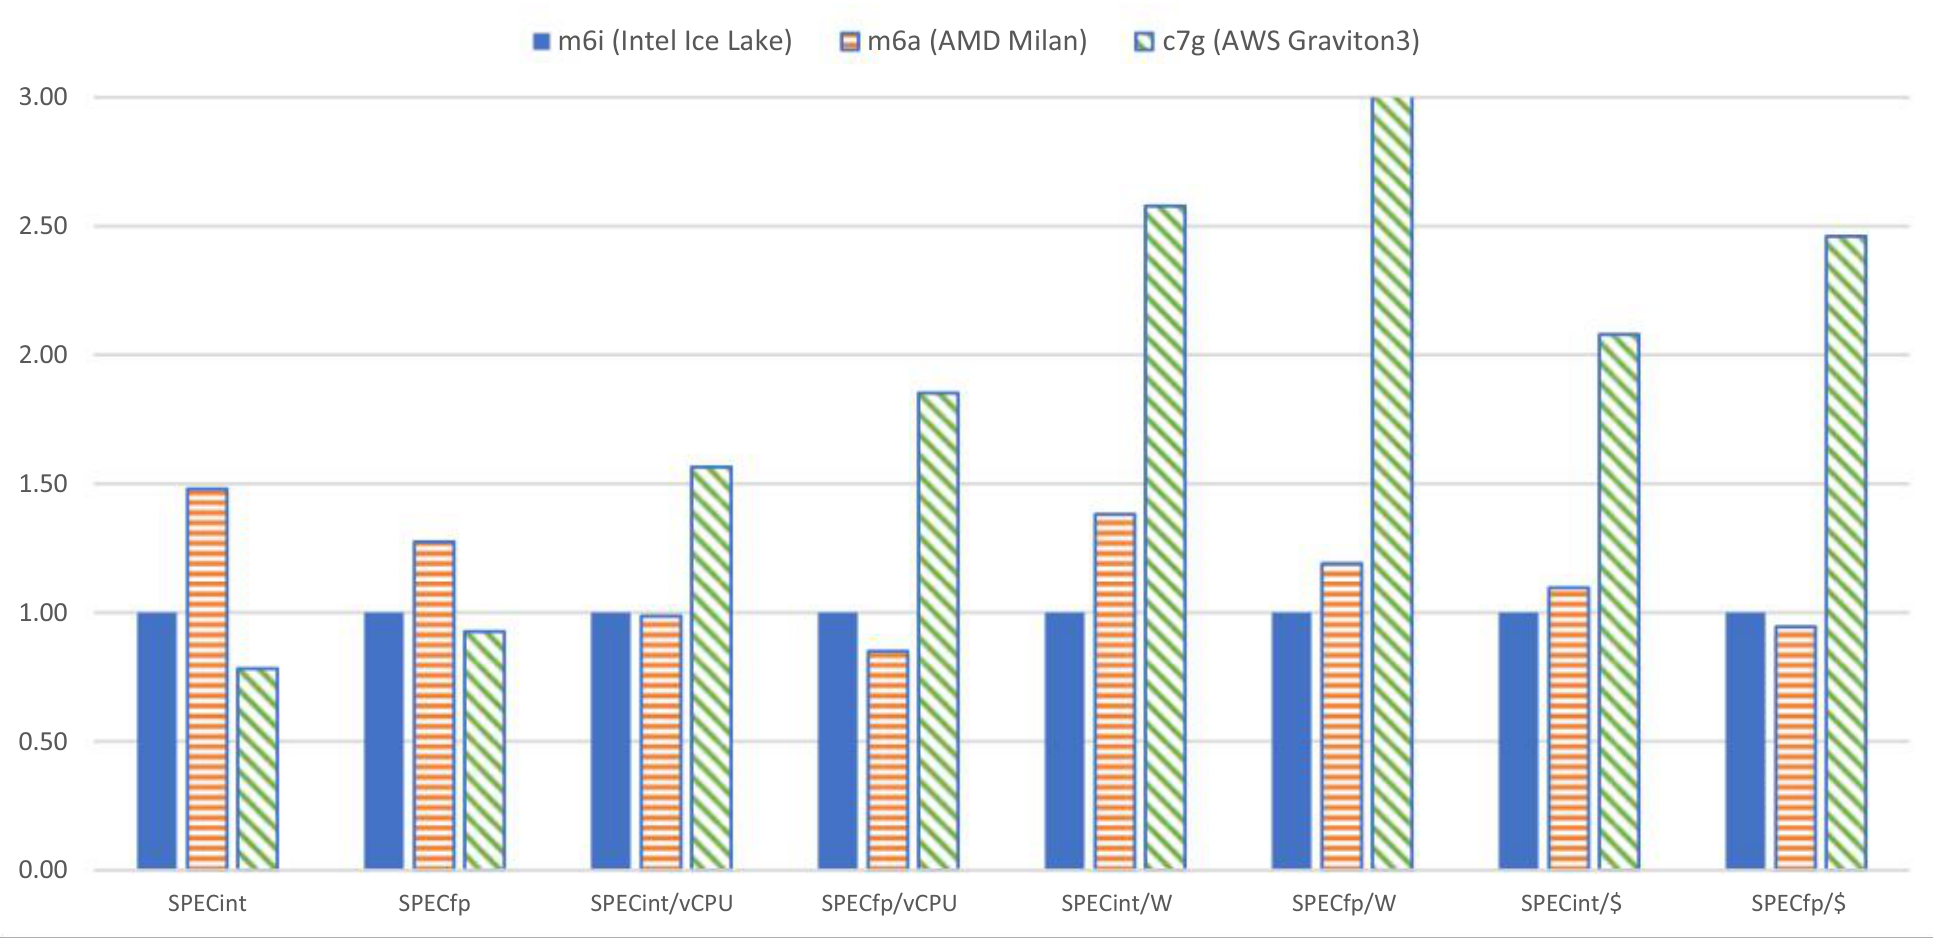
图内指标:SPECint、SPECfp=整数、浮点性能;/vCPU=每虚拟 CPU 性能;/W=每瓦性能;/$=每美元性能。三组柱分别为 m6i(Intel Ice Lake)、m6a(AMD Milan)、c7g(AWS Graviton3)。
这也表明,云提供商即使以现有硬件 IP 为起点——本例为商用 Arm 核心——自行构建 CPU 芯片仍能获得显著的端到端收益。