习题
作者:Parthasarathy Ranganathan。
习题 6.12
[10/10/10]〈6.1〉 WSC 得以实现的一个重要条件,是充足的请求级并行性,这与指令级或线程级并行性不同。本题探讨不同并行性对计算机体系结构和系统设计的影响。
a. [10]〈6.1〉 讨论一些场景:其中提高指令级或线程级并行性,能获得比请求级并行性更大的收益。
b. [10]〈6.1〉 增加请求级并行性,对软件设计有什么影响?
c. [10]〈6.1〉 增加请求级并行性可能有哪些缺点?
习题 6.13
[讨论/15/15]〈6.3,6.4〉 当云计算服务提供商收到由多个虚拟机(VM)组成的作业,例如 MapReduce 作业时,有许多调度选择。可以轮转调度 VM,使其分散到所有可用处理器和服务器上;也可以集中安排,尽量少用处理器。例如,提交一个包含 24 个 VM 的作业,而云中有 30 个处理器,每个最多运行 3 个 VM,轮转调度会使用 24 个处理器,集中调度则使用 8 个。调度器还可以在不同范围内寻找可用核心:CPU 插槽、服务器、机架,或者机架阵列。
a. [讨论]〈6.4〉 假设提交的作业都是计算密集型负载,但内存带宽需求可能不同。就供电与冷却成本、性能和可靠性而言,轮转调度与集中调度各有哪些利弊?
b. [15]〈6.4〉 假设提交的作业都是 I/O 密集型负载,在不同调度范围内,轮转调度与集中调度各有哪些利弊?
c. [15]〈6.4〉 假设提交的作业都是网络密集型负载,在不同调度范围内,轮转调度与集中调度各有哪些利弊?
习题 6.14
[15/15/10/10]〈6.4〉 MapReduce 等分布式计算框架让没有数据依赖的任务在多个节点上运行,通常使用商用硬件,从而实现大量并行性;不过,并行程度也有限制。例如,为提供冗余,MapReduce 会把数据块写到多个节点,消耗磁盘带宽,也可能消耗网络带宽。假设数据集总大小为 300 GB,网络带宽为 1 Gb/s,map 处理速率为 10 s/GB,reduce 处理速率为 20 s/GB。再假设 30% 的数据必须从远程节点读取,每个输出文件还要写入其他两个节点以提供冗余。其他参数使用图 6.21。
a. [15]〈6.4〉 假设所有节点位于同一机架。使用 5 个、10 个、100 个、1000 个节点时,预期运行时间各是多少?讨论每种节点规模下的瓶颈。
b. [15]〈6.4〉 假设每机架有 40 个节点,任一远程读写等概率地访问任何节点。使用 100 个、1000 个节点时,预期运行时间各是多少?
c. [10]〈6.4〉 一个重要考虑是尽可能减少数据移动。从本地访问变为机架内访问,再变为阵列内访问,会显著变慢,因此必须充分优化软件,最大限度利用局部性。假设每机架有 40 个节点,MapReduce 作业使用 1000 个节点。若远程访问有 20%、50%、80% 发生在同一机架内,运行时间分别是多少?
译注: 原题总难度标记有四项,但原页实际仅列 a–c 三个小问。
习题 6.15
[20/20/10/20/20/20]〈6.1,6.4〉 WSC 程序员常通过数据复制,在软件层面应对失效。例如,Hadoop 分布式文件系统(HDFS)采用三副本:一个本地副本、一个同机架内的远程副本,以及一个其他机架上的远程副本。不过,值得考察在什么情况下确实需要这样的复制。
a. [20]〈6.1〉 假设 Hadoop 集群较小,不超过 10 个节点,数据集不超过 10 TB。使用图 6.1 的失效频率数据,一个 10 节点 Hadoop 集群在采用单副本、双副本和三副本时,可用性分别如何?
b. [20]〈6.1〉 假设采用图 6.1 的失效数据,Hadoop 集群有 1000 个节点。在单副本、双副本和三副本情况下,其可用性分别如何?对于大规模系统中复制的收益,你能得出什么推论?
c. [10]〈6.1,6.4〉 复制的相对开销,随每个本地计算小时写入的数据量变化。一个 1000 节点 Hadoop 作业对 1 PB 数据排序,并把用于数据 shuffle 的中间结果写入 HDFS。计算额外的 I/O 流量,以及机架内和跨机架的网络流量。
d. [20]〈6.1,6.4〉 使用图 6.21,计算双副本和三副本的时间开销。再用图 6.1 的失效率,比较不复制、双副本和三副本情况下的预期执行时间。
e. [20]〈6.1,6.4〉 现在考虑一个复制日志的数据库系统,假设每笔事务平均访问硬盘一次,并产生 1 KB 日志。计算双副本和三副本的时间开销。如果事务在内存中执行,只需 10 μs,又如何?
f. [20]〈6.1,6.4〉 再考虑另一个数据库系统:为通过两阶段提交实现 ACID 一致性,需要两次网络往返。维护一致性以及副本的时间开销是多少?
习题 6.16
[15/15/20/讨论]〈6.1,6.9〉 请求级并行性使许多机器能够并行处理同一问题,从而提高整体性能;但一个挑战是如何避免把问题划分得过细。从服务级别协议(SLA)角度看,进一步划分、采用更小的问题规模,可能使满足目标 SLA 需要更多努力。假设 SLA 要求 95% 的查询在 0.5 秒内响应,且采用类似 MapReduce 的并行体系结构,可以启动多个冗余作业来得到同样的结果。以下各问采用图 6.46 的查询响应时间曲线。曲线给出基准服务器,以及采用较慢处理器型号的“小型”服务器,在不同每秒查询数下的响应延迟。
a. [15]〈6.1,6.9〉 假设查询响应时间曲线如图 6.46,WSC 每秒接收 30,000 次查询,需要多少台服务器才能满足 SLA?根据这一响应时间概率曲线,需要多少台“小型”服务器才能满足 SLA?只考虑服务器成本,为满足目标 SLA 并具有成本优势,“小型”服务器必须比普通服务器便宜多少?
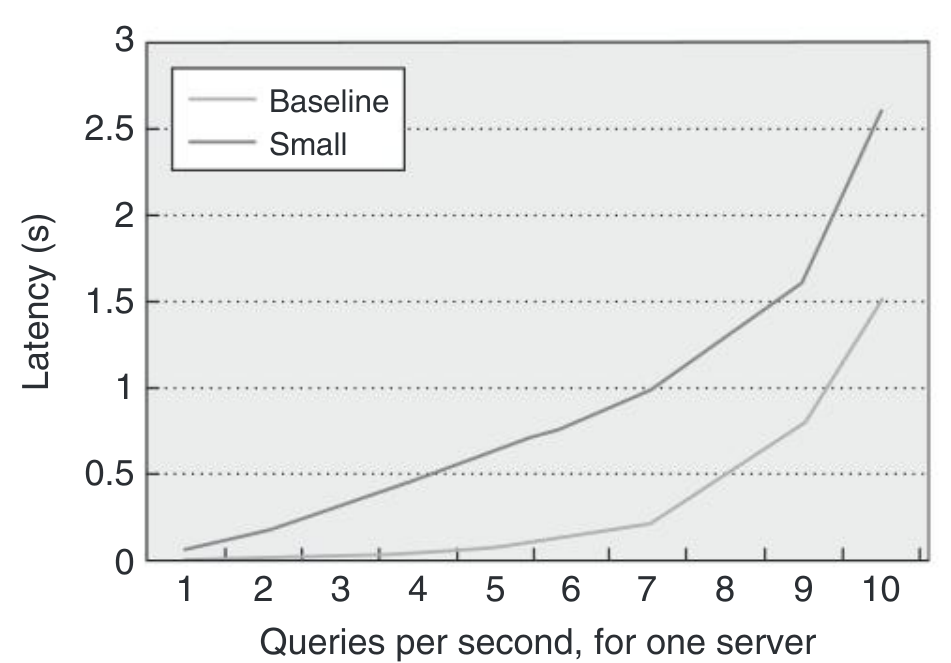
图内术语:Latency (s)=延迟(秒);Queries per second, for one server=单台服务器每秒查询数;Baseline=基准服务器;Small=小型服务器。
b. [15]〈6.1,6.9〉 “小型”服务器往往也因部件较便宜而可靠性较低。采用图 6.1 的数据,假设由不稳定机器和损坏内存引起的事件增加 30%。现在需要多少台“小型”服务器?它们必须比标准服务器便宜多少?
c. [20]〈6.1,6.9〉 现在假设是批处理环境。“小型”服务器整体性能为普通服务器的 30%。仍采用习题 6.15(b) 的可靠性数据,要提供与 2400 个标准服务器节点组成的阵列相同的预期吞吐量,需要多少个“小型”节点?假设性能随节点规模完美线性增长,每节点平均任务时长为 10 分钟。如果扩展效率为 85% 呢?60% 呢?
d. [讨论]〈6.1,6.9〉 扩展关系通常不是线性的,而是对数关系。一种自然反应可能是购买每节点计算能力更强的大型节点,以尽量减小阵列规模。讨论这种体系结构的一些权衡。
习题 6.17
[10/10/15/讨论]〈6.4,6.9〉 考虑把非易失性 Flash 加入存储层次结构,可以采用固态硬盘(SSD),或者通过 PCI Express 连接的卡。典型 SSD 带宽为 250 MB/s,延迟为 75 μs;PCIe 卡带宽为 600 MB/s,延迟为 35 μs。
a. [10] 在图 6.22 的本地服务器存储层次结构中加入这些点。假设它们在不同层次中访问时,其性能缩放系数与 DRAM 相同,那么经机架网络访问这些 Flash 设备时,表现如何?经阵列网络访问时呢?
b. [10] 讨论一些能够利用这一新增存储层次的软件优化。
c. [15] 如“谬误与陷阱”(6.9 节)所述,用 SSD 替换全部磁盘不一定划算。考虑一个使用 WSC 提供云服务的运营商,讨论哪些场景下使用 SSD 或其他 Flash 存储是合理的。
d. [讨论] 讨论存储层次结构中是否还可以容纳其他层次,例如更慢的内存(如分离式内存),或更慢的 Flash(采用更注重成本的技术)。
习题 6.18
[20/20/讨论]〈6.4〉存储层次结构。 一些 WSC 设计大量使用缓存来降低延迟;针对不同访问模式与需求,可以选择多种缓存方案。
a. [20] 考虑从 Web 提供富媒体流的设计选择,例如 Netflix 或 YouTube。首先需要估计视频数量、每个视频的编码格式数量,以及并发观看人数。假设一个流媒体提供商有 12,000 部可在线播放的作品,每部至少有四种编码格式,码率分别为 500、1000、1600、2200 kbps。再假设全站有 100,000 名并发观众,视频平均时长为 75 分钟,同时考虑 30 分钟节目与 2 小时视频。估算总存储容量、I/O 与网络带宽,以及视频流相关的计算需求。
b. [20] 对每位用户、每部视频以及全部视频整体而言,访问模式和引用局部性分别有什么特点?提示:随机还是顺序访问,时间局部性与空间局部性好还是差,工作集相对较小还是较大。
c. [讨论] 使用 DRAM、SSD 与硬盘,可以形成哪些影片存储方案?比较它们的性能与 TCO。习题 6.17(d) 中的其他存储技术是否有用?
习题 6.19
[20/讨论/讨论/讨论]〈6.4〉 考虑一个拥有 1 亿活跃用户的社交网站,用户用文字与图片发布自身动态,也浏览和互动其社交网络中的动态。为降低延迟,Facebook 等许多网站在后端存储/数据库层之前使用 memcached 缓存层。假设任一时刻,普通用户正在浏览兆字节量级的内容;任一天,普通用户上传的内容也为兆字节量级。
a. [20] 上述社交网站需要多少 DRAM 来容纳工作集?如果每台服务器有 96 GB DRAM,估计生成一个用户主页需要多少次本地内存访问与远程内存访问。
b. [讨论] 考虑两种候选 memcached 服务器设计:一种使用针对性能优化、耗能较高的核心,另一种使用较小、能效较高的核心,例如原文所举 Intel 和 AMD 发布的 E-core 与 P-core。memcached 需要大容量物理内存,却只有较低 CPU 利用率;这两种设计各有什么利弊?
c. [讨论] 当前内存模块与处理器紧密耦合,若要支持大容量内存,通常就必须增加 CPU 插槽数。列出其他能够提供大容量物理内存、又不必同比增加服务器插槽数量的设计,并比较它们的性能、功耗、成本与可靠性。
d. [讨论] 同一用户的信息,可以同时存在于 memcached 和存储服务器中;这些服务器又可以采用不同物理布局。讨论以下 WSC 布局的利弊:(1)把 memcached 放在同一台存储服务器上;(2)memcached 与存储服务器分属同一机架内的不同节点;(3)memcached 服务器集中在一组机架,存储服务器集中在另一组机架。
习题 6.20
[5/5/10/10/讨论/讨论/讨论]〈6.2,6.4,6.7〉数据中心网络。 MapReduce 等分布式框架与仓库级计算机结合,能有力地处理大规模数据。本题假设使用 4000 台服务器和 48,000 块硬盘,在 6 小时内对 1 PB 记录完成排序。
a. [5] 从图 6.21 及相关正文推导磁盘带宽。将数据读入主存、再把排序结果写回,需要多少秒?
b. [5] 假设每台服务器有两块 1 Gb/s 以太网 NIC,WSC 交换网络的超额订阅比为 4。在 4000 台服务器之间 shuffle 整个数据集,需要多少秒?
c. [10] 假设网络传输是 PB 级排序的性能瓶颈,能否估算 Google 数据中心采用的超额订阅比?
d. [10] 现在考察无超额订阅的 10 Gb/s 以太网的收益,例如采用 48 端口 10 Gb/s 以太网交换机,2010 年 Indy 排序基准测试冠军 TritonSort 就使用了这种配置。shuffle 1 PB 数据需要多久?
e. [讨论] 比较两种方法:(1)采用较高网络超额订阅比的大规模横向扩展系统;(2)采用高带宽网络的较小规模系统。各自可能的瓶颈是什么?在可扩展性与 TCO 方面,各有什么优缺点?
f. [讨论] 排序与许多重要科学计算负载都属于通信密集型,但许多其他负载并非如此。列举三个不能从高速网络获益的负载。对这两类负载,你会推荐哪些 EC2 实例?
g. [讨论] 查看 Sort Benchmark 中的各种基准测试,以及各类测试最近的优胜者。这些结果与 (e) 的讨论有什么对应关系?最近的 CloudSort 冠军使用的云实例,与 (f) 中的答案相比如何?
习题 6.21
[10/25/讨论]〈6.4,6.7〉 WSC 规模庞大,因此必须根据预期运行的负载,适当分配网络资源。不同分配方案会显著影响性能和总拥有成本。
a. [10] 使用图 6.32 电子表格中的数据,每台接入层交换机的超额订阅比是多少?如果减半,TCO 有何变化?如果加倍呢?
b. [25] 对受网络限制的负载,降低超额订阅比可能提高性能。假设一个计算作业使用 120 台服务器,读取 5 TB 数据。读取数据、中间数据和输出数据的比例,与图 6.47 中 2009 年 9 月相同;存储层次结构的带宽采用图 6.21。读取数据时,50% 来自远程磁盘;其中 80% 来自机架内,20% 来自阵列内。中间数据与输出数据有 30% 使用远程磁盘;其中 90% 位于机架内,10% 位于阵列内。将超额订阅比减半,整体性能会改善多少?如果超额订阅比加倍,性能又如何?计算各情况下的 TCO。
| 月份 | MapReduce 作业数 | 平均完成时间(s) | 每作业平均服务器数 | 每服务器平均核心数 | CPU 核心年 | 输入数据(PB) | 中间数据(PB) | 输出数据(PB) |
|---|---|---|---|---|---|---|---|---|
| 2016 年 9 月 | 95,775,891 | 331 | 130 | 2.4 | 311,691 | 11,553 | 4095 | 6982 |
| 2015 年 9 月 | 115,375,750 | 231 | 120 | 2.7 | 272,322 | 8307 | 3980 | 5801 |
| 2014 年 9 月 | 55,913,646 | 412 | 142 | 1.9 | 200,778 | 5989 | 2530 | 3951 |
| 2013 年 9 月 | 28,328,775 | 469 | 137 | 1.4 | 81,992 | 2579 | 1193 | 1684 |
| 2012 年 9 月 | 15,662,118 | 480 | 142 | 1.8 | 60,987 | 2171 | 818 | 874 |
| 2011 年 9 月 | 7,961,481 | 499 | 147 | 2.2 | 40,993 | 1162 | 276 | 333 |
| 2010 年 9 月 | 5,207,069 | 714 | 164 | 1.6 | 30,262 | 573 | 139 | 37 |
| 2009 年 9 月 | 4,114,919 | 515 | 156 | 3.2 | 33,582 | 548 | 118 | 99 |
| 2007 年 9 月 | 2,217,000 | 395 | 394 | 1.0 | 11,081 | 394 | 34 | 14 |
| 2006 年 3 月 | 171,000 | 874 | 268 | 1.6 | 2002 | 51 | 7 | 3 |
| 2004 年 8 月 | 29,000 | 634 | 157 | 1.9 | 217 | 3.2 | 0.7 | 0.2 |
c. [讨论] 你认为新兴技术趋势将怎样影响未来 WSC 的设计?例如,每个系统的核心越来越多,包括使用 chiplet;光互连带来更高带宽与更高能效。
习题 6.22
[5/15/15/20/25/讨论/讨论]〈6.2〉发挥云的能力。 假设你是 Alexa.com 排名靠前网站的运维与基础设施经理,正在考虑使用 Amazon Web Services(AWS)。决定是否迁移到 AWS 时,需要考虑哪些因素?可以使用什么服务和实例类型,能节省多少费用?你可以用 Alexa 和网站流量信息,例如 Wikipedia 的页面访问统计,估计热门网站的流量;也可以采用网上的具体案例,例如每日 280 万次页面浏览的 Drupal 单服务器案例。
这组幻灯片描述了一个 Alexa 排名第 3400、每日页面浏览量 280 万的网站,只使用一台服务器。服务器配有两颗四核 2.5 GHz Xeon、8 GB DRAM,以及三块构成 RAID1 的 15,000 RPM SAS 硬盘,每月成本约 $400。网站大量使用缓存,CPU 利用率在 50%–250% 之间,约相当于 0.5–2.5 个核心繁忙。
a. [5] 查看可用的 EC2 实例类型,哪些能够达到或超过当前服务器配置?
b. [15] 查看 EC2 价格信息,选择在 AWS 托管此网站最具成本效益的 EC2 实例,允许组合使用。每月 EC2 成本是多少?
c. [15] 再把 IP 地址和网络流量成本纳入计算,假设网站每天经互联网传入、传出 100 GB 数据。现在网站每月成本是多少?
d. [20] 原题所述 AWS 还向新客户免费提供一年微型实例,并对跨 AWS 的传入和传出流量各提供 15 GB 配额。根据你对所在部门 Web 服务器峰值与平均流量的估计,能否免费把它托管在 AWS?
e. [25] 如果 Netflix.com 这样大得多的网站,把流媒体与编码基础设施迁往 AWS,根据其服务特征,它可以使用哪些 AWS 服务,各自用于什么目的?
f. [讨论] 查看 Google、Microsoft、Alibaba 等其他云提供商的类似产品。(a)–(e) 的答案会怎样变化?
g. [讨论] “无服务器计算”(serverless computing)让你不必考虑具体服务器,就能构建和运行更高层次的应用与服务。例如 AWS Lambda、Google Cloud Functions、Microsoft Azure Functions 等。继续以网站运维与基础设施经理的身份考虑:什么时候会采用无服务器计算?
习题 6.23
[讨论/讨论/20/20/讨论]〈6.7,6.9〉 图 6.36 展示用户感知的响应时间如何影响收入,说明了为什么必须在保持低延迟的同时获得高吞吐量。
a. [讨论] 以 Web 搜索为例,有哪些可能降低查询延迟的方法?
b. [讨论] 为了解时间花在哪里,可以收集哪些监控统计?你准备如何实现这种监控工具?
c. [20] 假设每次查询的磁盘访问次数服从均值为 2、标准差为 3 的正态分布。要满足 95% 查询延迟不超过 0.1 s 的 SLA,磁盘访问延迟需要达到什么水平?
d. [20] 内存缓存可以减少访问硬盘等长延迟事件的发生频率。假设稳态命中率为 40%,命中延迟为 0.05 s,未命中延迟为 0.2 s,缓存能否帮助满足 95% 查询延迟不超过 0.1 s 的 SLA?
e. [讨论] 缓存内容何时会过时,甚至变得不一致?这种情况可能多久发生一次?如何检测并使这些内容失效?
习题 6.24
[15/15/20/讨论]〈6.6,6.7〉 典型电源单元(PSU)的效率随负载变化。例如,原题把第一档写为效率约“80%—40% load”,例子是一台 100 W PSU 输出 40 W;负载在 20%–40% 之间时,效率为 75%;负载低于 20% 时,效率为 65%。
译注: 原页确实印为“80%—40% load”,效率 80% 与负载 40% 之间缺少明确关系词,也没有清楚界定第一档负载范围。
a. [15] 假设一台服务器的实际功率与 CPU 利用率成正比,利用率曲线如图 6.48。PSU 平均效率是多少?
b. [15] 假设服务器的 PSU 采用 冗余,即 PSU 数量加倍,以保证一台 PSU 失效时仍能稳定供电。PSU 平均效率是多少?
c. [20] 刀片服务器厂商使用共享 PSU 池,既提供冗余,也能动态调整启用的 PSU 数量,使其匹配服务器实际功耗。假设一个刀片机箱共有 16 台服务器,最多使用 6 台 PSU。服务器利用率曲线相同,这种情况下机箱的 PSU 平均效率是多少?
d. [讨论] 结合图 6.32 和图 6.33 中更广泛的 TCO 讨论,考虑不同效率数值的影响:不同设计怎样影响总体 TCO?据此,你会如何优化未来仓库级计算机的设计?
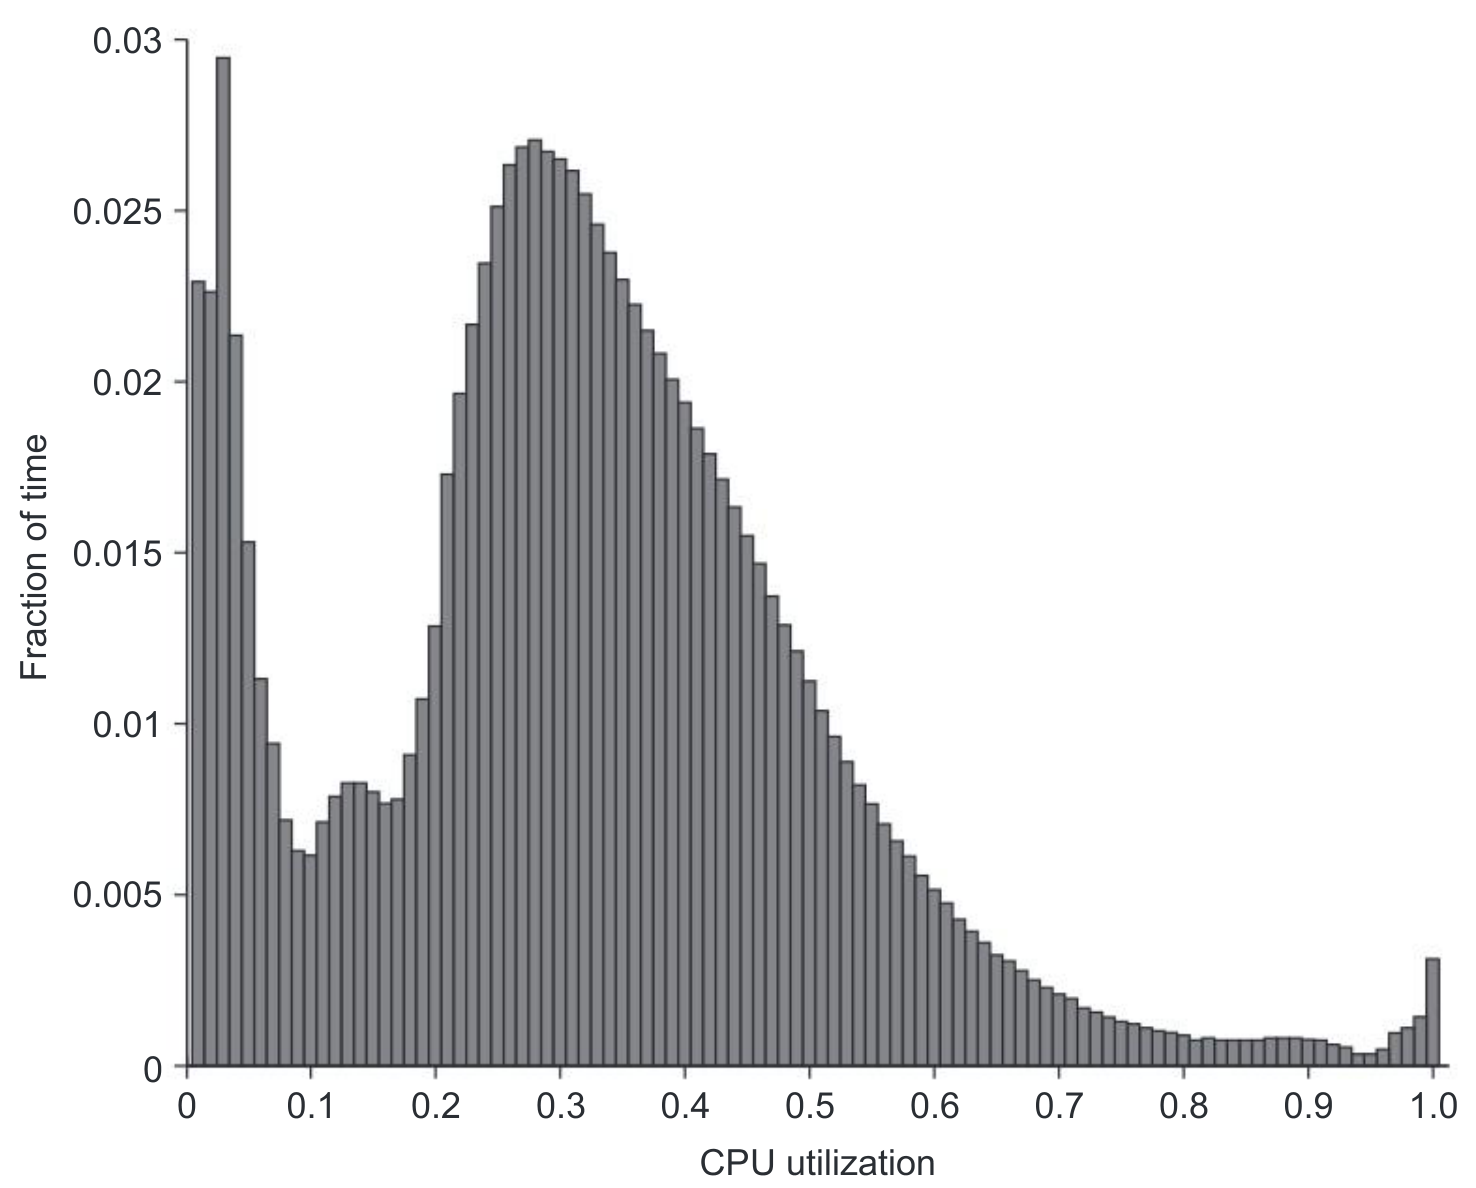
图内术语:Fraction of time=时间占比;CPU utilization=CPU 利用率。
习题 6.25
[5/讨论/10/15/讨论/讨论/讨论]〈6.6,6.9〉 Power stranding 指数据中心已经配置、却未使用的电力容量。考察图 6.49 中不同机器分组的数据(Fan、Weber 和 Barroso,2007)。注意,该论文所称的 cluster(集群),相当于本章所称的 array(阵列)。
a. [5] (1)机架级、(2)配电单元级、(3)阵列(集群)级,各有多少闲置电力容量?机器分组越大,电力容量的超额订阅呈现什么趋势?
b. [讨论] 你认为不同机器分组之间闲置电力容量的差异,是什么原因造成的?
c. [10] 考虑一个阵列级机器集合,全部机器实际总功率从不超过总配置功率的 72%;这有时也称为“总和的峰值”与“峰值的总和”之比。使用案例研究中的成本模型,比较按峰值容量配置与按实际使用配置的数据中心,计算可节省的成本。
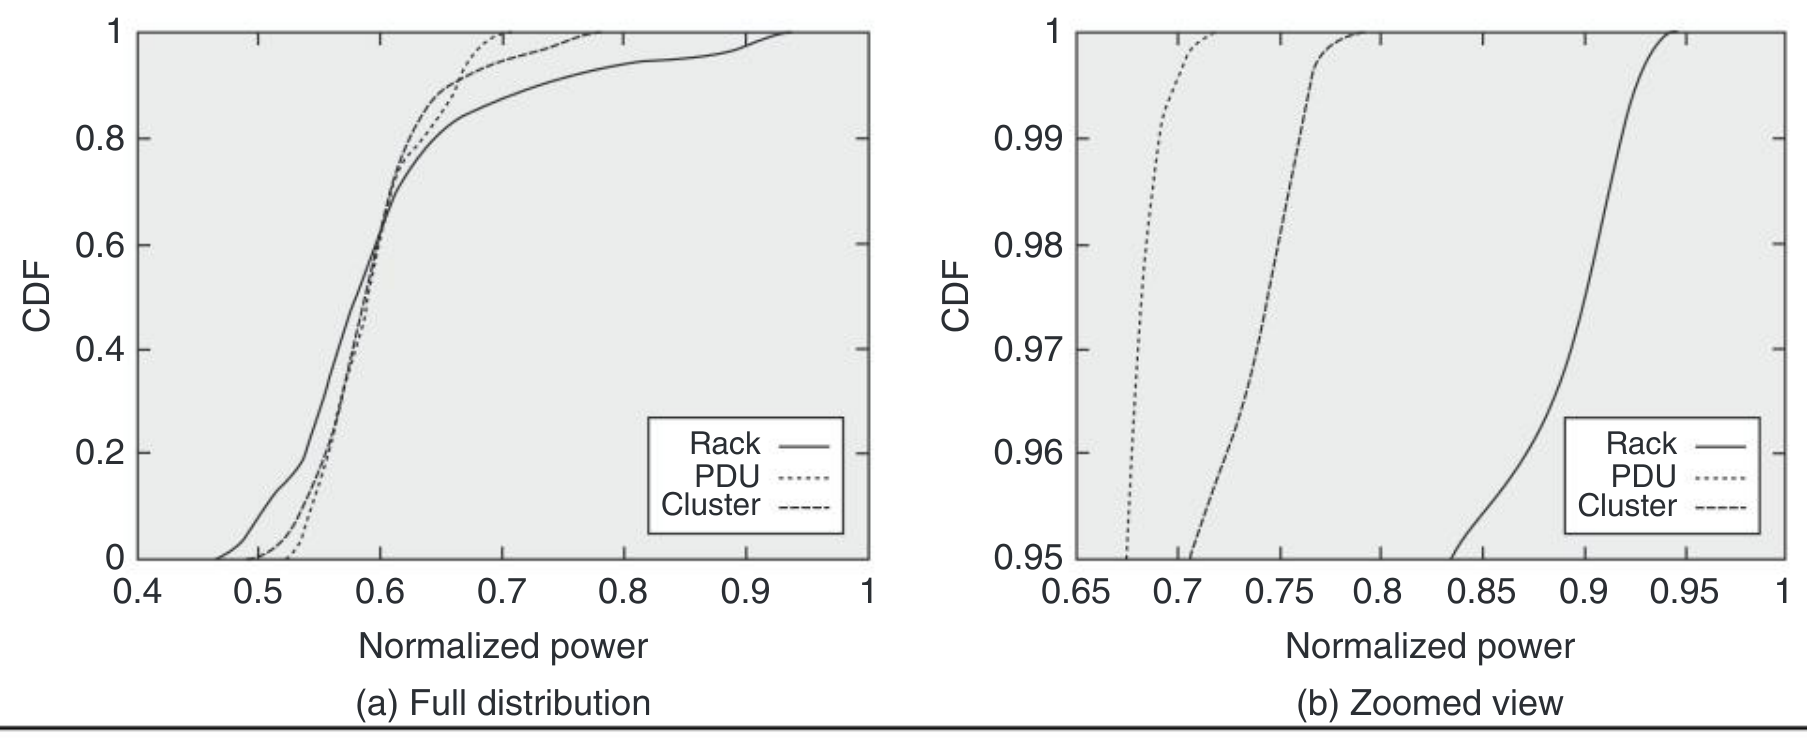
图内术语:Normalized power=归一化功率;Rack=机架;PDU=配电单元;Cluster=集群,对应本章的阵列;(a) Full distribution=完整分布;(b) Zoomed view=局部放大。
d. [15] 假设数据中心设计者决定在阵列级增加服务器,利用闲置电力容量。采用 (a) 的示例配置与假设,在总供电配置不变的情况下,WSC 可以增加多少台服务器?
e. [讨论] 要使 (d) 的优化在实际部署中可行,需要什么条件?提示:考虑极少数情况下,阵列中所有服务器同时达到峰值功率时,应如何限制功率。
f. [讨论] 可以设想两类功率上限管理策略(Ranganathan 等,2006):(1)事先制定功率预算的预先控制策略——“不要假定可以多用电,用之前先申请!”;(2)一旦违反预算再限制功率的响应式策略——“只要还没被告知不行,就按需要用电!”讨论两者的权衡,以及分别适合什么情况。
g. [讨论] 如果系统的能耗变得更接近与工作量成比例,总闲置电力容量会发生什么变化?
习题 6.26
[5/20/讨论]〈6.6,6.7〉 6.6 节讨论了每机架配置电池、作为本地 UPS 的方法。可以进一步把电池配置到每台服务器。下面考察这种设计的影响。
a. [5] 假设用电池作为服务器级微型 UPS,效率为 99.99%,从而不再需要效率只有 92% 的设施级 UPS。假设变电站开关效率为 99.7%,PDU、降压级与其他断路器的效率分别为 98%、98%、99%。计算每服务器电池备份方案带来的总体供电基础设施效率改善。
b. [20] 假设 UPS 成本为 IT 设备成本的 10%。使用案例研究成本模型的其他假设,求电池成本的盈亏平衡点,以单台服务器成本的比例表示:电池低于什么成本时,电池方案的 TCO 优于设施级 UPS?
c. [讨论] 两种方法还有哪些权衡?特别是,你认为两种设计的可管理性与失效模型会如何变化?
习题 6.27
[5/5/讨论]〈6.6,6.7〉 本题考虑 WSC 总运行功率的一个简化方程,如下:
译注: 题目缺少此处所述的方程。
a. [5] 假设一个 8 MW 数据中心的电力使用率为 80%,电价为每千瓦时 $0.10,冷却低效乘数为 0.8。比较两种优化的成本节省:(1)冷却效率提高 20%;(2)IT 设备能效提高 20%。
b. [5] IT 设备能效需要提高百分之多少,才能达到冷却效率提高 20% 的成本节省?
c. [讨论] 对于服务器能效优化与冷却能效优化的相对重要性,你能得出什么结论?
习题 6.28
[5/5/讨论]〈6.6,6.7〉 如本章所述,WSC 的冷却设备本身也可能消耗大量能量。主动管理温度可以降低冷却成本。已有一种优化方案是感知温度的负载放置:识别给定机房的冷却分布,把较热系统放到较冷位置,从而降低 WSC 整体冷却需求。
a. [5] 计算机房空调(CRAC)的性能系数(COP)衡量其效率,定义为移除的热量 与移除这些热量所需功 之比。CRAC 送入静压空间的空气温度越高,COP 越大。如果回风温度为 20°C,以 COP 1.9 移除 10 kW 热量,CRAC 消耗多少能量?如果同样体积的空气以 25°C 回流,冷却时 COP 为 3.1,现在 CRAC 消耗多少能量?
b. [5] 假设一种工作负载分配算法能把较热负载恰当地映射到较冷位置,让 CRAC 像上一问那样在较高温度下运行,提高冷却效率。上述两种情况之间节省多少功率?
c. [讨论] 鉴于 WSC 的规模,电源管理可能是复杂而多方面的问题。能效优化可以在硬件或软件中实现,可以针对 IT 设备或冷却设备,在系统级或集群级实施,等等。设计 WSC 整体能效方案时,必须考虑这些交互。设有一种整合算法,观察服务器利用率,把不同类别负载集中在同一服务器上以提高利用率;如果系统的能耗与工作量不成比例,这可能让服务器运行在能效更高的状态。这种优化与同时尝试使用不同电源状态的另一算法,会怎样相互影响?可参考 ACPI(Advanced Configuration Power Interface)中的例子。你还能想到哪些 WSC 中多种优化可能冲突的例子?你会怎样解决?
习题 6.29
[5/10/15/20]〈6.7〉 能耗与工作量成比例(energy proportionality,有时也称 energy scale-down),是指系统空闲时不耗电,更重要的是,功耗随活动水平和完成的工作量按比例逐渐增加。本题考察不同模型对能耗的影响。除非另有说明,以下默认使用图 6.50 的数据。
a. [5] 分析这种比例关系的一种简单方法,是假设活动水平与功率呈线性关系。仅使用图 6.50 的峰值功率和空闲功率数据,通过线性插值,绘制能效随利用率变化的趋势;能效以每瓦性能表示。如果空闲功率,即 0% 活动水平时的功率,只有图 6.50 假定值的一半,会怎样?如果空闲功率为零呢?
| 负载 | 性能 | 功率(W) | SPEC 权重 | 加权性能 | 加权功率(W) | 图 6.3 的权重(原表头) | 加权性能 | 加权功率(W) |
|---|---|---|---|---|---|---|---|---|
| 100% | 2,889,020 | 662 | 9.09% | 262,638 | 60 | 0.80% | 22,206 | 5 |
| 90% | 2,611,130 | 617 | 9.09% | 237,375 | 56 | 1.20% | 31,756 | 8 |
| 80% | 2,319,900 | 576 | 9.09% | 210,900 | 52 | 1.50% | 35,889 | 9 |
| 70% | 2,031,260 | 533 | 9.09% | 184,660 | 48 | 2.10% | 42,491 | 11 |
| 60% | 1,740,980 | 490 | 9.09% | 158,271 | 45 | 5.10% | 88,082 | 25 |
| 50% | 1,448,810 | 451 | 9.09% | 131,710 | 41 | 11.50% | 166,335 | 52 |
| 40% | 1,159,760 | 416 | 9.09% | 105,433 | 38 | 19.10% | 221,165 | 79 |
| 30% | 869,077 | 382 | 9.09% | 79,007 | 35 | 24.60% | 213,929 | 94 |
| 20% | 581,126 | 351 | 9.09% | 52,830 | 32 | 15.30% | 88,769 | 54 |
| 10% | 290,762 | 308 | 9.09% | 26,433 | 28 | 8.00% | 23,198 | 25 |
| 0% | 0 | 181 | 9.09% | 0 | 16 | 10.90% | 0 | 20 |
| 合计 | 15,941,825 | 4967 | 1,449,257 | 452 | 933,820 | 380 | ||
| ssj_ops/W | 3210 | ssj_ops/W | 2454 |
译注: 原表第七列表头写“Figure 6.3 weightings”,但图注说明权重来自图 6.48;这里同时保留表头与图注,并标出差异。加权结果也按原表保留,不用已舍入的权重重新覆盖原值。
b. [10] 绘制能效随活动水平变化的趋势,但功率变化采用图 6.50 第三列的数据。再假设仅空闲功率降至图 6.50 数值的一半,绘制能效曲线。将这些曲线与上一问的线性模型比较。对只关注空闲功率的做法,你能得出什么结论?
c. [15] 假设系统利用率组合如图 6.50 第七列。为简化起见,在 1000 台服务器中采用离散分布:109 台利用率为 0%,80 台为 10%,以此类推。使用 (a) 和 (b) 的假设,分别计算该负载组合的总性能与总能耗。
d. [20] 可以设计一种系统,在 0%–50% 负载区间中,功率与负载呈次线性关系。其能效曲线会在较低利用率时达到峰值,代价是在较高利用率时表现较差。重新设计图 6.50 第三列,使其展现这种能效曲线。假设利用率组合如图 6.50 第七列;为简化起见,在 1000 台服务器中采用离散分布,109 台利用率为 0%,80 台为 10%,以此类推。计算该负载组合的总性能与总能耗。
习题 6.30
[15/20/20]〈6.7〉 本题说明能耗与工作量比例模型,同服务器整合、高能效服务器设计等优化之间的交互。考虑图 6.51 和图 6.52 的场景。
a. [15] 考虑图 6.51 中两种服务器的功率分布:方案 A 是图 6.50 的服务器,方案 B 的能耗与工作量比例关系较差,但能效比 A 更高。采用图 6.50 第七列的利用率组合。为简化起见,在 1000 台服务器中采用离散分布:109 台利用率为 0%,80 台为 10%,以此类推,如图 6.52 第一行。性能变化采用图 6.50 第二列。比较两类服务器在该负载组合下的总性能与总能耗。
| 活动水平(%) | 0 | 10 | 20 | 30 | 40 | 50 | 60 | 70 | 80 | 90 | 100 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 方案 A 功率(W) | 181 | 308 | 351 | 382 | 416 | 451 | 490 | 533 | 576 | 617 | 662 |
| 方案 B 功率(W) | 250 | 275 | 325 | 340 | 395 | 405 | 415 | 425 | 440 | 445 | 450 |
b. [20] 考虑一个包含 1000 台服务器的集群,数据与图 6.50 类似,并汇总在图 6.51 和图 6.52 的第一行。在这些假设下,该负载组合的总性能与总能耗是多少?现在假设能够整合负载,得到方案 C 的分布,即图 6.52 第二行。此时总性能与总能耗是多少?与一个空闲功率为 0 W、峰值功率为 662 W、采用线性能耗与工作量比例模型的系统相比,总能耗如何?
c. [20] 使用服务器 B 的功率模型重复 (b),并与 (a) 的结果比较。
习题 6.31
[10/讨论]〈6.7〉系统级能耗与工作量比例关系的趋势。 考虑服务器功耗的以下两种分解:
- CPU 50%;内存 23%;磁盘 11%;网络/其他 16%。
- CPU 33%;内存 30%;磁盘 10%;网络/其他 27%。
a. [10] 假设 CPU 功率动态范围为 3.0 倍,即 CPU 空闲功耗为峰值的三分之一。内存、磁盘、网络/其他类别的动态范围分别为 2.0、1.3、1.2 倍。两种情况下整个系统的总动态范围分别是多少?
b. [讨论] 从 (a) 的结果中可以学到什么?如何在系统级改善能耗与工作量的比例关系?提示:系统级目标不能只靠 CPU 优化实现,而需要改善全部部件。
习题 6.32
[30]〈6.7〉 Pitt Turner IV 等(2008)对数据中心 Tier 等级分类作了很好的概述。Tier 等级定义场地基础设施的性能。为简化起见,只考虑图 6.53 中的关键差异,改编自 Pitt Turner IV 等(2008)。以案例研究中的 TCO 模型为框架,比较所列不同等级的成本影响。
习题 6.33
[讨论]〈6.7〉 根据图 6.36 与图 6.32,定性讨论停机造成的收入损失,与维持正常运行所需成本之间的权衡。
| 活动水平(%) | 0 | 10 | 20 | 30 | 40 | 50 | 60 | 70 | 80 | 90 | 100 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 方案 A、B 的服务器数 | 109 | 80 | 153 | 246 | 191 | 115 | 51 | 21 | 15 | 12 | 8 |
| 方案 C 的服务器数 | 504 | 6 | 8 | 11 | 26 | 57 | 95 | 123 | 76 | 40 | 54 |
| 等级 | 基础设施特征 | 可用性 |
|---|---|---|
| Tier 1 | 供电与冷却均为单一路径,无冗余部件 | 99.0% |
| Tier 2 | 冗余:两条供电与冷却分配路径 | 99.7% |
| Tier 3 | 冗余:三条供电与冷却分配路径,即使维护时也保持运行 | 99.98% |
| Tier 4 | 两条同时工作的供电与冷却分配路径,每条路径中均有冗余部件,可容忍任一单设备失效而不影响负载 | 99.995% |
习题 6.34
[15/讨论]〈6.6〉 最近一些研究定义了 TPUE,意为“真实 PUE”(true PUE)或“总体 PUE”(total PUE),定义为 。6.6 节将 PUE 定义为设施总功率与 IT 设备总功率之比。SPUE,即服务器 PUE,是一个类似 PUE、但用于计算设备的新指标,定义为服务器总输入功率与有效功率之比。有效功率指直接参与计算的电子部件所消耗的功率,包括主板、磁盘、CPU、DRAM、I/O 卡等。换言之,SPUE 衡量服务器内部电源、电压调节器和风扇带来的低效。
a. [15] 考虑提高计算机房空调(CRAC)送风温度的设计。CRAC 效率近似是温度的二次函数,因此这种设计能改善总体 PUE,假设改善 7%,基准 PUE 为 1.7。然而,服务器处温度提高,触发板载风扇控制器让风扇以更高速度运行。风扇功率是转速的三次函数,因此转速提高使 SPUE 恶化。假设采用如下风扇功率模型:其中 为归一化风扇转速,等于以 rpm 表示的风扇转速除以 18,000,基准服务器功率为 350 W。计算风扇转速(1)从 10,000 提高到 12,500 rpm,(2)从 10,000 提高到 18,000 rpm 时的 SPUE。比较两种情况下的 PUE 与 TPUE。为简化起见,在 SPUE 模型中忽略供电损耗。
译注: 原页“Assume a fan power model:”之后直接接“where ns…”,没有给出风扇功率模型公式。归一化转速定义和 350 W 参数确实存在。
b. [讨论] (a) 说明,PUE 虽然能很好地衡量设施开销,却不反映 IT 设备自身的低效。你能否指出另一种设计,其 TPUE 改善可能小于传统 PUE 的改善?提示:参见习题 6.26。
习题 6.35
[讨论/30/讨论]〈6.7〉 两个基准测试为评估服务器能效提供了良好起点:SPECpower_ssj2008 基准测试,见 SPECpower_ssj2008,以及 JouleSort 指标,见 Sort Benchmark。
a. [讨论] 查阅两种基准测试的说明。它们有哪些相似和不同之处?为了更好地服务于提高 WSC 能效的目标,你会如何改进它们?
b. [30] JouleSort 测量执行一次外部排序的系统总能耗,并试图建立一个能够比较嵌入式设备到超级计算机的指标。到 Sort Benchmark 查阅 JouleSort 说明。下载公开可用的排序算法实现,在笔记本、PC、手机等不同类别机器上,或者在不同配置下运行。从这些设置的 JouleSort 评分中,可以学到什么?
c. [讨论] 考虑上述实验中 JouleSort 评分最好的系统。你会如何改善能效?例如,尝试重写排序代码来提高评分。在云中运行排序,会怎样影响能效?
习题 6.36
[10/10/15/讨论]〈6.1,6.4〉 图 6.1 列出了服务器阵列中的中断事件。面对 WSC 的庞大规模,必须平衡集群设计与软件体系结构,以合理成本达到所需正常运行时间。本题考察仅靠硬件实现可用性的影响。
a. [10] 假设运营商希望只通过改进服务器硬件达到 95% 可用性,每类事件的次数需要减少多少?暂时假设单台服务器崩溃完全由冗余机器处理。
b. [10] 如果单台服务器崩溃只有 50% 的情况由冗余处理,(a) 的答案如何变化?如果只有 20% 呢?如果完全不由冗余处理呢?
c. [15] 讨论软件冗余对实现高可用性的重要性。如果 WSC 运营商考虑购买更便宜、但可靠性低 10% 的机器,会对软件体系结构有什么影响?软件冗余有哪些相关挑战?
d. [讨论] 讨论最终一致性对仓库级计算机扩展能力的重要性。
习题 6.37
[15]〈6.1,6.9〉 查阅普通 DDR4 DRAM 与支持纠错码(ECC)的 DDR4 DRAM 当前价格。为了获得 ECC 提供的更高可靠性,每位价格增加多少?仅使用 DRAM 价格与 6.9 节的数据,比较采用非 ECC 和 ECC DRAM 的 WSC,每美元可获得多少正常运行时间。
习题 6.38
[5/讨论/讨论]〈6.1,6.9〉WSC 的可靠性与可管理性问题。
a. [5] 考虑一个服务器集群,每台成本为 $2000。假设年失效率为 5%,每次维修平均需要 1 小时,更换部件每次花费系统成本的 10%。若维修技术人员每小时费用为 $100,每台服务器每年的维护成本是多少?
b. [讨论] 比较这一管理模型与传统企业数据中心模型的差异。后者有大量中小型应用,每个应用运行在自己的专用硬件基础设施上。
c. [讨论] 讨论仓库级计算机采用异构机器的权衡。
习题 6.39
[5/5/10/讨论]〈6.1,6.7〉 假设你创建了一项 Web 服务,99% 的时间运行良好,在 100 ms 内响应;1% 的时间出现性能问题,例如 CPU 进入低功耗状态,导致响应耗时 1000 ms。
a. [5] 服务越来越受欢迎,现在有 100 台服务器,而且处理用户请求的计算必须访问全部服务器。在这 100 台服务器上,一次查询出现慢响应的概率是多少?
b. [5] 要让集群延迟 SLA 仅有不超过 10% 的时间出现不良延迟,单服务器延迟 SLA 需要从“两个 9”(99%)提高到几个 9?
c. [10] 如果有 2000 台服务器,(a) 与 (b) 的答案如何变化?
d. [讨论] 6.7 节(原书所引第 531 页)讨论了能够容忍尾部延迟的设计。你的 Web 服务需要进行哪些设计优化?提示:参阅 Dean 和 Barroso(2013)的论文 The Tail at Scale。
习题 6.40
[讨论/讨论/5/5/5]〈6.3,6.2〉 现代虚拟化平台与 hypervisor 支持在线迁移,即在物理宿主机之间移动整个 VM。在线迁移为云提供商与客户带来许多收益,包括无中断系统维护,以及更有效地把负载安排到物理宿主机、改善 TCO。假设有机器 A、B,各有 12 个核心和 256 GB DRAM。最初,A 运行两个 VM:VM0 使用 6 个核心和 24 GB DRAM;VM1 使用 4 个核心和 48 GB DRAM。B 运行 VM2,使用 4 个核心和 128 GB DRAM。现在用户关闭 VM1。根据此前对该客户 VM 的经验,预计 VM0、VM2 在可预见的将来会持续运行。假设有一个简单 VM 迁移系统:(1)暂停 VM;(2)经网络传输 CPU/内存状态;(3)恢复 VM。假设迁移时间主要由内存内容的传输决定。
a. [讨论] 迁移 VM 时,除 CPU/内存状态外,还必须考虑哪些资源?如果目标是尽量缩短迁移时间,你预计应该如何管理这些资源?
b. [讨论] 假设要把 VM0 与 VM2 整合到同一物理宿主机。可以考察哪些指标,决定迁移哪一个 VM?
c. [5] 使用上述简单迁移系统,假设向 VM 客户承诺了“六个 9”的正常运行时间。如果每天最多迁移一次 VM,而且这是唯一可能导致停机的因素,迁移过程最多可以耗时多久?
d. [5] 假设系统决定把 VM2 迁到机器 A。仍假设每天迁移一次,A、B 之间至少需要多少带宽,才能在不违反正常运行时间保证的前提下完成迁移?
e. [5] 如果网络带宽为 200 Gb/s,在不违反“五个 9”的正常运行时间保证的情况下,每天最多可以迁移 VM0 多少次?
习题 6.41
[讨论]〈6.3,6.2〉 除进程隔离、虚拟机、物理隔离等机制外,容器化也是一种常用隔离机制。
a. [讨论] 查阅常用容器管理工具。隔离是否被宣传为它们的主要用途?
b. [讨论] 比较容器化与上述其他隔离机制的异同,从性能开销、隔离能力、硬件要求等多个方面讨论。
c. [讨论] 哪些类型的 WSC 运营商可能依赖各种隔离方式?为每种隔离技术给出一个 WSC 应用实例。
d. [讨论] 隔离机制从来都不是完美的。查找并解释这些机制在生产系统中被突破的若干实例。
习题 6.42
[30/10]〈6.5〉 今天的 WSC 提供大量成本/性能特征不同的 I/O 机制与加速器。云用户也能选择这些不同资源,价格公布在云提供商网站上。
a. [30] 绘制不同云提供商提供下列资源的每小时、每 GB、每 Gb/s 等成本。尝试比较不同类型实例,分离出每种资源的成本。
- i. 网络:不同带宽。
- ii. DRAM:不同容量与标准。
- iii. NVMe Flash:不同 IOPS、带宽。
- iv. 磁盘:不同 IOPS、带宽。
- v. GPU:不同 OPs/s。
- vi. FPGA。
- vii. ML 加速器:不同 OPs/s。
b. [10] 收集类似设备的零售价格。如果云提供商按这些价格购买设备,需要出租多久才能收回成本?
习题 6.43
[讨论/5/5/5/讨论]〈6.8〉 FPGA 可以在数小时内,而非数月或数年,部署新的专用硬件设计;但与 ASIC 相比,功耗与性能需要付出代价。本题考察在 FPGA 与 ASIC 上部署专用硬件的权衡。假设你是云运营商,可以购买以下一种加速器部署到服务器群:(1)FlexAcc,基于 FPGA,可快速修改与重新编程,始终保持相对 32 核 CPU 软件实现的 16 倍加速;(2)FastAcc,基于 ASIC,无法修改,但速度为 32 核 CPU 软件实现的 1024 倍,功耗为 FlexAcc 的八分之一、CPU 的三十二分之一。假设 FlexAcc 与 FastAcc 的购置价格相同。
a. [讨论] 哪些应用领域或程序库可能更适合 FlexAcc 这种形式?哪些更适合 FastAcc?
b. [5] 假设每次软件发布新版本,FastAcc 的有效性能减半,功耗不变。经过多少次软件发布后,FlexAcc 与 FastAcc 的瞬时每瓦性能相同?
c. [5] 假设一颗 32 核 CPU 成本为 $2048,电价为 $0.125/kWh。CPU 与 FastAcc 都部署两年,期间没有新软件版本。要与 CPU 的成本持平,FastAcc 最高购置价格是多少?
d. [5] 对 FlexAcc 重复 (c)。
e. [讨论] (a)–(d) 隐含假定 ASIC 加速器完全无法随软件演进,但实际并非如此。有哪些可编程 ASIC 的例子?它们如何保持灵活性?
习题 6.44
[讨论/讨论/240/5/5/5]〈6.8〉复现面向 WSC 的开源定制芯片。 Karandikar 等发布了一个开源 Protocol Buffers 硬件加速器设计。Protocol Buffers 是一种序列化框架,常用于仓库级计算机中的服务间通信与持久化存储。
a. [讨论] 设计这一加速器的动机是什么?查找一些参考资料,讨论不同云提供商、不同时间点上,序列化/反序列化占用的 CPU 比例。
b. [讨论] 这种加速器应如何集成到系统中,例如靠近核心、经 CXL 或 PCIe 接入?从性能和集成成本两个角度讨论权衡。
c. [240] 按 Karandikar 等论文的 artifact 附录,在 Protocol Buffers 加速器的开源实现上,运行源自 Google 服务器群的 Protocol Buffers 基准测试。需要能够访问 AWS。
d. [5] 该论文不仅提出新的 WSC 硬件,还利用 WSC 专门化完成评估:通过云 FPGA 与 FireSim 实现快速硬件模拟。比较按需付费使用所需 FPGA(EC2 F1),与直接购买一块 FPGA(Xilinx Alveo U250)的成本。
e. [5] 如果购买 FPGA,需要运行多少次基准测试才能收回成本?若再计入承载 FPGA 的服务器成本呢?
f. [5] 重做前面的计算,假设购买足够多的 FPGA,即八块,以匹配 artifact 所设置的、在云端多块 FPGA 上运行的并行度。