7.1 引言
Gordon Moore 不仅在 1965 年预言了每芯片晶体管数量惊人的增长;本章开篇的引语还表明,他也预见了约 50 年后这种增长将接近停滞。第 1 章图 1.24 提供了一个例证:就连他创办的公司——几十年来一直以 Moore 定律指导资本投入并引以为豪的公司——也在放缓新半导体工艺的开发速度。
在半导体高速发展的年代,体系结构设计者借助 Moore 定律,不断创造新的机制,把日益充裕的晶体管资源转化为更高的性能。20 世纪 80 年代,一个五级流水线、32 位的 RISC 处理器,最少只需约 25,000 个晶体管;此后,可用资源增加到了当时的 1,000,000 倍,从而支持了前面各章介绍的种种功能,让通用处理器上的通用程序运行得更快:
- 一级、二级、三级乃至四级缓存;
- 512 位 SIMD 浮点运算单元;
- 15 级以上的流水线;
- 分支预测;
- 乱序执行;
- 推测性预取;
- 多线程;
- 每插槽包含数百个处理器的多处理器系统。
这些复杂的体系结构,面向的是以 C、C++ 等高效语言编写、规模达到数百万行的程序。设计者把这些程序视为黑盒,通常既不了解程序内部的结构,甚至也不了解程序究竟要完成什么任务。SPEC2017 中的基准程序,就只是用来测量性能和加速执行的对象。自 20 世纪 80 年代的 RISC 革命以来,处于软硬件交界处的一直是编译器开发者;然而,他们对应用的高层行为也只有有限的了解。这正是编译器甚至无法跨越 C、C++ 与 GPU 体系结构之间语义鸿沟的原因。
如第 1 章所述,Dennard 缩放规律早于 Moore 定律走到了尽头。因此,如今更多晶体管发生开关动作,就意味着更高的功耗。能耗预算没有增加,而我们已经用多个高效核心取代了单个低效处理器。因此,对于通用体系结构,已经没有其他重大的体系结构创新,能够继续大幅提高性价比和能效。由于电迁移以及芯片的机械、热约束等因素,能耗预算受到限制;要获得更高的性能,即每秒执行更多次运算,就必须降低每次运算的能量消耗。
图 7.1 从另一个角度展示了第 1 章提到的存储访问与逻辑运算的相对能量代价,这一次把它们表示为执行一条算术指令所需的开销。
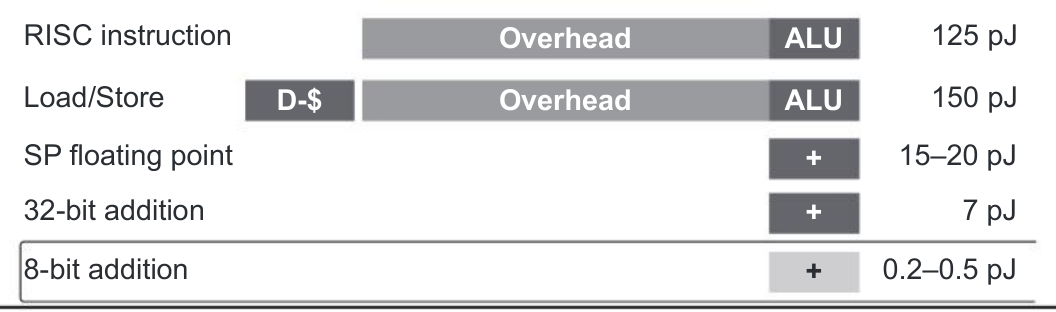
图中 RISC instruction 表示 RISC 指令,总能量为 125 pJ;Load/Store 表示加载/存储,总能量为 150 pJ;Overhead 为附加开销,D-$ 为数据缓存,ALU 为算术逻辑单元。单精度浮点运算(SP floating point)需要 15–20 pJ,32 位加法需要 7 pJ,8 位加法需要 0.2–0.5 pJ。
考虑到这些开销,对现有核心做些小幅调整,也许只能带来 5%–10% 的改进。如果希望在保留可编程性的同时获得大幅提升,就需要把每条指令执行的算术运算数量,从一次提高到数百次。要达到这样的效率,计算机体系结构必须发生根本变化:从通用核心转向领域专用体系结构(domain-specific architectures,DSA)。
因此,正如 21 世纪初从单处理器转向多处理器是形势所迫一样,如今设计者投入 DSA,也是因为传统道路已难以为继。新的常态是:一台计算机既包含运行操作系统等传统大型程序的标准处理器,也包含领域专用处理器。后者只完成很窄的一类任务,却能把它们做得极好。这样的计算机,将比过去同构的多核芯片具有更强的异构性。事实上,智能手机 SOC 已经采用了异构设计,用加速器提高信号处理、图形生成、图像转换等任务的能效。
这一论点的部分依据是:过去几十年中,那些借 Moore 定律发展起来的体系结构创新,例如缓存、乱序执行等,并不一定适合某些领域,尤其不一定有利于节能。它们占用的资源可以重新分配,让芯片更适合目标领域。例如,缓存非常适合通用体系结构,却未必适合 DSA。对存储访问模式容易预测的应用,或者视频这类数据规模巨大、复用却很少的应用,多级缓存往往配置过度:缓存囤积了可能不会再次使用的数据,白白消耗面积和能量。因此,DSA 有望同时提高硅资源的利用效率和能效,而后者通常是今天更重要的属性。
设计者大概不会为 SPEC2017 基准测试中的编译器这类大型 C++ 程序创建 DSA。领域专用算法几乎总是大型系统中规模较小、计算密集的核心部分,例如物体识别或语音理解。DSA 应当针对这部分计算,而不应打算运行整个程序。此外,修改基准测试代码不再意味着违反规则;对于 DSA 来说,这完全可以是合理的加速来源,部分原因正是待加速的代码规模较小。因此,想在 DSA 上作出有价值贡献的设计者,必须走出原有视野,学习应用领域及其算法。
除了拓宽专业知识,领域专用体系结构设计者还面临另一个挑战:找到需求规模足够大的目标领域,使得在 SOC 上分配专用硅面积、乃至单独定制一颗芯片值得投入。定制芯片及其配套软件的非重复性工程费用(NRE),要由制造的芯片数量分摊。因此,如果只需要 10,000 颗芯片,这种方案通常难以在经济上成立(见第 1 章图 1.17)。
服务较小规模应用的一种办法,是使用现场可编程门阵列(Field Programmable Gate Array,FPGA)等可重配置芯片。它们的 NRE 低于定制芯片,而且多个不同应用可能复用同一套可重配置硬件,分摊其成本。不过,这类硬件的效率远低于定制芯片,所以 FPGA 带来的收益也较为有限。
DSA 的另一项挑战是软件移植。C++ 语言及其编译器这类熟悉的编程环境,很少是使用 DSA 的合适途径。
本章接下来先给出 DSA 设计的五条指导原则,再介绍作为示例领域的深度神经网络(DNN)。我们选择 DNN,是因为在过去十年里,它们正在改变计算领域的许多方面。与某些硬件所针对的任务不同,DNN 适用于广泛的问题,因此,一种面向 DNN 的体系结构可以复用于语音、视觉、语言、翻译、搜索排序等许多领域。
随后,我们介绍六种 DSA:五种用于数据中心、加速 DNN 的定制芯片,以及一种用于个人移动设备(PMD)、加速 DNN 的 DSA。接着用 DNN 基准测试考察这些 DSA 的性价比,最后讨论计算机体系结构领域正在发生的复兴。