7.3 示例领域:深度神经网络
人工智能(AI)不仅是计算领域的下一波浪潮,也是人类历史上的下一个重大转折点……这场智能革命将由数据、神经网络和算力驱动。Intel 致力于发展 AI,因此……我们已经引入了一系列先进手段,以推动 AI 的发展与广泛应用。
——Brian Krzanich,Intel CEO,2016 年
自世纪之交以来,人工智能(AI)强势回归。研究重心不再是用一大套逻辑规则来构建智能,而是转向从样本数据中进行机器学习(machine learning,ML),以此实现人工智能。事实表明,编程让计算机具有智能,比编程让计算机学会如何变得智能更难。不过,学习所需的数据量也远远超出了最初的估计。本世纪的仓库级计算机(WSC)从互联网上数十亿用户及其智能手机中收集并存储 PB 级信息,提供了充足的数据。
我们同样低估了从海量数据中学习所需的计算量。不过,WSC 的数千台服务器中配备了 GPU;它们具有出色的单精度浮点性价比,提供了所需的算力。
机器学习中的深度神经网络(DNN),是过去十年 AI 和 ML 领域最引人注目的方向。DNN 带来的突破包括:在语言翻译方面,一次跨越所取得的进展,超过了此前十年的全部积累(Tung, 2016;Lewis-Kraus, 2016);在图像识别竞赛中,采用 DNN 后,错误率仅用五年就从 26% 降到了 3.5%(Krizhevsky et al., 2012;Szegedy et al., 2015;He et al., 2016);2016 年,DNN 使计算机程序首次战胜了人类围棋冠军(Silver et al., 2016)。2022 年,一个 DNN 根据一维氨基酸序列,预测了全部 2 亿种已知蛋白质的三维结构,解决了困扰生物学家数十年的问题。《Science》杂志把这一成果评为年度最大突破(Jumper et al., 2021),相关研究者又在 2024 年获得了诺贝尔奖。几乎每个月都会出现重要的 DNN 新成果,因此有人把这个时代称为“深度学习的黄金十年”(Dean, 2022)。这些应用虽然许多运行在云端,但也推动了第 1 章所述的智能手机 Google Translate 等应用。
希望在本节之外进一步学习 DNN 的读者,可以下载并动手尝试 JAX 和 PyTorch 教程;如果暂时不打算动手,也可以阅读免费的在线 DNN 教材(Nielsen, 2016)。Google 的 ML/AI 速成课程也很出色!
DNN 中的神经元
DNN 的灵感来自大脑中的神经元。神经网络使用的人工神经元,计算过程其实很简单:把一组权重或参数与相应数据值相乘,求和,再经过一个非线性函数得到输出。后文将看到,每个人工神经元都有很大的扇入和扇出。对图像处理 DNN,输入数据就是照片的像素,像素值分别与权重相乘。人们尝试过许多非线性函数,目前常用的一种却非常简单:
当 为负数时返回 0,为正数或零时返回原值。这个简单函数有一个较长的名字:整流线性单元(rectified linear unit,ReLU)。非线性函数的输出称为激活值(activation),也就是人工神经元被“激活”后得到的输出。
一组人工神经元可以分别处理输入的不同部分;这一组的输出,又成为下一层人工神经元的输入。输入层和输出层之间的层称为隐藏层。在图像处理中,可以把不同层理解为寻找不同层次的特征:从边缘、角等低层特征,逐渐走向眼睛、耳朵等高层特征。如果应用要判断图像中是否有狗,最后一层的输出可以是一个介于 0 和 1 之间的概率,也可以是一组对应不同犬种的概率。
“深度”神经网络的名称,来自网络的层数。早期缺少数据和算力,多数神经网络都比较浅,可能只有两个隐藏层。到 2024 年,一些 DNN 已有数十层,使用数千亿个权重。图 7.4 列出了一些 DNN 的层数、参数数量和训练时间。
| DNN 模型(类型与层数) | 参数数量 | 数据集规模与类型 | 训练平台与时间 |
|---|---|---|---|
| BERT-large:24 层 Transformer 编码器(Devlin et al., 2018) | 340 M | BookCorpus,8 亿个词;英文 Wikipedia,25 亿个词 | 64 个 TPU v2 × 4 天,约 1500 TPU v2 小时 |
| Stable Diffusion v2 Base:带 UNet、交叉注意力和 OpenCLIP-ViT/H 文本编码器的潜在扩散模型(Rombach et al., 2022) | UNet 为 860 M,文本编码器为 123 M | 经过筛选的 LAION-5B,58.5 亿个图文对 | 256 个 A100 GPU × 33 天,约 200,000 A100 小时 |
| Switch-Transformer Base:12 层、采用混合专家的 Transformer 编码器—解码器(Fedus et al., 2022) | 8000 M | Colossal Clean Crawled Corpus,3560 亿个 token | 16 个 TPU v3 × 2.5–3 天,约 70 TPU v3 小时 |
| GPT-3:96 层 Transformer 解码器(Brown et al., 2020) | 175,000 M | Common Crawl:4100 亿个 token;WebText2:190 亿;Books1:120 亿;Books2:550 亿;Wikipedia:30 亿 | 估计为 1024 个 A100 GPU × 34 天,约 840,000 A100 小时 |
表中 M 表示百万。为减少基准测试的工作量,MLPerf Training 3.1 对部分相同规模的模型采用了小得多的数据集。例如,Stable Diffusion v2 使用的图文对只有 4 亿个,而不是图中的约 59 亿个;在 8 个较新的 H100 GPU 上训练不到一小时,总计约 6 H100 小时,而表中的生产训练需要约 200,000 A100 小时。即使基于 H100 的系统性能是基于 A100 系统的 3.3 倍,Stable Diffusion 的生产训练所需时间仍约为 MLPerf 训练的 10,000 倍。1
训练与推理
以上讨论的是已经投入生产使用的 DNN。开发 DNN 时,首先要确定神经网络架构:选择层的数量和类型、每层的维度以及数据宽度。专家可能设计新的网络架构,但多数实践者会从已有的众多设计中选择,例如图 7.4 中那些已经在相似问题上取得良好效果的模型。
选定网络架构后,下一步是学习神经网络图中每条边对应的权重。权重决定模型的行为。根据所选架构不同,一个模型可能包含数千到数千亿个权重。
训练,就是调整这些权重,使 DNN 逼近训练数据所描述的复杂函数,例如从图片映射到图片中的物体;这一过程代价高昂。
开发阶段通常称为训练或学习,生产使用阶段则有多种称呼:推理(inference)、serving、预测(prediction)、评分(scoring)或 implementation。用教育作比喻,训练就像进入大学学习某个专业,serving 则像毕业后运用所学完成工作。
多数 DNN 采用监督学习:它们获得一个训练集,数据经过预处理,带有正确标签。在 ImageNet DNN 竞赛中(Russakovsky et al., 2015),训练集包含 120 万张照片,每张照片都标记为 1000 个类别之一。有些类别划分得相当细,例如特定品种的狗和猫。比赛使用另外一组保密的 50,000 张照片进行评测,错误率最低的 DNN 获胜。
设置权重是一个迭代过程:利用训练集,沿神经网络反向进行计算,这称为反向传播(backpropagation)。例如,训练集中一张图片的犬种已经知道;先查看 DNN 对这张图片给出的结果,再调整权重,使答案更准确。令人惊讶的是,训练开始时,权重应初始化为随机值;随后不断迭代,直到对模型在训练集上达到的准确率感到满意为止。
从数学角度看,学习的目标是:在多层神经网络架构上,找到把输入映射为正确输出的函数。backpropagation 即“误差的反向传播”。它计算所有权重的梯度,交给优化算法;优化算法再通过更新权重来尽量减小误差。DNN 中最常用的优化算法是随机梯度下降。它根据反向传播得到的梯度,按比例调整权重,使下降尽可能快。希望深入了解的读者可参阅 Nielsen(2016)。
训练可能需要数千颗芯片连续计算数周甚至数月。推理阶段处理一个数据样本,往往用时不到 100 ms,所需时间约为训练的一百万分之一。虽然训练远比一次推理耗时,但推理的总计算时间,还要乘上 DNN 的用户数量及其调用频率。
训练完成后,你会部署 DNN,希望训练集能够代表真实世界,也希望它足够受欢迎,让用户使用它花费的总时间,远远超过你开发它所投入的时间!
有些任务没有训练数据集,例如预测现实世界中某个事件的未来走向。这里不展开讨论,但强化学习(reinforcement learning,RL)是处理这类学习问题的一种常用算法。它不是从训练集中学习,而是对现实世界采取行动,再根据行动使情况变好还是变坏,从奖励函数中获得反馈信号。
很难想象还有哪个领域变化得更快。2024 年最常见的四类 DNN 是:多层感知机(MLP)、卷积神经网络(CNN)、循环神经网络(RNN)和 Transformer 模型。它们都是依靠训练集进行监督学习的例子。为了展示模型变化有多快,图 7.5 给出了仅六年间 Google 生产环境 DNN 工作负载的显著变化。
| DNN 模型 | TPU v1,2016 年 7 月,推理 | TPU v3,2019 年 4 月,训练与推理 | TPU v4 lite,2020 年 2 月,推理 | TPU v4,2022 年 10 月,训练 |
|---|---|---|---|---|
| MLP/DLRM | 61% | 27% | 25% | 24% |
| RNN | 29% | 21% | 29% | 2% |
| CNN | 5% | 24% | 18% | 12% |
| Transformer | — | 21% | 28% | 57% |
| 其中:BERT | (28%) | (26%) | ||
| 其中:大语言模型 | (31%) |
介绍 Transformer 的论文发表于 2017 年,两年后,它已占工作负载的 21%。BERT 发表于 2018 年;启发大型 Transformer 模型研究的 GPT-3 论文发表于 2020 年。到 2022 年,这类模型已占 TPU v4 工作负载的近 60%。
多层感知机
MLP 是最早出现的 DNN。每一层都对上一层全部输出的加权和应用一组非线性函数 :
加权求和由输出向量与权重矩阵相乘实现,见图 7.6。这样的层称为全连接层,因为每个输出神经元的结果,都依赖于上一层的所有输入神经元。
对于每一类 DNN,都可以计算每层的神经元数量、运算次数和权重数量。MLP 最简单,因为它只是把输入向量与权重数组作向量—矩阵乘法。以下给出推理所用的参数及计算公式;我们把乘法和加法各计为一次运算:
- :输出向量的维度,即神经元数量;
- :输入向量的维度;
- 权重数量:;
- 运算次数:;
- 每个权重对应的运算次数:2。
最后一项,就是第 4 章 Roofline 模型中讨论的算术强度(operational intensity)。这里使用“每个权重对应的运算次数”,因为权重可能多达数十亿个,通常无法全部放入芯片。例如,某个 MLP 的一层具有 、,则该层有 2048 个神经元、8,388,608 个权重,需要 16,777,216 次运算,算术强度为 2。根据 Roofline 模型,算术强度越低,越难实现高性能。
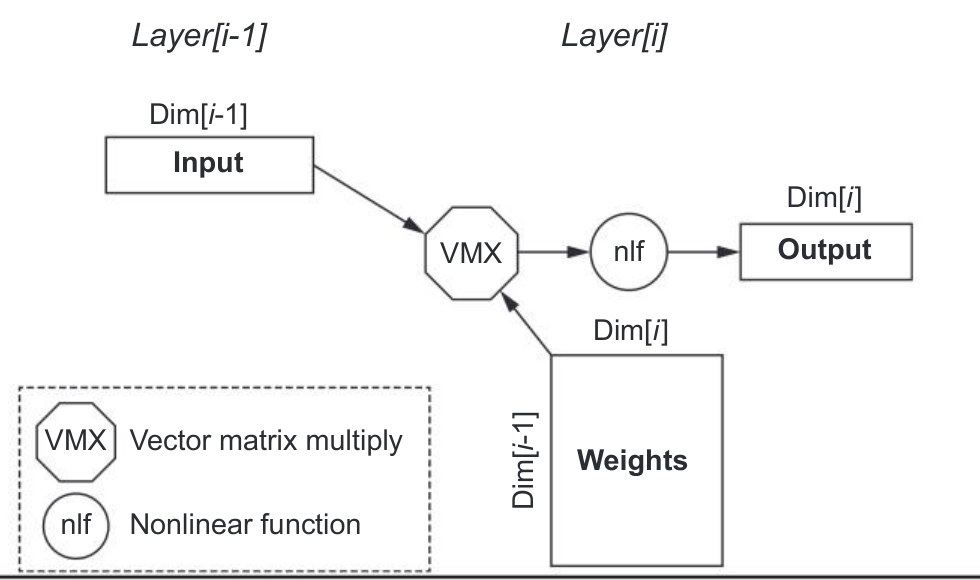
ReLU 是 MLP 常用的非线性函数。输入层与输出层的维度往往不同。这样的层称为全连接层,因为它依赖上一层的全部输入,即使其中许多输入为零。一项研究发现,44% 的输入为零;这可能部分源于 ReLU 会把负数变成零。图中 Input、Weights、Output 分别为输入、权重、输出;VMX 表示向量—矩阵乘法,nlf 表示非线性函数,Dim 为维度。
卷积神经网络
CNN 广泛用于计算机视觉。图像具有二维结构,因此,要寻找图像内部的关系,自然应从相邻像素入手。CNN 使用前一层输出中空间相邻区域经过非线性函数得到的结果作为输入,再乘以权重;同一组权重会被多次复用。
CNN 的基本思想是:每一层都提高对图像的抽象程度。例如,第一层可能只识别水平线和垂直线;第二层把它们组合起来,识别角;下一层可能识别矩形和圆。再下一层就能利用这些输入,检测狗的某些部位,如眼睛或耳朵。更高的层则尝试识别不同犬种的特征。
每个神经网络层都会生成一组二维特征图(feature map);特征图中的每个单元,都试图识别输入中相应区域的某种特征。
图 7.7 展示了起始步骤:对输入图像进行 的 stencil 计算,生成第一张特征图的各个元素。stencil 计算按照固定模式使用相邻单元,更新数组中的全部元素。输出特征图的数量,取决于试图从图像中捕捉多少种特征,以及应用 stencil 时使用的步长。2
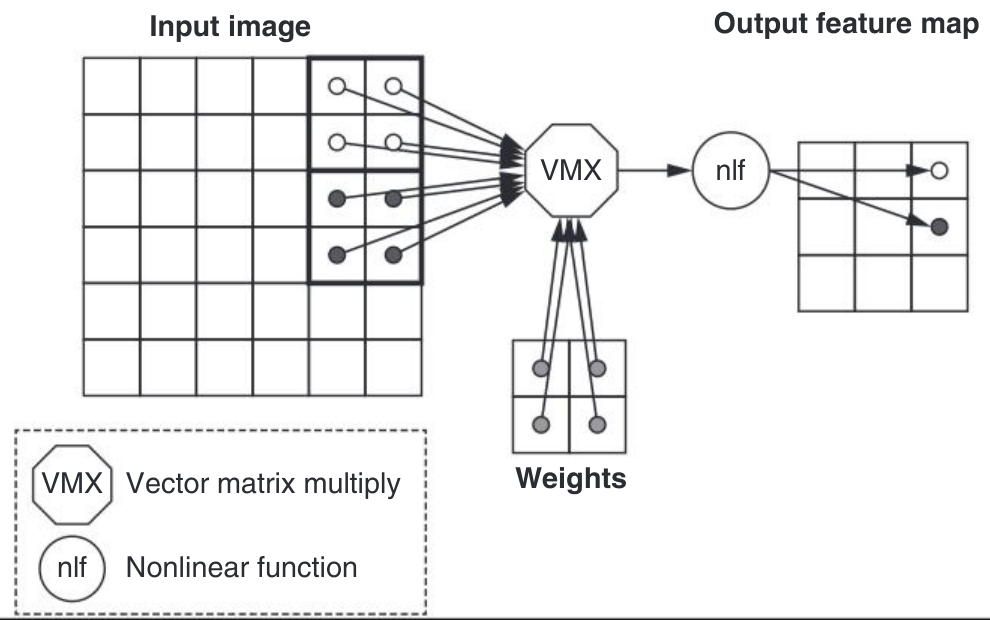
图中,每组四个输入像素都与同样的四个权重相乘,生成输出特征图的单元。所示输入像素组之间的步长为 2,也可以采用其他步长。联系 MLP 来看,每次 卷积,都可以看作一个很小的全连接运算,用来生成输出特征图上的一个点。原图注接着指出,图 7.7 展示了多个特征图如何把这些点扩展为第三个维度上的向量。3 图中 Input image 为输入图像,Output feature map 为输出特征图;Weights、VMX、nlf 的含义与图 7.6 相同。
实际过程更复杂,因为图像通常不是单一、平面的二维层。彩色图像一般有红、绿、蓝三个通道。例如,一个 stencil 要访问 12 个元素:红色通道的 个像素、绿色通道的 个像素,以及蓝色通道的 个像素。在这种情况下,对图像的三个输入通道应用 stencil,每张输出特征图都需要 12 个权重。
图 7.8 给出了第一层之后的一般情形:输入和输出都可以包含任意数量的特征图。计算时,对全部输入特征图应用一个三维 stencil,并配上一组权重,生成一张输出特征图。
从数学角度看,如果输入和输出的特征图数量都为 1、步长也为 1,那么二维 CNN 的单个层,与二维离散卷积进行的是相同计算。
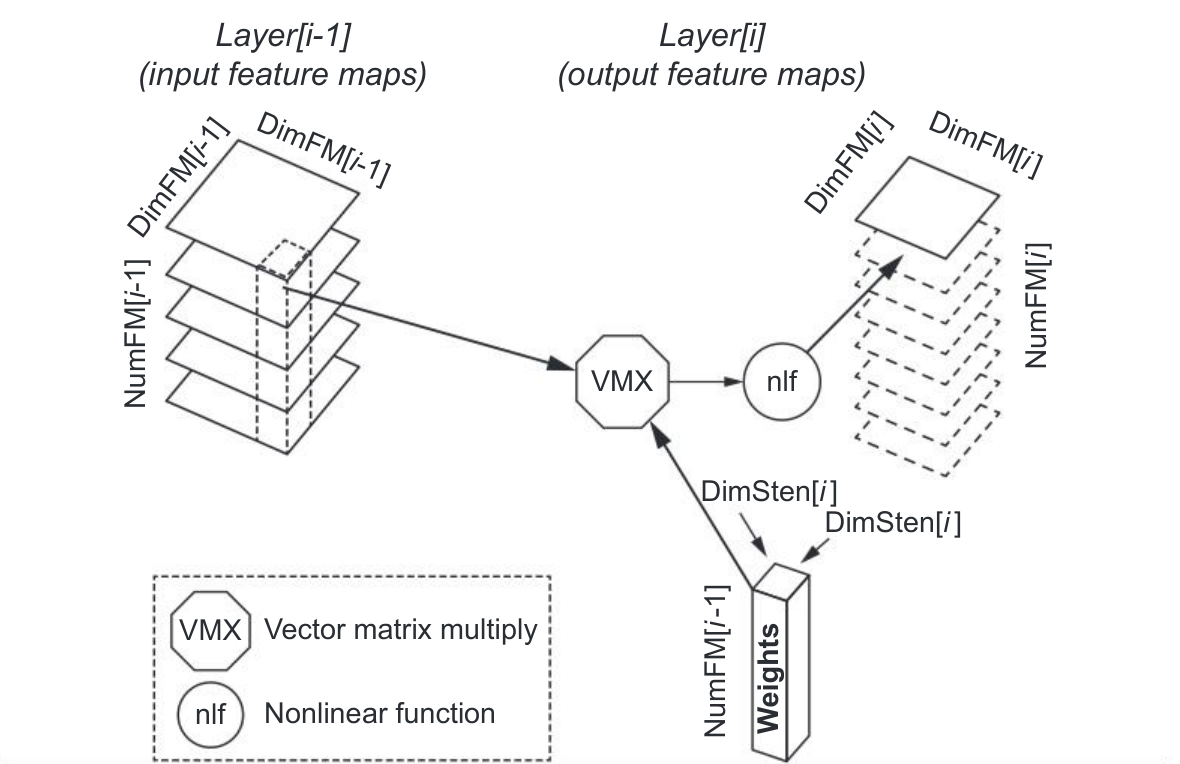
三维 stencil 覆盖输入特征图,用于生成一张输出特征图。每张输出特征图都有自己独有的一组权重,向量—矩阵乘法会针对每张图分别进行。虚线表示之后生成的输出特征图。如图所示,输入和输出特征图的尺寸与数量往往不同。与 MLP 一样,CNN 也常用 ReLU 作为非线性函数。图中 NumFM 表示特征图数量,DimFM 表示特征图的边长,DimSten 表示 stencil 的边长。
从图 7.8 可以看出,CNN 比 MLP 更复杂。以下给出有关参数,以及权重数量、运算次数的计算公式:
- :正方形输入特征图的边长;
- :正方形输出特征图的边长;
- :正方形 stencil 的边长;
- :输入特征图数量;
- :输出特征图数量;
- 神经元数量:;
- 每张输出特征图的权重数量:;
- 每层权重总数:;
- 每张输出特征图的运算次数:。
- 每层总运算次数:
- 每个权重对应的运算次数:。
某个 CNN 的一层可能具有以下参数:、、、(输入特征图数量),以及 (输出特征图数量)。这一层有 25,088 个神经元和 73,728 个权重,需要 28,901,376 次运算,算术强度为 392。这个例子说明,相比 MLP 中的全连接层,CNN 层通常具有更少的权重和更高的算术强度。
循环神经网络
第三类 DNN 是 RNN,它曾广泛用于语音识别和语言翻译。RNN 在 DNN 模型中加入状态,使其能够记住信息,从而显式建模具有先后顺序的输入。这就像硬件中组合逻辑与状态机的区别。例如,模型可能获知了某个人的性别;在之后翻译词语时,就需要传递并记住这条信息。RNN 的每一层,都会对上一层的输入和前一时刻的状态进行一组加权求和。不同时间步之间会复用权重。
长短期记忆(long short-term memory,LSTM)模型是一种 RNN,它缓解了早期 RNN 无法记住重要长期信息的问题。LSTM 曾一度非常流行,但如今已在很大程度上被 Transformer 取代。
Transformer 神经网络
Transformer 模型大约与本书上一版同时问世,如今已经成为极其流行且重要的一类 DNN。Transformer 依靠自注意力(self-attention),对输入数据中的不同部分赋予不同权重。它与 RNN 一样,常用于自然语言翻译和文本摘要;但与 RNN 顺序处理输入不同,它会一次性处理整个输入。因此,各项运算可以并行进行,处理输入的速度也更快,使 Transformer 能够处理规模大得多的数据集。
Transformer 依靠注意力机制,为输入序列中的各个位置提供上下文。注意力层在输入序列的任意位置,都可以访问此前的全部状态。介绍 Transformer 的论文,标题正是《Attention Is All You Need》(Vaswani,2017)。图 7.9 和图 7.10 展示了 Transformer 模型的体系结构。
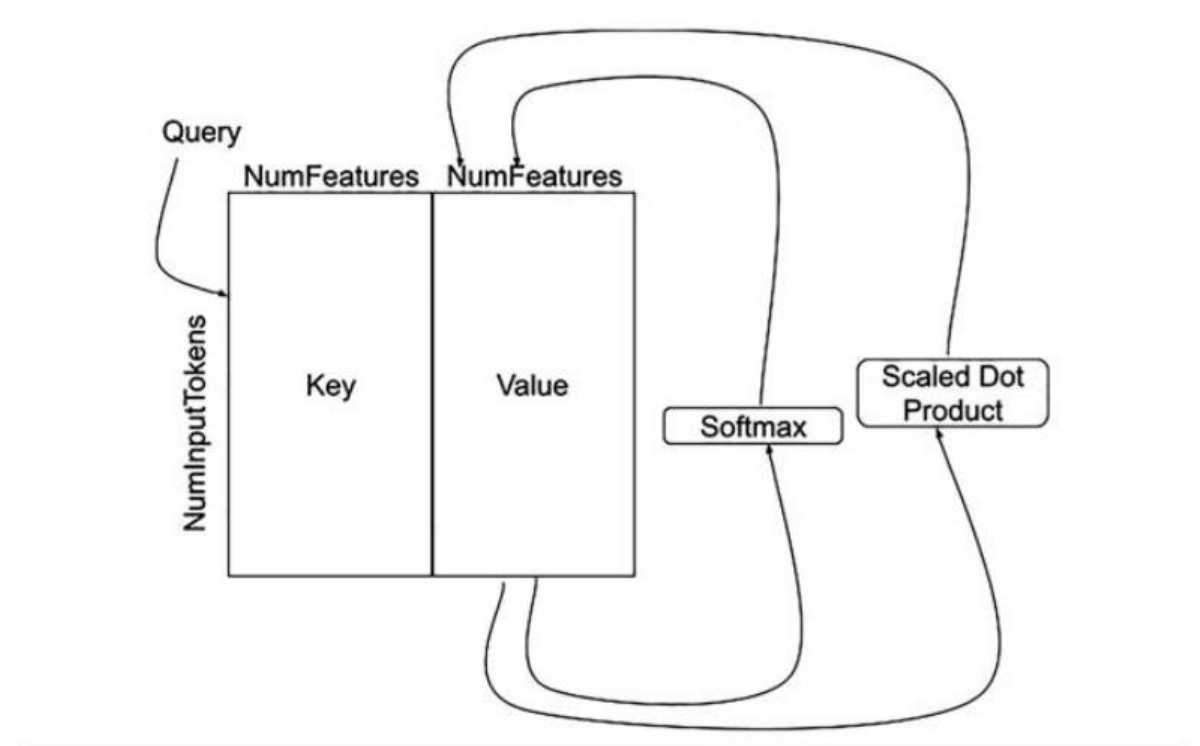
注意力机制基于一张键值表。键和对应值的宽度为特征数量,长度为输入 token 数量。注意力计算会多次遍历这张表。Softmax 把 DNN 的输出归一化为预测输出类别的概率分布。原图注称,它把输入映射为 −1 至 +1 之间、总和为 1 的值。4 缩放点积会增强输入中的某些部分,同时削弱其他部分,例如调整长期因素相对于短期因素的影响。图中 Query、Key、Value 分别为查询、键、值,NumFeatures 为特征数量,NumInputTokens 为输入 token 数量,Scaled Dot Product 为缩放点积。
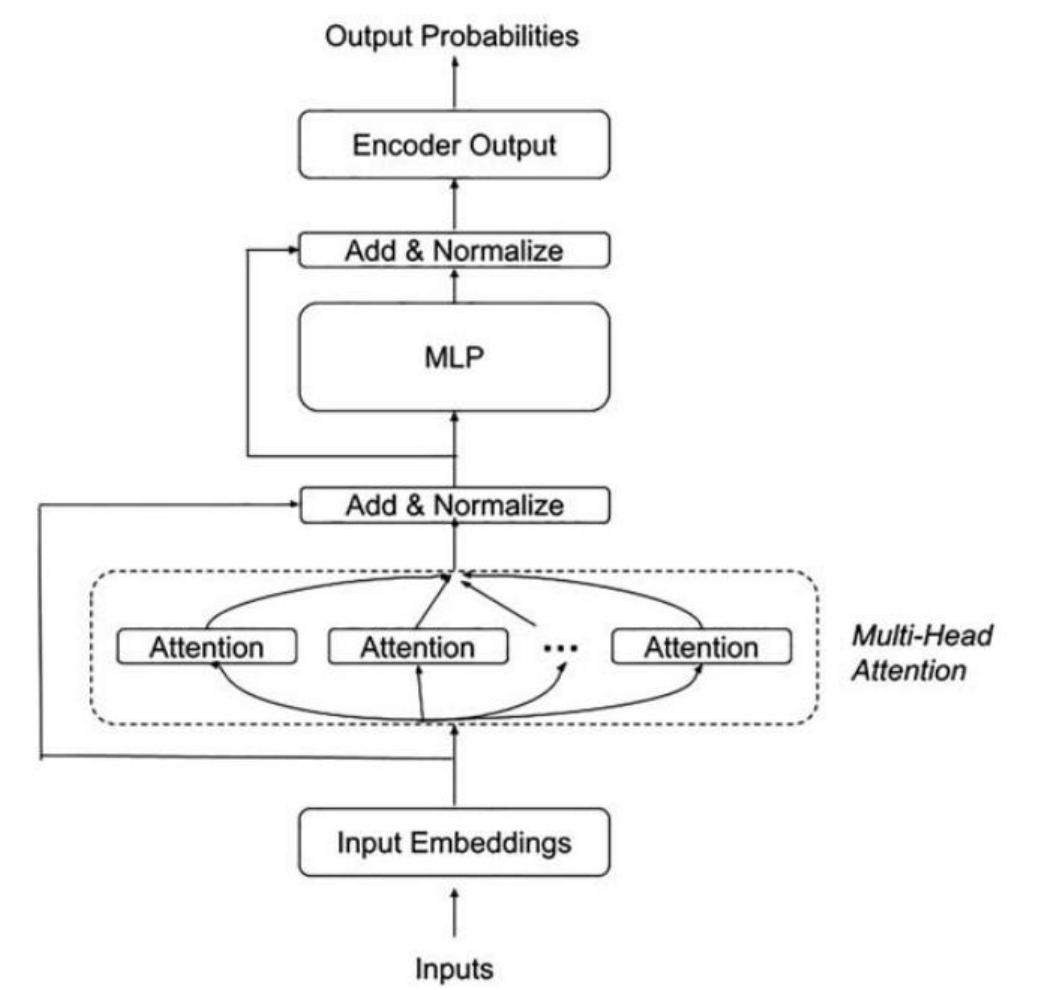
多头注意力(Multihead Attention)并行运行多份图 7.9 中的注意力机制,把得到的输出拼接起来,再变换为预期维度,随后送入 MLP。图中 Inputs 为输入,Input Embeddings 为输入嵌入,Add & Normalize 为相加与归一化,Encoder Output 为编码器输出,Output Probabilities 为输出概率。
一种流行的 Transformer 变体是 BERT(Bidirectional Encoder Representations from Transformers),它在原始 Transformer 的基础上进行了改进,提供两种模型,使用 BookCorpus 和英文 Wikipedia 进行面向自然语言处理的预训练(Devlin 等,2018)。另一种流行模型是 GPT-3(Generative Pretrained Transformer 3),它通过预测下一个 token 来训练,这称为生成式预训练。GPT-3 以规模庞大著称,拥有 1750 亿个参数,而其前身 GPT-2 有 15 亿个参数。GPT-3 催生了一类统称为大语言模型(large language model,LLM)或 Frontier Models 的模型。自 2021 年起,探索 LLM 的潜力就受到机器学习界——包括产业界——的高度关注。如今,在自然语言处理领域,Transformer 已在很大程度上取代 RNN(见图 7.5)。
批处理
DNN 可能拥有大量权重。一种性能优化方法是:从存储器取出权重之后,让一组输入复用这些权重,从而提高有效算术强度。例如,一个图像处理 DNN 可以一次处理 32 张图像,使读取权重的有效开销降至原来的 1/32。这样的输入集合称为批(batch)或小批量(minibatch)。批处理不仅能提高推理性能;要获得良好的训练效果,反向传播也需要使用一批样本,而不是每次只使用一个样本。
对于图 7.6 中的 MLP,一个批可以看作一系列输入行向量,也可以看作一个行数等于批大小的矩阵。将它们作为矩阵计算,比把各个向量作为独立输入依次计算更高效。
量化
与许多其他应用相比,DNN 对数值精度的要求较低。例如,它不需要高性能计算通常采用的双精度浮点运算。2024 年,许多 DNN 加速器支持 8 位或 16 位浮点数据;新近的 DNN DSA 还提供 6 位乃至 4 位浮点数据。DNN 也不需要完全达到 IEEE 754 浮点标准的精度要求;该标准的目标是把误差限制在浮点有效数最低位单位的二分之一以内。
为了利用数值精度上的灵活性,开发者经常在推理阶段使用定点运算代替浮点运算;训练通常仍采用浮点运算。这种从浮点数到整数的转换称为量化(quantization),经过转换的应用则称为已量化(quantized)的应用(Vanhoucke 等,2011)。定点数据可以是 1、2、4、8 或 16 位;标准的乘加运算通常使用乘法位宽的两倍进行累加。这种转换一般发生在训练完成之后,可能使 DNN 的准确率下降几个百分点(Bhattacharya 和 Lane,2016)。
位宽更窄的数据有利于 DNN:它们既能提高算术强度,也能减少权重所占的存储容量;后文将看到,这一容量往往受到限制。
DNN 小结
即使只是以上简要介绍,也足以说明:面向 DNN 的 DSA 至少需要高效执行以下矩阵相关运算——向量—矩阵乘法、矩阵—矩阵乘法和 stencil 计算。它们还需要支持非线性函数,至少包括 ReLU、Sigmoid 和 tanh。这些要求并不多,却仍然留下了极为广阔的设计空间,后续各节将对此展开讨论。
译注:图 7.4 的两处训练时间换算与其列出的设备数量和天数不一致。64 个 TPU v2 连续运行 4 天为 6144 个设备小时,而非约 1500;16 个 TPU v3 运行 2.5–3 天为 960–1152 个设备小时,而非约 70。原表未说明是否采用了其他计量口径。 ↩︎
译注:原文将步长也列为输出特征图“数量”的影响因素。按本节随后给出的参数区分,步长直接影响的是每张输出特征图的空间尺寸;特征图数量与所采用的滤波器数量对应。 ↩︎
译注:原图注确实写作图 7.7;从图示内容看,这里所指的多个特征图构成第三个维度的情况,应参见图 7.8。 ↩︎
译注:原图注写作 −1 至 +1。Softmax 的定义为 ,对于有限实数输入,其各输出均为正数且总和为 1,因此应处于 0 与 1 之间,不会为负数。 ↩︎