7.4 Google 的 Tensor Processing Unit v4 与 v4 lite:数据中心 DNN 加速器
早在 2006 年,Google 工程师就开始讨论在数据中心部署 GPU、FPGA 或定制 ASIC。他们当时的结论是:能够在专用硬件上运行的应用为数不多,利用大型数据中心的富余容量,几乎就能免费完成这些工作,而要比“免费”更划算并不容易。2013 年,讨论发生了转折。当时的预测显示,如果每人每天使用基于语音识别 DNN 的语音搜索 3 分钟,Google 就需要把数据中心规模扩大一倍,才能满足计算需求。若依靠传统 CPU 实现这一目标,既耗时又昂贵。
Google 随即启动了一个高优先级项目,力求快速开发出用于推理的定制 ASIC,同时购买现成的 GPU 用于训练。项目的目标是把性价比提高到 GPU 的 10 倍。Tensor Processing Unit(TPU)v1 实现了这一目标:其每瓦性能达到同时代 CPU 的 80 倍、GPU 的 30 倍。随着机器学习日益重要,CPU 和 GPU 也加入了针对机器学习的专门优化,因此,它们与 DNN DSA 的差距如今已有所缩小。
第一代 TPU 采用面向推理的单核设计,第二代和第三代则采用同时面向训练与推理的双核设计。它们通过面向 DNN 的 JAX、PyTorch 和 TensorFlow 框架编程,并使用定制的 XLA 编译器。
开发第四代 TPU 时,1 Google 意识到:只要采用相同的核心,就可以从同一个设计派生出两款芯片——一款使用单核进行推理,类似 TPU v1;另一款使用双核进行训练,类似 TPU v2 和 TPU v3。图 7.11 列出了本节介绍的两款 TPU 的特性。同一个团队基于统一的代码库开发了这两款芯片。
| 特性 | Google TPU v4 lite | Google TPU v4 |
|---|---|---|
| 投入生产部署的年份 | 2020 | 2020 |
| 峰值性能 | 138 TFLOPS(bf16 或 8 位整数) | 275 TFLOPS(bf16 或 int8) |
| DNN 目标任务 | 仅推理 | 训练或推理 |
| 时钟频率 | 1050 MHz | 1050 MHz |
| 工艺节点、裸片面积 | 7 nm,<400 mm² | 7 nm,<700 mm² |
| 晶体管数量 | 160 亿 | 220 亿 |
| 每台 CPU 主机连接的芯片数 | 8 | 4 |
| 热设计功耗 | 175 W | 未提供 |
| 空闲功耗;最小/平均/最大功耗 | 55 W;未提供 | 90 W;121/170/192 W |
| 芯片间互连 | 2 条,每条 50 GB/s | 6 条,每条 50 GB/s |
| 最大配置规模 | 8 颗芯片 | 4096 颗芯片 |
| 提供云服务的平台 | ||
| 处理器类型 | 单指令、二维数据 | 单指令、二维数据 |
| 每核运算单元数 | 65,536(bf16) | 65,536(bf16) |
| 每芯片核心数 | 1 | 2 |
| 每核线程数 | 1 | 1 |
| 片上存储容量 | 144 MiB | 160 MiB |
| DRAM 容量、带宽 | 8 GiB,614 GB/s | 32 GiB,1200 GB/s |
我们先介绍面向推理的 TPU v4 lite,再说明 TPU v4 为支持训练所作的改动。
TPU v4 lite 的体系结构
图 7.12 是 TPU v4 lite 的框图,其中包括 uncore,即芯片上 TensorCore 之外的全部部分。TPU v4 也采用与推理芯片相同、但规模有所扩大的 uncore。设计的中心是一个向量单元,以及 16 MB 的向量存储器。向量单元执行 DNN 的激活函数。Google 从 TPU v2 开始引入自行设计的“brain float 16”(Bfloat16)浮点格式,因为它比 IEEE 754 fp16 更适合 DNN。与 fp16 不同,bf16 的指数位数与 IEEE 754 fp32 相同,但尾数位数更少,而 DNN 对尾数位数的要求较低。
向量单元连接四个矩阵乘法单元(matrix multiply unit,MXU)。每个 MXU 每个时钟周期执行 的矩阵乘法计算:可以使用 bf16 并以 IEEE 754 fp32 累加,也可以使用 8 位整数并以 32 位累加。每个 MXU 有 16,384 个乘加单元,使 TPU v4 lite 的峰值性能达到 138 TFLOPS。跨通道单元(Cross Lane Unit,XLU)负责在 VPU 的各个通道之间执行 矩阵转置、归约和排列操作。
MXU 采用脉动执行(systolic execution),通过减少对向量存储器的读写来节约能耗(Kung 和 Leiserson,1980;Ramacher 等,1991)。脉动阵列是一组按二维方式排列的运算单元;每个单元独立计算部分结果,其输入来自相对于该单元处于上游的其他运算单元。
阵列依靠不同方向的数据按固定时间间隔到达各个单元,并在单元内组合运算。数据以不断前进的波前形式流经阵列,类似心脏推动血液流经人体循环系统,因此得名“脉动”。
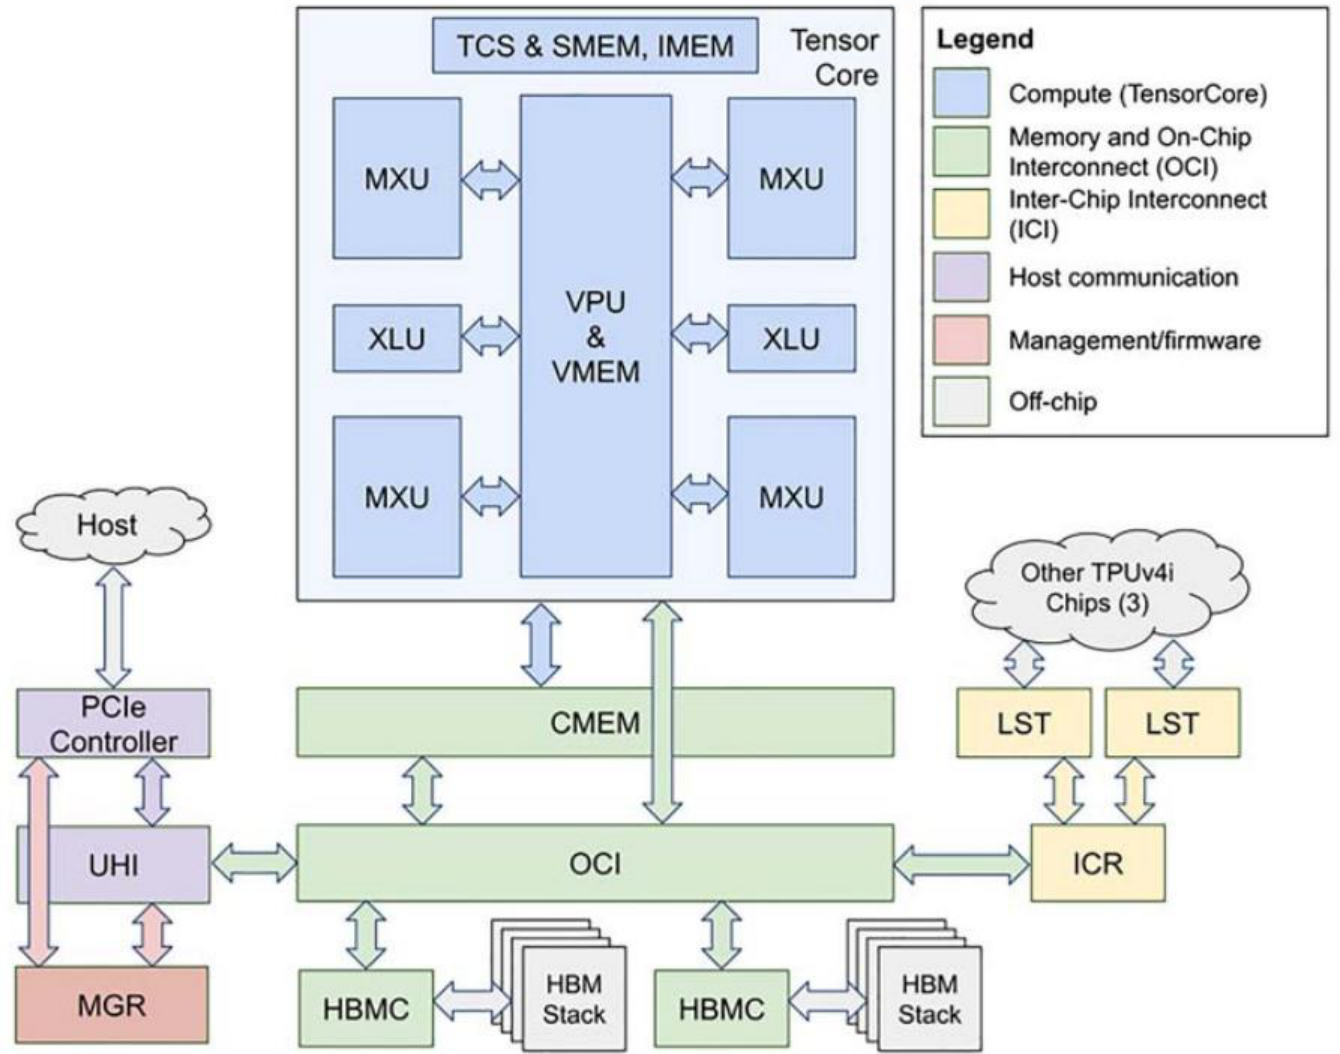
体系结构中的存储器包括公共存储器(Common Memory,CMEM)、向量存储器(Vector Memory,VMEM)、标量存储器(Scalar Memory,SMEM)、指令存储器(Instruction Memory,IMEM)以及高带宽存储器(High Bandwidth Memory,HBM)。HBM 是采用独立封装的标准 DRAM 产品,许多 DNN DSA 都依赖它。数据通路包括矩阵乘法单元 MXU、向量处理单元 VPU、跨通道单元 XLU 和 TensorCore 定序器(TensorCore Sequencer,TCS)。uncore 是图中上方中央大型阴影框之外的全部部分,包括片上互连(On-Chip Interconnect,OCI)、芯片间互连路由器(ICI Router,ICR)、ICI 链路栈(Link Stack,LST)、HBM 控制器(HBMC)、统一主机接口(Unified Host Interface,UHI)和芯片管理器(Chip Manager,MGR)。图例还区分了计算、存储器与片上互连、芯片间互连、主机通信、管理/固件以及片外部分;HBM Stack 表示 HBM 堆叠,Host 表示主机,PCIe Controller 表示 PCIe 控制器;Other TPUv4i Chips (3) 表示另外 3 颗 TPUv4i 芯片。
图 7.13 展示了脉动阵列的工作过程。图中底部的六个圆表示乘加单元,预先装入了权重 。输入数据 在时间上错开,从阵列上方进入。图中按页面由上向下展示的十个步骤,代表十个时钟周期。阵列向下传递输入,向右传递乘积和部分和。当数据走完整个脉动阵列时,所需的乘积之和就会输出。注意,在脉动阵列中,输入数据只需从存储器读取一次,输出数据也只需写回存储器一次。
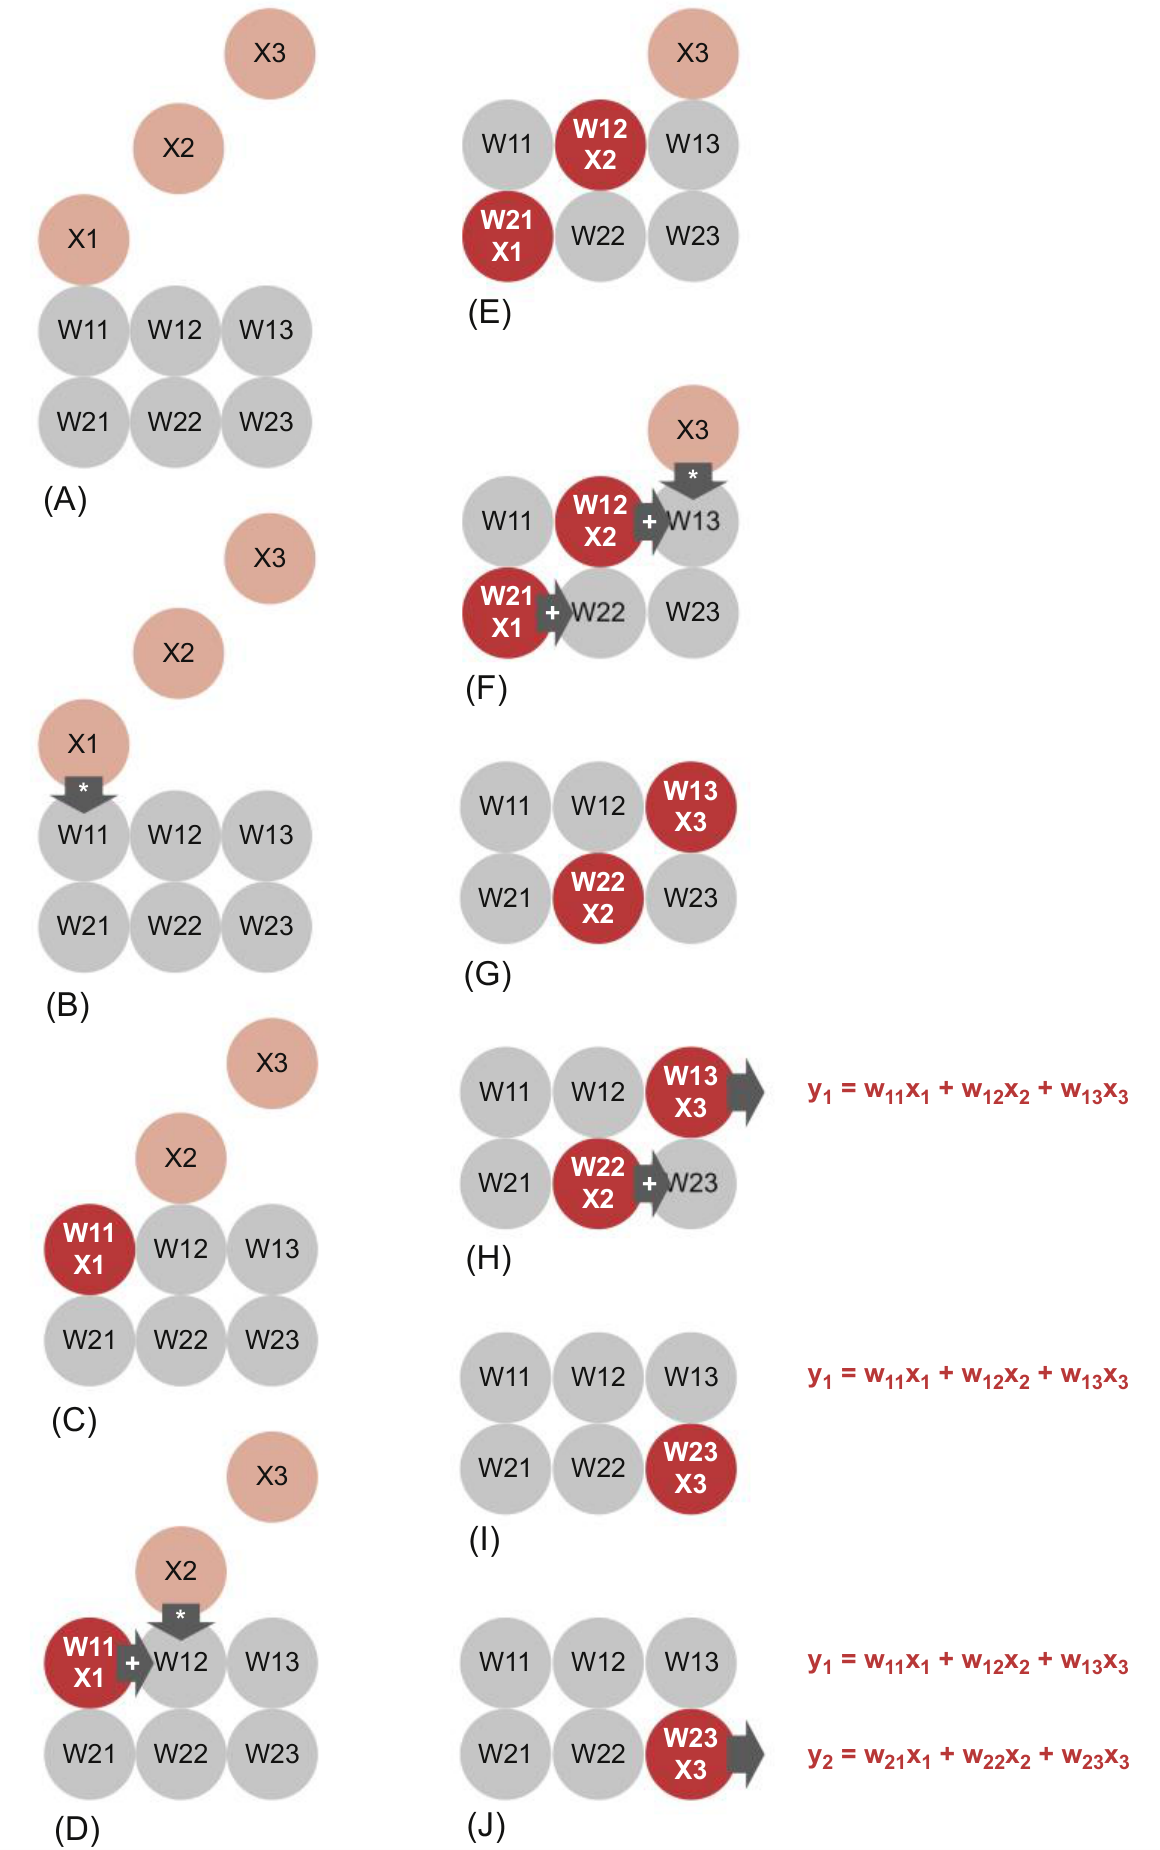
本例中,六个权重已经位于乘加单元内,TPU 通常也是如此。三个输入在时间上错开,以实现预期的数据配合;本图中它们从上方进入,而在 TPU 中,数据实际上从左侧进入。阵列把数据向下传递给下一个单元,把计算结果向右传递给下一个单元;过程结束后,在右侧得到乘积之和:,。绘图由 Yaz Sato 提供。
TPU 中的脉动阵列相当于旋转了上述布置。原文以图 7.13 为参照,说明权重从顶部装入,输入数据从左侧流入阵列。2 一次含 128 个元素的乘加操作,会以对角波前的形式通过矩阵。权重预先装入,并随波前推进,与新数据块的首批数据一同生效。控制与数据都经过流水化,使其表现得像是一次读入了 128 个输入;经过一段输入延迟后,它们更新 128 个累加器存储器中各自的一个位置。从正确性角度看,软件无需知道矩阵单元内部采用脉动阵列;但为了获得良好性能,软件必须考虑该单元的延迟。
图 7.14 展示了 TPU v4 lite 裸片的平面布局。该芯片采用 7 nm 工艺,时钟频率为 1.05 GHz。虽然确切的裸片面积并未公开,但它小于 400 mm²。
图 7.14 中最大的模块是 CMEM,占芯片面积的 28%。DNN 所需的一些大型数据结构无法装入 16 MB 向量存储器,因此 TPU v4 在存储层次中增加了一个 128 MB 存储器,减少对速度最慢、能效最低的主存——HBM——的访问次数。
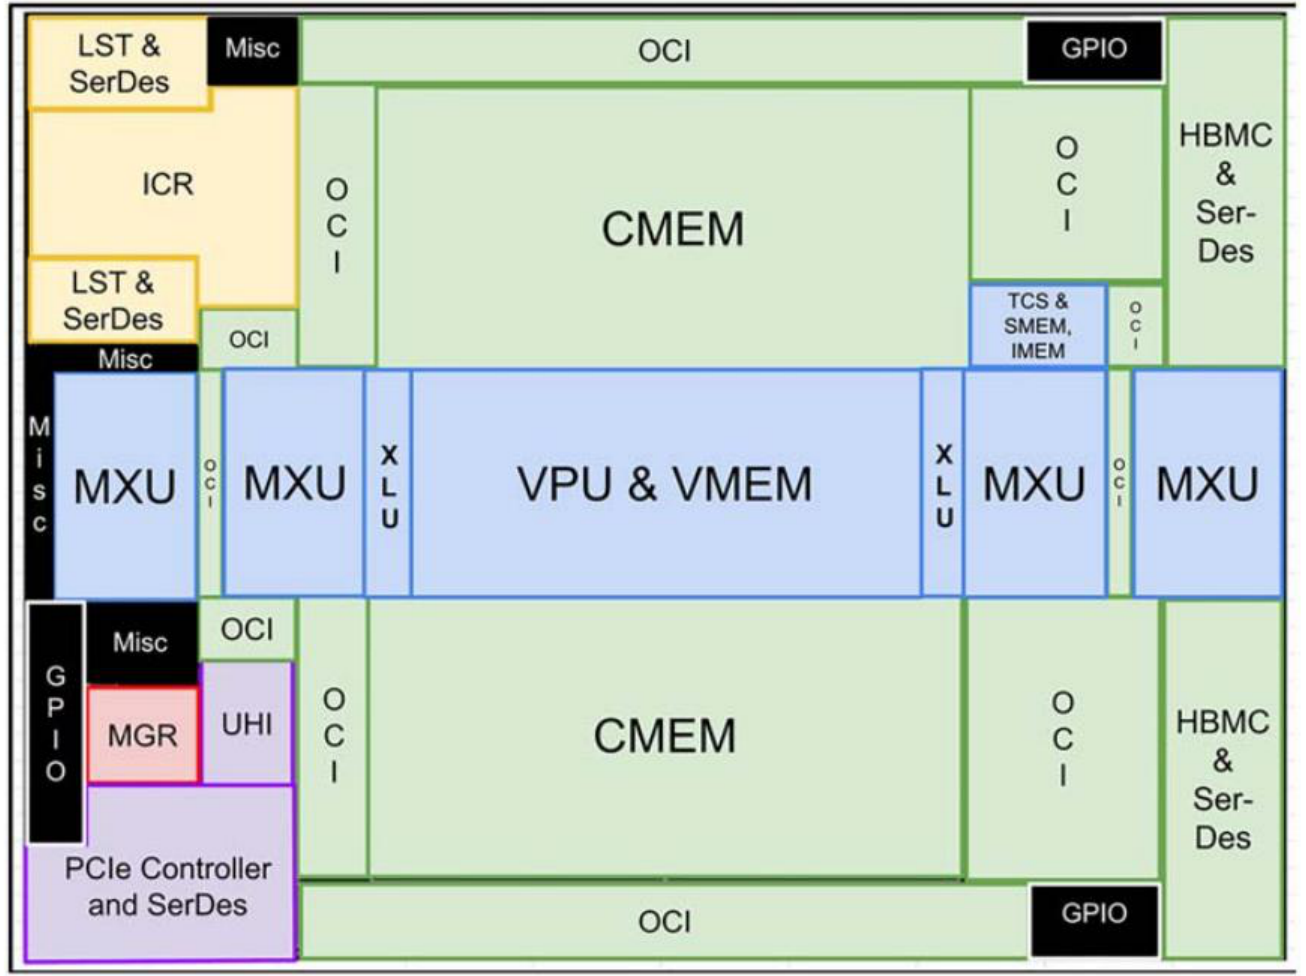
原图注称,配色与图 7.11 一致。3 裸片面积小于 400 mm²,CMEM 占面积的 28%。在各模块紧邻排列的布局中,OCI 模块被拉长以填满空隙,因为裸片的尺寸及整体布局主要取决于 TensorCore、CMEM 和 SerDes 的位置。TensorCore 和 CMEM 的模块布局源自 TPU v4。图中 SerDes 表示串行器/解串器,GPIO 为通用输入输出,Misc 为其他模块;其余缩写见图 7.12。
TPU v4 lite 的指令集体系结构
Google 工程师没有要求 TPU v4 与 TPU v2、TPU v3 的 VLIW 指令集保持二进制兼容,而是选择编译器兼容,原因有以下几点:
- VLIW 最初的立足点就是:随着硬件资源增加,通过重新编译应用,让编译器控制新增的指令级并行性;二进制兼容反而会限制这一点。
- 一些 Google 工程师曾开发过 Itanium 编译器,了解二进制兼容对 VLIW 编译器和硬件的弊端。
- XLA 编译器除 TensorFlow 外,还接受 JAX 和 PyTorch,因此 TPU 可以依赖一个编译器,而无需提供供多种编译器使用的接口。
- TPU 软件以源代码形式维护和分发,而不是二进制形式。
TPU v4 指令集使用约 400 位的 VLIW 指令束,取代 TPU v2 和 TPU v3 的 322 位指令束;新增位用于控制额外特性,例如更多的 MXU。
XLA 生成与机器无关的高层操作(high-level operation,HLO),以及与机器相关的低层操作(low-level operation,LLO)。HLO 层的优化适用于所有平台。如果新一代 TPU 所需的编译器改动仅限于 LLO,例如使用更宽的 VLIW,那么 HLO 优化就不受影响。
XLA 编译器显式控制各类并行性:
- 指令级并行。 XLA 使用循环展开、指令调度和软件流水等标准编译技术,使所有计算单元保持忙碌。
- 数据级并行。 对于二维向量寄存器和计算单元,数据在计算单元及存储器中的布局对性能至关重要,其重要性可能超过向量处理器或 SIMD 处理器。对 MXU 而言,两个二维输入相互作用,生成一个二维输出。每个操作数都有自己的存储布局,需要转换为二维寄存器中的布局,再在精确的时刻送入 MXU,以满足脉动阵列的时序要求。
- 存储级并行。 TPU v4 lite 没有缓存,因此存储层次各级之间的全部数据传输,都由编译器调度。芯片 uncore 各处分布着张量 DMA 引擎,以减轻互连延迟和导线缩放困难带来的影响。
这些张量 DMA 引擎作为协处理器,完整译码并执行 TensorCore DMA 指令。TPU v4 lite 的四维 DMA 为本地(片上)、远程(芯片间)以及主机(主机到芯片、芯片到主机)传输提供统一的 DMA 体系结构,使应用更容易从单颗芯片扩展到整个 pod。
- 线程级并行。 XLA 把 TensorFlow 程序中的并行工作映射到超级计算机中的数千颗芯片上,目标是在从 4 颗到 4096 颗芯片的系统上无缝运行。
TPU v4 相比 TPU v4 lite 的变化
如前所述,芯片本身最大的变化是:TPU v4 有两个 TensorCore(TC),而不是一个,因此峰值性能翻倍,达到 275 TFLOPS。两个核心共享 CMEM,因此它称为“公共存储器”。
从系统角度看,两款 TPU 的差异很大。TPU v4 lite 针对推理优化,每台 CPU 主机配置 8 颗 TPU v4 lite。训练对主机计算能力的要求更高,因此每台 CPU 主机只配置 4 颗 TPU v4。TPU v4 的目标是互连成为 Google 称作 pod 的超级计算机,因此它有 6 条芯片间互连(Inter-Chip Interconnect,ICI)链路,而 TPU v4 lite 只有 2 条。相比之下,TPU v3 有 4 条 ICI 链路。增加链路后,TPU v4 可以采用二分带宽更高的网络拓扑,即三维环面。TPU v3 的 pod 最多容纳 1024 颗芯片,TPU v4 则可达 4096 颗。因此,一个 pod 的 bf16 峰值性能超过 1 EFLOPS。TOP500 榜单对单台 HPC 超级计算机进行排名;Google 则在云中部署了数十个这样的 pod。
TPU v4 为训练带来的最后一项主要改进,是把片外 HBM 容量从 TPU v4 lite 的 8 GiB 增加至 32 GiB。
小结:TPU v4 如何遵循设计准则
下面考察 TPU v4 和 TPU v4 lite 如何遵循 7.2 节的准则。
- 使用专用存储器,尽量缩短数据移动的距离。 TPU v4 提供两级由程序控制的片上 SRAM,其能效是片外 HBM 的 20 倍。
- 把取消先进微体系结构优化所节省的资源,投入更多运算单元或更大的存储器。 TPU v4 提供 160 MiB 软件控制的 scratchpad 存储器,包括 128 MiB CMEM 和两个 16 MiB VMEM,以及 131,072 个 16 位/32 位 ALU;ALU 数量比同时代服务器 CPU 高一个数量级。TPU v4 lite 的 ALU 数量减半,而片上存储容量几乎相同,包括 128 MiB CMEM 和一个 16 MiB VMEM。
- 采用与应用领域匹配的最简单并行形式。 TPU 的每个 TC 都有四个 MXU,以二维 SIMD 并行提供性能,内部则采用脉动结构进行流水化。除利用数据级并行外,它还在每个插槽中提供两个 TC,并使每台超级计算机最多容纳 4096 颗芯片。约 400 位的 VLIW 指令则用于利用指令级并行。同时代 CPU 依赖多处理、乱序执行、多线程和一维 SIMD。
- 把数据大小与类型缩减到该领域所需的最简形式。 TPU 主要计算 16 位浮点数据,以 32 位浮点数累加,同时支持 8 位整数。主要收益是:较窄的数据减少了对存储带宽和容量的需求。CPU 还支持 64 位整数,以及 32 位、64 位浮点数。
- 采用领域专用编程语言,把代码移植到 DSA。 TPU 使用 JAX、PyTorch 和 TensorFlow 编程框架;CPU 则必须运行几乎所有编程语言。