7.5 NVIDIA A100 与 T4 GPU:数据中心的图形和 DNN 加速器
如第 4 章所示,NVIDIA GPU 从根本上说是一种多处理器体系结构,其中的处理器称为流式多处理器(Streaming Multiprocessor,SM)。对于同一代产品,GPU 通过改变 SM 的数量,在成本与性能之间形成不同配置;SM 数量从数十个到一百多个不等。GPU 还利用多处理器结构设置冗余 SM,以提高芯片良率。
GPU 的存储层次同时具有缓存和 scratchpad 存储器,但隐藏存储延迟主要依靠大量线程,以及在线程之间快速切换。支持快速上下文切换的主要硬件,是容量很大的寄存器堆。GPU 体系结构鼓励 CUDA 程序员暴露大量线程,以便一些线程等待存储器时,始终有其他线程可以执行。GPU 每次把 32 个线程组成一个 warp;某个 warp 等待 HBM 中的操作数时,就切换到另一个 warp。只有 warp 的访存得到合并(coalesced),即加载或存储访问连续的存储位置,GPU 才能充分利用存储带宽。
GPU 最初是为图形处理设计的。这类工作采用数据密集型算法,数值计算量大,存储访问模式规则。DNN 具有相似特点,因此十年前 GPU 就已成为机器学习的热门平台。
随着在 GPU 上运行机器学习越来越普遍,近几代 GPU 除了进行同时有利于图形与机器学习的体系结构增强,还加入了专门服务于 DNN 的特性。前一类改进包括,新型服务器级 GPU:
- 提高主存带宽和容量;
- 增大缓存容量;
- 增加每个插槽中的 SM 数量;
- 提高 Turbo 加速频率。
NVIDIA A100 Tensor Core 体系结构
第 4 章的 4.4 节介绍过,NVIDIA GPU 采用分块式体系结构,每个块称为 SM。第 4 章使用了更具描述性的名称:多线程 SIMD 处理器。随着 GPU 世代更替,SM 数量不断增加,从 Pascal 的 56 个增长到 Hopper 的 132 个(见图 4.21)。与 Google TPU v3 同时代的 Volta(Jouppi,2020),是首款直接支持机器学习的 NVIDIA GPU。NVIDIA 报告称,取决于矩阵大小,这种支持使 GPU 的机器学习峰值性能提高至原来的 6–9 倍。
CUDA 的矩阵乘法操作为 ,其中 、、、 都可以是更大矩阵的分块(Raihan,2019)。每次分块运算由 三个维度描述:
- 的维度为 ;
- 的维度为 ;
- 和 的维度为 。
这正是矩阵乘法所要求的维度关系。Volta 增加了四条 TC PTX 指令来支持这些操作:LoadA、LoadB、MultiplyAddA 和 StoreD。每条指令都根据数据类型、形状、步长、数据布局和同步方式,提供多种选项。
为了把计算映射到 SM 的多线程结构,每个分块还会进一步划分为 fragment,分别映射到各线程的寄存器中。例如,对于一个 分块,由 32 个线程组成的 warp 可以把每线程 个元素的 fragment,映射到 8 个独立的通用寄存器中。NVIDIA 尚未公布 fragment 到寄存器的具体映射方式。对细节感兴趣的读者可以参阅 Raihan(2019):该研究通过逆向分析发现,矩阵 在一个 warp 内的数据分布,与矩阵 、 不同。
每个 Volta SM 包含四个子核,其结构见图 7.15;每个子核又包含两个 Tensor Core(TC)(Choquette,2018)。Google 也把 TPU 中的处理器称为 TensorCore,这只是名称上的巧合。Volta 有 80 个 SM,因此共有 个 TC。
NVIDIA Ampere 每个子核只有一个 TC,因此总数为 个。Hopper 则恢复为每个子核两个 TC。
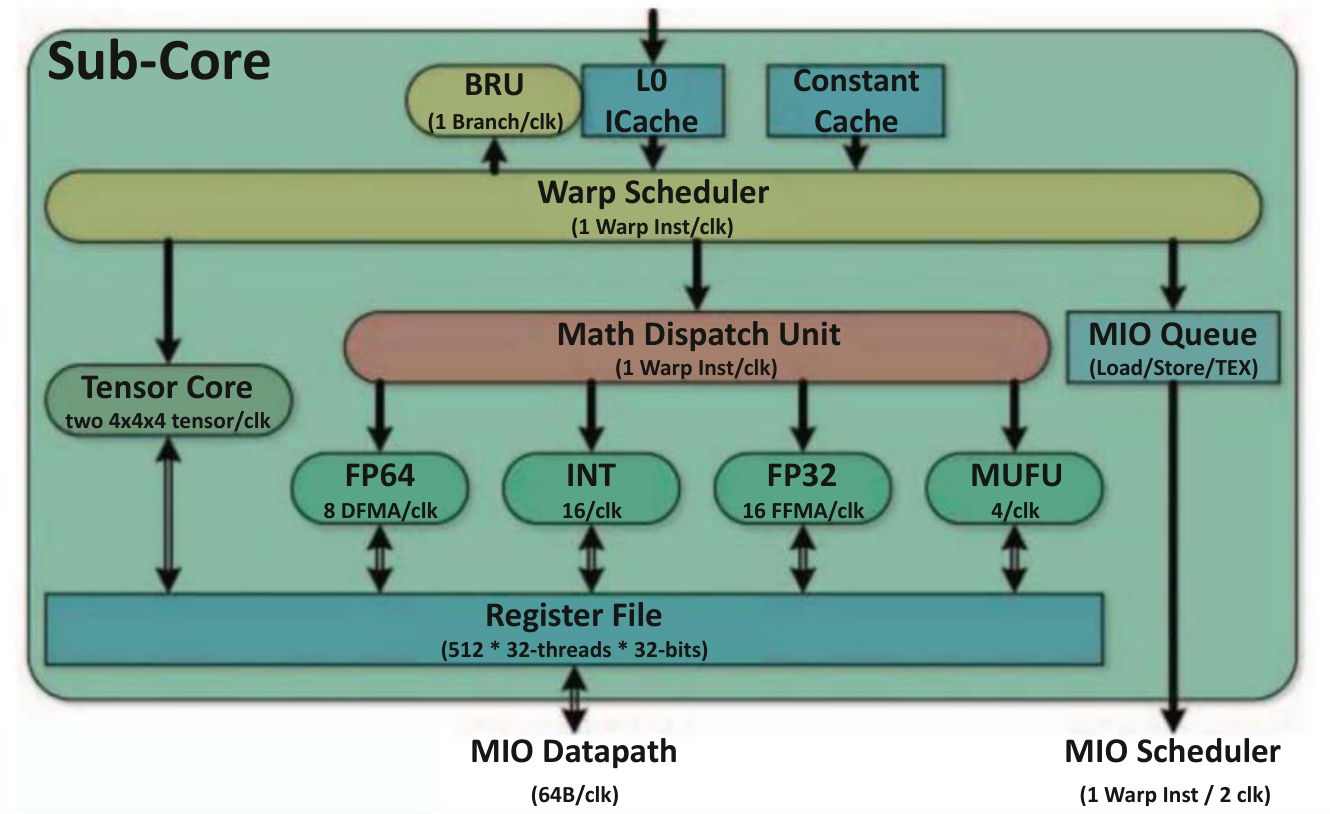
转载自 Choquette、Giroux 和 Foley(2018),《Volta: Performance and Programmability》,IEEE Micro,38(2):42–52,图 3。图中 Warp Scheduler 为 warp 调度器,Math Dispatch Unit 为算术派发单元,Register File 为寄存器堆,Constant Cache 为常量缓存,L0 ICache 为 L0 指令缓存,BRU 为分支单元;MIO Queue、Datapath、Scheduler 分别为 MIO 队列、数据通路和调度器。图中 Load/Store/TEX 表示加载、存储和纹理操作,INT 为整数单元,FP32/FP64 为相应精度的浮点单元;MUFU 保留原缩写。BRU 每周期处理 1 条分支;warp 调度器和算术派发单元每周期各处理 1 条 warp 指令;Tensor Core 每周期处理两个 4×4×4 张量运算;FP64 为 8 DFMA/周期,FP32 为 16 FFMA/周期,INT 为 16/周期,MUFU 为 4/周期;MIO 数据通路为 64 B/周期,MIO 调度器每 2 周期处理 1 条 warp 指令。寄存器堆容量表示为 。
每个 TC 执行矩阵乘法。 一个 TC 每个时钟周期处理 1024 位数据,可处理从 1 位整数到 16 位浮点数的操作数:1024 个 1 位整数、256 个 4 位整数、128 个 8 位整数,或 64 个 16 位浮点数。图 7.15 中的 warp 调度器向 TC 发送乘加操作;TC 从寄存器堆取出操作数,完成 矩阵乘法,再把结果写回寄存器堆。每个 TC 每个周期完成一次这样的矩阵乘加,原文计为 64 次浮点运算。1
NVIDIA 没有公布 TC 的框图。Raihan(2019)通过运行微基准,尝试揭示其底层微体系结构;图 7.16 给出了他们推测的 Volta TC 微体系结构。
TPU 的矩阵乘法硬件依赖脉动阵列。Volta 只计算 矩阵,而不是 ,因此不需要脉动阵列。Volta 的乘加硬件采用组合逻辑,依靠良好的电路设计、逻辑设计、流水化和物理设计,在一个时钟周期内完成全部 64 次浮点运算。
Volta TC 可以执行 fp16 运算,或 fp16 与 fp32 的混合精度运算。图 7.17 展示了后续 GPU 如何改变 TC 支持的数据类型。Ampere 中的 tf32 是 TensorFloat-32 的缩写:其指数位数与 fp32 相同,都是 8 位;尾数位数与 fp16 相同,都是 10 位。
这种 19 位格式在存储器中需要占用 32 位。当 bf16 的 7 位尾数或 fp16 的 5 位指数不足以满足需求时,tf32 可以提供比 fp32 更高的计算效率。Hopper 的 fp8 浮点格式有两种:符号位、4 位指数、3 位尾数;或者符号位、5 位指数、2 位尾数。设计上的预期是,训练的前向传播需要更高精度,因此需要更多尾数位;反向传播则需要更大的数值范围,因此需要更多指数位。
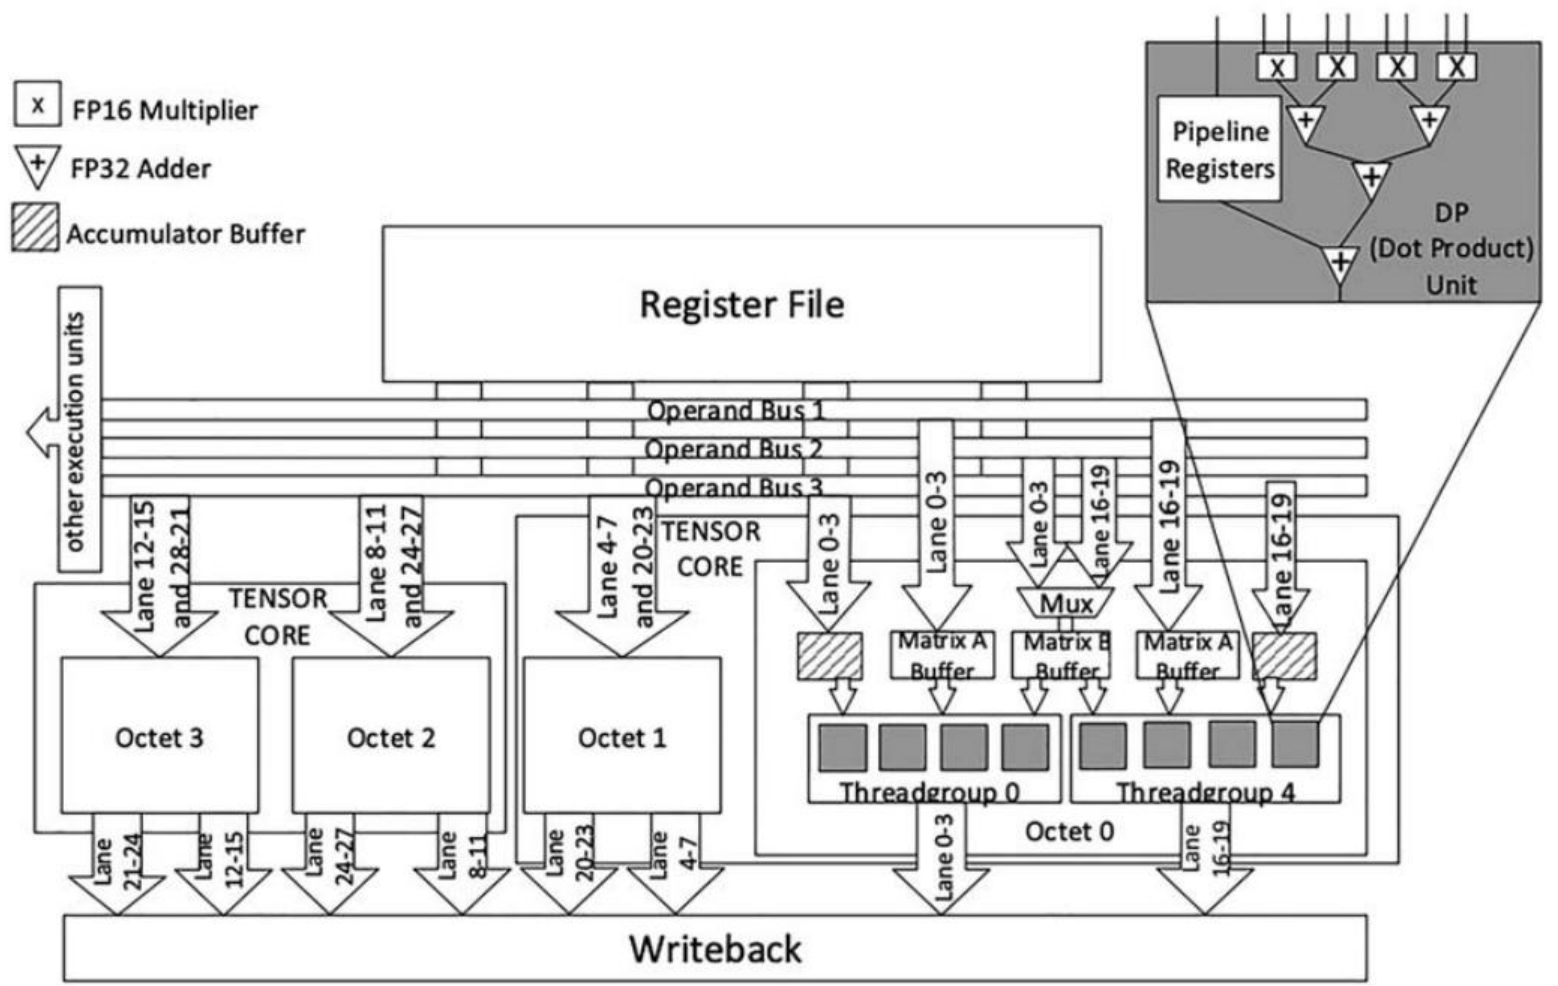
threadgroup 是 warp 内四个连续线程组成的组。octet 由两个 threadgroup 构成,用于计算结果中 的子分块。每个 Volta warp 有四个 octet。转载自 Raihan、Goli 和 Aamodt(2019),《Modeling Deep Learning Accelerator Enabled GPUs》,2019 IEEE International Symposium on Performance Analysis of Systems and Software (ISPASS),79–92 页,图 13。图中 FP16 Multiplier 为 fp16 乘法器,FP32 Adder 为 fp32 加法器,Accumulator Buffer 为累加器缓冲区,Pipeline Registers 为流水线寄存器,DP 为点积单元,Operand Bus 为操作数总线,Matrix A/B Buffer 为矩阵 A/B 缓冲区,Writeback 为写回,Lane 为通道,Other Execution Units 为其他执行单元;Register File 为寄存器堆,Mux 为多路选择器。
| GPU 世代 | 整数类型 | 浮点类型 |
|---|---|---|
| Volta | n.a. | fp16、fp32 |
| Turing | Int8 | fp16 |
| Ampere | Int1、Int4、Int8 | fp16、fp32、bf16、tf32、fp64 |
| Hopper | Int8 | fp16、fp32、bf16、tf32、fp64、fp8 |
| Blackwell | Int8 | fp16、fp32、bf16、tf32、fp64、fp8、fp6、fp4 |
Blackwell 的 fp4 格式只有 2 位指数和 1 位尾数;令人惊讶的是,它仍然是一种浮点格式,只是总共只有 16 个可能的取值。
A100 的每个 SM 有 4 个 TC,每个 TC 每周期处理 4096 位数据。Ampere 还引入了对细粒度结构化稀疏性的支持:对于连续四个数值组成的数据块,只要其中任意两个为零,就可以使用这一机制。A100 增加了一条执行 2:4 稀疏矩阵乘法的 PTX 指令。
TC 只对两个非零值执行运算,因此能在一半时间内完成相同计算。当数据符合这种模式时,这项优化使峰值性能翻倍。DNN 的适应性相当强,机器学习框架可以尝试让训练后的部分数据满足 2:4 稀疏模式。NVIDIA 展示的一个例子中,性能提升为 1.10–1.18 倍,具体取决于批大小。
除了增加 fp8(见图 7.17),Hopper 还加入了专门针对 Transformer DNN 的硬件,足见这类模型的重要性。Transformer Engine 监测各 TC 输出值的统计特征,自动为 Transformer DNN 的每一层选择 fp8 或 fp16 数据类型;只要可行,就使用 fp8 提高性能。硬件在执行过程中完成 fp8 与 fp16 之间的缩放转换,程序员无需自行管理。Transformer Engine 的目标,是让 DNN 中每一层都采用满足自身需求的最小数据范围。
Hopper 取消了 A100 的 Int1 和 Int4 数据类型(见图 7.17),可能是因为体系结构设计者认为它们已不再必要。机器学习变化迅速,即使从 DNN DSA 开始设计到正式部署只有三年,也很难预判届时哪些数据类型会重要。
图 7.18 列出了 NVIDIA A100 和 T4 GPU 的主要特性。与上一节 TPU v4 lite 和 TPU v4 的比较类似,面向推理时,NVIDIA 每台 CPU 主机配置 8 块 T4,而每台主机配置 4 块 A100。同样,在系统层面,A100 可以扩展到 4096 颗芯片,T4 则只能扩展到 8 颗。A100 使用 12 条 NVLink,无缝扩展为称作 DGX 的 8 插槽系统;再通过集群网络交换机和链路,连接 512 台 DGX,组成总计 4096 颗芯片的系统。
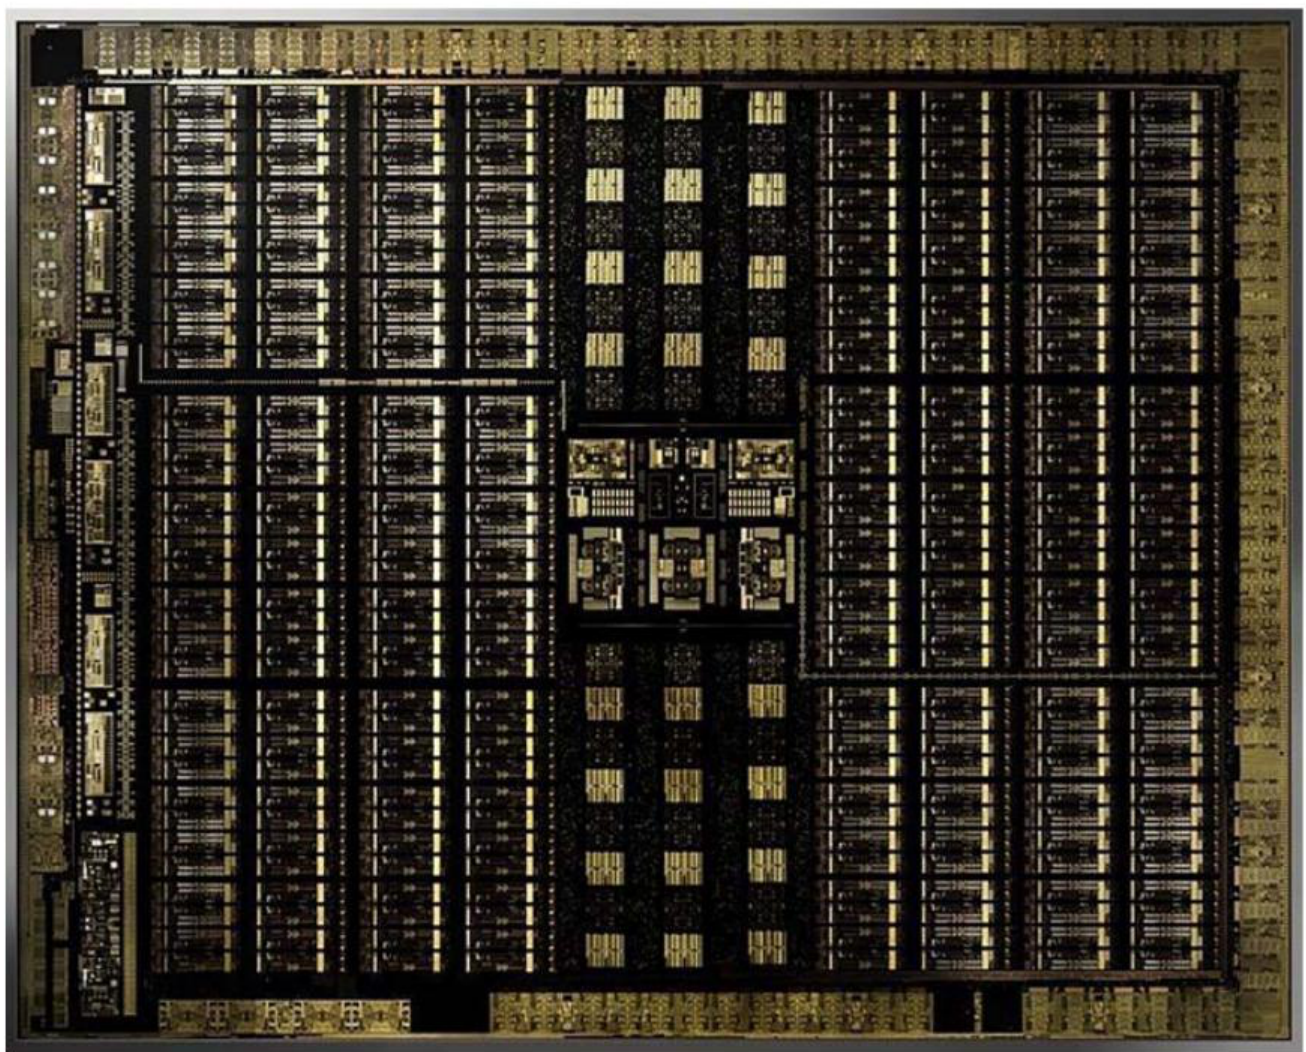
图 7.19 和图 7.20 展示了两款 GPU 的芯片布局。A100 与 T4 在尺寸、功耗和主存方面有显著差异。T4 的裸片面积约为 A100 的三分之二,但 SM 数量仅约为其 40%,因为 T4 使用更大的工艺节点,即 12 nm,而 A100 为 7 nm。值得注意的是,T4 的热设计功耗约为 A100 的四分之一,分别为 70 W 和 300 W,而基础时钟频率约为 A100 的 1/1.3,分别为 585 MHz 和 765 MHz。在最高 Turbo 加速模式下,关系反而倒转:T4 的频率约为 A100 的 1.1 倍,分别为 1590 MHz 和 1410 MHz。
另一个主要差异是,T4 采用图形 DRAM(GDDR6),A100 采用高带宽存储器(HBM2E)。容量比例同样约为 40%,分别为 16 GiB 和 40 GiB;带宽差距却接近 5 倍,分别为 320 GB/s 和 1555 GB/s。
| 特性 | NVIDIA A100 | NVIDIA T4 | Graphcore MK2 IPU |
|---|---|---|---|
| 投入生产部署的年份 | 2020 | 2018 | 2021 |
| 峰值性能(原表单位:TFLOPS) | 312(bf16),624(int8) | 65(IEEE fp16)/130(8 位整数) | 250(bf16) |
| DNN 目标任务 | 训练或推理 | 仅推理 | 训练或推理 |
| 时钟频率 | 765 MHz / Turbo 1410 MHz | 585 MHz / Turbo 1590 MHz | 1850 MHz |
| 工艺节点、裸片面积 | 7 nm,826 mm² | 12 nm,545 mm² | 7 nm,832 mm² |
| 晶体管数量 | 540 亿 | 140 亿 | 590 亿 |
| 每台 CPU 主机连接的芯片数 | 4 | 8 | 4 |
| 热设计功耗 | 300 W | 70 W | 300 W |
| 芯片间互连 | 12 条链路,每条 25 GB/s | — | 3 条链路,每条 64 GB/s |
| 最大配置规模 | 4096 颗芯片 | 8 颗芯片 | 256 颗芯片 |
| 提供云服务的平台 | AWS、Azure、Google | AWS、Azure、Google | AWS、Azure、Google |
| 处理器类型 | 单指令多线程 | 单指令多线程 | 多线程、单指令多数据 |
| 每处理器运算单元数 | 1024(fp16) | 512(fp16) | 64(fp16) |
| 每芯片处理器数 | 108 | 40 | 1472 |
| 每核线程数 | 32 | 32 | 6 |
| 片上存储容量 | 40 MiB | 18 MiB | 897 MiB |
| DRAM 类型 | HBM2E | GDDR6 | 无 |
| DRAM 容量、带宽 | 40 GiB,1555 GB/s | 16 GiB,320 GB/s | 0 |
译注:原表的峰值性能行统一标为 TFLOPS,表中沿用该原始表头。整数运算吞吐量应使用 TOPS,而不是表示浮点吞吐量的 TFLOPS;这里将单位疑点单独说明,未改动原表数值。
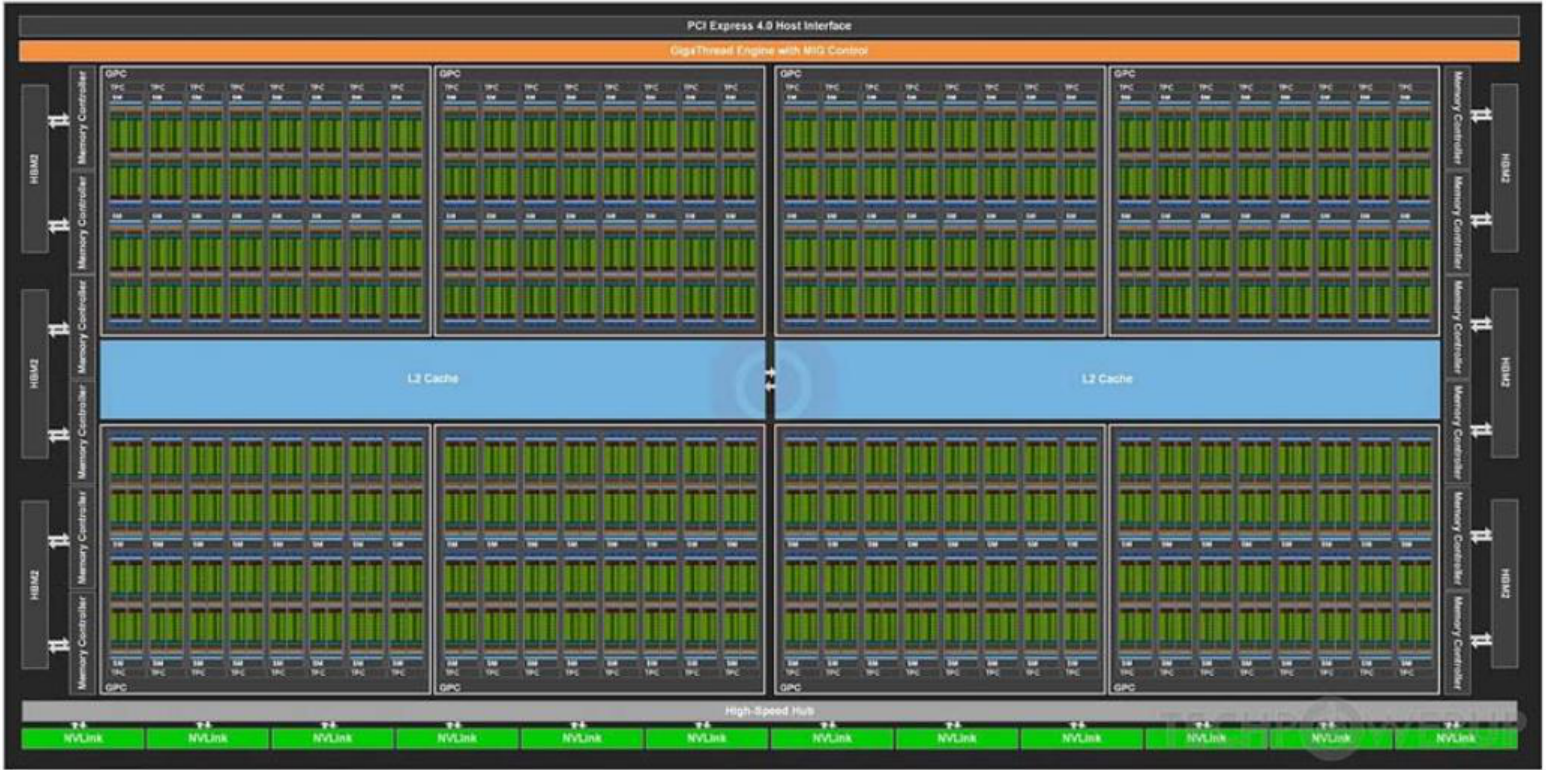
图中绘有 128 个 SMP,NVIDIA 仅启用其中 108 个。L2 缓存容量为 40 MB。A100 可以将 DRAM 数据压缩后放入缓存,以加速非结构化稀疏数据及其他可压缩的数据模式。其宣称的效果是:DRAM 读写带宽最多达到 4 倍,L2 读取带宽最多达到 4 倍,L2 缓存的有效容量最多达到 2 倍。图中 PCI Express 4.0 Host Interface 为 PCI Express 4.0 主机接口,GigaThread Engine with MIG Control 为带 MIG 控制的 GigaThread 引擎,Memory Controller 为存储控制器,L2 Cache 为 L2 缓存,High-Speed Hub 为高速集线器;GPC、TPC、SM、HBM2 和 NVLink 保留原缩写与产品名称。
最后一个差异是主存纠错码(ECC)的处理方式。与服务器 CPU 一样,A100 使用更宽的 HBM,使 ECC 校验或存储能够与数据访问同时进行:72 位中,64 位为数据,8 位为 ECC。T4 的 GDDR 存储器宽度为 64 位,因此启用 ECC 时,存储控制器会把 ECC 位存放到 DRAM 芯片的其他位置。前一种方式称为 sideband ECC,后一种称为 in-band ECC。因此,T4 客户可以选择是否启用 ECC。Google 数据中心要求主存启用 ECC,这使 T4 的性能平均下降约 5%(见 7.10 节)。
小结:A100 与 T4 如何遵循设计准则
下面考察 TPU v4 如何遵循 7.2 节的准则。2
- 使用专用存储器,尽量缩短数据移动的距离。 GPU 使用很大的寄存器堆支持大规模多线程:A100 为 27 MiB,T4 为 10 MiB。这些寄存器的总容量,与其 L2 缓存的 40 MiB 和 18 MiB 相当。
GPU 用作图形 DSA 时,多线程很有帮助;但它对机器学习究竟有多大帮助,目前还不清楚。 2. 把取消先进微体系结构优化所节省的资源,投入更多运算单元或更大的存储器。 A100 有 110,592 个 16 位/32 位 ALU,T4 有 20,480 个,同样远多于同时代 CPU。 3. 采用与应用领域匹配的最简单并行形式。 GPU 依赖多处理、多线程和二维 SIMD,不过其乘法单元比 TPU 的小。 4. 把数据大小与类型缩减到该领域所需的最简形式。 为了让程序员选择最合适的位宽,GPU 提供最广泛的数据类型:4 位和 8 位整数,以及 IEEE 16 位、32 位浮点数;A100 还增加了 1 位、16 位整数,以及 bf16、tf32、fp64 浮点格式。 5. 采用领域专用编程语言,把代码移植到 DSA。 GPU 使用面向机器学习的 JAX、PyTorch、TensorFlow 框架,以及 CUDA 和 OpenCL 编程。图形处理则使用 DirectX、Metal、OpenGL 等库。