7.7 Samsung 神经处理单元(NPU):智能手机推理加速器
智能手机中的 DSA 被设计为片上系统(SOC)的一部分。图 7.22 以与图 7.11、图 7.18 中数据中心加速器相对应的指标,列出了 Samsung 神经处理单元(Neural Processing Unit,NPU v1)的特性;图 7.23 则展示了裸片照片。与数据中心推理 DSA 相比,它的能耗和裸片面积预算低两个数量级。
每个 NPUv1 包含三个核心,核心框图见图 7.24。每核包含两个 NPU 引擎,共享一个称为紧耦合存储器(Tightly Coupled Memory,TCM)的 1 MiB scratchpad。NPU 引擎的中心是张量单元,其中有四个 乘加阵列,与 TPU v4 lite 的四个 MXU 类似。它们可能也采用脉动阵列结构,主要处理 8 位整数;也可以处理 16 位整数,但每次运算需要多个时钟周期。
| 特性 | Samsung NPUv1 | Samsung NPUv2 | Intel Core i7-11375H |
|---|---|---|---|
| 投入生产部署的年份 | 2021 | 2022 | 2021 |
| 峰值性能(原表单位:TOPS/sec,8 位整数) | 14.6(8 位) | 39.3(4 位),19.7(8 位),9.8(fp16) | 1.3(8 位),0.6(fp16) |
| DNN 目标任务 | 仅推理 | 仅推理 | 通用 |
| 基础时钟频率(MHz) | 332 | 332 | 3300 |
| Turbo 时钟频率(MHz) | 1196 | 1196 | 5000 |
| AVX/SIMD 时钟频率(MHz) | N.A. | N.A. | 原表留空 |
| 工艺节点、裸片面积 | 5 nm,5.4 mm² | 4 nm,4.7 mm² | 10 nm,122 mm² |
| 晶体管数量 | N.A. | N.A. | N.A. |
| 热设计功耗 | 0.6 V 时 0.33 W;0.9 V 时 0.79 W | 0.55 V 时 0.38–5.1 W | 28–35 W |
| 处理器类型 | 单指令、二维数据 | 单指令、二维数据 | 多线程 SIMD |
| 每核运算单元数 | 2048(8 位) | 4096(8 位) | 64(8 位) |
| 每芯片核心数 | 3 | 2 | 4 |
| 每核线程数 | 1 | 1 | 2 |
| 片上存储容量 | 3 MiB | 2 MiB | 17 MiB |
| DRAM 类型 | N.A. | N.A. | DDR4、LPDDR4 |
| DRAM 容量、带宽 | N.A. | N.A. | 64 GiB,26–34 GB/s |
这些处理器将在 7.9 节中比较。原图注明来源为《Architecture for Samsung Flagship Mobile SoC》。N.A. 沿用原表,表示未提供或不适用。
译注:原表将峰值性能统一标为“TOPS/sec(8 位整数)”,但各列也列出了 4 位整数及 fp16 数据;此外,TOPS 本身已表示每秒万亿次运算,再附加 /sec 重复计入了时间单位。表中保留原始表头和数值;若按运算类型区分,整数吞吐量应以 TOPS 表示,浮点吞吐量应以 TFLOPS 表示。
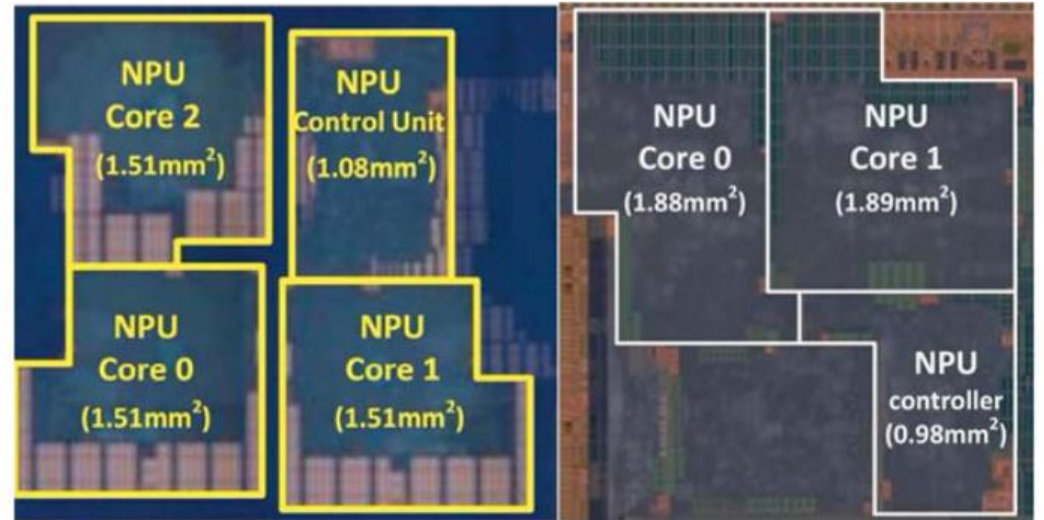
NPUv1 采用 5 nm 工艺,裸片面积为 5.4 mm²,包含三个核心。NPUv2 采用 4 nm 工艺,裸片面积为 4.7 mm²,包含两个核心。两个版本中,每核都包含 1 MiB SRAM。两张裸片照片保持实际的相对尺寸。来源:2021 ACM/IEEE 48th Annual International Symposium on Computer Architecture (ISCA)。图中 NPU Core 为 NPU 核心,NPU Control Unit / controller 为 NPU 控制单元/控制器。
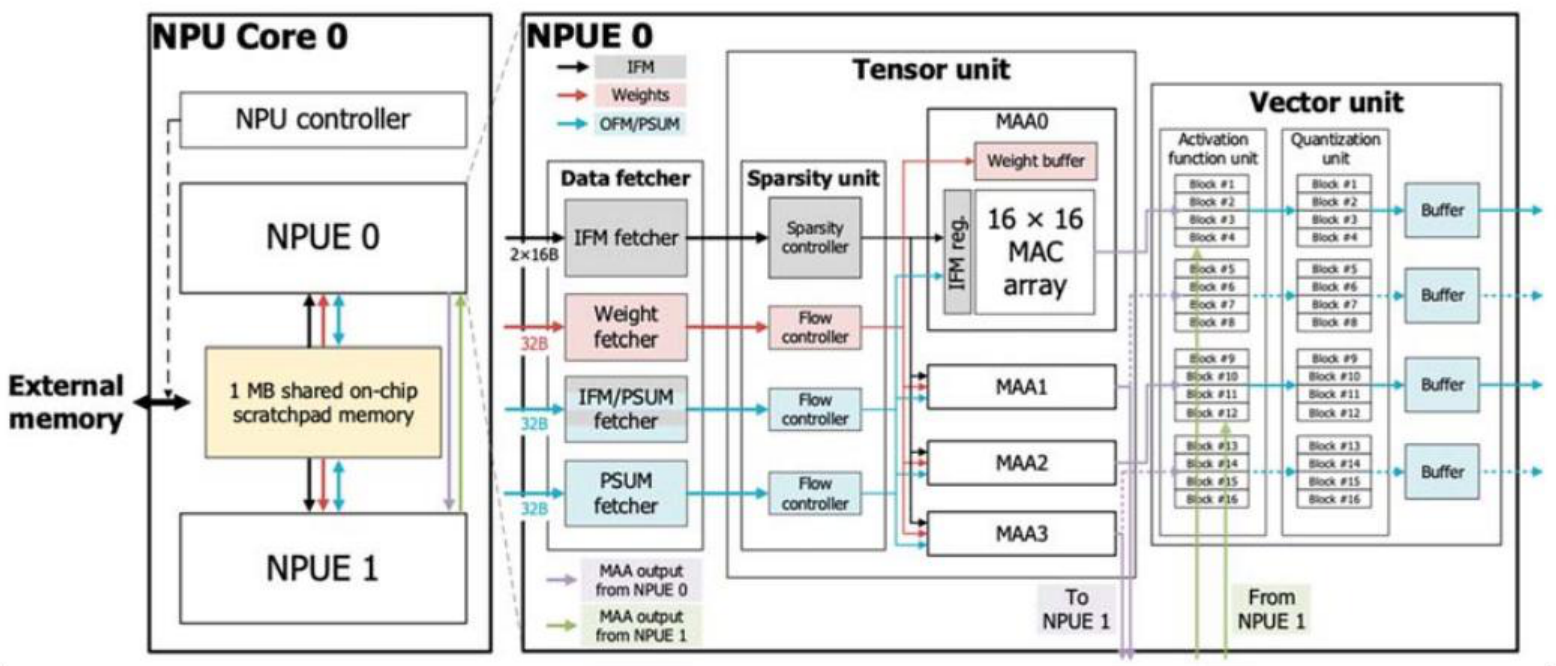
来源:《A Multi-Mode 8K-MAC HW-Utilization-Aware Neural Processing Unit with a Unified Multi-Precision Datapath in 4nm Flagship Mobile SoC》。图中 External Memory 为外部存储器,shared on-chip scratchpad memory 为共享片上 scratchpad 存储器;Data Fetcher、Tensor Unit、Vector Unit 分别为数据读取单元、张量单元和向量单元;Sparsity Unit / Controller 为稀疏处理单元/控制器,Flow Controller 为流控制器,Activation Function Unit 为激活函数单元,Quantization Unit 为量化单元,Weight Buffer 为权重缓冲区,IFM reg. 为输入特征图寄存器。NPUE 表示 NPU 引擎,MAC array 为乘加阵列,IFM/OFM 分别为输入/输出特征图,PSUM 为部分和,Buffer 为缓冲区,Block 为模块;MAA output from NPUE 0/1 表示来自 NPU 引擎 0/1 的 MAA 输出,To/From NPUE 1 表示送往/来自 NPU 引擎 1。图内 scratchpad 标为 1 MB,正文按原书写作 1 MiB。
数据读取单元把数据从 TCM 传送到其右侧的张量单元。它包含分别读取输入特征图(IFU)、权重(WFU)和部分和(PSUM)的子单元;还有一个 IFM/PSUM 单元,可根据计算需要读取特征图或部分和。所有读取子单元都可以同时工作,通过各自独立的 256 位通路访问 TCM。
NPUv1 最有新意的特性,可能是利用输入矩阵的稀疏性来降低能耗、提高性能。图 7.24 中,张量单元左侧的稀疏处理单元跳过输入中的零值,生成稠密矩阵,然后送入四个 MAC 单元。张量单元旁边是向量单元;与 TPU v4 lite 的向量单元一样,它对 MAC 单元的输出执行非线性激活操作。
NPUv1 问世一年后,Samsung 公布了下一代 NPU(见图 7.22 和图 7.23)。NPUv2 与 NPUv1 的总体思路相近,时钟频率相同,每核 TCM 容量也相同,主要差异如下:
- NPUv2 每核只有一个 NPU 引擎,而不是两个。
- NPUv2 的每个张量单元除了支持 8 位整数,还支持 16 位浮点数和 4 位整数。
- NPUv2 的每个张量单元支持 4096 个 8 位 MAC,使每核 MAC 数量翻倍。
- 为减轻核心面积增大的影响,每个 NPUv2 包含两个核心,而不是三个。
- NPUv2 有多种工作模式。例如,面向语音唤醒等始终开启的功能时,可以优先降低功耗,只使用一个核心,让其他单元休眠。与标准模式相比,低功耗模式可节省 89% 的功耗。在低延迟模式下,两个核心都以高时钟频率运行 DNN,尽快完成模型处理;此时功耗可能显著高于 NPUv1。
- NPUv2 还具有聚集单元,可以访问另一个核心的 TCM。与软件方案相比,该单元显著减少了低延迟模式下的冗余数据传输和总延迟。
- NPUv2 采用 4 nm 工艺,而不是 5 nm,裸片面积减小了 15%。
小结:Samsung NPU 如何遵循设计准则
NPU 对 7.2 节准则的遵循情况如下。
- 使用专用存储器,尽量缩短数据移动的距离。 NPU 每核有 1 MiB scratchpad 存储器,占核心面积的 51%。
- 把取消先进微体系结构优化所节省的资源,投入更多运算单元或更大的存储器。 NPUv1 有 6144 个 8 位 MAC,NPUv2 有 8192 个。
- 采用与应用领域匹配的最简单并行形式。 NPU 依赖多处理和二维 SIMD。
- 把数据大小与类型缩减到该领域所需的最简形式。 NPUv1 只支持 8 位、16 位整数,NPUv2 增加了 4 位整数和 16 位浮点数。
- 采用领域专用编程语言,把代码移植到 DSA。 NPU 使用 TensorFlow 和 TensorFlow Lite 编程框架。