7.8 贯穿各层的问题
异构性与片上系统
把 DSA 纳入系统的简单方法,是通过 I/O 总线连接;本章的数据中心加速器都采用这种方式。为了避免通过缓慢的 I/O 总线读取存储器操作数,这些加速器配置了本地 DRAM。
Amdahl 定律提醒我们:主机存储器与加速器存储器之间传送数据的频繁程度,可能限制加速器的性能。把主机 CPU 和加速器集成到同一个片上系统(system on a chip,SOC)中,必然有利于某些应用。
可以用于这类集成的设计称为 IP 模块(IP block),IP 是 Intellectual Property(知识产权)的缩写;不过,“可移植设计模块”可能更能说明它的用途。IP 模块通常使用 Verilog 或 VHDL 等硬件描述语言定义,以便集成进 SOC。IP 模块促成了一个市场:许多公司开发 IP 模块,其他公司购买这些模块,为自己的应用构建 SOC,而无需自行设计每一个部分。后文图 7.32 绘出了 Apple 多代个人移动设备 SOC 中 IP 模块的数量,展示了它们的重要性:仅四年间,数量就增长到原来的三倍。另一个迹象是,Apple SOC 中 CPU 和 GPU 只占三分之一面积,其余都由 IP 模块占据(Shao 和 Brooks,2015)。
设计 SOC 很像城市规划:相互独立的团队都在争取有限资源,而找到适当的折中并不容易。CPU、GPU、缓存、视频编码器等都可以调整设计,用更多或更少的面积和能耗,换取更高或更低的性能。SOC 用于平板电脑还是物联网设备,其资源预算也会不同。因此,IP 模块必须能够在面积、能耗和性能方面灵活伸缩。对于新的 IP 模块,提供资源占用较小的版本尤其重要,因为它可能尚未在 SOC 生态中站稳脚跟;初始资源需求较为适度,会更容易被采用。
集成的吸引力是否会使大多数数据中心处理器来自传统 CPU 公司,并把 IP 加速器集成进 CPU 裸片?还是系统公司会继续通过 I/O 总线部署加速器,延续 2017–2024 年的主流方式?这将是值得观察的问题。
机器学习训练的能耗与碳排放
对全球气候变化的关注,理所当然地促使人们研究机器学习对环境的影响。图 7.25 展示了遵循最佳实践如何使能耗最多降至原来的百分之一、排放最多降至千分之一(Patterson,2022)。示例的起点是著名的 2017 年 Transformer 模型,在普通数据中心使用 GPU 训练。图中展示了在 2019 年、继而在 2021 年应用最佳实践所带来的节省。借鉴缓存“3C”的记忆法,我们把机器学习能效的四项要素称为 4M。
- Model——模型。 第一个 M 指 DNN 模型,示例从 Transformer 开始。最佳实践是选择能够同样出色地解决相同问题的、最新且最高效的模型。
2019 年,Google 研究人员通过神经架构搜索(Neural Architecture Search,NAS),发现了 Evolved Transformer:在质量相同的情况下,它的速度达到 Transformer 的 1.3 倍(So,2019)。2021 年,同一批研究人员再次使用 NAS,发现了 Primer:它的速度达到 Transformer 的 4.2 倍、Evolved Transformer 的 3.2 倍,质量同样不变(So,2021)。注意,NAS 并不频繁进行:针对一个问题领域和体系结构搜索空间进行一次,而不是每次训练模型都进行。搜索结果通常公开发表,模型也会开源,让所有机器学习从业者受益。之后反复使用 NAS 找到的更高效模型,所节省的能耗和排放足以抵偿搜索本身的成本。 2. Machine——机器。 选择训练该模型时效率最高的硬件。以 2017 年 P100 GPU 的性能为基准,2019 年 TPU v2 的性能为其 5.7 倍,2021 年 TPU v4 的性能为其 14 倍,即 TPU v2 的 2.6 倍。结合第一个 M,与在 P100 上运行 Transformer 相比,2019 年的能耗和排放降至原来的 1/7.4,2021 年降至 1/57。 3. Mechanization——数据中心设施(PUE)。 Google 云数据中心的 PUE 约为 1.1,而平均数据中心约为 1.6,前者的 PUE 约为后者的 1/1.4。1 结合前两个 M,与在平均 PUE 数据中心的 P100 上运行 Transformer 相比,2019 年的能耗和排放降至原来的 1/10.7,2021 年降至 1/83。
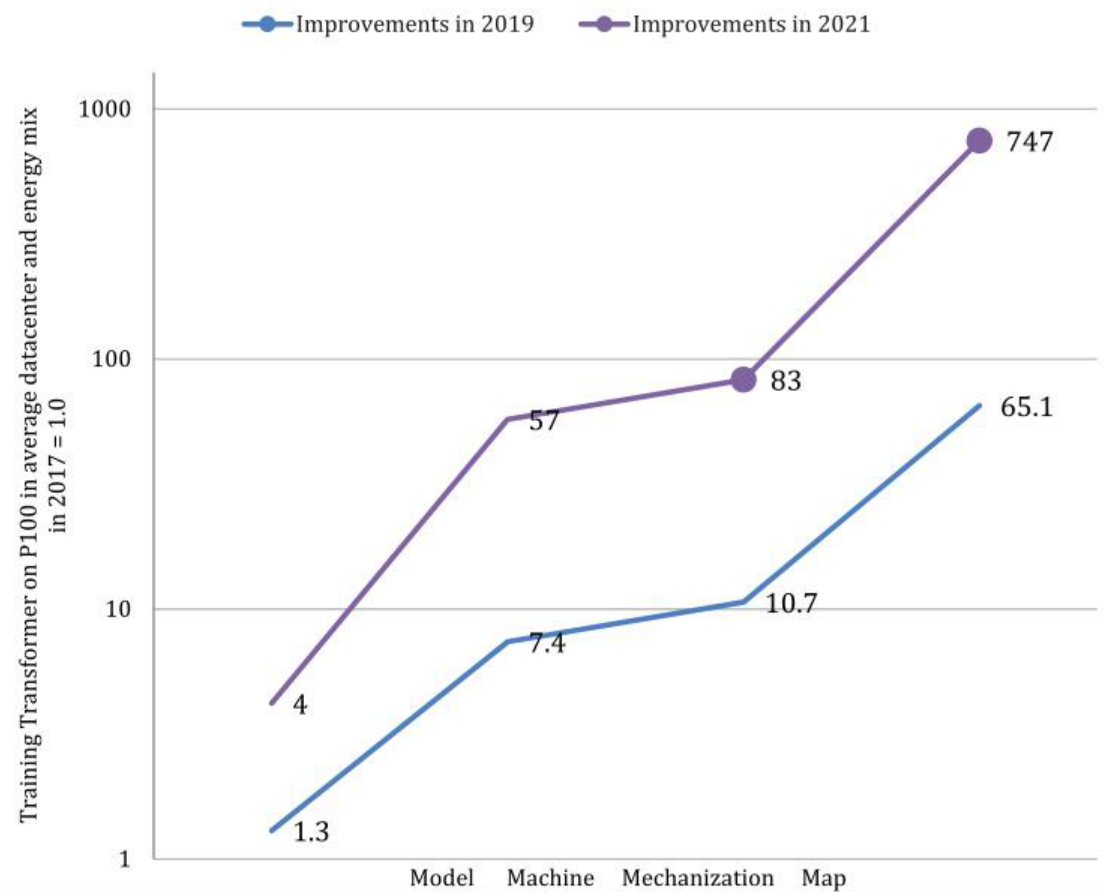
图中蓝线表示 2019 年的改善,紫线表示 2021 年的改善;纵轴为相对于 2017 年基准的改善倍数,采用对数刻度。横轴依次加入 Model、Machine、Mechanization、Map 四项因素。2019 年标注值依次为 1.3、7.4、10.7、65.1;2021 年依次为 4、57、83、747。
- Map——地理位置。 第 1 章已提到,数据中心的位置会显著影响能源供应的清洁程度,差异可达 5–10 倍。以平均能源供应的每千瓦时排放量为基准,2019 年 Google 艾奥瓦州数据中心的排放量为其 1/6;2021 年俄克拉何马州数据中心为其 1/9,即 2019 年艾奥瓦州的 1/1.5。结合前三个 M,与在平均 PUE、平均能源清洁程度的数据中心中用 P100 训练 Transformer 相比,2019 年的排放降至原来的 1/65,2021 年降至 1/747。
遵循 4M 最佳实践,最有希望让我们以可持续的方式兑现机器学习的巨大潜力。
开放的指令集
DSA 设计者面临的一项挑战,是如何与 CPU 协作,运行应用的其余部分。如果二者位于同一个 SOC 中,那么选择哪种 CPU 指令集就是一个重大决定,因为直到不久之前,几乎每种指令集都属于某一家独立公司。过去,开发 SOC 的实际第一步往往是与某家公司签约,锁定指令集。
另一条路是自行设计定制 RISC 处理器,再为它移植编译器和库。IP 核授权的费用与麻烦,使 SOC 中出现了数量惊人的自制简单 RISC 处理器。一位 AMD 工程师估计,一颗现代微处理器内部可能有 12 种指令集!
RISC-V 提供了第三条路:一种切实可用、免费且开放的指令集,并预留了充足的操作码空间,用于增加领域专用协处理器指令,使前述 CPU 与 DSA 的紧密集成成为可能。为支持 DSA,RISC-V 预留了四个用于自定义指令的操作码,每个都可以通过 10 位功能码扩展,因此足以容纳数千条这样的指令。SOC 设计者现在可以选择一种拥有大量配套软件的标准指令集,而无需先签订合同。
他们仍然必须在设计早期选定指令集,但无需选定一家公司并与之签约。他们可以自行设计 RISC-V 核心,可以向销售 RISC-V IP 模块的多家公司之一购买,也可以下载他人开发的免费开源 RISC-V IP 模块。最后一种方式类似开源软件:志愿者维护浏览器、编译器、操作系统等,供用户免费下载使用。
开放指令集还带来额外好处:它改善了提供 RISC-V 技术的小公司的商业前景,因为客户不再需要担心某家拥有独有指令集的公司能否长期存续。
RISC-V 对 DSA 的另一项吸引力是:在 DSA 中,指令集的重要性不如通用处理器中那么高。如果 DSA 通过图结构或并行模式等高层抽象来编程,像 JAX、PyTorch 和 TensorFlow 那样,那么需要在指令集层面处理的工作就更少。原文将其中的图结构写作“data acyclic graphs(DAGs)”。2 此外,当性价比和能源成本方面的进步主要来自增加 DSA 时,二进制兼容性可能不再像过去那样重要。
截至本书写作时,RISC-V 很可能已成为 ARM 和 x86 之后第三重要的指令集。开放的 RISC-V 指令集前景可期。(我们真希望能窥见未来,看看从现在到本书下一版出版时,RISC-V 会发展成什么样!)