7.9 融会贯通:比较 DNN 加速器
下面以 DNN 领域为例,比较本章各加速器的性价比。1 我们先详细比较 TPU v4 lite 与 T4 的推理基准测试表现,再比较 TPU v4、A100 和 IPU Bow 的训练性能。最后,简要评估智能手机中的 Samsung NPU,并将其与笔记本电脑使用的 x86 CPU 比较。
推理:TPU v4 lite 与 T4
图 7.26 展示了在 Google 数据中心运行时,TPU v4 lite 相对于 T4 的性能。三项推理基准来自 MLPerf,每项都有两种成绩。server 版本在几十到几百毫秒的延迟上限约束下,以每秒查询数衡量性能;offline 版本同样使用每秒查询数,但没有延迟上限。
对于 server 基准,TPU v4 lite 的速度为 T4 的 1.3 倍;对于 offline 基准,为 1.6 倍。
图 7.27 展示了已报告的 MLPerf 性能,与 Google 数据中心实测结果之间的差异。T4 的 Turbo 加速频率是基础频率的 2.6 倍;温度上升时,时钟可能降频,因此散热系统对 T4 性能至关重要。T4 与 TPU v4 lite 都采用风冷。MLPerf Inference 要求每次测试至少持续 1 分钟,这与芯片及散热器充分升温所需的时间相近。Google 的实验发现,以最低频率空闲运行的 T4 温度为 35°C;以最高 1.6 GHz 运行 MLPerf 后,30 秒内就升至 75°C。此后温度保持在 75°C,而时钟频率在 0.9–1.3 GHz 之间变化。考虑到 Google 数据中心的环境,以及其强制要求的 ECC——MLPerf Inference 当时允许选择是否启用 ECC——图 7.27 给出了启用 ECC 并持续运行 10 分钟时的影响。
T4 的性能比其报告的 MLPerf Inference 成绩低 19%–26%。相比之下,TPU v4i 起始温度约为 37°C,10 分钟后只上升约 5°C。Google 有意在数据中心中为 TPU v4i 配备充足的供电和散热能力,以维持稳定的延迟,并提供额外存储空间用于 ECC,使 ECC 可以始终开启且不损失性能。此处的 TPU v4i 即本节所述 TPU v4 lite。
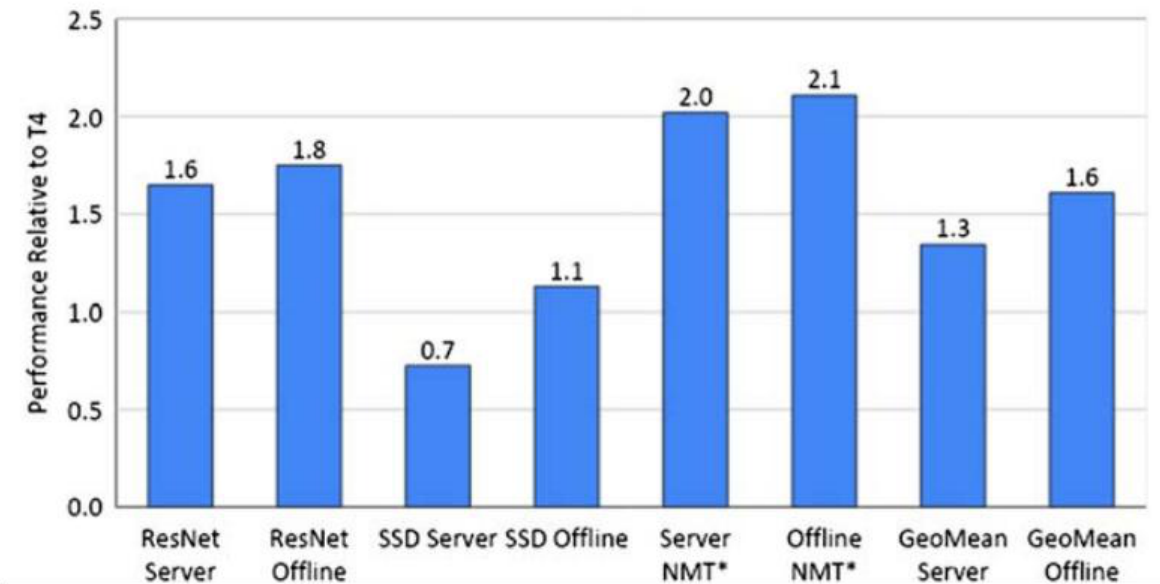
T4 对 ResNet 和 SSD 使用 int8,对 NMT 使用 fp16。MLPerf Inference 0.7 不包含 NMT,因此 NMT 使用 0.5 版结果,ResNet 和 SSD 使用 0.7 版结果。图中从左至右分别为 ResNet server 1.6、ResNet offline 1.8、SSD server 0.7、SSD offline 1.1、NMT server 2.0、NMT offline 2.1,以及 server 和 offline 的几何平均值 1.3、1.6;基准 T4 的性能为 1。
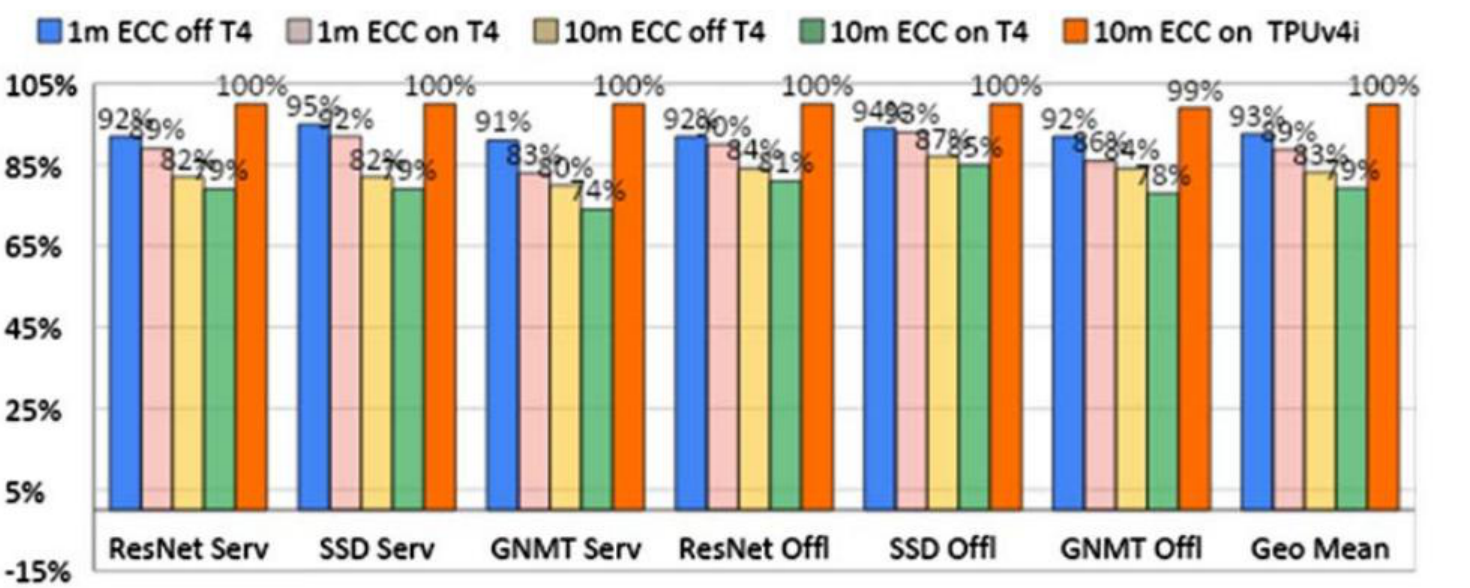
T4 的 100% 基准是 NVIDIA 报告的 MLPerf 成绩;TPU v4i 的 100% 基准是在 Google 数据中心中运行、未经认证的 MLPerf 成绩。1 分钟测试开始前,T4 处于空闲状态,然后在最高频率下,分别关闭和开启 ECC,运行 MLPerf 1 分钟。T4 使用会占用存储带宽的 inline ECC。10 分钟测试前,机器不处于空闲状态。TPU v4i 的速度不随 ECC 开关状态或运行时长改变。图例依次为:T4 运行 1 分钟、ECC 关闭;T4 运行 1 分钟、ECC 开启;T4 运行 10 分钟、ECC 关闭;T4 运行 10 分钟、ECC 开启;TPU v4i 运行 10 分钟、ECC 开启。Serv、Offl、Geo Mean 分别表示 server、offline 和几何平均值。
训练:TPU v4、A100 与 IPU Bow
图 7.28 和图 7.29 展示了三种训练系统随规模扩展,在 ResNet-50 和 BERT 两项 MLPerf 基准上的性能。厂商可以自行选择要报告训练结果的系统规模,因此,能够进行哪些比较,受三家公司选择的限制。
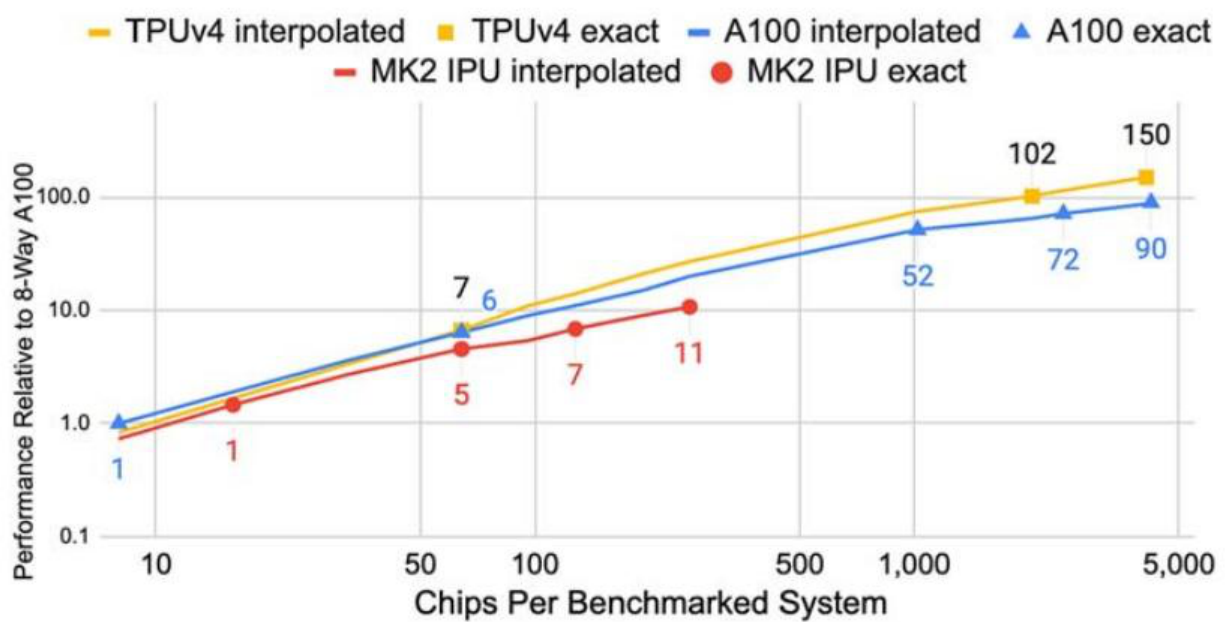
图中的点为已报告结果,连线表示对中间规模系统性能的推算。TPU v4 少于 2048 颗芯片的结果来自 MLPerf Training 1.0,其余所有系统的数据点来自 MLPerf Training 2.0。两个坐标轴均为对数刻度。横轴为参与基准测试的系统芯片数量,纵轴为相对于 8 路 A100 的性能;黄色为 TPU v4,蓝色为 A100,红色为 MK2 IPU。图例中的 exact 表示报告的数据点,interpolated 表示插值连线。2
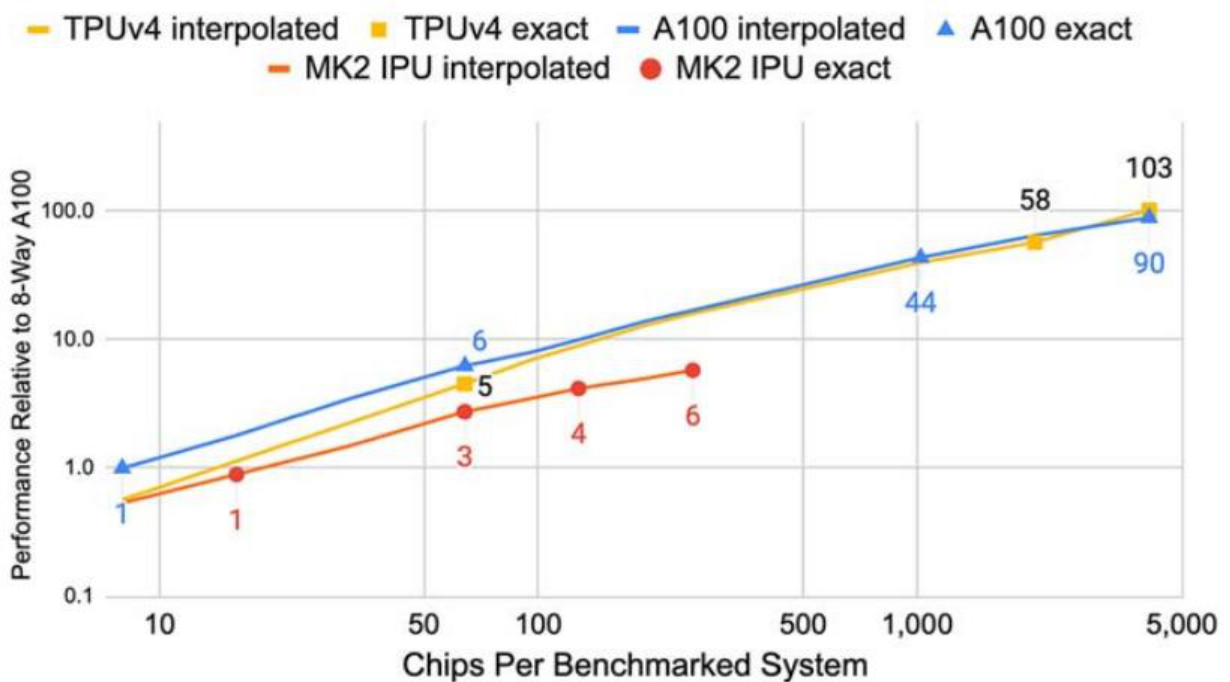
图中的点为已报告结果,连线表示对中间规模系统性能的推算。TPU v4 少于 2048 颗芯片的结果来自 MLPerf Training 1.0,其余所有系统的数据点来自 MLPerf Training 2.0。两个坐标轴均为对数刻度,轴和图例的含义与图 7.28 相同。
本节希望比较规模相同或成本相同的系统。图中的大标记代表已报告结果,点之间的连线则是推算值。TPU v4 和 A100 的 MLPerf 结果都扩展到了远大于 IPU 的系统规模:前两者为 4096 颗芯片,IPU 为 256 颗。对 ResNet-50,TPU v4 快于 A100,A100 又快于 IPU;对 BERT,TPU v4 略快于 A100,而 A100 显著快于 IPU。
推理:Samsung NPUv1、NPUv2 与 Intel Core i7 加 Iris Xe GPU
MLPerf 还提供一组面向移动设备的推理基准。为降低计算需求,移动基准使用的权重通常更少,质量目标也低于数据中心基准。图 7.30 展示了两个 MLPerf 类别的结果:NPUv1 和 NPUv2 属于手机类别,Intel Core i7 属于笔记本电脑类别。
这种比较并非完全同类,因为笔记本电脑的功耗和裸片面积预算更高,时钟频率也快得多,差异达到 5–25 倍(见图 7.22)。即便如此,面向特定领域的 NPU 加速器仍分别达到 CPU 的 1.2 倍和 3.4 倍性能。3 一个原因是它们会跳过稀疏矩阵中的零值,平均获得 1.4 的加速比。
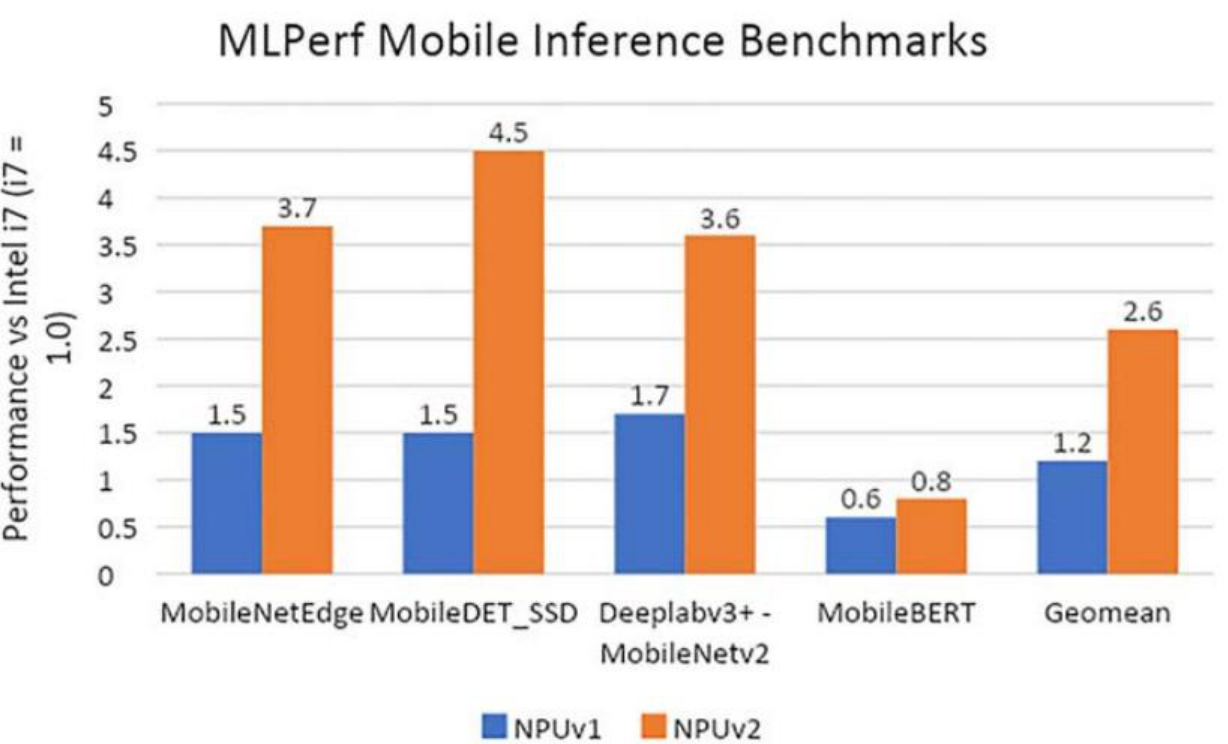
NPUv1 结果来自 MLPerf 1.0,Core i7 来自 MLPerf 1.1,NPUv2 来自 MLPerf 2.0。图中蓝色为 NPUv1,橙色为 NPUv2,Core i7 的性能归一化为 1。各项性能分别为:MobileNetEdge 1.5/3.7,MobileDET_SSD 1.5/4.5,Deeplabv3+–MobileNetv2 1.7/3.6,MobileBERT 0.6/0.8,几何平均值 1.2/2.6。
注意,与另外三项基准相比,MobileBERT 在 NPU 上表现较弱,因为它要求使用 fp16 计算。NPUv1 不支持 fp16,因此这项测试实际运行在同一 SOC 中的 DSP 上。NPUv2 可以直接运行该测试,但它相对 i7 的 fp16 性能优势,远小于整数数据类型的情况。