案例研究与习题
案例与习题由 Cliff Young 编写。
案例研究 1:矩阵乘法
本案例阐明的概念:矩阵乘法运算的结构。
矩阵乘法也许是你在高中代数中接触过的内容,它是当今深度学习革命中最基本的计算密集型运算。与标量乘法一样,矩阵乘法有两个输入、一个输出,但三个操作数都是二维矩阵。描述矩阵形状时,通常先给行数,再给列数;例如, 矩阵有 3 行、5 列,共 15 个元素。
矩阵相乘时,形状必须匹配。按照 FORTRAN 的惯例,我们通常把矩阵乘法写作 ,其中 为结果矩阵,、 为输入矩阵。 是 矩阵,、 分别为 和 矩阵。关键在于:只需三个标量 、、,就能确定矩阵乘法的全部几何关系。 与 的行数同为 , 与 的列数同为 ,而 的列数必须等于 的行数。
这些字母可能让人难以理清。我们可以把矩阵乘法看作一个长方体,三个面分别对应矩阵 、、(图 7.33)。三个标量决定长方体的三条边长,而矩阵乘法的计算量对应长方体的体积。设想把每个输入矩阵的值,沿垂直于其所在面的方向广播到长方体内部;来自 和 的两个值相遇之处,就计算它们的乘积。如何得到输出 呢?对于输出中的每个位置,把垂直于 所在面的直线上所有乘积相加,就得到 中该位置的值。
下面给出一个很简单的矩阵乘法程序,通常也称为 GEMM,即 GEneral Matrix Multiplication。GEMM 是基本线性代数子程序库(Basic Linear Algebra Subroutines,BLAS,读作“blahs”)的一部分;BLAS 是线性代数的标准库。
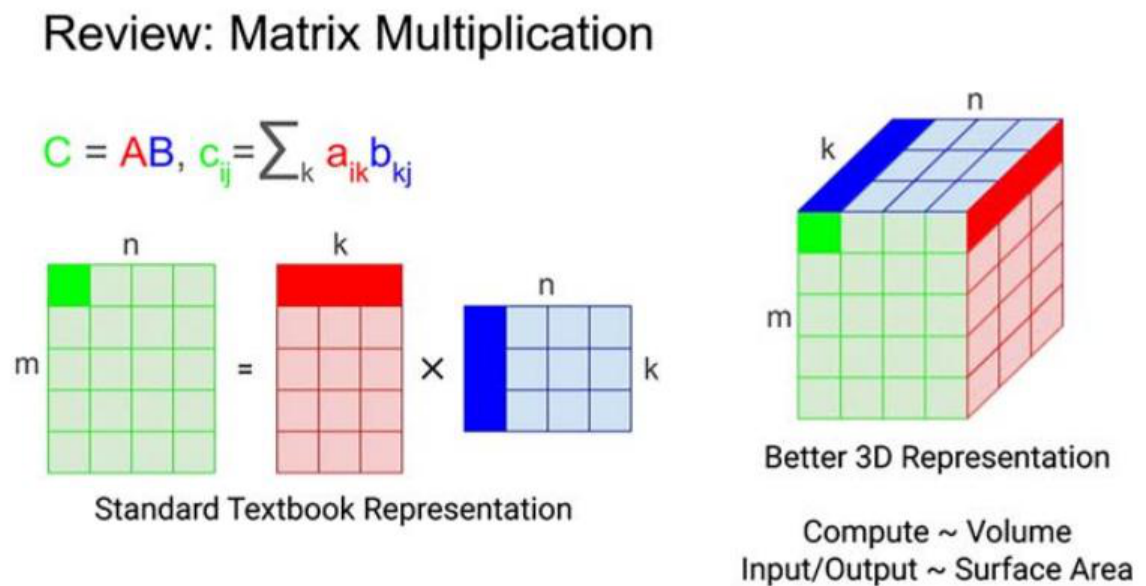
图中左侧为常见教科书中的表示,右侧为更直观的三维表示;Compute ~ Volume 表示计算量对应体积,Input/Output ~ Surface Area 表示输入输出量对应表面积。
译注:代码按原书保留。结果矩阵的声明写为 c[M][K],与正文给出的 形状不符;参数中的数组引用写法也不是可直接编译的标准 C++。本案例代码用于说明计算结构,不能不加修改就当作完整程序运行。
习题 7.1
[10/20/10/10/20] ⟨7.3,7.4⟩
a. [10] 假设 、、 相等。这个算法的渐近时间复杂度是多少?如果不熟悉大 O 记号,请用 、、 写出加法和乘法次数的公式。参数所占空间的渐近复杂度是多少?当 、、 变大时,这对矩阵乘法的算术强度意味着什么?
b. [20] 假设 、、,即三个维度两两互素。写出三个矩阵 、、 中各存储位置的访问顺序。可以先写二维下标,再转换为存储地址或相对于各矩阵起点的偏移量。哪些矩阵的元素按顺序访问?哪些不是?假设采用按行优先的 C 语言存储布局。
c. [10] 假设通过交换行列构造新矩阵 ,即 的转置,其形状改为 B[N][K]。此时最内层循环语句为:
现在哪些矩阵的元素按顺序访问?
矩阵乘法最内层循环中的语句:
称为乘加操作(multiply-accumulate,MAC)。可以将它写成一个简短的子程序:
高性能计算的惯例是把一个 MAC 计为两次运算,显然分别对应乘法与加法;即使 ISA 将 MAC 定义为单个操作码,也仍如此。例如,IBM POWER 就采用这种指令,需要三个源操作数。矩阵乘法可以改写为使用 MAC 的版本:
d. [10] 对于 、、 的情况,这个程序执行多少次 MAC?共多少次运算?
e. [20] 假设有一个硬件单元,每周期可以完成两个 矩阵的乘法。若它运行在 1 GHz,每秒执行多少次 MAC?相当于每秒多少次运算?
分解
为了引出矩阵乘法的下一种表达方式,先把 GEMM_MAC 改写为接受转置后的 :所有值保持不变,只交换行列。 是 矩阵,其转置 是 矩阵。
译注:原书这一代码块缺少函数末尾的右花括号;此处按原样保留。
这种转置还带来一个好处: 和 在存储器中的最内层维度,也就是变化最快的维度,现在都对应 。
点积或内积
考虑点积操作。dot 接收两个向量,把对应元素逐一相乘,再把乘积相加,返回总和。
习题 7.2
[25/25/25] ⟨7.3,7.4⟩
a. [25] 改写 GEMM_MAC_BT,在嵌套循环中用点积替代 MAC。总共会调用多少次 dot?
b. [25] 假设不是使用接受 len 参数的软件 dot,而是使用一个要求长度固定的硬件版本,例如长度固定为 2。把代码改写为使用这样的 dot2。它会被调用多少次?如果 不是偶数,应如何处理?
SAXPY
另一种略有不同的分解方式使用 SAXPY,即 Single-precision Alpha times X Plus Y(单精度的 )。SAXPY 接收一个输入向量和一个标量,用标量缩放输入向量的每个元素,再把所得乘积加到输出向量的对应位置。
c. [25] 改写 GEMM,在嵌套循环中用 saxpy 替代 MAC。
外积
两个向量的外积是一个矩阵,包含这两个向量中所有可能元素配对的乘积。与 GEMM 一样,通常把结果矩阵同时用作输入和输出,将外积加到传入的矩阵上。还需注意,这个程序使用了一点 C 语言下标技巧:把 result 作为原始指针传入,然后手动计算它的下标。
译注:原页确实在 result[i * len_y + j] 后附有 [29][30][31],与 float *result 的类型不相容,疑为排版混入的标记。
习题 7.3
[25/25] ⟨7.3,7.4⟩
a. [25] 改写 GEMM,在嵌套循环中用 outer_product 替代 MAC。示例中具体的下标写法并不重要,可以自行修改 outer_product,让它适合所选择的接口。
b. [25] 重画图 7.33,展示如何把长方体分解为点积、SAXPY 和外积操作。可以把长方体中的小块略微分开,以显示三种运算各自的分组方式。
案例研究 2:神经网络层
本案例阐明的概念:深度神经网络的结构。
图 7.34 转载自经典 AlexNet 论文的图 2(Krizhevsky,2012)。这篇论文发表于 2012 年,却已经包含了现代神经网络设计中几乎所有仍然重要的组成部分。
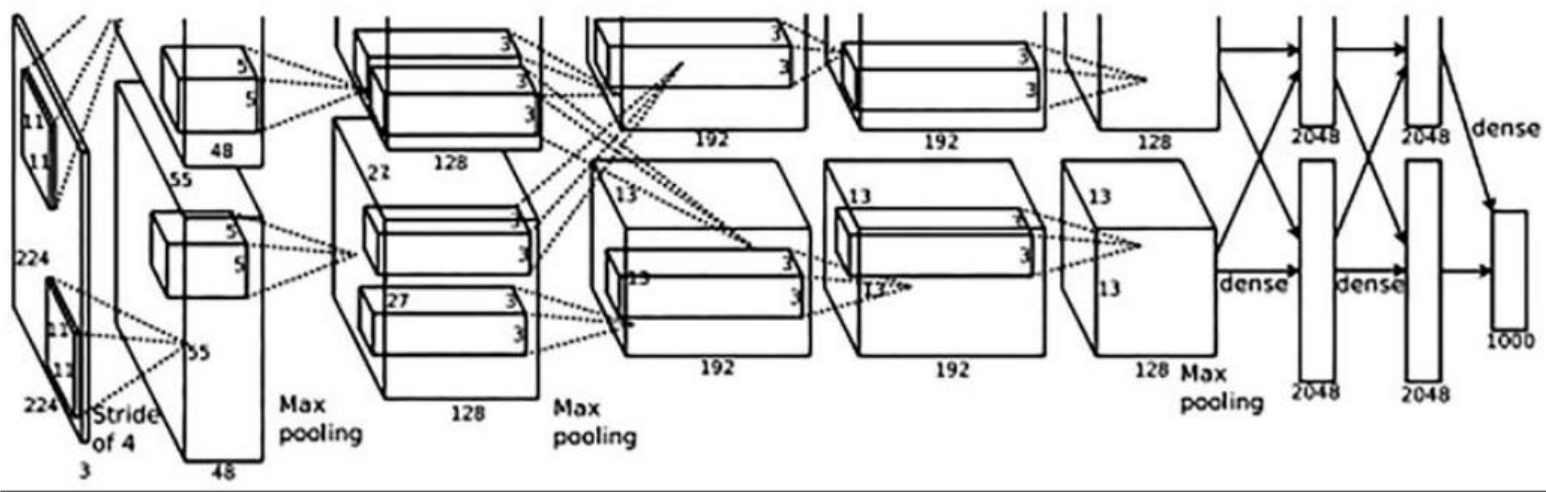
来源:Krizhevsky、Sutskever 和 Hinton,《ImageNet Classification with Deep Convolutional Neural Networks》,Advances in Neural Information Processing Systems 25(2012)。图中展示了“两个 GPU 的职责划分。一个 GPU 运行图中上半部分的各层部分,另一个运行下半部分。GPU 仅在某些层交换数据。网络输入为 150,528 维,其余各层的神经元数量依次为 253,440—186,624—64,896—64,896—43,264—4096—4096—1000。”图中 Stride of 4 为步长 4,Max pooling 为最大池化,dense 表示全连接。
这张图需要一些解释。为便于阅读,我们把它逐项拆开,仅讨论基本内容。
- 图左侧和中间的长方体,以及右侧的矩形,表示激活值,也称特征图。有些具有三维结构,例如 AlexNet 的输入是 的 RGB 图像,颜色维度为 3;有些只有一维结构,例如右侧五个矩形是长度为 2048 或 1000 的一维向量。最后一个含 1000 个值的激活向量,是 AlexNet 的“输出分类器”,列出输入图像属于 ILSVRC 比赛中各个类别的概率。
- 图中没有显式绘出 AlexNet 的层和权重。它们位于相邻的激活表示之间,其形状可由激活的形状推导,稍后会说明。
- 前五层位于各长方体之间,是卷积层。输出长方体中的每一点,都依赖于一个感受野,即大长方体内部画出的小长方体。每组卷积输入或输出下方的数字——3、48、128、192、192、128——表示该层的深度或特征深度。输入激活的深度对应 RGB;后续层中,更多的深度则表示更抽象的概念。长方体还标出了空间尺寸:输入为 ,第一层后迅速降至 ,第二层后为 ,第三和第四层后为 。1
- 前几层通过两种机制缩小空间尺寸,其含义类似图像分辨率。第一种是使用步长:每隔 4 个像素评估一次感受野,而不是对每个像素位置都评估。
第二种是最大池化:对空间上 的一组激活值,返回其中的最大值。
- 最后三层是全连接层,本质上是矩阵—向量乘法。第六层把 展平成一维向量,两个 GPU 各有一组 21,632 个激活值,总计 43,264 个;然后通过矩阵乘法将其投影到 4096 个激活值。第七层将 4096 个激活值映射为 4096 个;分类器层再从 4096 个降至最终的 1000 个输出类别。
- 在分类器层,Softmax 函数把含 1000 个激活值的向量转换为 1000 个概率。Softmax 是向量函数,原书给出的公式为:
其中,输入向量的 个元素为 ,输出向量的 个元素为 。2 不必被公式吓到:各输出共用同一个分母,它是一个缩放因子,保证输出向量中各值之和为 1。
- 图中还展示了跨两个 GPU 的并行化,两者之间只有有限通信。后面还会讨论并行化。
习题 7.4
[10/20/15//25/25/25/25] ⟨7.3,7.4⟩
a. [10] 每个卷积层有多少权重?生成一个输出激活值需要使用多少权重?
b. [20] 根据图注给出的总数,推导各卷积层的神经元(激活值)数量,例如第一个卷积层输出为 253,440 个,依此类推。
c. [15] AlexNet 的第六、七、八层,开始时数据分布在两个 GPU 上。为完成这些计算,每个 GPU 需要向另一个发送多少数据?这些层在每个 GPU 上驻留多少权重?处理一张图像时,这些层执行多少次运算?
d. [25] 深度学习实践中一个令人遗憾的现实是:我们学过的简洁卷积公式,实际使用时不一定完全吻合。缩小空间尺寸的层就能体现这一点,包括卷积核步长和最大池化。我们可能预期,长度为 的滤波器对长度为 的输入做卷积,会产生 个输出;但某些神经网络层的规格似乎会产生更多输出。通常的解决办法是在输入中加入一定量的零填充(zero padding),增大有效尺寸,以达到预期输出尺寸。对于图中使用步长和最大池化的层,何时需要在 X 或 Y 方向填充,才能使尺寸计算吻合?注意,最大池化也可能需要设置步长。
e. [25] Softmax 看起来可能很复杂,但用几个小例子试一试,就能形成直觉。Softmax 的输入称为 logits。请计算以下向量的 Softmax:
- 四个值均为 2.0 的向量;
- 向量
[1,2,3,4]; - 长度为四的 one-hot 向量;
- 包含两个较大值和两个较小值的四维向量。
随后尝试缩放整个向量、给所有元素加上同一个值,以及改变向量中各元素的相对大小。从定性角度看,Softmax 对输入有什么影响?输出向量的大部分数值总量会集中在哪里?
f. [25] 使用均匀分布、高斯分布和指数分布,生成一些随机的 1000 维向量,再计算它们的 Softmax。绘制输出的累积分布函数(CDF)。需要多少个输入项,才能分别占据 CDF 的 50%、95% 和 99%?
g. [25] Softmax 可能出现数值不稳定,因为它使用的指数函数增长很快,相对不大的输入就可能产生超出浮点表示范围的值。如何改写 Softmax,以消除这种数值不稳定?
AlexNet 缺少的一项重要组成部分是注意力层。介绍 Transformer 体系结构的论文《Attention Is All You Need》(原文此处写作 Vishwani,2017)就突出了它的重要性。3 注意力的代数形式为:
图 7.35 用图形展示了注意力。这个表达仍然有些简略,下面进一步解释。
- 三个输入 、、,分别表示 Query(查询)、Key(键)和 Value(值)。这些名称提示我们,注意力的工作方式类似内容寻址存储器(CAM)。4 这种硬件结构保存键值对,接收查询,而不是普通存储器中的地址;如果某个键与查询相等,就返回对应的值。但与 CAM 布尔式的精确比较和选择不同,注意力的选择更为柔和,因此学习时反向传播能够通过它进行。
- 先把 看作向量,而不是矩阵。深度学习中一个令人困惑的现象是:激活向量未必具有容易被人理解的“含义”;研究者用较为专业的说法,称它位于潜在空间(latent space)。图中底部表示 的 MatMul,暂时可看作矩阵—向量乘法,其中 为矩阵, 为向量。
现在把 看作一组向量,每个向量都表示与查询向量处于同一潜在空间的一个键。于是, 可以理解为计算 与各个键向量的点积。这里的点积就像比较函数:两个向量方向大致相同时,点积较大;方向正交时,点积为零。因此,第一个 MatMul 只是把查询向量 与各键比较,计算 与每个键的相似程度。
- Scale(缩放)和可选的 Mask(掩码)都是逐元素操作,这里略过。
- Softmax 如前所述,把 产生的 logits 转换为概率分布,从而确定应给每个键值对分配多大权重。
- 最后一次矩阵乘法 ,按 Softmax 选出的权重缩放各个值向量。如果 Softmax 的结果是 one-hot,就像内容寻址存储器报告“这里命中了”;如果结果包含多个非零值,就会把那些键最接近查询的值,按照接近程度混合起来。因此,第二个 MatMul 返回的是由查询决定的、各个值的加权组合。
- 最后,取消最初“ 是一个向量”的简化假设,把它看作一组查询。我们并行处理整组查询,注意力模块针对每个查询,分别返回一个混合后的值向量。
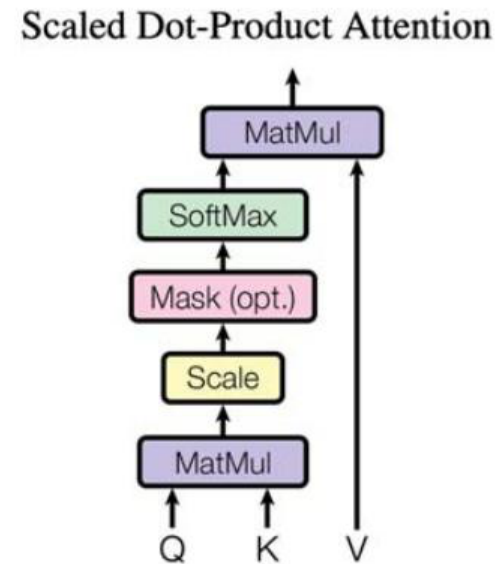
转载自 Vaswani、Shazeer、Parmar、Uszkoreit、Jones、Gomez、Kaiser 和 Polosukhin,《Attention Is All You Need》,Advances in Neural Information Processing Systems 30(2017),图 2 的一部分。图中 Scaled Dot-Product Attention 为缩放点积注意力,MatMul 为矩阵乘法,Mask (opt.) 表示可选掩码。
习题 7.5
[25/15/15] ⟨7.3,7.4⟩
a. [25] 探索点积如何起到比较函数的作用。为保持简单,仍使用四维向量。标准正交基向量集合 {[1,0,0,0], [0,1,0,0], [0,0,1,0], [0,0,0,1]} 中,任意两个不同向量的点积显然都为零。但神经网络产生的向量很少这样规整,因为它们是通过随机过程学习得到的。随机选取一个四维向量,然后构造一个包含它的正交基。四个向量不必为单位长度,但必须两两点积为零。
b. [15] 如果一个键向量等于另一个的两倍,会怎样?它们与查询的点积之比是多少?
c. [15] 同样,如果一个键向量是另一个的相反数,会怎样?点积之比是多少?经过 Softmax 后,那个负的点积会怎样?
案例研究 3:数值表示
本案例阐明的概念:数值表示和浮点运算。
矩阵乘法是当今神经网络中的关键大规模运算,而降低精度则是使每秒万亿、千万亿次运算在芯片面积和功耗上变得可承受的重要因素。AlexNet 使用 32 位浮点值编写,并在 GPU 上运行;TPUv1 的高运算吞吐量,部分来自使用 8 位定点运算。为了简化练习,我们只讨论 4 位数值表示,这样就能列举每种格式的全部可表示值。
整数
无符号整数是由 位组成的位串,每一位的权值是相应的 2 的幂。把四个位从最高有效位到最低有效位依次记作 、、、,则四位无符号整数的值为:
这四位可以表示 0 到 15 的整数。
为了表示有符号整数,二进制补码格式把最高有效位的权值从 8 改为 −8:
因此,四位可以表示 −8 到 7 的整数。最高有效位也称为符号位。
第三种较少使用的格式称为 Excess-k。它的二进制表达与无符号格式相似,但增加了一个偏置项 ,改变各位所代表数值的解释:
偏置不一定由硬件表示,也可能完全由软件通过改变数值解释来管理。无符号整数相当于 excess-0 值。5
更少见的一种整数格式是符号—数值表示(sign-magnitude),第一位表示符号,其余位按通常方式表示数值:
四位符号—数值表示有一个有趣特点:零有两种表示,实质上是正零和负零。这给比较带来麻烦,因为两种零的位模式不同,但比较时应该相等。
习题 7.6
[5/10/10/10/20] ⟨7.4,7.5⟩
a. [5] 列举全部四位整数值,包括无符号和有符号表示。可以列成表格;使用二进制形式会很有帮助。
b. [10] 符号—数值表示取相反数很容易,只需翻转符号位。对于有符号补码值, 与 之间是否存在通用模式或公式?忽略 −8,因为它的相反数 8 无法用四位有符号数表示。
c. [10] 对每一种格式,两个四位数相加,需要多少位才能表示其和?
d. [10] 两个四位无符号数相乘,需要多少位才能精确表示无符号乘积?
e. [20] 假设要构建一个接受两个四位输入的乘法器,输入可能都无符号、都有符号,或一个有符号而另一个无符号。要保证这三种情况下输出正确,分别需要做什么?
浮点数
如果还记得高中化学中的科学计数法,你会记得它把阿伏伽德罗常数——一摩尔中的原子或分子数量——写成类似 的形式。计算机中的浮点表示本质上做的是同样的事,只是不使用十进制来表示有效数字和指数,而是使用能以位表示的整数。
浮点数包含三个部分:
- 一个符号位,与整数的符号—数值表示相同;
- 零个或多个小数位,对应阿伏伽德罗常数中的“.02”。它们表示基数点右侧的值:这里是二进制小数点,科学计数法中则是十进制小数点。把小数位作为整体来看,它很像一个无符号整数。那么,6.02 中的 6 去哪里了?这恰恰是浮点格式高效表示实数的关键,下面会继续解释;
- 零个或多个指数位,主要以 Excess-k 格式表示以 2 为底的指数;此外,可能有一些特殊取值,用于处理格式中的边界情况。
对于所谓的规格化浮点数(normal),数值由下式给出:
符号项决定整个表达式为正还是为负。注意,中间项在小数位之前有一个“隐含的首位 1”。因此,中间项所表示的值位于数轴上的半开区间 :这种小数位格式永远不会表示 2.0,但如果小数位足够多,就能非常接近它。原文以 IEEE 双精度格式的 53 位为例。6 隐含首位 1 与指数项相结合,赋予浮点格式巨大的动态范围:指数每增加一级,它在实数轴上覆盖的区间跨度就是前一级的两倍。
你可能会问:浮点格式如何表示零?这就需要一个特殊指数编码,通常是指数位全零。对于这个特殊编码,使用修改后的公式:
其中,minexp 是最小规格化浮点数的指数值。除此之外,唯一变化是:隐含首位 1 变为隐含首位 0。当小数部分不为零时,这种格式中的值称为非规格化数(subnormal 或 denormal)。
它们在浮点数的数值稳定性和误差分析中起着关键作用。
习题 7.7
[20/20/20/5/10] ⟨7.4,7.5⟩
a. [20] 一种四位格式有 1 个符号位、1 个小数位和 2 个指数位。列出全部 16 种四位编码在实数轴上对应的值。假设指数采用 excess-(−2):指数编码 0 表示非规格化范围,1 表示指数 −1,2 表示指数 0,3 表示指数 1。
b. [20] 把这 16 个值画在实数轴上。由于对称,只画正半轴或负半轴也可以。非规格化数在数轴上起什么作用?
c. [20] 对于 1 个符号位、没有小数位、3 个指数位的格式,画出所有可表示值。这些值如何分布?对于这种格式,你会如何实现乘法?
d. [5] 对于 1 个符号位、3 个小数位、没有指数位的格式,画出所有可表示值。这种格式看起来像什么?
e. [10] 如果格式包含 1 个符号位、2 个小数位和 1 个指数位,又会怎样?这个单独的指数位起什么作用?这种格式与上一种有什么不同?
案例研究 4:计算、供数与规模
本案例阐明的概念:
- 简单神经网络模型的存储容量与计算速率,即“speeds and feeds”;
- 构建面向 DNN 的 DSA。
若以每个字所蕴含的系统设计智慧衡量,Jon Bentley 的《The Back of the Envelope》(Bentley,1999)或许是最出色的文章之一。Bentley 在文中介绍了一种计算机系统设计方法:借助纸笔——甚至旧信封的背面——和高中代数,快速判断某个设计是否合理,乃至是否可能。计算机体系结构设计者有时把这种分析称为 speeds and feeds,即把计算速度、数据供给速率和容量放在一起估算。本节给出若干这样的例子。
Google 的第一代 Tensor Processing Unit(TPU)包含一个 脉动阵列矩阵乘法器,峰值性能达到每秒 92 万亿次运算。这个数字在当时令人惊叹,是同时代双芯片 K80 GPU 的 30 倍、超大规模数据中心 CPU 的 90 倍。在介绍 TPU 的论文中(Jouppi,2017),作者同时指出,TPU 的存储带宽是关键瓶颈:两个 DDR3 通道只能以约 30 GB/s 的速率加载单字节权重。
习题 7.8
[10/10/10/10] ⟨7.3,7.4,7.5⟩
a. [10] 假设脉动阵列中的每个单元每周期执行一次乘加,计为两次运算,计算 TPU 的运行时钟频率。
b. [10] TPU 加载一个 64 KiB 权重分块需要多久?
c. [10] 本题把算术强度(arithmetic intensity)定义为一个已加载值被复用的次数,通常表现为它参与多个不同的 ALU 运算。7 在稳态运行中,每个权重需要达到多大的算术强度,才能使 TPU 同时达到峰值存储带宽和峰值计算吞吐量?
后来的 TPUv4 lite 使用两个 HBM 堆叠,存储带宽达到 614 GB/s(Jouppi,2021)。它有四个 脉动阵列,但这里暂且忽略这一点,把计算资源看作一个整体的 脉动阵列。
d. [10] 对于每个权重占 2 字节的 bf16——TPUv1 每个权重仅占 1 字节——TPUv4 lite 加载“64 KiB 权重”需要多久?8 要同时达到计算与存储峰值,它需要多大的算术强度?
根据原书引用的 NVIDIA H100 规格页面,最快的 H100 GPU 版本采用 SXM 形态:fp64 峰值为 32 TFLOPS/second,fp32 为 367 TFLOPS,Tensor Core 的 bf16 为 1.979 TFLOPS,fp8 或 int8 模式为 3958 TFLOPS/second。9 据报告,H100 包含 132 个流式多处理器,时钟频率介于约 1 GHz 的基础频率和约 2 GHz 的加速频率之间。
另一个 DNN DSA 是 Cerebras WSE-2,它堪称工程奇迹:使用整片制造晶圆构建单个计算单元,面积约为 50 颗常规最大尺寸裸片的总和;常规裸片面积上限约为 800 mm²。片上规格同样引人注目:40 GB SRAM、20 PB/s 带宽,以及 20 kW 功耗。这些庞大的资源通过 12 条 100 Gb/s 以太网链路与外界连接。
习题 7.9
[10/10/10] ⟨7.3,7.4,7.5⟩
a. [10] 考虑 fp32 的峰值 TFLOPS,这个数值很可能是在 GPU 峰值频率下测得的。每个 SM、以及整颗 H100 芯片中,可能分别有多少 fp32 功能单元?
b. [10] H100 Tensor Core 的 bf16 每秒运算次数高出很多。据此,你认为 Tensor Core 功能单元与 SIMD 核心功能单元的数量之比是多少?
c. [10] GPT-3 有 1750 亿个参数,因此即使每个权重只占 1 字节,一个 GPT-3 实例仅权重就需要 175 GB。把这些参数从 WSE 之外的独立存储系统流式传送到晶圆上,需要多久?
习题
习题 7.10
[5/5/10/10/10/10/15] ⟨7.9⟩
2024 年,在云中租用一块 NVIDIA H100 GPU 的费用为每小时 2–4 美元。媒体报道的购买价格,即资本支出(CAPEX),约为 30,000 美元。运营支出(OPEX)的一部分是电费。H100 的 TDP 为 700 W;2023 年,美国各地零售电价约为每千瓦时 0.10–0.20 美元。
a. [5] 假设设备持续出租,H100 的年租金收入是多少?
b. [5] 如果购买价格是云厂商为 H100 支付的唯一成本,需要多久才能收回购置成本?
c. [10] 运行这样一台设备一年,最坏情况下电费是多少?
d. [10] 电费会怎样改变回收期?还有哪些因素可能影响 GPU 全生命周期的总拥有成本?
e. [10] 假设其他因素造成的运营支出与电费相等,此时回收期是多少?
f. [10] 假设 GPU 的有效使用寿命约为 8 年,云厂商可能获得多少利润?如果每逢新一代 GPU 推出,例如每两年,H100 租金大致减半,利润会如何变化?
g. [15] 到目前为止,我们忽略了影响 H100 租赁盈利能力的一些实际问题。收入方面,我们假定多年间硬件始终可以 100% 出租。更现实的利用比例可能是多少?如果 H100 用于推理而不是训练,这个比例可能如何变化?支出方面,我们省略了容纳 H100 的 CPU 主机的 CAPEX 和 OPEX、出租 H100 公司的人员成本,以及资金成本,也就是持有现金而不投资的机会成本。估算这些因素如何影响预期利润。如果调整后的利润估计在经济上不合理,可能有哪些合理解释?
习题 7.11
[10/10/10/10] ⟨7.2⟩
第一代 Anton 分子动力学超级计算机,通常模拟一个边长为 64 埃的水立方体。计算机本身可以近似为边长 1 米的立方体。单个模拟步骤对应 2.5 飞秒的模拟时间,实际耗时约 10 微秒。
分子动力学的物理模型假定,在每个“外层”时间步中,系统中的每个粒子都对其他每个粒子施加作用力,因此实质上要求整台计算机进行一次全局同步。
a. [10] 计算从模拟空间到现实硬件空间的空间放大倍数。
b. [10] 计算模拟时间相对于实际经过时间的减速倍数。
c. [10] 上述两个答案竟然非常接近。这只是巧合,还是有其他限制以某种方式约束了它们?提示:光速限制既适用于被模拟的化学系统,也适用于进行模拟的硬件。
d. [10] 在这些限制下,要用仓库级超级计算机以 Anton 的速率进行分子动力学模拟,需要满足什么条件?换句话说,对于边长为 或 米的机器,可能达到的最快模拟步耗时是多少?如果使用跨越全球的云服务进行模拟,又会怎样?
译注:原文这里明确写作 ,原图第二组特征图的上、下半部分也分别出现 22 与 27 的不一致标注。 ↩︎
译注:原公式的分子写作 ,分母使用 ,随后文字使用 作为输入符号;若统一采用输入向量 ,分子应写作 。 ↩︎
译注:原文此处作者拼作 Vishwani,而图 7.35 和参考文献均为 Vaswani。 ↩︎
译注:原文第一次将 CAM 展开为 context-addressable memory,后文则使用 content-addressable memory;这里按其键值匹配机制统一译为“内容寻址存储器”。 ↩︎
译注:本案例明确把 定义为加到编码值上的偏置,因此公式中为 ,后面的习题也采用 excess-(−2)。这与把 Excess-k 中的 k 定义为待减去偏置量的惯例不同,应以本题给出的定义为准。 ↩︎
译注:IEEE 双精度的 53 位有效精度包含隐含首位 1;显式存储的小数位为 52 位。原文在这里把 53 称为小数位数量,混用了两种计数。 ↩︎
译注:本题把算术强度描述为每个已加载值的复用次数;在 Roofline 模型中还常按每字节数据对应的运算次数计量。解题时应明确所采用的单位,以及一次乘加计为两次运算的口径。 ↩︎
译注:原题写作“64 KiB weights”,未明确在 bf16 情形中指 64 KiB 数据,还是 64 Ki 个权重。两种解释所需传输字节数不同,题目单位按原样保留。 ↩︎
译注:原页确实写作 fp32 为 367、bf16 为 1.979。后者与题目所说“Tensor Core 吞吐量高出很多”不一致,疑有数字或分隔符问题。原书还把 fp64 和 fp8/int8 项的单位写成 TFLOPS/second,而 TFLOPS 已含“每秒”的含义;int8 的整数运算吞吐量通常应以 TOPS 表示。 ↩︎